Dla kogo jest ten przewodnik i jak z niego korzystać
Ten przewodnik jest dla osób, które badają skutki interwencji: terapii, rehabilitacji, szkolenia, programu edukacyjnego albo zmiany organizacji opieki. Najczęściej są to prace z fizjoterapii, pielęgniarstwa, psychologii klinicznej, położnictwa, dietetyki i ratownictwa medycznego, ale ta sama logika obowiązuje w każdym badaniu, w którym mierzysz te same osoby przed i po. Nie znajdziesz tu nowego poradnika, tylko uporządkowaną drogę przez wpisy, hasła i kalkulatory, które już są w serwisie. Każdy link ma jedno zdanie opisu, żebyś wiedział(a), po co go otwierasz.
Ścieżka ma osiem etapów, ułożonych w kolejności, w jakiej podejmujesz decyzje (rysunek 1). Cztery pierwsze dotyczą planu i trzeba je zamknąć, zanim zbadasz pierwszą osobę. Trzy kolejne to analiza, ostatni to opis wyników. Jeśli masz już dane i konkretny kłopot, zacznij od tabeli „mam problem – co przeczytać”. Gdy potrzebujesz tylko definicji, przejdź do listy haseł.
Jeśli piszesz pracę na konkretnym kierunku, równolegle otwórz wpis z przykładami z Twojej dziedziny: pielęgniarstwo, położnictwo, dietetyka, ratownictwo medyczne, WF i nauki o sporcie albo zdrowie publiczne. Każdy z nich pokazuje pięć typowych projektów z danymi i gotowymi zdaniami.
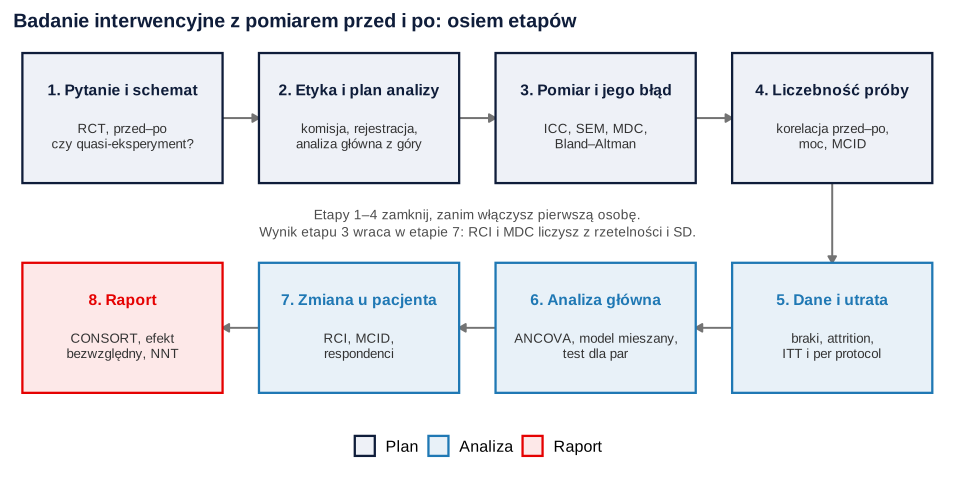
Etap 1. Pytanie badawcze i schemat badania
Od schematu zależy, jaki wniosek w ogóle wolno Ci wyciągnąć. Pomiar jednej grupy przed i po pozwala opisać zmianę, ale nie przypisać jej interwencji: tę samą poprawę mogą dać naturalny przebieg choroby, efekt testowania i regresja do średniej. Ta ostatnia jest tym silniejsza, im większy błąd pomiaru i im bardziej skrajne wyniki miały osoby kwalifikowane do badania (Barnett i in., 2005). Jeśli chcesz napisać „terapia zmniejszyła ból”, potrzebujesz grupy kontrolnej, najlepiej z losowym przydziałem. Gdy losowanie jest niemożliwe, zaplanuj grupę porównawczą i pomiar cech wyjściowych.
- Statystyka dla fizjoterapeuty – pomiar przed i po terapii, skale bólu i trzy pytania: czy zmiana przekracza błąd, czy ma znaczenie dla pacjenta i czy wynika z terapii.
- Statystyka dla lekarza – jak czytać wyniki badań klinicznych (różnica bezwzględna, NNT, HR, wartości predykcyjne) i zaplanować własne badanie.
- Schemat pretest–posttest bez grupy kontrolnej – co wynika z pomiaru jednej grupy i jakie konkurencyjne wyjaśnienia trzeba opisać w ograniczeniach.
- Regresja do średniej – dlaczego osoby kwalifikowane za wysoki wynik „poprawiają się” bez żadnej interwencji.
- Grupa kontrolna – rodzaje kontroli (brak interwencji, lista oczekujących, placebo, kontrola aktywna) i to, na jakie pytanie każda odpowiada.
- Grupa porównawcza – czym różni się od kontrolnej, gdy przydział nie był losowy, i jak ją dobrać.
- Randomizacja – losowy przydział do grup, randomizacja blokowa w małych próbach i warstwowanie.
- Schemat quasi-eksperymentalny – interwencja bez losowania i założenia, od których zależy ocena jej skutku.
- Badanie non-inferiority i równoważności – margines, test jednostronny, ITT i per protocol.
- Schemat naprzemienny (crossover) – efekt okresu, przeniesienie i model mieszany.
- Randomizacja klastrowa – ICC, efekt schematu i analiza wielopoziomowa na przykładzie oddziałów.
- Pilotaż wykonalności – kryteria postępu, rekrutacja i retencja z 95% CI zamiast testu efektu.
Etap 2. Etyka, rejestracja i plan analizy
Zanim zaczniesz rekrutację, sprawdź, czy potrzebujesz opinii komisji bioetycznej, i sformułuj kryteria włączenia i wyłączenia tak, żeby dało się je sprawdzić. Badanie interwencyjne zarejestruj w publicznym rejestrze przed włączeniem pierwszej osoby, bo rejestracja wsteczna nie spełnia swojego celu. W planie analizy zapisz jeden wynik pierwszorzędowy, moment jego pomiaru, analizę główną, sposób postępowania z brakami i ewentualne podgrupy. Ustal też, kto nie będzie znał przydziału do grup: przy wynikach wymagających oceny klinicznej często najłatwiej zaślepić osobę, która mierzy efekt.
- Zgoda komisji bioetycznej – kiedy jest potrzebna, co przygotować i jak opisać opinię w rozdziale o metodzie.
- Rejestracja badania klinicznego – rejestry uznawane przez ICMJE i dlaczego plan wpisuje się przed włączeniem pierwszego uczestnika.
- Kryteria włączenia i wyłączenia – jak wywieść je z pytania badawczego i opisać ich wpływ na uogólnianie wyników.
- Plan analizy statystycznej i prerejestracja – wzór planu: hipotezy, liczebność, reguły wykluczeń, braki danych i kryteria decyzji spisane przed zobaczeniem danych.
- Zaślepienie badania – kogo zaślepić i jak to opisać, zamiast poprzestawać na etykiecie „pojedynczo ślepa próba”.
- Podwójnie ślepa próba – przed czym chroni i jak sprawdzić, czy zaślepienie się udało.
- Ślepa ocena wyniku – zaślepienie osoby, która mierzy zmienną zależną, gdy nie da się zaślepić pacjentów ani terapeutów.
- Efekt placebo i nocebo – jak oczekiwania uczestników zmieniają wynik i dlaczego warto je mierzyć w obu grupach.
Etap 3. Narzędzie i błąd pomiaru
Zmiana o trzy punkty nic nie znaczy, dopóki nie wiesz, jak duży jest błąd pomiaru narzędzia. Dlatego przed analizą zmiany sprawdź (albo znajdź w literaturze) rzetelność test–retest i standardowy błąd pomiaru. Przy ICC zawsze podawaj model, typ i definicję współczynnika oraz 95% przedział ufności, a jakość oceniaj na podstawie przedziału, a nie samej wartości punktowej (Koo i Li, 2016). Gdy porównujesz dwie metody albo dwa urządzenia, korelacja nie wystarcza: potrzebujesz wykresu Blanda–Altmana z granicami zgodności. Sprawdź też, czy narzędzie nie ma efektu sufitu albo podłogi w Twojej populacji.
- Badanie rzetelności pomiaru klinicznego – pełny przykład: ICC, SEM, MDC95 i Bland–Altman, z planem, kto mierzy, ile razy i w jakim odstępie.
- ICC – współczynnik korelacji wewnątrzklasowej – formy ICC i jak wybrać model, typ i definicję do swojego badania.
- Rzetelność test–retest – dlaczego sama korelacja Pearsona nie wykryje, że w retescie wszyscy uzyskali wyższy wynik.
- Standardowy błąd pomiaru (SEM) – typowy błąd wyniku jednej osoby w jednostkach skali; nie myl go ze skrótem modelowania równań strukturalnych.
- Metoda Blanda–Altmana – błąd systematyczny i granice zgodności dwóch metod pomiaru.
- Jak analizować skale bólu NRS i VAS – rozkład bólu wyjściowego, zmiana w punktach zamiast procentów i odsetki responderów z CI.
- Efekt sufitu i podłogi – jak skupienie wyników na krańcu skali zaniża wariancję i spłaszcza zmianę.
- Efekt uczenia się – poprawa przy drugim wykonaniu testu, która nie jest zmianą mierzonej cechy.
- Skala Tinetti – wynik POMA, ryzyko upadku i krzywa ROC.
- FES-I – obawa przed upadkiem: wynik, reguła braków i progi autorów.
- Skala Norton – ryzyko odleżyn: progi, czułość, swoistość i zgodność oceniających.
- WHOQOL-BREF – jakość życia w czterech domenach, przeliczenie 4–20 i 0–100.
- PSQI – jakość snu: siedem komponentów i wynik globalny 0–21.
- GDS-15 – przesiew depresji u seniorów: klucz, progi i czułość.
- Skala Lawtona (IADL) – złożone czynności dnia codziennego: wersje punktacji i C-IADL.
- EPDS – przesiew depresji poporodowej, progi i plan bezpieczeństwa przy pozycji 10.
Etap 4. Liczebność próby
W badaniu przed i po potrzebna liczebność zależy nie tylko od oczekiwanego efektu, ale też od korelacji między pomiarami: im wyższa, tym mniej osób wystarczy. W badaniu z dwiema grupami ANCOVA z pomiarem wyjściowym jako kowariantem ma większą moc niż porównanie różnic post − pre (Van Breukelen, 2006), więc warto ją uwzględnić już w planie liczebności. Efekt, który chcesz wykryć, uzasadnij najmniejszą różnicą ważną dla pacjenta albo ostrożnym oszacowaniem z metaanalizy. Wynik pilotażu jest zbyt niepewny, żeby na nim opierać obliczenia.
- Kalkulator liczebności próby – liczba osób do testu t, korelacji i ankiety z podanym efektem, α i mocą.
- Korelacja pomiarów przed i po – jak korelacja pomiarów zmienia liczebność w badaniu bez grupy kontrolnej i skąd wziąć jej wartość.
- Dobór liczebności próby – analiza mocy, planowanie precyzji, SESOI i analiza wrażliwości, gdy liczebność ogranicza budżet.
- Analiza mocy a priori w G*Power – które pola wypełnić i jak opisać obliczenie w pracy.
- MCID – najmniejsza poprawa uznawana przez pacjentów za ważną, czyli dobry kandydat na efekt do analizy mocy.
- Badanie pilotażowe – co pilotaż sprawdza (wykonalność, procedurę, narzędzie) i dlaczego nie służy do szacowania efektu.
Etap 5. Dane: braki, utrata uczestników i ITT
W badaniach interwencyjnych prawie zawsze ktoś rezygnuje albo nie przychodzi na pomiar końcowy. Pokaż przepływ uczestników na diagramie CONSORT, porównaj odsetki utraty w grupach i sprawdź, czy osoby utracone różniły się na starcie od pozostałych. Analizą główną zostaw analizę zgodną z zamiarem leczenia (ITT), a analizę per protocol podaj jako uzupełniającą, bo odpowiada na inne pytanie i bywa obciążona. Nie uzupełniaj braków ostatnią obserwacją (LOCF) ani średnią; przy pomiarach powtarzanych lepszy jest model mieszany albo imputacja wielokrotna.
- Utrata uczestników (attrition) – utrata różnicowa i nieróżnicowa oraz jak ją raportować na diagramie przepływu.
- Analiza ITT – dlaczego analizuje się wszystkie zrandomizowane osoby w grupach, do których je przydzielono.
- Analiza per protocol – kogo obejmuje, kiedy ma sens i skąd bierze się jej obciążenie.
- Adherencja – jak mierzyć przestrzeganie protokołu i wierność interwencji oraz gdzie te miary opisać.
- LOCF i proste imputacje – dlaczego obciążają wynik i co zastosować zamiast nich.
- Braki danych MCAR, MAR i MNAR – mechanizmy braków i to, czego nie da się rozstrzygnąć na podstawie samych danych.
- Braki danych i imputacja wielokrotna w R – opis braków, test Little’a, imputacja ze zmiennymi pomocniczymi i reguły Rubina.
Etap 6. Analiza główna: efekt interwencji
Przy dwóch grupach i pomiarze przed i po efekt interwencji możesz oszacować na kilka sposobów. W badaniu z randomizacją ANCOVA i analiza różnic są nieobciążone, ale ANCOVA jest precyzyjniejsza, dlatego zwykle to ją planuje się jako analizę główną; w grupach nierandomizowanych, które różnią się na starcie, obie metody mogą dawać sprzeczne wyniki (Van Breukelen, 2006). W jednej grupie z dwoma pomiarami użyj testu t dla prób zależnych albo testu Wilcoxona i podaj wielkość efektu, zaznaczając, którą wersję d policzyłeś(-aś). Przy trzech pomiarach i więcej, zwłaszcza z brakami, sięgnij po model mieszany. Gdy wynikiem jest czas do zdarzenia (np. nawrotu), potrzebujesz analizy przeżycia.
- ANCOVA w badaniu przed i po – porównanie ANOVA mieszanej, analizy różnic, ANCOVA i modelu mieszanego na jednym badaniu, z paradoksem Lorda.
- ANCOVA (analiza kowariancji) – założenia, średnie skorygowane i homogeniczność nachyleń.
- Test t dla prób zależnych – test na różnicach, w którym normalność dotyczy różnic, a nie surowych wyników.
- Test Wilcoxona dla par – rangowa alternatywa dla dwóch pomiarów tych samych osób i jak opisać jej wynik.
- Wielkość efektu dla prób zależnych – dz, dav i drm: czym się różnią i którą podać.
- ANOVA z powtarzanymi pomiarami czy model mieszany? – kiedy wystarczy ANOVA, a kiedy braki i nierówne odstępy wymagają modelu mieszanego.
- Badanie wiedzy przed i po szkoleniu – wynik testu wiedzy, pojedyncze pytania 0/1 (McNemar z korektą Holma) i poziomy wiedzy (Bowker).
- Analiza przeżycia: Kaplan–Meier i model Coxa – krok po kroku dla wyniku, którym jest czas do zdarzenia z obserwacjami cenzurowanymi.
Etap 7. Zmiana u pacjenta i znaczenie kliniczne
Istotny efekt w grupie nie mówi, ilu pacjentom realnie się poprawiło. Do oceny zmiany u jednej osoby służy wskaźnik wiarygodnej zmiany: Jacobson i Truax (1991) połączyli go z kryterium przejścia z zakresu populacji klinicznej do funkcjonalnej i w ten sposób zdefiniowali klinicznie istotną zmianę. MDC95 wyraża ten sam próg w punktach skali, a MCID mówi, czy zmianę odczuł pacjent. Odsetek responderów podawaj z 95% przedziałem ufności, ale jako uzupełnienie analizy wyniku ciągłego, bo dychotomizacja obniża moc. Zawsze napisz, skąd wziąłeś rzetelność i odchylenie standardowe do obliczeń.
- Wiarygodna i klinicznie istotna zmiana: RCI, MDC i MCID – trzy progi zmiany krok po kroku i jak raportować odsetki responderów.
- Kalkulator RCI i MDC – RCI, SEM, MDC95 i punkt c Jacobsona–Truaxa z Twoich danych lub z literatury.
- Wskaźnik wiarygodnej zmiany (RCI) – wzór i próg |RCI| > 1.96 oraz dlaczego RCI nie ocenia znaczenia klinicznego.
- Minimalna wykrywalna zmiana (MDC) – najmniejsza zmiana, której z 95% pewnością nie wyjaśnia błąd pomiaru.
- Klinicznie istotna zmiana według Jacobsona i Truax – kryteria a, b i c oraz podział pacjentów na kategorie zmiany.
- Analiza responderów – jak porównać grupy pod względem odsetka osób z poprawą powyżej progu.
- Zmiana procentowa – dlaczego „poprawa o 30%” bywa myląca i jak ją podawać obok analizy w punktach.
Etap 8. Raport: CONSORT, efekty bezwzględne i opis w pracy
Badanie z randomizacją opisz według listy CONSORT 2025. Przy wyniku binarnym podaj miarę względną (RR lub OR) i bezwzględną (różnicę ryzyka) z 95% CI, bo samo ryzyko względne przecenia efekt; nie raportuj wyników wyłącznie jako wartości p i nie testuj różnic wyjściowych między grupami randomizowanymi (Hopewell i in., 2025). W analizie podgrup pytaj, czy efekty w podgrupach różnią się między sobą, czyli testuj interakcję. W pracy dyplomowej przy wyniku ciągłym podaj średnie skorygowane, różnicę między grupami z przedziałem ufności i wielkość efektu.
- Statystyka w publikacji medycznej – STROBE, CONSORT, Tabela 1 bez wartości p, regresja logistyczna i ROC.
- NNT – liczba osób, które trzeba leczyć: wzór, horyzont czasowy i przedział ufności.
- Ryzyko względne (RR) – jak je policzyć i dlaczego przy częstym zdarzeniu nie zastępuje się go ilorazem szans.
- Analiza podgrup – test interakcji zamiast osobnych testów w każdej podgrupie.
- Jak opisać wyniki w stylu APA – 18 gotowych wzorów zdań z liczbami, m.in. dla testu t dla prób zależnych i testu Wilcoxona.
- Wielkość efektu – interpretacja – miara do planu badania, przedział ufności i porównanie z MCID zamiast progów Cohena.
Mam problem – co przeczytać
Tabela zbiera pytania, które najczęściej pojawiają się przy pracach z interwencją. W prawej kolumnie są strony, od których warto zacząć.
| Mój problem | Przeczytaj |
|---|---|
| Mam jedną grupę zmierzoną przed i po. Czy mogę napisać, że terapia zadziałała? | schemat pretest–posttest, regresja do średniej |
| Nie wiem, czy porównywać różnice post − pre, czy robić ANCOVA | wynik różnicowy |
| Grupy różniły się już w pomiarze wyjściowym | paradoks Lorda we wpisie o ANCOVA |
| Grup nie losowano – interwencja była na jednym oddziale, a drugi służył do porównania | różnica w różnicach (DiD), propensity score: dopasowanie i ważenie |
| Część pacjentów nie przyszła na pomiar końcowy | utrata uczestników |
| Kilka osób przerwało terapię. Usunąć je z analizy? | analiza ITT |
| Ból w skali 0–10: podać średnią czy medianę? | skale bólu NRS i VAS, skala NRS |
| Różnice między pomiarami są silnie skośne, a próba mała | testy nieparametryczne krok po kroku |
| Mam trzy pomiary: przed, po i po trzech miesiącach | pomiar odroczony, ANOVA z powtarzanymi pomiarami krok po kroku |
| Odpowiedzi tak/nie na te same pytania przed i po szkoleniu | test McNemara |
| Kategorie (np. niski, średni, wysoki poziom) przed i po | test symetrii Bowkera |
| Wynik testu wiedzy jest blisko maksimum już przed szkoleniem | znormalizowany przyrost |
| Czy poprawa u konkretnego pacjenta nie jest tylko błędem pomiaru? | kalkulator RCI i MDC |
| Promotor pyta, czy efekt ma znaczenie kliniczne | RCI, MDC i MCID |
| Porównuję dwa urządzenia albo dwie metody pomiaru | metoda Blanda–Altmana |
| Efekt wyszedł tylko u kobiet | czynnik zakłócający a modyfikator efektu |
| Wynikiem jest czas do nawrotu, a część osób nie miała zdarzenia | obserwacja cenzurowana, krzywa Kaplana–Meiera |
| Recenzent albo promotor chce NNT zamiast samego d | konwerter wielkości efektu |
| Wynik binarny u pacjentów z kilku szpitali. | Wielopoziomowa regresja logistyczna |
| Pacjenci mieli wizyty w różnych terminach. | Modele wzrostu w lme4 |
| Szukam punktu odcięcia dla skali przesiewowej. | Krzywa ROC i punkt odcięcia |
| Pomiar przed i po dla odpowiedzi tak/nie. | Test McNemara |
| Mam grupę kontrolną i kilka pomiarów w czasie. | ANOVA mieszana |
| Czasopismo wymaga listy CONSORT albo STROBE. | Wytyczne raportowania |
| Oceniam ryzyko błędu badań obserwacyjnych w przeglądzie. | Newcastle–Ottawa i JBI |
| Część pacjentów umiera, zanim wystąpi badane zdarzenie. | Ryzyka konkurencyjne: Fine–Gray i CIF |
| Grupy różniły się na początku – ANCOVA czy zmiana wyniku? | Paradoks Lorda |
| Recenzent pyta, czemu w tabeli 1 nie ma wartości p. | Tabela 1 – opis próby |
| Porównuję nowy przyrząd pomiarowy ze standardem. | Zgodność dwóch metod pomiaru |
| Oceniam skutki programu wprowadzonego w określonym miesiącu. | Regresja segmentowa i ITS |
| AUC dwóch modeli jest podobne – który lepiej pomaga w decyzji? | Krzywa decyzyjna i NRI |
| Chcę porównać kilka interwencji, których nie testowano ze sobą bezpośrednio. | Metaanaliza sieciowa |
| Jak wylosować przydział do grup w badaniu klinicznym? | Randomizacja w praktyce |
| Czy narzędzie wykrywa zmianę po terapii? | Responsywność narzędzia |
| Mierzę kinezjofobię albo katastrofizację bólu. | TSK – jak policzyć wynik |
Najważniejsze hasła ze słownika
Poniżej hasła, których nie było w liście etapów, a które przydają się w pracach z interwencją, epidemiologii i diagnostyce. Każde ma definicję, przykład i wzór opisu.
Schematy obserwacyjne i zmienne zakłócające
- Badanie kohortowe – osoby z ekspozycją i bez niej śledzone w czasie; zapadalność, ryzyko względne i różnica ryzyk.
- Badanie kliniczno-kontrolne – start od wyniku, a właściwą miarą jest iloraz szans.
- Czynnik zakłócający a modyfikator efektu – co trzeba usunąć korektą, a co opisać osobnymi wynikami.
- Propensity score – wyrównanie grup pod względem zmierzonych cech i kontrola równowagi w SMD.
- Chorobowość i zapadalność – licznik, mianownik i okres dla obu miar.
- Standaryzacja względem wieku – porównanie populacji o różnej strukturze wieku.
- Ryzyko konkurencyjne i CIF – dlaczego 1 − Kaplan–Meier zawyża ryzyko, gdy zgon wyklucza zdarzenie.
- Zmienna zderzeniowa – kontrola wspólnego skutku tworzy fałszywy związek.
Miary efektu dla wyniku binarnego i czasu do zdarzenia
- Iloraz szans (OR) – obliczenie, przedział ufności na skali logarytmicznej i interpretacja.
- Iloraz hazardów (HR) – względne tempo zdarzeń w modelu Coxa, a nie odsetek osób ze zdarzeniem.
- Analiza przeżycia – przegląd metod: Kaplan–Meier, log-rank i regresja Coxa.
- Test log-rank – porównanie krzywych przeżycia grup i dlaczego trzeba dołączyć mediany.
- Model Coxa – kilka predyktorów czasu do zdarzenia i założenie proporcjonalnych hazardów.
Testy diagnostyczne i przesiewowe
- Czułość i swoistość – obie zależą od punktu odcięcia, więc podawaj je razem z CI.
- Wartość predykcyjna PPV i NPV – zależność od chorobowości w badanej grupie.
- Iloraz wiarygodności (LR+, LR−) – jak wynik testu zmienia szansę choroby.
- Krzywa ROC – AUC i wybór punktu odcięcia.
- Punkt odcięcia – skąd bierze się próg w kwestionariuszu przesiewowym.
Zmiana i pomiary powtarzane
- Wynik różnicowy – kiedy wystarcza post − pre, a kiedy lepsza jest ANCOVA.
- Znormalizowany przyrost – część możliwej poprawy osiągnięta po szkoleniu.
- ANOVA z powtarzanymi pomiarami – sferyczność i poprawka Greenhouse’a–Geissera.
- Model wielopoziomowy (model mieszany) – pomiary zagnieżdżone w osobach i efekty losowe.
- Test McNemara – odpowiedzi tak/nie tych samych osób w dwóch pomiarach.
Kalkulatory przydatne w badaniach przed i po
Kalkulatory działają w przeglądarce, a pod wynikiem mają wzory i kod R. Przydają się do sprawdzenia liczb z programu i do progów, których program statystyczny sam nie podaje.
- Kalkulator RCI i MDC – wiarygodna zmiana u jednej osoby, SEM, MDC95 i punkt c; najważniejszy kalkulator dla tego przewodnika.
- Kalkulator liczebności próby – liczebność do testu t i korelacji na etapie planu.
- Konwerter wielkości efektu – przeliczenie t na d i dz, d na OR oraz d na NNT z uwzględnieniem odsetka poprawy w grupie kontrolnej.
- Kalkulator przedziału ufności – CI dla średniej, proporcji (Wilson) i różnicy średnich, np. dla odsetka responderów.
- Kalkulator ICC i efektu schematu – ICC, efekt schematu i liczba oddziałów lub przychodni w badaniu z randomizacją klastrową.
- Kalkulator testu diagnostycznego – czułość, swoistość, PPV, NPV i ilorazy wiarygodności z przedziałami ufności.
- Kalkulator kappy Cohena i testu McNemara – zgodność dwóch oceniających i zmiana odsetka w parach przed–po.
- Kalkulator tabeli 2×2 i r×c – chi-kwadrat, test Fishera, V Craméra, OR, RR i różnica odsetków z przedziałami ufności.
- Kalkulator metaanalizy – model losowy, I², przedział predykcji i wykres lasu do pobrania.
Kiedy warto poprosić o pomoc
Najwięcej błędów w pracach z interwencją powstaje na etapach 1–5: przy wyborze grupy porównawczej, pomiaru i sposobu postępowania z osobami, które odpadły. Tych decyzji nie da się naprawić po zebraniu danych, dlatego konsultacja ma największy sens przed rekrutacją. Jeśli dane już masz, możemy sprawdzić, czy analiza odpowiada schematowi badania, policzyć efekt z przedziałem ufności i progi zmiany klinicznej oraz wyjaśnić wyniki tak, żebyś umiał(a) je opisać i obronić – szczegóły są na stronie analiz statystycznych dla studentów. Pracę piszesz sam(a), a z pomocy korzystasz zgodnie z zasadami swojej uczelni.
Inne przewodniki w serwisie: statystyka w pracy dyplomowej (cała droga od hipotez do obrony), testy statystyczne (wybór testu do hipotezy), analiza kwestionariusza (wynik skali i rzetelność) oraz psychometria i budowa skal.
Najczęstsze pytania
Od czego zacząć analizę badania z pomiarem przed i po?
Od schematu badania, a nie od testu. Ustal, czy masz grupę kontrolną i czy przydział był losowy, bo od tego zależy, czy wolno Ci przypisać zmianę interwencji. Potem sprawdź błąd pomiaru narzędzia i zapisz z góry analizę główną. Kolejność kroków pokazuje ścieżka w tym przewodniku.
Jaką analizę wybrać w badaniu z grupą kontrolną i pomiarem wyjściowym?
W badaniu z randomizacją zwykle ANCOVA z wynikiem końcowym jako zmienną zależną i pomiarem wyjściowym jako kowariantem. Analiza różnic post − pre też jest nieobciążona, ale ma mniejszą moc (Van Breukelen, 2006). Przy kilku pomiarach i brakach danych lepszy jest model mieszany. Porównanie metod znajdziesz we wpisie o ANCOVA w badaniu przed i po.
Co zrobić z uczestnikami, którzy odpadli z badania interwencyjnego?
Nie usuwaj ich po cichu. Pokaż przepływ uczestników na diagramie CONSORT, porównaj utratę między grupami i analizuj osoby w grupach, do których je przydzielono (ITT). Braki uzupełnij imputacją wielokrotną albo uwzględnij w modelu mieszanym, a nie ostatnią obserwacją (LOCF).
Jak sprawdzić, czy poprawa pojedynczego pacjenta jest klinicznie istotna?
Najpierw policz wskaźnik wiarygodnej zmiany (RCI): jeśli |RCI| przekracza 1.96, zmiana jest większa niż błąd pomiaru. Klinicznie istotna zmiana według Jacobsona i Truax (1991) wymaga dodatkowo przejścia za punkt odcięcia między populacją kliniczną a funkcjonalną. Obie wartości policzysz w kalkulatorze RCI i MDC.
Czy w pracy dyplomowej z badaniem interwencyjnym trzeba stosować CONSORT?
CONSORT to wytyczne raportowania badań z randomizacją i nawet wtedy, gdy uczelnia ich nie wymaga, warto użyć ich jako listy kontrolnej. Wersja z 2025 roku zaleca m.in. podawanie miar względnych i bezwzględnych z 95% CI i rezygnację z testów różnic wyjściowych między grupami randomizowanymi (Hopewell i in., 2025). Wymagania formalne sprawdź w regulaminie swojej uczelni.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikRCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →PoradnikStatystyka dla fizjoterapeuty
Pomiar przed i po terapii, test t i Wilcoxona, MCID dla skali NRS, ANCOVA, trzy pomiary, ICC i regresja do średniej – z danymi, kodem R i opisem APA.
Czytaj →Planujesz badanie z interwencją albo masz już wyniki przed i po?
Sprawdzimy, czy analiza pasuje do schematu badania, policzymy efekt interwencji z przedziałem ufności oraz progi zmiany klinicznej i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006x.59.1.12
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{jacobson1991clinical, author={Jacobson, Neil S. and Truax, Paula}, title={{Clinical significance: A statistical approach to defining meaningful change in psychotherapy research}}, journal={Journal of Consulting and Clinical Psychology}, year={1991}, volume={59}, number={1}, pages={12--19}, doi={10.1037/0022-006x.59.1.12}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}