Co to jest model wielopoziomowy?
Model wielopoziomowy (ang. multilevel model; także hierarchiczny model liniowy, HLM, albo liniowy model mieszany, LMM) to regresja dla danych o strukturze zagnieżdżonej: uczniów w klasach, pracowników w zespołach, pacjentów u terapeutów albo kolejnych pomiarów u tych samych osób. Oprócz efektów stałych – przeciętnych zależności, takich jak współczynniki zwykłej regresji liniowej – model szacuje efekty losowe, czyli to, jak bardzo wyrazy wolne i nachylenia różnią się między grupami (klasami, zespołami, osobami).
Polskojęzyczne wprowadzenie przedstawiają Radkiewicz i Zieliński (2010): zalecają te modele, gdy naruszone jest założenie niezależności obserwacji, i omawiają efekty stałe i losowe, strukturę danych wielopoziomowych, interakcje międzypoziomowe oraz komponenty wariancji. Klasycznymi podręcznikami są prace Raudenbusha i Bryka (2002) – w drugim wydaniu rozszerzone o wyniki binarne, liczebności i dane porządkowe (zob. regresja logistyczna, regresja porządkowa, regresja Poissona) – oraz przystępny podręcznik Hoxa, Moerbeek i van de Schoota (2017) z przykładami z psychologii i edukacji.
Dlaczego nie zwykła regresja?
Uczniowie z jednej klasy są do siebie bardziej podobni niż uczniowie z różnych klas – mają tego samego nauczyciela, podobne warunki i wpływają na siebie nawzajem. Zwykła regresja traktuje jednak 800 uczniów jak 800 niezależnych informacji, przez co zaniża błędy standardowe, zwłaszcza dla zmiennych opisujących całe klasy, i zbyt często daje wyniki istotne (błąd I rodzaju). Skalę problemu opisuje efekt schematu:
gdzie nśr to średnia liczebność grupy, a ICC – korelacja wewnątrzklasowa, czyli odsetek wariancji przypadający na różnice między grupami. Przy 20 uczniach w klasie i ICC = .22 efekt schematu wynosi 5.17: dla efektów na poziomie klas 800 uczniów niesie tyle informacji co około 155 niezależnych obserwacji.
Równania modelu: efekty stałe i losowe
Model zapisuje się na dwóch poziomach. Poziom 1 opisuje ucznia i w klasie j, poziom 2 – klasy:
Poziom 2: β0j = γ00 + γ01Zj + u0j β1j = γ10 + u1j
- γ00, γ10, γ01 – efekty stałe: przeciętny wyraz wolny, przeciętne nachylenie predyktora ucznia X (np. lęku) i efekt predyktora klasy Z (np. profilu klasy);
- u0j – odchylenie wyrazu wolnego klasy j (wariancja τ00), u1j – odchylenie jej nachylenia (wariancja τ11);
- eij – reszta na poziomie ucznia (wariancja σ²).
Model z samym u0j to model z losowym wyrazem wolnym: klasy mają różne średnie, ale ten sam związek X z Y. Dodanie u1j daje model z losowym nachyleniem. Jeśli do równania na β1j wprowadzisz Zj, otrzymasz interakcję międzypoziomową – sprawdzasz wtedy, czy cechy klasy zmieniają siłę związku na poziomie ucznia. Sondowanie takich interakcji (proste nachylenia, technika Johnsona–Neymana) działa w modelach wielopoziomowych podobnie jak w zwykłej regresji (Bauer i Curran, 2005; zob. analiza moderacji krok po kroku).
Model pusty (bez predyktorów) pozwala policzyć korelację wewnątrzklasową: ICC = τ00 / (τ00 + σ²).
Przykład: lęk matematyczny i wyniki testu w 40 klasach
W badaniu (dane symulowane) 800 uczniów z 40 klas (od 12 do 28 osób w klasie; 20 klas o profilu rozszerzonym i 20 o podstawowym) napisało test z matematyki (0–50 punktów) i wypełniło skalę lęku matematycznego (1–5). Analizę prowadzimy według trzyetapowej procedury, którą Sommet i Morselli (2017) zaproponowali dla wielopoziomowej regresji logistycznej, a którą łatwo przenieść na model liniowy.
Krok 1. Model pusty i ICC. Wariancja między klasami wyniosła τ00 = 12.35, a wariancja w obrębie klas σ² = 43.88, więc ICC = 12.35 / (12.35 + 43.88) = .22. Prawie jedna czwarta zróżnicowania wyników to różnice między klasami – zwykła regresja byłaby tu błędem.
Krok 2. Czy nachylenie różni się między klasami? Do modelu z losowym wyrazem wolnym, lękiem (wyśrodkowanym względem średniej ogólnej, M = 2.82) i profilem klasy dodaliśmy losowe nachylenie lęku. Test ilorazu wiarygodności wskazał, że to poprawia dopasowanie, χ²(2) = 12.99, p = .002. Odchylenie standardowe nachyleń wynosi 1.70, więc w 95% klas nachylenie mieściłoby się mniej więcej między −6.49 a 0.18 punktu na 1 punkt lęku – w części klas związek jest bardzo silny, w innych prawie zerowy. W modelu bez losowego nachylenia błąd standardowy efektu lęku był zaniżony (0.28 zamiast 0.39).
Krok 3. Model końcowy. Wyższy lęk wiązał się z niższym wynikiem: b = −3.15, 95% CI [−3.92, −2.39], t(41.40) = −8.06, p < .001 – w przeciętnej klasie każdy dodatkowy punkt lęku to ok. 3 punkty testu mniej. Uczniowie klas rozszerzonych uzyskiwali średnio o 3.27 punktu więcej, 95% CI [1.13, 5.40], t(37.65) = 2.99, p = .005. Efekty stałe wyjaśniają 16% wariancji (R²m = .16), a razem z efektami losowymi – 37% (R²c = .37). Profil klasy nie był przydzielany losowo, więc ten efekt opisuje związek, a nie wpływ przyczynowy.
Dla porównania naiwna regresja MNK oszacowała efekt profilu na 2.95 z błędem standardowym 0.49 – ponad dwukrotnie mniejszym niż w modelu wielopoziomowym (1.09). Stosunek 2.24 jest bliski pierwiastkowi z efektu schematu (√5.17 = 2.27).
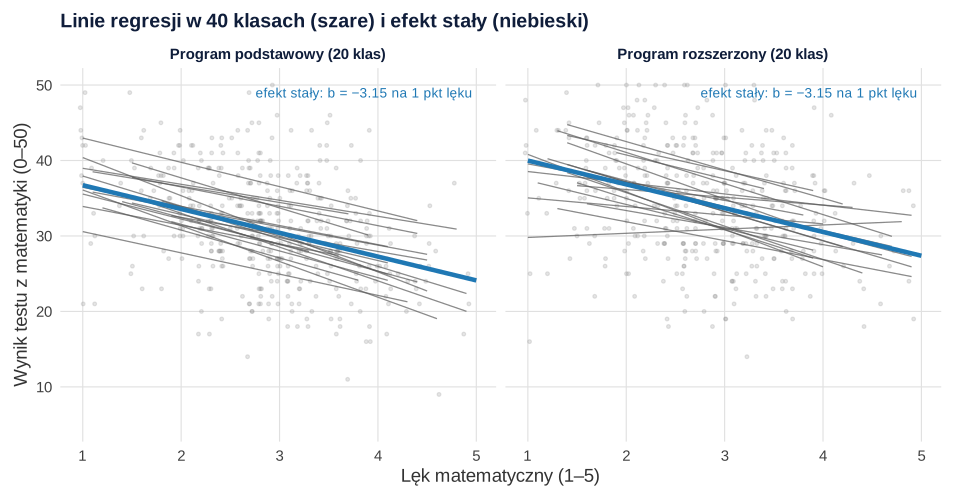
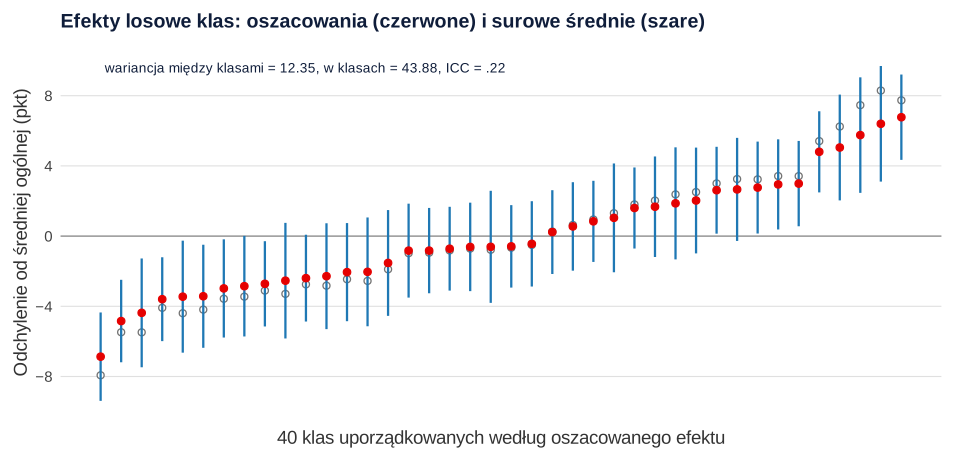
Rysunek 2 pokazuje ważną cechę efektów losowych – ściąganie do średniej (ang. shrinkage). Dla klasy K21, liczącej 12 uczniów, surowa średnia była o 8.29 punktu wyższa od średniej ogólnej, a oszacowany efekt losowy wynosi 6.40: model łączy informację z danej klasy z informacją o wszystkich klasach. Przedziały 17 z 40 klas nie obejmują zera.
Estymacja, centrowanie i liczba grup
- REML czy ML? Funkcja
lmer()z pakietu lme4 dopasowuje modele mieszane metodą największej wiarygodności (ML) lub REML, a efekty stałe i losowe definiuje się w formule modelu (Bates i in., 2015). REML lepiej szacuje wariancje; modele różniące się efektami stałymi porównuj testem ilorazu wiarygodności na modelach ML (w przykładzie dla profilu χ²(1) = 8.39, p = .004). Pakiet lmerTest dodaje testy t i F ze stopniami swobody Satterthwaite’a. - Centrowanie. Centrowanie względem średniej ogólnej (jak w przykładzie) ułatwia interpretację wyrazu wolnego. Centrowanie względem średniej klasy, uzupełnione o średnią klasową jako predyktor poziomu 2, pozwala oddzielić efekt wewnątrz- i międzyklasowy.
- Liczba grup. Precyzja efektów poziomu 2 i wariancji τ zależy przede wszystkim od liczby klas, a nie od liczby uczniów. Przy kilku grupach (np. trzech szkołach) wariancji między nimi nie da się sensownie oszacować.
Jak opisać wynik (APA)
Podaj strukturę danych, ICC z modelu pustego, sposób estymacji, efekty stałe z 95% CI i komponenty wariancji. Przykładowy opis:
Tabela 1
Wielopoziomowy model wyników testu z matematyki
| Parametr | b | SE | 95% CI | t (df) | p |
|---|---|---|---|---|---|
| Efekty stałe | |||||
| Wyraz wolny | 30.97 | 0.77 | [29.46, 32.48] | 40.23 (37.34) | < .001 |
| Lęk matematyczny (wyśrodkowany) | −3.15 | 0.39 | [−3.92, −2.39] | −8.06 (41.40) | < .001 |
| Profil rozszerzony (vs podstawowy) | 3.27 | 1.09 | [1.13, 5.40] | 2.99 (37.65) | .005 |
| Efekty losowe (wariancje) | |||||
| Wyraz wolny klasy (τ00) | 9.92 | ||||
| Nachylenie lęku (τ11) | 2.90 | ||||
| Korelacja wyrazu wolnego i nachylenia | .03 | ||||
| Reszta (σ²) | 36.16 | ||||
Uwaga. N = 800 uczniów w 40 klasach. Estymacja REML, stopnie swobody Satterthwaite’a. ICC (model pusty) = .22; R²m = .16, R²c = .37.
Przykład w R
Kod generuje dane z przykładu i przeprowadza trzy kroki analizy w pakietach lme4 i lmerTest: model pusty z ICC, test losowego nachylenia i model końcowy z 95% CI. Liczby w tekście, tabeli i na rysunkach pochodzą z tego kodu (R² i porównanie z regresją MNK – w pełnym skrypcie strony).
Model z losowym wyrazem wolnym i losowym nachyleniem
R
library(lmerTest)                     # lme4 + testy t i F z poprawką Satterthwaite'a
options(show.signif.stars = FALSE)
set.seed(127)
J <- 40                                                        # liczba klas
n_j <- sample(12:28, J, replace = TRUE)                        # liczebności klas
klasa <- factor(rep(sprintf("K%02d", 1:J), n_j))
profil <- rep(rep(0:1, each = J / 2), n_j)                     # 0 = podstawowy, 1 = rozszerzony
u0 <- rnorm(J, 0, 3); u1 <- rnorm(J, 0, 1.1)                   # odchylenia klas: wyraz wolny i nachylenie
lek <- round(pmin(pmax(rnorm(sum(n_j), 2.8, 0.8), 1), 5), 1)   # lęk matematyczny 1–5
j <- as.integer(klasa)
wynik <- round(30 + 4 * profil - 3 * (lek - 2.8) + u0[j] + u1[j] * (lek - 2.8) + rnorm(sum(n_j), 0, 6))
dane <- data.frame(klasa, profil = factor(profil, labels = c("podstawowy", "rozszerzony")),
                   lek, wynik = pmin(pmax(wynik, 0), 50))
dane$lek_c <- dane$lek - mean(dane$lek)                        # centrowanie względem średniej ogólnej

m0 <- lmer(wynik ~ 1 + (1 | klasa), data = dane)               # krok 1: model pusty
performance::icc(m0)
m1 <- lmer(wynik ~ lek_c + profil + (1 | klasa), data = dane)            # krok 2: losowy wyraz wolny
m2 <- lmer(wynik ~ lek_c + profil + (1 + lek_c | klasa), data = dane)    # + losowe nachylenie
anova(m1, m2, refit = FALSE)                                   # czy nachylenie różni się między klasami?
summary(m2)                                                    # krok 3: model końcowy
confint(m2, parm = "beta_", method = "Wald")                   # 95% CI efektów stałych
Wynik w R
# Intraclass Correlation Coefficient

    Adjusted ICC: 0.220
  Unadjusted ICC: 0.220
Data: dane
Models:
m1: wynik ~ lek_c + profil + (1 | klasa)
m2: wynik ~ lek_c + profil + (1 + lek_c | klasa)
   npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1    5 5258.2 5281.6 -2624.1    5248.2
m2    7 5249.2 5282.0 -2617.6    5235.2 12.989  2   0.001512
Linear mixed model fit by REML. t-tests use Satterthwaite's method [
lmerModLmerTest]
Formula: wynik ~ lek_c + profil + (1 + lek_c | klasa)
   Data: dane

REML criterion at convergence: 5235.2

Scaled residuals:
    Min      1Q  Median      3Q     Max
-3.0709 -0.6295  0.0107  0.6510  2.9254

Random effects:
 Groups   Name        Variance Std.Dev. Corr
 klasa    (Intercept)  9.922   3.150
          lek_c        2.896   1.702    0.03
 Residual             36.163   6.014
Number of obs: 800, groups:  klasa, 40

Fixed effects:
                  Estimate Std. Error      df t value Pr(>|t|)
(Intercept)        30.9734     0.7700 37.3433  40.226  < 2e-16
lek_c              -3.1532     0.3914 41.3977  -8.056 5.18e-10
profilrozszerzony   3.2653     1.0909 37.6535   2.993  0.00485

Correlation of Fixed Effects:
            (Intr) lek_c
lek_c        0.011
prflrzszrzn -0.706  0.009
                      2.5 %    97.5 %
(Intercept)       29.464287 32.482587
lek_c             -3.920278 -2.386057
profilrozszerzony  1.127240  5.403417
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Ignorowanie zagnieżdżenia – zwykła regresja lub ANOVA na danych z klas, zespołów czy powtarzanych pomiarów zaniża błędy standardowe (w przykładzie ponad dwukrotnie dla efektu profilu).
- Brak ICC i komponentów wariancji w raporcie – czytelnik nie wie, jak silne jest zagnieżdżenie i jak bardzo różnią się grupy.
- Pominięcie losowego nachylenia, które naprawdę występuje – błąd standardowy efektu poziomu 1 jest wtedy zaniżony (tu 0.28 zamiast 0.39).
- Porównywanie modeli o różnych efektach stałych na podstawie REML – do takich testów ilorazu wiarygodności użyj estymacji ML.
- Zbyt mało grup – z trzech szkół nie oszacujesz wariancji między szkołami; potraktuj je wtedy jako czynnik stały.
- Przeładowana struktura efektów losowych – komunikat
boundary (singular) fitw lme4 sygnalizuje, że części wariancji nie da się oszacować; uprość model.
Ten sam model opisuje też pomiary zagnieżdżone w osobach – to elastyczna alternatywa dla ANOVA z powtarzanymi pomiarami, która radzi sobie z brakami danych i nierównymi odstępami między pomiarami (zob. schemat podłużny).
Najczęstsze pytania
Kiedy stosować model wielopoziomowy?
Gdy obserwacje są zagnieżdżone w grupach i przez to nie są niezależne: uczniowie w klasach, pracownicy w zespołach, pacjenci u terapeutów, kolejne pomiary u tych samych osób. Jeśli ICC jest wyraźnie większe od zera, zwykła regresja zaniży błędy standardowe.
Czym różnią się efekty stałe od losowych?
Efekty stałe to przeciętne zależności w całej populacji, interpretowane jak współczynniki regresji. Efekty losowe opisują, jak bardzo grupy odchylają się od tych przeciętnych – np. wariancja wyrazów wolnych klas (różne średnie) i wariancja nachyleń (różna siła związku w klasach).
Jak obliczyć ICC w modelu wielopoziomowym?
Dopasuj model pusty, bez predyktorów, z losowym wyrazem wolnym. ICC = τ00 / (τ00 + σ²), gdzie τ00 to wariancja między grupami, a σ² – wariancja w grupach. W przykładzie na tej stronie ICC = 12.35 / (12.35 + 43.88) = .22. W R policzysz je funkcją performance::icc().
Ile grup potrzeba do modelu wielopoziomowego?
Precyzja wariancji między grupami i efektów poziomu grupy zależy głównie od liczby grup, a nie od liczby osób. Przy kilku grupach (np. trzech szkołach) wariancji między nimi nie da się sensownie oszacować – lepiej wtedy włączyć grupę do modelu jako czynnik stały.
Model wielopoziomowy czy ANOVA z powtarzanymi pomiarami?
Dla pomiarów zagnieżdżonych w osobach oba podejścia dają przy kompletnych danych podobne testy, ale model wielopoziomowy nie usuwa osób z brakami danych, radzi sobie z nierównymi odstępami między pomiarami i pozwala modelować indywidualne trajektorie (losowe nachylenia).
Jak zrobić model wielopoziomowy w R?
Użyj funkcji lmer() z pakietu lme4, np. lmer(wynik ~ lek + profil + (1 + lek | klasa), data = dane), gdzie część w nawiasie określa efekty losowe. Pakiet lmerTest dodaje wartości p ze stopniami swobody Satterthwaite’a, a anova(m1, m2, refit = FALSE) porównuje modele o różnych efektach losowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Hox, J. J., Moerbeek, M., & van de Schoot, R. (2017). Multilevel analysis: Techniques and applications (3rd ed.). Routledge. https://doi.org/10.4324/9781315650982
- Radkiewicz, P., & Zieliński, M. W. (2010). Hierarchiczne modele liniowe. Co nam dają i kiedy warto je stosować. Psychologia Społeczna, 5(2–3), 217–233. https://www.ceeol.com/search/article-detail?id=229295 ● Otwarty dostęp
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). Sage.
- Sommet, N., & Morselli, D. (2017). Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS. International Review of Social Psychology, 30(1), 203–218. https://doi.org/10.5334/irsp.90 ● Otwarty dostęp
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@book{hox2017multilevel, author={Hox, Joop J. and Moerbeek, Mirjam and van de Schoot, Rens}, title={{Multilevel analysis: Techniques and applications (3rd ed.)}}, year={2017}, publisher={Routledge}, doi={10.4324/9781315650982}}@article{radkiewicz2010hierarchiczne, author={Radkiewicz, Piotr and Zieliński, Marcin W.}, title={{Hierarchiczne modele liniowe. Co nam dają i kiedy warto je stosować}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={217--233}, url={https://www.ceeol.com/search/article-detail?id=229295}}@book{raudenbush2002hierarchical, author={Raudenbush, Stephen W. and Bryk, Anthony S.}, title={{Hierarchical linear models: Applications and data analysis methods (2nd ed.)}}, year={2002}, publisher={Sage}}@article{sommet2017keep, author={Sommet, Nicolas and Morselli, Davide}, title={{Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={203--218}, doi={10.5334/irsp.90}}