Co to jest schemat podłużny?
Schemat podłużny (ang. longitudinal design; badanie podłużne, badanie panelowe) to plan badania, w którym te same osoby mierzy się co najmniej dwa razy, zwykle trzy lub więcej, w odstępach czasu. Dzięki temu widać, jak zmieniają się poszczególne osoby, a nie tylko, czym różnią się osoby w jednym momencie. To podstawowa różnica wobec schematu przekrojowego, w którym, np. porównując studentów pierwszego i piątego roku, porównujesz różnych ludzi.
Moment pomiaru jest w takim badaniu czynnikiem wewnątrzobiektowym, a dane mają strukturę zagnieżdżoną: pomiary są zagnieżdżone w osobach. Ployhart i Vandenberg (2010) podkreślają, że badanie podłużne to nie tylko „kilka pomiarów”. Wymaga ono teorii zmiany: jak szybko zjawisko się zmienia, w jakim kształcie i dlaczego. Od niej zależy liczba i rozstaw pomiarów.
Rodzaje badań podłużnych
| Rodzaj | Charakterystyka | Przykład |
|---|---|---|
| Panel prospektywny | Kilka pomiarów tych samych osób w odstępach tygodni, miesięcy lub lat | Stres i sen studentów co 4 tygodnie przez semestr |
| Kohorta urodzeniowa lub wiekowa | Grupa osób urodzonych lub rozpoczynających etap życia w tym samym czasie, śledzona przez lata | Rocznik rozpoczynający studia, badany do końca studiów |
| Intensywny pomiar | Wiele pomiarów w krótkim czasie: dzienniczki, próbkowanie doświadczeń | Nastrój mierzony 5 razy dziennie przez 2 tygodnie |
| Schemat sekwencyjny | Kilka kohort śledzonych równolegle, by oddzielić wiek od pokolenia i momentu historycznego | Trzy roczniki uczniów badane przez 3 lata |
Intensywne dane z dzienniczków to granica między badaniem podłużnym a analizą szeregów czasowych. Pomiarów jest tak dużo, że można badać dynamikę u pojedynczej osoby.
Co daje schemat podłużny, a czego nie
- Zmiana wewnątrzosobowa. Możesz opisać, jak zmienia się każda osoba i czy ludzie różnią się tempem zmian.
- Kolejność w czasie. Widać, co poprzedza co. To warunek konieczny wnioskowania przyczynowego, ale niewystarczający – zmienne zakłócające działają też w czasie.
- Rozdzielenie dwóch poziomów związku. Curran i Bauer (2011) wskazują to jako szczególną zaletę danych podłużnych. Związek „między osobami” (czy ludzie, którzy zwykle robią więcej X, mają więcej Y?) i związek „wewnątrz osoby” (czy w okresach, gdy dana osoba robi więcej X, ma więcej Y?) to różne pytania. Ich odpowiedzi mogą mieć nawet przeciwne znaki.
- Mniej obciążone modele procesów. Maxwell i Cole (2007) pokazali, że przekrojowe analizy mediacji procesów rozwijających się w czasie dają zwykle wyraźnie obciążone oszacowania. Dzieje się tak nawet w idealnych warunkach.
Schemat podłużny nie usuwa natomiast problemu zmiennych zakłócających zmieniających się w czasie i nie zastąpi eksperymentu tam, gdzie da się go przeprowadzić.
Przykład: nauka i stres w ciągu semestru
W badaniu (dane symulowane) 150 osób studiujących wypełniało co 4 tygodnie krótką ankietę: ile godzin uczyły się w ostatnim tygodniu i jak silny był ich stres (PSS-10, 0–40). Ostatni, czwarty pomiar wypełniło 126 osób (ubytek 16%). Średni stres rósł w trakcie semestru: 24.63, 24.76, 25.83 i 26.75. Średnia liczba godzin nauki pozostawała podobna: 11.57, 11.41, 11.61 i 11.33.
Co pokazałby jeden pomiar? W pierwszej fali korelacja nauki ze stresem wyniosła r = −.12. Badanie przekrojowe sugerowałoby więc słaby związek: więcej nauki, nieco mniej stresu.
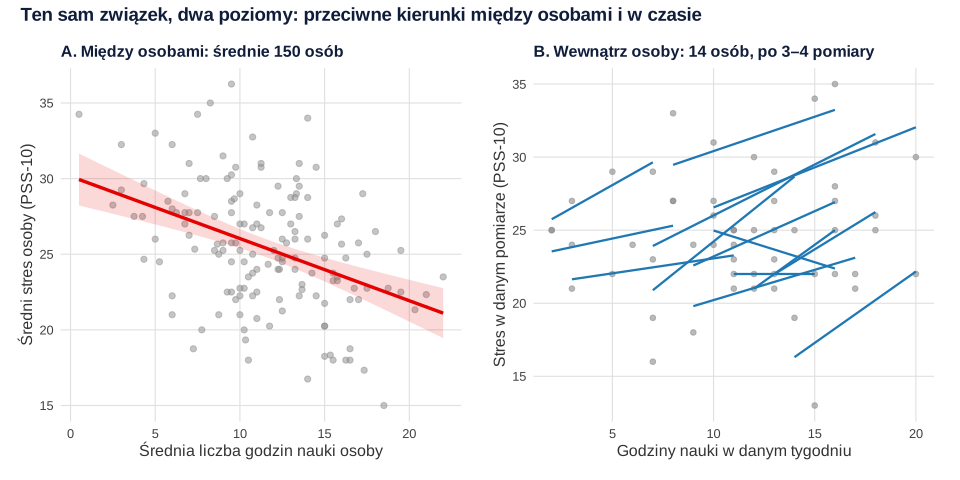
Co pokazują cztery pomiary? Model wielopoziomowy z losową stałą dla osoby rozdziela liczbę godzin nauki na dwie części. Pierwsza to średnia danej osoby ze wszystkich pomiarów (poziom „między osobami”). Druga to odchylenie w danym tygodniu od tej średniej (poziom „wewnątrz osoby”). Wyniki:
- Między osobami: osoby, które zwykle uczyły się o godzinę więcej, miały stres niższy o 0.41 punktu, 95% CI [−0.56, −0.27], p < .001.
- Wewnątrz osoby: w tygodniach, w których dana osoba uczyła się o godzinę więcej niż zwykle, jej stres był wyższy o 0.45 punktu, 95% CI [0.37, 0.53], p < .001.
- Czas: przy tej samej liczbie godzin nauki stres rósł o 0.75 punktu z każdym pomiarem (p < .001).
- Stałe różnice między osobami odpowiadały za 65% wariancji niewyjaśnionej przez predyktory (ICC = .65) – pomiary tej samej osoby były do siebie bardzo podobne.
Słaba korelacja przekrojowa była więc mieszanką dwóch przeciwnych związków. Kto na ogół uczy się systematycznie, jest mniej zestresowany. A tygodnie intensywnej nauki, np. przed kolokwium, są dla każdego bardziej stresujące. Jeden pomiar nie ma szans tego rozdzielić.
Decyzje przy planowaniu badania podłużnego
- Liczba pomiarów. Dwa pomiary pokazują tylko różnicę i mylą zmianę z błędem pomiaru (zob. regresja do średniej). Trzy to minimum do opisu kształtu zmiany, przy nieliniowych trajektoriach potrzeba więcej.
- Odstępy. Dopasuj je do tempa procesu. Nastrój zmienia się w godzinach, tożsamość zawodowa w latach. Zbyt rzadkie pomiary przeoczą zmianę, a zbyt częste zmęczą osoby badane.
- Ubytek. Zaplanuj przypomnienia i rekompensaty. Sprawdź, czy osoby, które odpadły, różniły się na starcie, a braki analizuj metodami opartymi na założeniu MAR, zamiast usuwać osoby (zob. braki danych).
- Ten sam pomiar w każdej fali. Porównanie średnich ma sens tylko wtedy, gdy narzędzie mierzy to samo w kolejnych pomiarach (zob. inwariancja pomiaru).
- Efekty powtarzania. Wypełnianie tej samej skali kilka razy może samo zmieniać odpowiedzi.
Do analizy służą ANOVA z powtarzanymi pomiarami (tylko kompletne dane, ten sam rozstaw), modele wielopoziomowe i modele krzywej latentnej. Ployhart i Vandenberg (2010) omawiają kompromisy między nimi. Do pytań o wzajemne oddziaływanie dwóch zmiennych w czasie stosuje się modele krzyżowo-opóźnione. Hamaker i in. (2015) pokazali jednak, że klasyczny model CLPM, który nie oddziela stałych różnic między osobami od procesu wewnątrzosobowego, może błędnie wskazać obecność, przewagę, a nawet znak wpływu. Proponują model z losowymi stałymi (RI-CLPM). Oba modele omawia wpis modele cross-lagged: CLPM i RI-CLPM.
Jak opisać badanie podłużne (APA)
Podaj liczbę pomiarów i odstępy, liczebność w każdej fali i sposób postępowania z brakami. W wynikach rozdziel efekty między osobami i wewnątrz osób, jeśli predyktor zmienia się w czasie.
Dane do takiego modelu muszą być w formacie długim – jeden wiersz na pomiar. Wybór między ANOVA a modelem mieszanym omawia wpis ANOVA z powtarzanymi pomiarami czy model mieszany?
Przykład w R
Kod tworzy dane z czterech pomiarów z ubytkiem w ostatniej fali, pokazuje średnie w czasie, korelację z jednego pomiaru i model wielopoziomowy rozdzielający efekt między osobami i wewnątrz osoby.
Model wielopoziomowy z rozdzieleniem efektów (lme4, lmerTest)
R
# Dane symulowane: schemat podłużny – 150 osób studiujących zbadano 4 razy w semestrze (co 4 tygodnie).
# Zmienne: godziny nauki w ostatnim tygodniu i stres (skala PSS-10, 0–40).
# Część osób nie wypełniła ostatniego pomiaru (ubytek próby).
suppressPackageStartupMessages(library(lmerTest))
set.seed(1891)
n <- 150; fale <- 4
id <- rep(1:n, each = fale); fala <- rep(0:(fale - 1), times = n)
nauka_os <- rnorm(n, 12, 4)                        # typowa liczba godzin nauki danej osoby
stres_os <- rnorm(n, 0, 3.5)                       # stałe różnice w poziomie stresu
nauka <- round(pmax(nauka_os[id] + rnorm(n * fale, sd = 3), 0))
stres <- 24 - 0.45 * (nauka_os[id] - 12) +                         # MIĘDZY osobami: więcej nauki – mniej stresu
         0.40 * (nauka - nauka_os[id]) +                         # WEWNĄTRZ osoby: tydzień z większą nauką – więcej stresu
         0.8 * fala + stres_os[id] + rnorm(n * fale, sd = 2.5)
dane <- data.frame(id = factor(id), fala, nauka, stres = round(pmin(pmax(stres, 0), 40)))
dane <- dane[!(dane$fala == 3 & dane$id %in% sample(levels(dane$id), 24)), ]   # ubytek w 4. pomiarze
table(dane$fala)                                                                  # liczba osób w każdym pomiarze

# 1. Zmiana w czasie: średnie w kolejnych pomiarach
aggregate(cbind(nauka, stres) ~ fala, data = dane, FUN = function(x) round(mean(x), 2))

# 2. Jeden pomiar (jak w badaniu przekrojowym): korelacja nauki i stresu w 1. fali
with(subset(dane, fala == 0), round(c(r = cor(nauka, stres)), 2))

# 3. Model wielopoziomowy: rozdzielenie efektu międzyosobowego i wewnątrzosobowego
dane$nauka_srednia_os <- ave(dane$nauka, dane$id)                 # średnia osoby ze wszystkich jej pomiarów
dane$nauka_odch <- dane$nauka - dane$nauka_srednia_os              # odchylenie od własnej średniej
model <- lmer(stres ~ fala + nauka_odch + I(nauka_srednia_os - 12) + (1 | id), data = dane)
round(summary(model)$coefficients, 3)
vc <- as.data.frame(VarCorr(model))
vc[, c("grp", "sdcor")]
round(c(ICC = vc$vcov[1] / sum(vc$vcov)), 2)                       # udział stałych różnic między osobami
round(confint(model, parm = c("nauka_odch", "I(nauka_srednia_os - 12)"), method = "Wald"), 2)
Wynik w R
  0   1   2   3
150 150 150 126
  fala nauka stres
1    0 11.57 24.63
2    1 11.41 24.76
3    2 11.61 25.83
4    3 11.33 26.75
    r
-0.12
                         Estimate Std. Error      df t value Pr(>|t|)
(Intercept)                24.145      0.335 212.443  72.155        0
fala                        0.753      0.097 427.017   7.741        0
nauka_odch                  0.451      0.042 424.221  10.808        0
I(nauka_srednia_os - 12)   -0.411      0.074 148.728  -5.538        0
       grp    sdcor
1       id 3.465780
2 Residual 2.536973
 ICC
0.65
                         2.5 % 97.5 %
nauka_odch                0.37   0.53
I(nauka_srednia_os - 12) -0.56  -0.27
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4 i lmerTest; rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Nazywanie badaniem podłużnym porównania różnych roczników. Pierwszy i piąty rok studiów zbadane w tym samym miesiącu to schemat przekrojowy.
- Usuwanie osób z brakującym pomiarem. Analiza tylko kompletnych przypadków marnuje dane i może zniekształcić wynik, jeśli odpadają osoby o określonych cechach.
- Mieszanie efektu między osobami i wewnątrz osoby w jednym współczynniku – jak w przykładzie, wynik może być bliski zera, choć oba efekty są wyraźne.
- Analiza pomiarów jako niezależnych obserwacji, np. zwykła regresja na 576 wierszach bez uwzględnienia, że pochodzą od 150 osób.
- Odstępy dobrane do kalendarza, a nie do procesu. Pomiar „na początku i na końcu roku” może przeoczyć zmianę, która trwała dwa tygodnie.
- Wnioski przyczynowe z samej kolejności w czasie. To, że X poprzedza Y, nie wyklucza wspólnej przyczyny.
Najczęstsze pytania
Co to jest badanie podłużne?
To badanie, w którym te same osoby mierzy się kilka razy w czasie, np. co miesiąc przez semestr. Pozwala zobaczyć, jak zmieniają się poszczególne osoby i co poprzedza co, czego nie da się uzyskać z jednego pomiaru.
Czym różni się badanie podłużne od przekrojowego?
W badaniu przekrojowym mierzysz różne osoby jeden raz, np. studentów pierwszego i piątego roku w tym samym miesiącu. W podłużnym mierzysz te same osoby wielokrotnie, więc możesz oddzielić zmianę u danej osoby od różnic między ludźmi, np. pokoleniowych.
Ile pomiarów potrzeba w badaniu podłużnym?
Co najmniej dwa, ale dwa pomiary pokazują tylko różnicę i mylą zmianę z błędem pomiaru. Trzy pomiary to minimum do opisu kształtu zmiany, a przy nieliniowych trajektoriach i modelach krzyżowo-opóźnionych potrzeba zwykle więcej.
Co zrobić z osobami, które odpadły z badania podłużnego?
Nie usuwaj ich automatycznie. Opisz ubytek w każdej fali, sprawdź, czy osoby, które odpadły, różniły się na starcie, i użyj metod wykorzystujących wszystkie dostępne pomiary (model wielopoziomowy, metoda największej wiarygodności, imputacja wielokrotna).
Czym jest efekt wewnątrzosobowy w danych podłużnych?
To związek między zmianami u tej samej osoby: czy w okresach, gdy dana osoba ma więcej X, ma też więcej Y. Różni się od efektu między osobami, który dotyczy tego, czy ludzie z przeciętnie wyższym X mają wyższe Y. Oba efekty rozdziela się, np. centrując predyktor względem średniej osoby.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Inwariancja podłużna pomiaru
Trzy pomiary w lavaan: kowariancje reszt, measEq.syntax, częściowa inwariancja w jednym pomiarze, odpadanie i progi – co zmienia się we wniosku o zmianie.
Czytaj →PoradnikLatentne modele zmiany (LCS) w lavaan
Model podwójnej zmiany i sprzężenie dwóch procesów w lavaan: interpretacja β i γ, porównanie z LGM i odzysk parametrów w symulacji.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikAnkieta w kilku falach
Łączenie fal, stałe pytania, książka kodów i analiza ubytku: kompletne przypadki, model mieszany i wagi IPW w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Ployhart, R. E., & Vandenberg, R. J. (2010). Longitudinal research: The theory, design, and analysis of change. Journal of Management, 36(1), 94–120. https://doi.org/10.1177/0149206309352110
Cytowania BibTeX
@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{hamaker2015critique, author={Hamaker, Ellen L. and Kuiper, Rebecca M. and Grasman, Raoul P. P. P.}, title={{A critique of the cross-lagged panel model}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={102--116}, doi={10.1037/a0038889}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{ployhart2010longitudinal, author={Ployhart, Robert E. and Vandenberg, Robert J.}, title={{Longitudinal research: The theory, design, and analysis of change}}, journal={Journal of Management}, year={2010}, volume={36}, number={1}, pages={94--120}, doi={10.1177/0149206309352110}}