Co oznacza wartość p – definicja w jednym akapicie
Wartość p to prawdopodobieństwo uzyskania wyniku co najmniej tak skrajnego jak obserwowany, przy założeniu, że prawdziwa jest hipoteza zerowa i wszystkie pozostałe założenia modelu statystycznego (losowy dobór, niezależne obserwacje, rozkład, brak selekcji analiz). Wasserstein i Lazar (2016), czyli oświadczenie Amerykańskiego Towarzystwa Statystycznego (ASA), ujmują to tak: p pokazuje, na ile dane są niezgodne z określonym modelem statystycznym. Nie jest prawdopodobieństwem, że hipoteza jest prawdziwa, i nie mierzy wielkości efektu.
Ten wpis dotyczy interpretacji: jak czytać p, czego z niego nie wyczytasz i jak to zapisać w pracy. Jak p powstaje krok po kroku – z rozkładu z prób, błędu standardowego i pola pod krzywą – pokazujemy w poradniku P value krok po kroku. Logikę całej procedury opisuje hasło NHST.
Przykład, do którego będziemy wracać (dane symulowane): 80 studentów losowo przydzielono do 20-minutowej drzemki albo do odpoczynku bez snu, po 40 osób, a potem sprawdzono, ile słów z listy 30 słów pamiętają po dwóch godzinach. Po drzemce zapamiętano średnio M = 17.77 słowa (SD = 4.38), po odpoczynku – M = 15.62 (SD = 4.41). Test t dla prób niezależnych: różnica 2.15 słowa, 95% CI [0.19, 4.11], t(78) = 2.19, p = .032, d = 0.49, 95% CI [0.04, 0.93].
Poprawne zdanie o tym p brzmi: gdyby drzemka nie miała żadnego wpływu na zapamiętywanie (i założenia testu były spełnione), różnicę co najmniej 2.15 słowa w którąkolwiek stronę uzyskiwalibyśmy w około 3.2% takich badań. Każde inne sformułowanie trzeba sprawdzić z listą poniżej.
Błędne interpretacje wartości p – lista kontrolna
Greenland i in. (2016) zebrali 25 typowych błędnych interpretacji wartości p, przedziałów ufności i mocy, a Goodman (2008) – dwanaście nieporozumień wokół samego p. Poniżej te, które najczęściej pojawiają się w pracach dyplomowych, każde odniesione do przykładu z drzemką.
| Błędne odczytanie (p = .032) | Dlaczego to błąd | Co można powiedzieć |
|---|---|---|
| 1. „Prawdopodobieństwo, że H0 jest prawdziwa, wynosi 3.2%.” | p liczy się przy założeniu, że H0 jest prawdziwa, więc nie może jednocześnie mówić, jak prawdopodobna jest H0 | dane są mało zgodne z modelem „brak różnicy” |
| 2. „Szansa, że wynik jest dziełem przypadku, wynosi 3.2%.” | to ta sama pomyłka w innych słowach – „wynik przypadkowy” znaczy „H0 prawdziwa” | jak wyżej |
| 3. „Z prawdopodobieństwem 96.8% drzemka poprawia pamięć.” | 1 − p nie jest prawdopodobieństwem hipotezy alternatywnej | do takich zdań potrzebna jest analiza bayesowska, np. czynnik Bayesa |
| 4. „Ryzyko, że się mylę, odrzucając H0, wynosi 3.2%.” | odsetek fałszywych alarmów wśród wyników istotnych zależy od mocy i od tego, jak często badane hipotezy są prawdziwe (zob. symulacja niżej) | przy α = .05 test fałszywie odrzuca prawdziwą H0 w 5% badań – to cecha procedury, nie tego wyniku |
| 5. „Wynik jest istotny, więc efekt jest duży i ważny.” | p zależy od wielkości efektu i liczebności; d = 0.49 z CI od 0.04 do 0.93 obejmuje efekty od znikomych po duże | podaj wielkość efektu z CI i oceń ją merytorycznie |
| 6. „Gdyby p wyszło .079 (jak w replikacji 18 niżej), drzemka by nie działała.” | p > .05 nie dowodzi braku efektu; .032 i .079 to bardzo podobne wyniki | wynik nieistotny opisz z CI; brak efektu wykazuje się testem równoważności |
| 7. „Powtórzone badanie z prawdopodobieństwem 96.8% też da p < .05.” | szansa na istotną replikację zależy od mocy; przy prawdziwym efekcie tej wielkości i tej liczebności to mniej więcej rzut monetą | zob. symulację „tańca p” |
| 8. „Replikacja 8 dała p = .023, a replikacja 4 – p = .207, więc wyniki są sprzeczne.” | różnica między „istotnym” a „nieistotnym” nie musi sama być istotna (Gelman i Stern, 2006) | porównaj oszacowania i ich przedziały albo przetestuj różnicę wprost |
| 9. „Małe p potwierdza, że model i założenia były poprawne.” | p zakłada model; naruszenie założeń albo wybór analiz po wynikach może dać małe p nawet przy prawdziwej H0 (Greenland i in., 2016) | opisz sprawdzenie założeń i wszystkie wykonane analizy |
| 10. „Replikacja 6 (p = .006) wykazała silniejszy efekt niż replikacja 1 (p = .013).” | w replikacji 6 różnica wyniosła 2.47 słowa, a w replikacji 1 – 2.76; mniejsze p nie oznacza większego efektu, a przy różnych liczebnościach porównanie p jest jeszcze bardziej mylące | porównuj wielkości efektu z CI |
| 11. „Skoro p < .05, hipoteza badawcza została udowodniona.” | test dotyczy hipotezy statystycznej, a nie całej teorii; pojedyncze badanie niczego nie dowodzi | „wyniki są zgodne z hipotezą”, „przemawiają za hipotezą” |
Lista dotyczy zwykłego testu dwustronnego. O testach jednostronnych i ich nadużywaniu piszemy w haśle test jednostronny i dwustronny, a o różnicy między p a poziomem istotności α – w osobnym haśle.
Wartość p pod H0 i pod H1: co pokazuje symulacja
Murdoch i in. (2008) proponują uczyć interpretacji p przez symulację, bo wartość p jest zmienną losową: przy powtórzeniu tego samego badania wychodzi za każdym razem inna. Zasymulowaliśmy trzy „światy”, w każdym po 20 000 badań z testem t dla dwóch grup:
- H0 prawdziwa: brak różnicy, 40 osób w grupie;
- H1, moc .50: prawdziwe d = 0.5, 32 osoby w grupie – typowe małe badanie;
- H1, moc .95: prawdziwe d = 0.5, 105 osób w grupie – badanie dobrze zaplanowane.
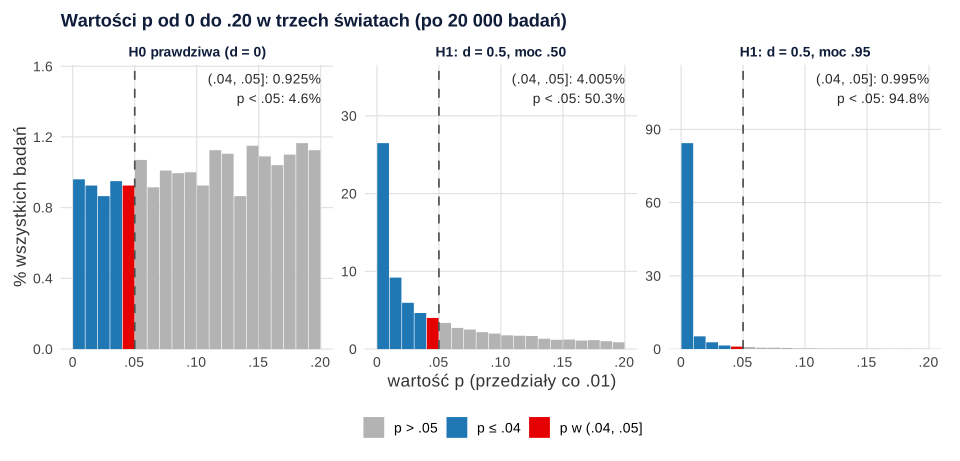
Co widać na rysunku i w liczbach z przepisu 2?
- Gdy H0 jest prawdziwa, każda wartość p jest tak samo prawdopodobna. Rozkład jest płaski: wynik p < .05 pojawił się w 4.6% badań, a mediana p wyniosła .499. Właśnie dlatego przy α = .05 test fałszywie alarmuje w około 5% badań. Poza tym p = .03 i p = .80 są w świecie H0 równie „zwyczajne” – pojedyncze p mówi niewiele.
- Gdy H1 jest prawdziwa, rozkład przesuwa się ku zeru, ale tylko o tyle, na ile pozwala moc. Przy mocy .50 połowa badań dała p < .05 (50.3%), a druga połowa – nie, choć efekt istniał. Mediana p wyniosła .049.
- Wynik „tuż poniżej .05” to słaby dowód. Wartość p z przedziału (.04, .05] pojawiła się w 0.925% badań w świecie H0, w 4.005% badań przy mocy .50 i w 0.995% badań przy mocy .95. W małym badaniu taki wynik jest więc około 4.3 razy częstszy przy prawdziwym efekcie niż przy jego braku, a w dużym – tylko 1.08 razy. W badaniu o wysokiej mocy wynik z przedziału (.04, .05] jest niemal tak samo prawdopodobny przy braku efektu, jak przy efekcie zakładanym w planie. Przy mocy .95 aż 60.9% badań dało p < .001.
Ten ostatni wynik jest jednym z argumentów za ostrzejszymi progami. Benjamin i in. (2018) zaproponowali, by dla twierdzeń o nowych odkryciach obniżyć próg z .05 do .005. W naszej symulacji p < .005 uzyskano w 0.47% badań w świecie H0, 19.4% przy mocy .50 i 77.9% przy mocy .95.
Ile wyników istotnych to fałszywe alarmy?
Błąd 4 z tabeli – „ryzyko pomyłki wynosi p” – najlepiej widać w prostym rachunku. Wyobraź sobie 1000 testowanych hipotez, z których 10% jest prawdziwych, przy mocy .50 i α = .05. Prawdziwych efektów jest 100 i połowa z nich da wynik istotny – 50 trafień. Fałszywych hipotez jest 900, a 5% z nich da wynik istotny – 45 fałszywych alarmów. Wśród 95 istotnych wyników prawie połowa (47.4%) to fałszywe alarmy, choć każdy z nich ma p < .05.
| Odsetek prawdziwych H1 | Moc .20 | Moc .50 | Moc .80 | Moc .95 |
|---|---|---|---|---|
| 10% | 69.2% | 47.4% | 36.0% | 32.1% |
| 25% | 42.9% | 23.1% | 15.8% | 13.6% |
| 50% | 20.0% | 9.1% | 5.9% | 5.0% |
Ten odsetek nie wynika z p w Twoim badaniu, tylko z mocy i z tego, jak prawdopodobne były badane hipotezy. Dlatego moc testu ma znaczenie nie tylko dla wyników nieistotnych. Niska moc obniża też wiarygodność wyników istotnych. Rolę błędu I i II rodzaju omawiamy w haśle o błędach I i II rodzaju.
„Taniec” wartości p: co się stanie w replikacji?
Załóżmy, że drzemka naprawdę poprawia pamięć o 2 słowa (SD = 4.5), a badanie z 40 osobami w grupie powtarzamy 20 razy. Moc takiego badania wynosi .50. Rysunek 2 pokazuje wynik każdej replikacji.
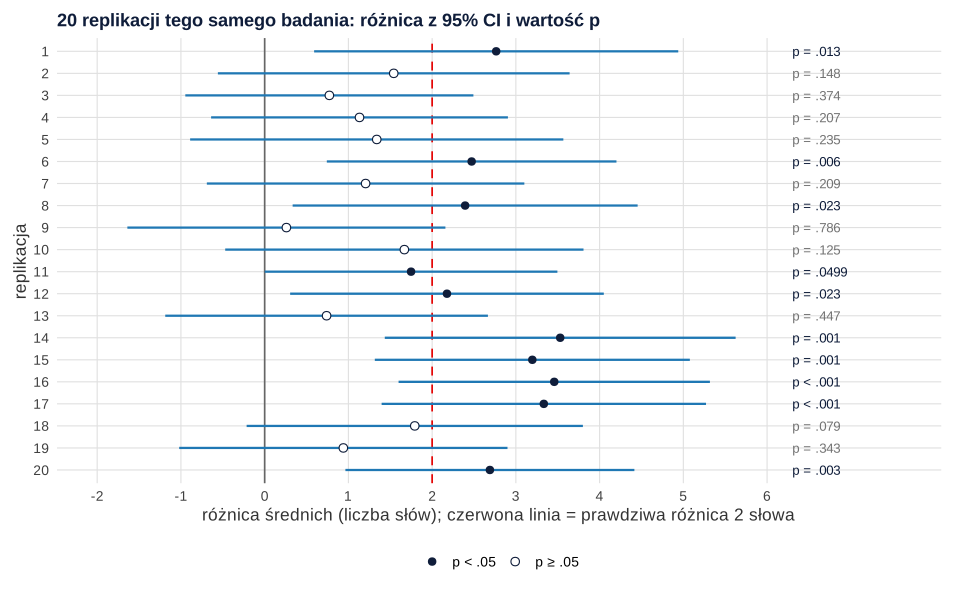
Wartości p wahały się od .0004 do .786. Wynik istotny dało 10 z 20 replikacji, w tym jedna z p = .0499. Gdyby każdą replikację opisywał inny autor, połowa ogłosiłaby, że „drzemka poprawia pamięć”, a połowa – że „nie ma wpływu”. Tymczasem we wszystkich badaniach działał ten sam mechanizm, a wszystkie 20 przedziałów ufności objęło prawdziwą różnicę 2 słów.
Cumming (2008) pokazał to samo analitycznie: jeśli pierwsze badanie dało dwustronne p = .05, to jednostronne p replikacji z prawdopodobieństwem 80% wypadnie gdzieś między .00008 a .44, niezależnie od liczebności. Wniosek: wartość p słabo przewiduje, co zobaczysz w następnym badaniu, a przedziały ufności i myślenie o wielu badaniach naraz radzą sobie z tym znacznie lepiej. Właśnie stąd biorą się „nieudane” replikacje, które nie muszą oznaczać, że pierwotny efekt nie istniał – więcej w haśle o replikowalności.
Wartość p a przedział ufności
Dla tego samego testu p i przedział ufności to dwie strony tej samej informacji. 95% CI zawiera wszystkie wartości różnicy, których test dwustronny nie odrzuciłby przy α = .05. W przykładzie 95% CI [0.19, 4.11] nie obejmuje zera, więc p < .05. Gdy zwiększamy poziom ufności, przedział się poszerza, a przy poziomie 1 − p = 96.8% jego dolna granica dotyka dokładnie zera: [0.0, 4.3].
Przedział mówi jednak więcej niż p, bo pokazuje wszystkie wartości zgodne z danymi, a nie tylko odległość od zera. Policzyliśmy p dla kilku innych hipotez o wielkości różnicy:
| Hipoteza: różnica wynosi | 0 słów | 1 słowo | 2 słowa | 3 słowa | 4 słowa |
|---|---|---|---|---|---|
| p | .032 | .245 | .879 | .390 | .063 |
Dane są niemal tak samo (nie)zgodne z hipotezą „różnica wynosi 4 słowa” (p = .063) jak z hipotezą „różnica wynosi 0” (p = .032). Nikt nie napisałby jednak „dowiedliśmy, że drzemka nie daje 4 słów przewagi”. Amrhein i in. (2019) proponują dlatego nazywać przedziały ufności „przedziałami zgodności” i omawiać praktyczne konsekwencje wszystkich wartości w ich obrębie, a nie tylko tego, czy obejmują zero. Pamiętaj tylko, że przedziały też bywają źle rozumiane: badacze i studenci akceptowali średnio ponad trzy z sześciu fałszywych stwierdzeń o przedziale ufności (Hoekstra i in., 2014). „95%” dotyczy procedury, a nie tego jednego przedziału – szczegóły w haśle o estymacji przedziałowej.
Wartość p a wielkość efektu
p łączy w jednej liczbie wielkość efektu i liczebność próby, więc samo w sobie nie mówi, który z tych czynników „zrobił” wynik. Ta sama wartość p = .032 w badaniu dwóch równych grup oznacza zupełnie różne efekty:
| Osób w grupie | t | d | 95% CI dla d |
|---|---|---|---|
| 20 | 2.23 | 0.72 | [0.06, 1.37] |
| 40 | 2.18 | 0.49 | [0.04, 0.94] |
| 200 | 2.15 | 0.22 | [0.02, 0.41] |
| 2000 | 2.15 | 0.07 | [0.01, 0.13] |
Przy 2000 osobach w grupie p = .032 oznacza efekt rzędu d = 0.07, który w większości zastosowań byłby bez znaczenia praktycznego. Przy 20 osobach to samo p towarzyszy efektowi oszacowanemu na 0.72, ale z przedziałem od znikomego do bardzo dużego. Dlatego wartość p zawsze podawaj razem z wielkością efektu i jej przedziałem – zasady interpretacji opisujemy we wpisie wielkość efektu – interpretacja, a wartości dla różnicy średnich – w haśle d Cohena.
Istotny w jednej grupie, nieistotny w drugiej
Z tą samą pomyłką wiąże się błąd 8 z tabeli. Przykład: efekt drzemki policzony osobno dla kobiet wynosi 2.6 słowa (SE = 1.10, p = .018), a dla mężczyzn 1.4 słowa (SE = 1.15, p = .223). Kusi, by napisać „drzemka działa u kobiet, ale nie u mężczyzn”. Różnica między tymi efektami to jednak 1.2 słowa, a jej test daje p = .451. Gelman i Stern (2006) pokazują, że nawet duża zmiana poziomu istotności może odpowiadać małej, nieistotnej zmianie samych efektów. Żeby stwierdzić, że efekt różni się między grupami, przetestuj interakcję, a nie porównuj dwóch wartości p.
Gdy wartość p wprowadza w błąd: wielokrotne testy i elastyczne analizy
Interpretacja p zakłada, że wykonano jeden zaplanowany test. Gdy analiz było wiele, a raportuje się tylko istotne, nominalne p przestaje znaczyć to, co powinno. Simmons i in. (2011) pokazali w symulacjach i eksperymentach, że nieujawniona elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. To mechanizm p-hackingu i HARKingu.
- Przy wielu testach w jednej rodzinie hipotez zastosuj korektę – zob. poprawki na wielokrotne porównania i hasło o problemie wielokrotnych porównań.
- Zapisz plan analizy przed zebraniem danych – zob. plan analizy statystycznej i prerejestracja.
- Analizy dodane po zobaczeniu danych opisz jako eksploracyjne, bez „potwierdzania” hipotez.
Nie oznacza to, że p trzeba porzucić. Lakens (2021) przekonuje, że praktyczną alternatywą dla wartości p jest wartość p używana poprawnie. W niektórych pytaniach badawczych to właśnie ona daje odpowiedź, a zestaw narzędzi warto poszerzyć o testy równoważności i testy minimalnego efektu.
Jak pisać o wartości p w pracy: źle → dobrze
| Źle | Dobrze |
|---|---|
| wartość p zapisana jako „0,032” albo „0.032” | „p = .032” (APA: kropka, bez zera wiodącego, trzy miejsca) |
| „p = .000” | „p < .001” |
| „Hipoteza została udowodniona (p < .05).” | „Wyniki są zgodne z hipotezą 1: osoby po drzemce zapamiętały więcej słów…” |
| „Wynik był bliski istotności (p = .079)” / „trend” | „Różnica wyniosła 1.79 słowa, 95% CI [−0.22, 3.80], p = .079” (replikacja 18) – bez etykiety „prawie” |
| „Nie było różnicy między grupami (p = .32).” | „Nie wykazano istotnej różnicy; przedział ufności obejmuje zarówno brak różnicy, jak i różnice do X słów.” |
| „Wynik wysoce istotny (p < .001) – silny efekt.” | wielkość efektu z CI i ocena merytoryczna, niezależnie od p |
| „Efekt wystąpił u kobiet (p = .018), ale nie u mężczyzn (p = .223).” | „Efekt drzemki nie różnił się istotnie między kobietami a mężczyznami (interakcja: …)” |
Wood i in. (2014) pokazują, że opisywanie wyników nieistotnych jako „trendu w kierunku istotności” albo sugerowanie, że zabrakło danych, daje mylące wrażenie i podważa rzetelne raportowanie. Ogólne zasady zapisu statystyk – w poradniku jak opisać wyniki w stylu APA, a sposób opisania wyników nieistotnych – we wpisie hipoteza się nie potwierdziła.
Na obronie pytania „co oznacza p?” i „czy wynik nieistotny oznacza brak efektu?” padają bardzo często. Odpowiedzi przećwiczysz z wpisem pytania na obronie z metodologii i statystyki. Jeśli chcesz, żeby ktoś sprawdził interpretację wyników w Twojej pracy, zajrzyj do oferty analiz statystycznych dla studentów – wyjaśnimy, co wolno, a czego nie wolno wyczytać z Twoich wartości p.
Wartość p w R – symulacje i przykłady
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Przepisy nie wymagają pliku z danymi – dane symulują same, z ustalonym ziarnem losowania. Symulacja w przepisie 2 (60 000 badań) trwa kilka sekund.
1. Badanie drzemki: test t, wielkość efektu i wartości p dla innych hipotez
R
# Badanie przykładowe (dane symulowane): 20-minutowa drzemka (n = 40) a odpoczynek bez snu (n = 40);
# wynik: liczba słów przypomnianych z listy 30 słów po 2 godzinach.
library(effectsize)   # cohens_d()
set.seed(1653)
drzemka   <- pmin(pmax(round(rnorm(40, 17.5, 4.5)), 0), 30)
odpoczynek <- pmin(pmax(round(rnorm(40, 15.5, 4.5)), 0), 30)
dane <- data.frame(grupa = factor(rep(c("drzemka", "odpoczynek"), each = 40), levels = c("drzemka", "odpoczynek")),
                   slowa = c(drzemka, odpoczynek))
aggregate(slowa ~ grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
tt <- t.test(slowa ~ grupa, data = dane, var.equal = TRUE)
round(c(roznica = unname(diff(rev(tt$estimate))), CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2],
        t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value), 3)
cohens_d(slowa ~ grupa, data = dane)

# Dualność p i CI: przy jakim poziomie ufności dolna granica przedziału dotyka zera? (1 − p)
round(1 - tt$p.value, 3)
round(t.test(slowa ~ grupa, data = dane, var.equal = TRUE, conf.level = 1 - tt$p.value)$conf.int, 3)
# Wartości p dla innych hipotez niż „różnica = 0” (np. różnica = 1, 2, 3, 4 słowa)
sapply(c(0, 1, 2, 3, 4), function(m) round(t.test(slowa ~ grupa, data = dane, var.equal = TRUE, mu = m)$p.value, 3))
Wynik w R
       grupa slowa.M slowa.SD
1    drzemka   17.77     4.38
2 odpoczynek   15.62     4.41
 roznica CI_dolna CI_gorna        t       df        p
   2.150    0.194    4.106    2.188   78.000    0.032
Cohen's d |       95% CI
------------------------
0.49      | [0.04, 0.93]

- Estimated using pooled SD.[1] 0.968
[1] 0.0 4.3
attr(,"conf.level")
[1] 0.9683331
[1] 0.032 0.245 0.879 0.390 0.063
2. Rozkład p pod H0 i pod H1 oraz odsetek fałszywych alarmów
R
# 20 000 badań w każdym z trzech „światów” (dane symulowane, test t dla dwóch grup, α = .05)
p_t <- function(n, d, reps) {
  x <- matrix(rnorm(n * reps, d), n); y <- matrix(rnorm(n * reps), n)
  sp <- sqrt((apply(x, 2, var) + apply(y, 2, var)) / 2)
  t <- (colMeans(x) - colMeans(y)) / (sp * sqrt(2 / n))
  2 * pt(-abs(t), 2 * n - 2)
}
set.seed(316)
swiaty <- list("H0: d = 0, n = 40"              = p_t(40, 0, 20000),
               "H1: d = 0.5, n = 32 (moc ~.50)"  = p_t(32, 0.5, 20000),
               "H1: d = 0.5, n = 105 (moc ~.95)" = p_t(105, 0.5, 20000))
podsum <- t(sapply(swiaty, function(p) c(proc_p_ponizej_05 = 100 * mean(p < .05), proc_p_ponizej_005 = 100 * mean(p < .005),
                                         proc_p_04_05 = 100 * mean(p > .04 & p <= .05), proc_p_ponizej_001 = 100 * mean(p < .001),
                                         mediana_p = median(p))))
round(podsum, 3)
power.t.test(n = c(32, 105), delta = 0.5)$power

# Jak często p z przedziału (.04, .05] pojawia się w świecie H1 w porównaniu ze światem H0?
round(c(moc_50 = podsum[2, "proc_p_04_05"] / podsum[1, "proc_p_04_05"],
        moc_95 = podsum[3, "proc_p_04_05"] / podsum[1, "proc_p_04_05"]), 2)

# Odsetek fałszywych alarmów wśród wyników istotnych: zależy od mocy i od tego, jak często badane H1 są prawdziwe
fa <- function(prior, moc, alfa = .05) alfa * (1 - prior) / (alfa * (1 - prior) + moc * prior)
siatka <- expand.grid(odsetek_prawdziwych_H1 = c(.10, .25, .50), moc = c(.20, .50, .80, .95))
siatka$proc_falszywych_wsrod_istotnych <- round(100 * fa(siatka$odsetek_prawdziwych_H1, siatka$moc), 1)
siatka
# Ten sam rachunek w liczbach: 1000 hipotez, 10% prawdziwych, moc .50
c(prawdziwe_istotne = 1000 * .10 * .50, falszywe_istotne = 1000 * .90 * .05)
Wynik w R
                                proc_p_ponizej_05 proc_p_ponizej_005
H0: d = 0, n = 40                           4.625              0.470
H1: d = 0.5, n = 32 (moc ~.50)             50.270             19.390
H1: d = 0.5, n = 105 (moc ~.95)            94.815             77.945
                                proc_p_04_05 proc_p_ponizej_001 mediana_p
H0: d = 0, n = 40                      0.925              0.100     0.499
H1: d = 0.5, n = 32 (moc ~.50)         4.005              8.515     0.049
H1: d = 0.5, n = 105 (moc ~.95)        0.995             60.940     0.000
[1] 0.5035956 0.9501287
moc_50 moc_95
  4.33   1.08
   odsetek_prawdziwych_H1  moc proc_falszywych_wsrod_istotnych
1                    0.10 0.20                            69.2
2                    0.25 0.20                            42.9
3                    0.50 0.20                            20.0
4                    0.10 0.50                            47.4
5                    0.25 0.50                            23.1
6                    0.50 0.50                             9.1
7                    0.10 0.80                            36.0
8                    0.25 0.80                            15.8
9                    0.50 0.80                             5.9
10                   0.10 0.95                            32.1
11                   0.25 0.95                            13.6
12                   0.50 0.95                             5.0
prawdziwe_istotne  falszywe_istotne
               50                45
3. Dwadzieścia replikacji tego samego badania
R
# 20 identycznych replikacji tego samego badania (dane symulowane): prawdziwa różnica 2 słowa, SD = 4.5, n = 40 w grupie
set.seed(77)
rep20 <- t(sapply(1:20, function(i) {
  a <- rnorm(40, 17.5, 4.5); b <- rnorm(40, 15.5, 4.5)
  tt <- t.test(a, b, var.equal = TRUE)
  c(replikacja = i, roznica = unname(diff(rev(tt$estimate))), CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2], p = tt$p.value)
}))
print(data.frame(round(rep20[, 1:4], 2), p = formatC(rep20[, "p"], format = "f", digits = 4)))
signif(c(min_p = min(rep20[, "p"]), max_p = max(rep20[, "p"]), istotnych = sum(rep20[, "p"] < .05),
        CI_obejmuje_2 = sum(rep20[, "CI_dolna"] < 2 & rep20[, "CI_gorna"] > 2)), 3)
power.t.test(n = 40, delta = 2, sd = 4.5)$power
Wynik w R
   replikacja roznica CI_dolna CI_gorna      p
1           1    2.76     0.59     4.94 0.0134
2           2    1.54    -0.56     3.64 0.1480
3           3    0.77    -0.95     2.49 0.3739
4           4    1.13    -0.64     2.91 0.2070
5           5    1.34    -0.89     3.57 0.2354
6           6    2.47     0.74     4.20 0.0057
7           7    1.21    -0.69     3.10 0.2093
8           8    2.39     0.33     4.45 0.0233
9           9    0.26    -1.64     2.16 0.7863
10         10    1.67    -0.47     3.81 0.1246
11         11    1.75     0.00     3.50 0.0499
12         12    2.18     0.30     4.05 0.0233
13         13    0.74    -1.19     2.67 0.4471
14         14    3.53     1.43     5.62 0.0012
15         15    3.20     1.32     5.08 0.0011
16         16    3.46     1.60     5.32 0.0004
17         17    3.33     1.40     5.27 0.0010
18         18    1.79    -0.22     3.80 0.0794
19         19    0.94    -1.02     2.90 0.3429
20         20    2.69     0.96     4.42 0.0027
        min_p         max_p     istotnych CI_obejmuje_2
     3.95e-04      7.86e-01      1.00e+01      2.00e+01
[1] 0.5012577
4. To samo p, różne efekty; „istotny” a „nieistotny”
R
library(effectsize)   # t_to_d(): d z 95% CI na podstawie t i df

# To samo p = .032 przy różnych liczebnościach (dwie równe grupy): jak duży jest efekt?
n <- c(20, 40, 200, 2000)
t_kr <- qt(1 - .032 / 2, 2 * n - 2)
wyn <- t_to_d(t_kr, df_error = 2 * n - 2)
round(data.frame(n_w_grupie = n, t = t_kr, d = wyn$d, CI_dolna = wyn$CI_low, CI_gorna = wyn$CI_high), 2)

# Gelman i Stern (2006): „istotny” w jednej podgrupie, „nieistotny” w drugiej – czy podgrupy się różnią?
# Dane zbiorcze (przykład): różnica średnich i jej błąd standardowy w każdej podgrupie
kobiety <- c(roznica = 2.6, SE = 1.10); mezczyzni <- c(roznica = 1.4, SE = 1.15)
p_z <- function(est, se) 2 * pnorm(-abs(est / se))
roznica_podgrup <- kobiety["roznica"] - mezczyzni["roznica"]
se_roznicy <- sqrt(kobiety["SE"]^2 + mezczyzni["SE"]^2)
round(c(p_kobiety = unname(p_z(kobiety["roznica"], kobiety["SE"])), p_mezczyzni = unname(p_z(mezczyzni["roznica"], mezczyzni["SE"])),
        roznica_podgrup = unname(roznica_podgrup), p_roznicy = unname(p_z(roznica_podgrup, se_roznicy))), 3)
Wynik w R
  n_w_grupie    t    d CI_dolna CI_gorna
1         20 2.23 0.72     0.06     1.37
2         40 2.18 0.49     0.04     0.94
3        200 2.15 0.22     0.02     0.41
4       2000 2.15 0.07     0.01     0.13
      p_kobiety     p_mezczyzni roznica_podgrup       p_roznicy
          0.018           0.223           1.200           0.451
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy interpretacji wartości p
- Czytanie p jako prawdopodobieństwa hipotezy – zerowej („3% szans, że H0 jest prawdziwa”) albo alternatywnej („97% pewności”).
- „Brak istotności = brak efektu”. Wynik nieistotny przy małej mocy jest zgodny także z dużymi efektami – sprawdź przedział ufności.
- Porównywanie wartości p zamiast efektów – między badaniami, podgrupami albo zmiennymi.
- Traktowanie .05 jak granicy między prawdą a fałszem: wyniki tuż poniżej i tuż powyżej .05 to praktycznie ten sam wynik.
- Raportowanie samego p bez statystyki testu, stopni swobody, wielkości efektu i przedziału ufności.
- Interpretowanie p z wielu nieskorygowanych testów tak, jakby każdy był jedynym zaplanowanym testem.
- Zapisy „p = .000”, „p < .05” zamiast dokładnej wartości albo przecinek dziesiętny w pracy pisanej według APA.
Najczęstsze pytania
Czy p = .03 oznacza 3% szans, że wynik jest przypadkowy?
Nie. Wartość p liczy się przy założeniu, że hipoteza zerowa jest prawdziwa, czyli że wynik jest „przypadkowy” – nie może więc mówić, jak prawdopodobne jest to założenie. p = .03 oznacza, że przy braku efektu i spełnionych założeniach wynik co najmniej tak skrajny pojawiałby się w około 3% badań.
Czy mniejsza wartość p oznacza silniejszy efekt?
Nie wprost. Wartość p zależy jednocześnie od wielkości efektu i od liczebności próby, więc przy dużej próbie bardzo małe p może towarzyszyć znikomemu efektowi. Siłę efektu oceniaj na podstawie miary wielkości efektu (np. d, r) z przedziałem ufności, a nie na podstawie p.
Co znaczy, że wynik jest nieistotny statystycznie?
Że dane nie pozwoliły odrzucić hipotezy zerowej przy przyjętym poziomie α. Nie oznacza to, że efektu nie ma – przy małej mocy wynik nieistotny jest zgodny także z dużymi efektami. Sprawdź przedział ufności: jeśli jest szeroki, badanie było mało precyzyjne; brak efektu można wykazać testem równoważności.
Czy można pisać o trendzie, gdy p wynosi .06 albo .07?
Lepiej nie. Określenia „trend” czy „prawie istotny” sugerują, że wynik zmierzał do istotności, czego dane nie pokazują. Podaj dokładne p, wielkość efektu i przedział ufności, a interpretację oprzyj na nich – bez etykiety „prawie”.
Dlaczego w powtórzonym badaniu wartość p wyszła zupełnie inna?
Bo wartość p jest zmienną losową i przy umiarkowanej mocy waha się bardzo mocno między replikacjami. W symulacji 20 identycznych badań z prawdziwym efektem i mocą .50 wartości p wahały się od .0004 do .786, a połowa wyników była nieistotna. Porównuj więc oszacowania efektu i ich przedziały ufności, a nie same p.
Powiązane hasła
Przeczytaj też
P value krok po kroku
Jak powstaje wartość p: rozkład z prób, centralne twierdzenie graniczne, błąd standardowy, statystyka Z i pole pod krzywą – z przykładem i tablicą Z.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →Nie wiesz, co możesz wyczytać ze swoich wartości p?
Sprawdzimy analizy i interpretację wyników w Twojej pracy i wyjaśnimy je tak, abyś umiał(a) samodzielnie bronić swoich wniosków przed komisją.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Benjamin, D. J., Berger, J. O., Johannesson, M., Nosek, B. A., Wagenmakers, E.-J., Berk, R., Bollen, K. A., Brembs, B., Brown, L., Camerer, C., Cesarini, D., Chambers, C. D., Clyde, M., Cook, T. D., De Boeck, P., Dienes, Z., Dreber, A., Easwaran, K., Efferson, C., . . . Johnson, V. E. (2018). Redefine statistical significance. Nature Human Behaviour, 2(1), 6–10. https://doi.org/10.1038/s41562-017-0189-z ● Otwarty dostęp
- Cumming, G. (2008). Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better. Perspectives on Psychological Science, 3(4), 286–300. https://doi.org/10.1111/j.1745-6924.2008.00079.x
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Goodman, S. (2008). A dirty dozen: Twelve p-value misconceptions. Seminars in Hematology, 45(3), 135–140. https://doi.org/10.1053/j.seminhematol.2008.04.003
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Hoekstra, R., Morey, R. D., Rouder, J. N., & Wagenmakers, E.-J. (2014). Robust misinterpretation of confidence intervals. Psychonomic Bulletin & Review, 21(5), 1157–1164. https://doi.org/10.3758/s13423-013-0572-3 ● Otwarty dostęp: pełny tekst
- Lakens, D. (2021). The practical alternative to the p value is the correctly used p value. Perspectives on Psychological Science, 16(3), 639–648. https://doi.org/10.1177/1745691620958012 ● Otwarty dostęp
- Murdoch, D. J., Tsai, Y.-L., & Adcock, J. (2008). P-values are random variables. The American Statistician, 62(3), 242–245. https://doi.org/10.1198/000313008X332421
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Wood, J., Freemantle, N., King, M., & Nazareth, I. (2014). Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data. BMJ, 348, Article g2215. https://doi.org/10.1136/bmj.g2215 ● Otwarty dostęp
Cytowania BibTeX
@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{benjamin2018redefine, author={Benjamin, Daniel J. and Berger, James O. and Johannesson, Magnus and Nosek, Brian A. and Wagenmakers, Eric-Jan and Berk, Richard and Bollen, Kenneth A. and Brembs, Björn and Brown, Lawrence and Camerer, Colin and Cesarini, David and Chambers, Christopher D. and Clyde, Merlise and Cook, Thomas D. and De Boeck, Paul and Dienes, Zoltan and Dreber, Anna and Easwaran, Kenny and Efferson, Charles and others}, title={{Redefine statistical significance}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={1}, pages={6--10}, doi={10.1038/s41562-017-0189-z}}@article{cumming2008replication, author={Cumming, Geoff}, title={{Replication and p intervals: p values predict the future only vaguely, but confidence intervals do much better}}, journal={Perspectives on Psychological Science}, year={2008}, volume={3}, number={4}, pages={286--300}, doi={10.1111/j.1745-6924.2008.00079.x}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{goodman2008dirty, author={Goodman, Steven}, title={{A dirty dozen: Twelve p-value misconceptions}}, journal={Seminars in Hematology}, year={2008}, volume={45}, number={3}, pages={135--140}, doi={10.1053/j.seminhematol.2008.04.003}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{hoekstra2014robust, author={Hoekstra, Rink and Morey, Richard D. and Rouder, Jeffrey N. and Wagenmakers, Eric-Jan}, title={{Robust misinterpretation of confidence intervals}}, journal={Psychonomic Bulletin \& Review}, year={2014}, volume={21}, number={5}, pages={1157--1164}, doi={10.3758/s13423-013-0572-3}}@article{lakens2021practical, author={Lakens, Daniël}, title={{The practical alternative to the p value is the correctly used p value}}, journal={Perspectives on Psychological Science}, year={2021}, volume={16}, number={3}, pages={639--648}, doi={10.1177/1745691620958012}}@article{murdoch2008pvalues, author={Murdoch, Duncan J. and Tsai, Yu-Ling and Adcock, James}, title={{P-values are random variables}}, journal={The American Statistician}, year={2008}, volume={62}, number={3}, pages={242--245}, doi={10.1198/000313008x332421}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{wood2014trap, author={Wood, John and Freemantle, Nick and King, Michael and Nazareth, Irwin}, title={{Trap of trends to statistical significance: Likelihood of near significant P value becoming more significant with extra data}}, journal={BMJ}, year={2014}, volume={348}, eid={g2215}, doi={10.1136/bmj.g2215}}