Co to jest wartość p?
Wartość p (ang. p-value) to prawdopodobieństwo uzyskania wyniku co najmniej tak skrajnego jak zaobserwowany, przy założeniu, że hipoteza zerowa jest prawdziwa i że spełnione są pozostałe założenia modelu statystycznego. „Skrajny” znaczy tu: mocno odbiegający od tego, czego należałoby oczekiwać przy H0 – na przykład duża różnica średnich albo silna korelacja. Wartość p podaje każdy test statystyczny: test t, ANOVA, test chi-kwadrat czy test współczynnika regresji.
Im mniejsza wartość p, tym trudniej pogodzić dane z modelem zakładającym H0. Oświadczenie Amerykańskiego Towarzystwa Statystycznego (ASA) ujmuje to tak: wartość p może wskazywać, w jakim stopniu dane są niezgodne z określonym modelem statystycznym (Wasserstein i Lazar, 2016). Nie mówi natomiast, jak prawdopodobna jest sama hipoteza – wartość p liczy się przy założeniu, że H0 jest prawdziwa, więc nie może być jednocześnie prawdopodobieństwem, że H0 jest prawdziwa. Poprawne definicje i listę 25 typowych błędnych interpretacji wartości p, przedziałów ufności i mocy zebrali Greenland i in. (2016). Szerzej o interpretacji piszemy w poradniku Wartość p: co naprawdę oznacza i jak ją poprawnie interpretować.
Jak oblicza się wartość p?
Test sprowadza dane do jednej liczby – statystyki testowej (np. t, F, χ²) – i porównuje ją z rozkładem, jaki miałaby ona przy prawdziwej H0. Wartość p to pole pod krzywą tego rozkładu „za” wynikiem zaobserwowanym. W teście dwustronnym sumuje się oba ogony:
Tu T to statystyka testowa o znanym rozkładzie przy prawdziwej H0 (np. rozkład t z określoną liczbą stopni swobody), a tobs – jej wartość obliczona z Twoich danych. W teście jednostronnym liczy się pole tylko w jednym, z góry wskazanym ogonie. Zamiast porównywać p z progiem α, można porównać statystykę z wartością krytyczną – obie drogi dają tę samą decyzję. Cały łańcuch – od rozkładu z prób i centralnego twierdzenia granicznego przez błąd standardowy po pole pod krzywą Z – liczymy na jednym przykładzie we wpisie P value krok po kroku.
Przykład: trening relaksacyjny a poziom stresu
Sześćdziesiąt osób studiujących losowo przydzielono do dwóch grup: 30 osób przez cztery tygodnie ćwiczyło techniki relaksacyjne, a 30 tworzyło grupę kontrolną. Na końcu wszyscy wypełnili skalę odczuwanego stresu PSS-10 (zakres 0–40; dane symulowane). Średni wynik w grupie treningowej wyniósł M = 17.30 (SD = 6.85), a w kontrolnej M = 20.93 (SD = 5.82).
Hipoteza zerowa mówi, że średnie w populacji są równe (μ1 = μ2). Test t dla prób niezależnych (wariant dla równych wariancji; zob. też test Welcha) dał t(58) = −2.21. Pole pod krzywą rozkładu t(58) na lewo od −2.21 wynosi .0154, a na prawo od 2.21 – tyle samo. Wartość p dla testu dwustronnego to suma obu pól: p = 2 × .0154 = .031 (rysunek 1).
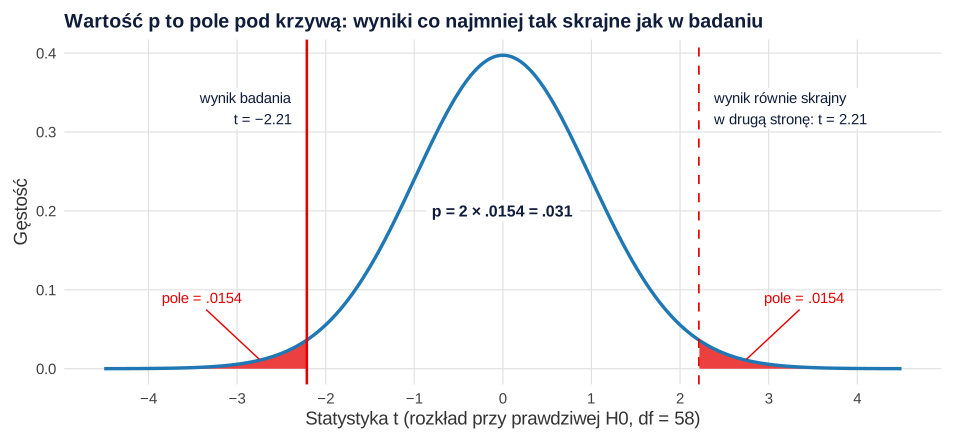
Interpretacja: gdyby trening nie zmieniał poziomu stresu, a założenia testu były spełnione, różnica średnich co najmniej tak duża jak zaobserwowana (w którąkolwiek stronę) pojawiałaby się w około 3.1% takich badań. To rzadko, więc dane słabo pasują do H0. Przy z góry przyjętym poziomie istotności α = .05 odrzucamy hipotezę zerową.
Wartość p nie mówi jednak, jak duży jest efekt. Tę informację daje wielkość efektu – tu d = −0.57, czyli różnica ponad pół odchylenia standardowego (zob. interpretacja d Cohena) – oraz przedział ufności dla różnicy średnich: −3.63 punktu, 95% CI [−6.92, −0.35]. Przedział jest szeroki: dane są zgodne zarówno ze spadkiem stresu o niecałe pół punktu, jak i o prawie 7 punktów.
Jak rozkładają się wartości p? Symulacja 10 000 badań
Wartość p, podobnie jak średnia z próby, zmienia się z badania na badanie. Rysunek 2 pokazuje 10 000 symulowanych badań z dwiema grupami w trzech sytuacjach: gdy efektu nie ma (H0 prawdziwa) oraz gdy istnieje efekt średniej wielkości (d = 0.5), badany na 30 albo na 64 osobach w grupie.
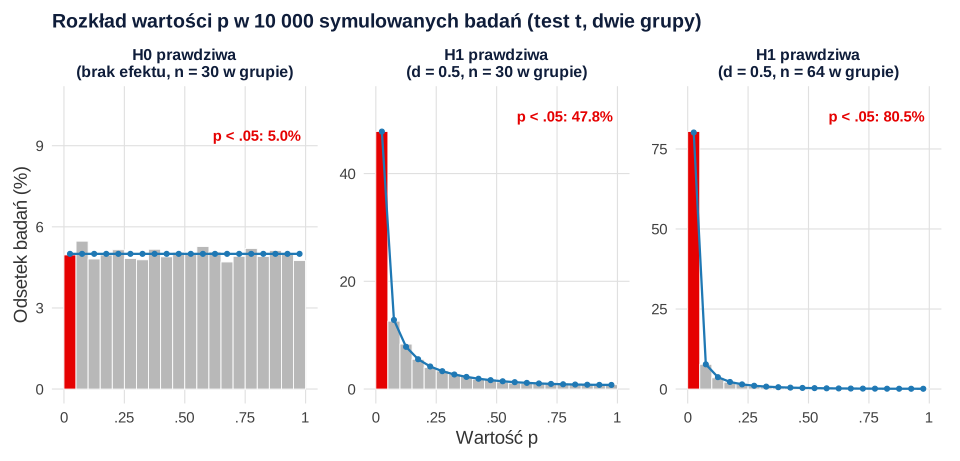
- Gdy H0 jest prawdziwa, wartości p rozkładają się równomiernie między 0 a 1. W każdym przedziale o szerokości .05 znalazło się około 5% badań, także w przedziale p < .05 (4.96%). Dlatego reguła „odrzucam H0, gdy p < α” daje w długiej serii badań odsetek fałszywych alarmów równy α – to błąd I rodzaju.
- Gdy efekt istnieje, rozkład jest prawoskośny – małe wartości p są częste. Odsetek wyników p < .05 to moc testu: 47.8% przy 30 osobach w grupie i 80.5% przy 64 osobach (z teorii: 47.8% i 80.2%).
- Wartość p mocno się waha między powtórzeniami. Przy 30 osobach w grupie mediana p wyniosła .057: w połowie badań p przekroczyło .057, choć efekt naprawdę istniał, a w 30.5% badań wypadło między .05 a .25.
Pojedyncza wartość p niesie więc dużo przypadkowości, a nieistotny wynik małego badania nie dowodzi braku efektu. Amrhein i in. (2019) apelują, by nie wnioskować o braku różnicy tylko dlatego, że p > .05.
Sześć zasad ASA dotyczących wartości p
Oświadczenie ASA (Wasserstein i Lazar, 2016) streszcza poprawne rozumienie wartości p w sześciu zasadach:
- Wartość p może wskazywać, jak bardzo dane są niezgodne z określonym modelem statystycznym.
- Wartość p nie mierzy prawdopodobieństwa, że badana hipoteza jest prawdziwa, ani prawdopodobieństwa, że dane powstały wyłącznie przez przypadek.
- Wnioski naukowe i decyzje praktyczne nie powinny opierać się wyłącznie na tym, czy wartość p przekroczyła określony próg.
- Rzetelne wnioskowanie wymaga pełnego raportowania i przejrzystości.
- Wartość p ani istotność statystyczna nie mierzą wielkości efektu ani wagi wyniku.
- Sama wartość p nie jest dobrą miarą siły dowodów na rzecz modelu lub hipotezy.
Zasada 4 dotyczy m.in. p-hackingu, czyli raportowania tylko analiz z p < .05. Przy wielu testach rośnie też szansa fałszywego alarmu (zob. korekta Bonferroniego i porównania wielokrotne).
Czego wartość p nie oznacza?
| Błędna interpretacja | Jak jest naprawdę |
|---|---|
| „p = .031, więc H0 jest prawdziwa z prawdopodobieństwem 3.1%” | Wartość p liczy się przy założeniu, że H0 jest prawdziwa. Prawdopodobieństwo hipotezy daje dopiero podejście bayesowskie, uwzględniające jej wiarygodność przed badaniem (zob. czynnik Bayesa). |
| „Z prawdopodobieństwem 96.9% efekt jest prawdziwy i powtórzy się w replikacji” | Szansa na p < .05 w replikacji zależy od mocy badania – w symulacji przy prawdziwym efekcie wynosiła 47.8% albo 80.5%. |
| „Przy p < .05 ryzyko fałszywego alarmu wynosi 5%” | α = .05 to odsetek fałszywych alarmów wśród badań z prawdziwą H0, a nie wśród wyników istotnych. Według kalkulacji przytaczanej przez Nuzzo (2014) p = .05 oznacza – zależnie od wyjściowej wiarygodności hipotezy – co najmniej 29%, a p = .01 co najmniej 11% prawdopodobieństwa fałszywego alarmu. |
| „p > .05, więc efektu nie ma” | Brak istotności to brak wystarczających dowodów, a nie dowód braku efektu (Amrhein i in., 2019). Sprawdź przedział ufności – często obejmuje także efekty ważne praktycznie. |
| „Bardzo małe p oznacza duży, ważny efekt” | Wartość p zależy od wielkości efektu i od liczebności próby: w bardzo dużej próbie nawet znikomy efekt da p < .001 (zasada 5 ASA). |
| „p = .049 i p = .051 to jakościowo różne wyniki” | Niosą niemal tę samą informację. Sztywny podział na wyniki „istotne” i „nieistotne” zniekształca wnioski (Amrhein i in., 2019). |
Wolski (2016) zwraca uwagę, że mylące konotacje terminu „istotność statystyczna” – kojarzonego potocznie z ważnością – sprzyjają przecenianiu wyników istotnych i pomijaniu wielkości efektu. Opisuj więc, co dokładnie pokazały dane, a nie samą „istotność”.
Jak zapisać wartość p w pracy (APA)
Przewodnik APA Style po zapisie liczb i statystyk (American Psychological Association, 2024) zaleca podawanie dokładnej wartości p z dwoma lub trzema miejscami dziesiętnymi (na metodolog.pl – trzy: p = .031), zapis p < .001 dla wartości mniejszych, pomijanie zera przed kropką (p nie może przekroczyć 1) i kursywę dla symbolu p.
| Wydruk programu | Zapis w pracy |
|---|---|
p-value = 0.03088 (R) | p = .031 |
Sig. = ,000 (SPSS) | p < .001 (nigdy „p = .000”) |
p-value < 2.2e-16 (R) | p < .001 |
p-value = 0.2513 (R) | p = .251 (zamiast „n.s.”) |
Wartość p podawaj razem ze statystyką testu, stopniami swobody, wielkością efektu i przedziałem ufności. Wynik testu jednostronnego oznacz wprost. Opis wyniku z przykładu:
Więcej gotowych zdań dla różnych testów znajdziesz we wpisie Jak opisać wyniki w pracy – gotowe zdania w stylu APA.
Przykład w R
Kod odtwarza przykład (test t, wartość p liczona „ręcznie”, d Cohena), zamienia wartości p na zapis APA i powtarza symulację z rysunku 2 dla dwóch scenariuszy.
Wartość p z testu t i jej rozkład w symulacji
R
set.seed(125)
kontrola <- pmin(pmax(round(rnorm(30, mean = 20, sd = 6)), 0), 40)  # stres (PSS-10), grupa kontrolna
trening  <- pmin(pmax(round(rnorm(30, mean = 17, sd = 6)), 0), 40)  # stres po treningu relaksacyjnym
wynik <- t.test(trening, kontrola, var.equal = TRUE)
wynik
2 * pt(-abs(wynik$statistic), df = 58)    # p "ręcznie": dwa ogony rozkładu t(58)
(mean(trening) - mean(kontrola)) / sqrt((var(trening) + var(kontrola)) / 2)   # d Cohena

apa_p <- function(p) ifelse(p < .001, "p < .001", paste0("p = ", sub("^0", "", sprintf("%.3f", p))))
apa_p(c(0.03088, 0.0004, 0.2513, 2.2e-16))

# Rozkład wartości p w 10 000 badań: H0 prawdziwa i H1 prawdziwa (d = 0.5)
set.seed(2026)
p_H0 <- replicate(10000, t.test(rnorm(30), rnorm(30), var.equal = TRUE)$p.value)
p_H1 <- replicate(10000, t.test(rnorm(30), rnorm(30, mean = 0.5), var.equal = TRUE)$p.value)
c(H0 = mean(p_H0 < .05), H1 = mean(p_H1 < .05))     # odsetek wyników p < .05
Wynik w R
	Two Sample t-test

data:  trening and kontrola
t = -2.2125, df = 58, p-value = 0.03088
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -6.9205065 -0.3461601
sample estimates:
mean of x mean of y
 17.30000  20.93333

         t
0.03088223
[1] -0.5712679
[1] "p = .031" "p < .001" "p = .251" "p < .001"
    H0     H1
0.0496 0.4780
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Wynik na granicy istotności” przy p = .06 – jeśli przyjęto α = .05, wynik jest nieistotny. Zamiast szukać „trendu”, opisz wielkość efektu i przedział ufności.
- Porównywanie wartości p między grupami – to, że efekt jest istotny u kobiet (p = .02), a nieistotny u mężczyzn (p = .20), nie oznacza, że efekty w obu grupach istotnie się różnią. Sprawdź to bezpośrednio, np. testem interakcji.
- Wartość p bez wielkości efektu – sama informacja „p = .031” nie mówi, czy różnica ma znaczenie praktyczne. Dodaj d i 95% CI.
Najczęstsze pytania
Co oznacza wartość p?
Wartość p to prawdopodobieństwo uzyskania wyniku co najmniej tak skrajnego jak zaobserwowany, gdyby hipoteza zerowa i założenia testu były prawdziwe. Mała wartość p oznacza, że dane słabo pasują do H0. Nie mówi jednak, jak duży jest efekt ani jak prawdopodobna jest sama hipoteza.
Czy wartość p to prawdopodobieństwo, że hipoteza zerowa jest prawdziwa?
Nie. Wartość p liczy się przy założeniu, że H0 jest prawdziwa, więc nie może jednocześnie wyrażać prawdopodobieństwa tej hipotezy. Takie prawdopodobieństwo wymaga podejścia bayesowskiego, które uwzględnia wiarygodność hipotezy przed badaniem (zob. czynnik Bayesa).
Co oznacza p < .05?
Że wynik co najmniej tak skrajny jak uzyskany zdarzałby się rzadziej niż w 5% badań, gdyby H0 i założenia testu były prawdziwe – przy z góry przyjętym poziomie istotności α = .05 odrzucasz więc hipotezę zerową. Nie oznacza to, że ryzyko pomyłki w tym konkretnym wyniku wynosi 5%, ani że efekt jest duży. Zawsze podaj dokładną wartość p, wielkość efektu i przedział ufności.
Jak zapisać wartość p w APA?
Podaj dokładną wartość z trzema miejscami dziesiętnymi, bez zera przed kropką i kursywą: p = .031. Wartości mniejsze niż .001 zapisz jako p < .001 – nigdy jako p = .000. Wartość p podaj razem ze statystyką testu, np. t(58) = −2.21, p = .031.
Czym różni się wartość p od poziomu istotności α?
Poziom istotności α ustalasz przed badaniem – to dopuszczalny odsetek fałszywych alarmów w długiej serii badań, w których H0 jest prawdziwa. Wartość p obliczasz z danych po badaniu i odrzucasz H0, gdy p < α. Więcej w haśle poziom istotności (alfa).
Czy wynik p = .06 jest „na granicy istotności”?
Jeśli przed badaniem przyjęto α = .05, wynik p = .06 jest nieistotny statystycznie i nie należy go przedstawiać jako „prawie istotnego”. Jednocześnie nie dowodzi on braku efektu. Opisz wielkość efektu i przedział ufności – pokażą, jakie wartości efektu są zgodne z danymi.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikWynik istotny, ale efekt mały
Dlaczego przy dużej próbie słaby efekt daje p < .001, jak ocenić jego znaczenie praktyczne i jak go uczciwie opisać w pracy – przykład w R.
Czytaj →PoradnikJak opisać wynik nieistotny
Co podać przy p > .05, jak odróżnić brak efektu od wyniku nierozstrzygającego, sformułowania źle i dobrze oraz gotowy wzór opisu w stylu APA.
Czytaj →Poradnikp = .06 – trend czy brak efektu?
Dlaczego p = .06 to ani trend, ani dowód braku efektu, co pokazuje symulacja replikacji i jak opisać taki wynik w pracy: efekt z CI i czułość badania.
Czytaj →PoradnikPytania ze statystyki na obronę magisterską
Pytania promotora i recenzenta ułożone według analizy – od testu t i chi-kwadrat po regresję, ANOVA i alfę Cronbacha – z krótkimi odpowiedziami na liczbach.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. https://doi.org/10.1038/d41586-019-00857-9 ● Otwarty dostęp
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Nuzzo, R. (2014). Scientific method: Statistical errors. Nature, 506(7487), 150–152. https://doi.org/10.1038/506150a ● Otwarty dostęp
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Wolski, P. (2016). Istotność statystyczna II. Pułapki interpretacyjne. Rocznik Kognitywistyczny, 9, 59–70. https://doi.org/10.4467/20843895RK.16.006.6412 ● Otwarty dostęp
Cytowania BibTeX
@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{amrhein2019scientists, author={Amrhein, Valentin and Greenland, Sander and McShane, Blake}, title={{Scientists rise up against statistical significance}}, journal={Nature}, year={2019}, volume={567}, number={7748}, pages={305--307}, doi={10.1038/d41586-019-00857-9}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{nuzzo2014scientific, author={Nuzzo, Regina}, title={{Scientific method: Statistical errors}}, journal={Nature}, year={2014}, volume={506}, number={7487}, pages={150--152}, doi={10.1038/506150a}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{wolski2016istotnosc, author={Wolski, Piotr}, title={{Istotność statystyczna II. Pułapki interpretacyjne}}, journal={Rocznik Kognitywistyczny}, year={2016}, volume={9}, pages={59--70}, doi={10.4467/20843895rk.16.006.6412}}