Co to jest korekta Bonferroniego?
Korekta Bonferroniego (ang. Bonferroni correction) to najprostszy sposób kontroli błędu przy wielu testach statystycznych: jeśli wykonujesz m testów, każdy z nich przeprowadzasz na poziomie α/m zamiast α. Równoważnie możesz pomnożyć każdą wartość p przez m (z górnym limitem 1) i porównać wynik z α. Przy sześciu testach i α = .05 próg dla pojedynczego testu wynosi więc .05/6 = .0083.
Korekta odpowiada na problem porównań wielokrotnych (ang. multiple comparisons problem). W psychologii pojawia się on bardzo często: przy testach post hoc po ANOVA, przy porównaniu grup na kilku podskalach kwestionariusza, przy macierzy korelacji czy przy analizie wielu zmiennych zależnych. Każdy dodatkowy test to kolejna szansa na fałszywy alarm, czyli błąd I rodzaju.
Dlaczego wiele testów zwiększa ryzyko błędu?
Poziom istotności α = .05 dotyczy jednego testu. Gdy testów jest więcej, rośnie rodzinny błąd I rodzaju (ang. familywise error rate, FWER), czyli prawdopodobieństwo, że w całej rodzinie testów pojawi się co najmniej jeden fałszywy alarm. Dla m niezależnych testów, gdy wszystkie hipotezy zerowe są prawdziwe:
Kim (2014) zwraca uwagę, że właśnie dlatego kilku grup nie porównuje się serią testów t: łączny błąd rośnie do 1 − 0.95k przy k porównaniach. Dla 3 testów to .143, dla 6 – .265, dla 10 – .401, a dla 20 – już .642. W symulacji (20 000 powtórzeń sześciu niezależnych testów t przy prawdziwych H0) co najmniej jeden wynik istotny pojawił się w 26.5% powtórzeń; po korekcie Bonferroniego i Holma – w 5.0%.
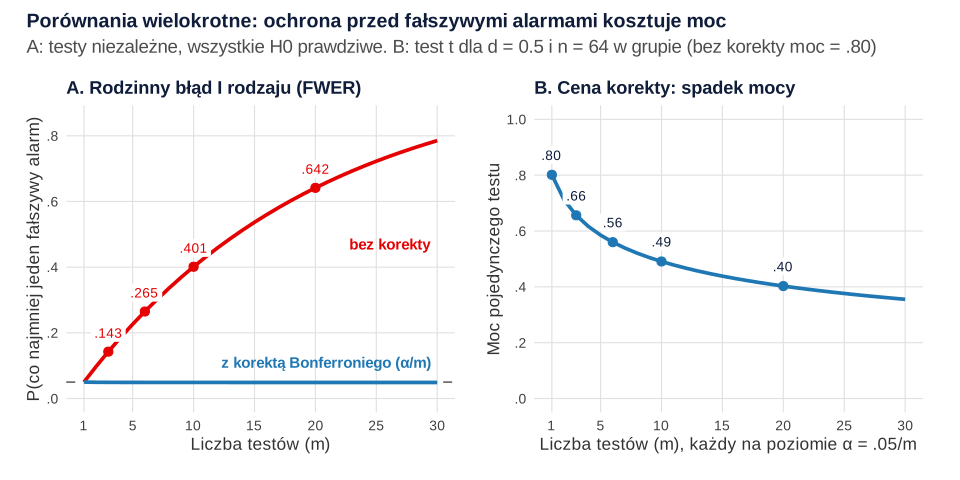
Panel B pokazuje drugą stronę medalu. Korekta chroni przed fałszywymi alarmami, ale obniża moc każdego testu: badanie, które przy jednym teście ma moc .80, przy korekcie na sześć testów ma już tylko .56, a na dwadzieścia – .40. Rośnie więc ryzyko błędu II rodzaju, czyli przeoczenia prawdziwego efektu.
Metody korekty: Bonferroni, Holm i Benjamini–Hochberg
| Metoda | Co kontroluje | Jak działa | W R (p.adjust) |
|---|---|---|---|
| Bonferroni | FWER | Każde p × m (maks. 1) albo próg α/m | "bonferroni" |
| Šidák | FWER (testy niezależne) | Próg 1 − (1 − α)1/m; dla 6 testów .0085 zamiast .0083 | brak; np. adjust = "sidak" w pakiecie emmeans |
| Holm (Holm–Bonferroni) | FWER | Sekwencyjnie: najmniejsze p z progiem α/m, kolejne z α/(m − 1) itd. | "holm" (domyślna) |
| Benjamini–Hochberg | FDR – oczekiwany odsetek fałszywych odkryć | Największe i, dla którego p(i) ≤ (i/m) α; odrzuć H0 od 1 do i | "BH" (też "fdr") |
Procedura Holma (Holm, 1979) odrzuca hipotezy po kolei: porządkuje wartości p od najmniejszej, pierwszą porównuje z α/m, drugą z α/(m − 1) i tak dalej, aż do pierwszej hipotezy, której nie da się odrzucić. Zapewnia z góry ustalony poziom ochrony przed błędem I rodzaju dla dowolnej kombinacji prawdziwych hipotez, a przy tym jest prosta i szeroko stosowalna. Ponieważ nigdy nie odrzuca mniej hipotez niż zwykły Bonferroni, zamiast klasycznego Bonferroniego używaj metody Holma.
Procedura Benjaminiego–Hochberga (Benjamini i Hochberg, 1995) zmienia cel kontroli. Zamiast prawdopodobieństwa choćby jednego błędu (FWER) kontroluje FDR (ang. false discovery rate), czyli oczekiwany odsetek fałszywie odrzuconych hipotez wśród wszystkich odrzuconych. Autorzy pokazali, że ta prosta sekwencyjna procedura typu Bonferroniego daje istotny zysk mocy. Sprawdza się w analizach eksploracyjnych z wieloma testami, w których kilka fałszywych odkryć jest akceptowalne, o ile stanowią mały odsetek wyników.
Przykład: sześć wartości p
Porównujesz dwie grupy studentów na sześciu podskalach kwestionariusza i otrzymujesz sześć wartości p z testów t. Tabela pokazuje je po trzech korektach (wynik funkcji p.adjust() w R):
| Podskala | p bez korekty | p Bonferroni | p Holm | p BH (FDR) |
|---|---|---|---|---|
| 1 | .002 | .012 | .012 | .012 |
| 2 | .009 | .054 | .045 | .027 |
| 3 | .014 | .084 | .056 | .028 |
| 4 | .021 | .126 | .063 | .032 |
| 5 | .038 | .228 | .076 | .046 |
| 6 | .260 | 1.000 | .260 | .260 |
| Liczba p < .05 | 5 | 1 | 2 | 5 |
Bez korekty istotnych jest pięć wyników, po korekcie Bonferroniego – jeden, po korekcie Holma – dwa, a po korekcie Benjaminiego–Hochberga – znów pięć. Holm porównuje kolejne wartości z progami .0083, .0100, .0125, .0167, .025 i .050: pierwsze dwie (.002 i .009) mieszczą się pod progami, trzecia (.014 > .0125) już nie, więc procedura się zatrzymuje. Procedura BH porównuje wartości z progami (i/6) × .05 = .0083, .0167, .025, .0333, .0417 i .050 i szuka największej wartości poniżej swojego progu – to piąta (.038 ≤ .0417), więc odrzuca pięć hipotez. Wybór metody zmienia wnioski, dlatego trzeba go uzasadnić przed analizą, a nie po zobaczeniu wyników.
Kiedy korygować, a kiedy nie?
Korekta nie jest obowiązkowa przy każdej liczbie testów – zależy od tego, jakie pytanie zadajesz. Perneger (1998) zwraca uwagę, że korekta Bonferroniego dotyczy „uniwersalnej” hipotezy zerowej, według której wszystkie hipotezy zerowe są prawdziwe jednocześnie, a ta rzadko interesuje badacza. Zmniejszając ryzyko błędu I rodzaju, korekta zwiększa ryzyko błędu II rodzaju, a interpretacja wyniku zaczyna zależeć od tego, ile innych testów wykonano. Perneger zaleca raczej opisanie, jakie testy wykonano i dlaczego. Armstrong (2014) też odradza rutynowe stosowanie korekty i wskazuje trzy sytuacje, w których warto ją rozważyć: gdy potrzebny jest test hipotezy „uniwersalnej”, gdy uniknięcie błędu I rodzaju jest kluczowe i gdy wykonuje się wiele testów bez wcześniej zaplanowanych hipotez.
- Koryguj porównania parami po istotnej ANOVA, wiele testów eksploracyjnych bez hipotez (np. dziesiątki korelacji) i sytuacje, w których jeden „sukces” wystarczy do ogłoszenia efektu (np. kilka miar tego samego wyniku pierwszorzędowego).
- Nie musisz korygować pojedynczej, zaplanowanej hipotezy głównej ani kilku hipotez, z których każda dotyczy innego pytania i jest opisana osobno – pod warunkiem, że zaplanowałeś je z góry, najlepiej w prerejestracji.
- Zawsze raportuj wszystkie wykonane testy, a nie tylko istotne – ukrywanie nieistotnych porównań to odmiana p-hackingu, której żadna korekta nie naprawi.
W porównaniach po ANOVA zamiast mnożenia wartości p zwykle używa się testów post hoc projektowanych dla par średnich. Lee i Lee (2018) w przeglądzie takich procedur omawiają m.in. testy Tukeya, Bonferroniego, Scheffégo i Dunnetta oraz sposoby kontroli błędu I rodzaju; przy nierównych wariancjach zalecają procedury bez założenia ich równości, takie jak test Gamesa–Howella. Szczegóły znajdziesz w haśle testy post hoc i w poradniku ANOVA krok po kroku.
Jak opisać korektę w pracy (APA)
W części „Metoda” albo przy pierwszym wyniku napisz, jaką rodzinę testów korygowałeś i jaką metodą. Przy wynikach podawaj skorygowane wartości p i zaznacz to w tekście lub w nocie tabeli:
Jeśli wybierasz próg zamiast korygowania p, napisz to wprost: „wyniki uznawano za istotne przy p < .0083 (korekta Bonferroniego dla sześciu porównań)”. W tabelach dodaj notę „Wartości p skorygowane metodą Holma”. Gotowe zdania do innych analiz znajdziesz we wpisie jak opisać wyniki w stylu APA.
Korekty w R
Kod koryguje sześć wartości p trzema metodami, liczy rodzinny błąd I rodzaju i wykonuje porównania parami czterech grup z korektą Holma. Liczby w tabeli i w tekście pochodzą z tego kodu.
Funkcja p.adjust() i porównania parami
R
# 1. Sześć wartości p (np. porównanie dwóch grup na sześciu podskalach) i trzy korekty
p <- c(.002, .009, .014, .021, .038, .260)
data.frame(p,
           bonferroni = p.adjust(p, method = "bonferroni"),
           holm       = p.adjust(p, method = "holm"),
           BH         = p.adjust(p, method = "BH"))

# 2. Rodzinny błąd I rodzaju bez korekty dla 3, 6, 10 i 20 niezależnych testów
round(1 - (1 - .05)^c(3, 6, 10, 20), 3)
.05 / 6   # próg Bonferroniego dla sześciu testów

# 3. Porównania parami czterech grup z korektą Holma (dane symulowane: poziom stresu)
set.seed(4)
stres <- c(rnorm(20, 20, 5), rnorm(20, 22, 5), rnorm(20, 25, 5), rnorm(20, 21, 5))
rok   <- factor(rep(c("I rok", "II rok", "III rok", "IV rok"), each = 20))
pairwise.t.test(stres, rok, p.adjust.method = "holm", pool.sd = FALSE)
Wynik w R
      p bonferroni  holm     BH
1 0.002      0.012 0.012 0.0120
2 0.009      0.054 0.045 0.0270
3 0.014      0.084 0.056 0.0280
4 0.021      0.126 0.063 0.0315
5 0.038      0.228 0.076 0.0456
6 0.260      1.000 0.260 0.2600
[1] 0.143 0.265 0.401 0.642
[1] 0.008333333

	Pairwise comparisons using t tests with non-pooled SD

data:  stres and rok

        I rok II rok III rok
II rok  0.689 -      -
III rok 0.198 0.699  -
IV rok  0.699 0.230  0.046

P value adjustment method: holm
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje p.adjust() i pairwise.t.test() z pakietu stats); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
W przykładzie z porównaniami parami bez korekty istotne byłyby dwie różnice: między I a III rokiem (p = .040) i między III a IV rokiem (p = .008). Po korekcie Holma istotna pozostaje tylko ta druga (p = .046).
Najczęstsze błędy
- Brak jakiejkolwiek kontroli przy wielu testach eksploracyjnych – przy 20 testach szansa na co najmniej jeden fałszywy alarm wynosi .642.
- Klasyczny Bonferroni zamiast Holma – Holm kontroluje ten sam błąd, a nigdy nie odrzuca mniej hipotez.
- Wybór metody po zobaczeniu wyników – sprawdzanie kolejno Bonferroniego, Holma i BH, aż coś „wyjdzie”, zawyża błąd I rodzaju tak samo jak brak korekty.
- Mylenie FWER z FDR – procedura Benjaminiego–Hochberga nie gwarantuje, że wśród wyników nie ma żadnego fałszywego alarmu; kontroluje tylko ich oczekiwany odsetek.
- Nieopisana rodzina testów – zawsze napisz, ile testów obejmowała korekta i dlaczego właśnie tyle.
- Interpretacja wyniku nieistotnego po korekcie jako dowodu braku efektu – korekta obniża moc, więc brak istotności tym bardziej nie oznacza braku różnicy.
Najczęstsze pytania
Na czym polega korekta Bonferroniego?
Przy m testach każdy wykonujesz na poziomie α/m zamiast α, dzięki czemu prawdopodobieństwo co najmniej jednego fałszywego alarmu w całej rodzinie testów nie przekracza α. Bez korekty przy 6 testach i α = .05 ryzyko to wynosi .265, a przy 20 testach – .642.
Jak obliczyć poprawkę Bonferroniego?
Podziel poziom istotności przez liczbę testów: przy α = .05 i 6 testach próg wynosi .05/6 = .0083. Równoważnie pomnóż każde p przez 6 (maksymalnie do 1) i porównaj z .05. W R użyj p.adjust(p, method = "bonferroni"), a w SPSS opcji Bonferroni w porównaniach post hoc albo w EM Means.
Czym się różni korekta Holma od Bonferroniego?
Obie kontrolują rodzinny błąd I rodzaju, ale procedura Holma (Holm, 1979) działa sekwencyjnie: najmniejsze p porównuje z α/m, następne z α/(m − 1) itd. Nigdy nie odrzuca mniej hipotez niż Bonferroni, więc ma większą moc. W przykładzie z tego hasła Bonferroni pozostawił jeden istotny wynik, a Holm – dwa.
Kiedy nie trzeba stosować korekty Bonferroniego?
Gdy testujesz jedną, zaplanowaną hipotezę główną albo kilka hipotez dotyczących różnych pytań, opisanych osobno i zaplanowanych z góry. Perneger (1998) i Armstrong (2014) odradzają rutynowe korygowanie, bo zwiększa ryzyko błędu II rodzaju; korektę rozważ przy wielu testach eksploracyjnych i porównaniach parami po ANOVA.
Co to jest FDR i procedura Benjaminiego–Hochberga?
FDR (ang. false discovery rate) to oczekiwany odsetek fałszywych odkryć wśród wszystkich wyników uznanych za istotne. Procedura Benjaminiego–Hochberga (1995) kontroluje FDR zamiast FWER i ma wyraźnie większą moc, dlatego dobrze sprawdza się w analizach eksploracyjnych z wieloma testami. W R: p.adjust(p, method = "BH").
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikWartość p: co naprawdę oznacza i jak ją poprawnie interpretować
Wartość p bez mitów: definicja, interpretacja, typowe błędy oraz sposób raportowania wraz z wielkością efektu i przedziałem ufności.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Armstrong, R. A. (2014). When to use the Bonferroni correction. Ophthalmic and Physiological Optics, 34(5), 502–508. https://doi.org/10.1111/opo.12131
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kim, H.-Y. (2014). Analysis of variance (ANOVA) comparing means of more than two groups. Restorative Dentistry & Endodontics, 39(1), 74–77. https://doi.org/10.5395/rde.2014.39.1.74 ● Otwarty dostęp
- Lee, S., & Lee, D. K. (2018). What is the proper way to apply the multiple comparison test? Korean Journal of Anesthesiology, 71(5), 353–360. https://doi.org/10.4097/kja.d.18.00242 ● Otwarty dostęp
- Perneger, T. V. (1998). What's wrong with Bonferroni adjustments. BMJ, 316(7139), 1236–1238. https://doi.org/10.1136/bmj.316.7139.1236 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{armstrong2014when, author={Armstrong, Richard A.}, title={{When to use the Bonferroni correction}}, journal={Ophthalmic and Physiological Optics}, year={2014}, volume={34}, number={5}, pages={502--508}, doi={10.1111/opo.12131}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kim2014analysis, author={Kim, Hae-Young}, title={{Analysis of variance (ANOVA) comparing means of more than two groups}}, journal={Restorative Dentistry \& Endodontics}, year={2014}, volume={39}, number={1}, pages={74--77}, doi={10.5395/rde.2014.39.1.74}}@article{lee2018what, author={Lee, Sangseok and Lee, Dong Kyu}, title={{What is the proper way to apply the multiple comparison test?}}, journal={Korean Journal of Anesthesiology}, year={2018}, volume={71}, number={5}, pages={353--360}, doi={10.4097/kja.d.18.00242}}@article{perneger1998whats, author={Perneger, Thomas V.}, title={{What's wrong with Bonferroni adjustments}}, journal={BMJ}, year={1998}, volume={316}, number={7139}, pages={1236--1238}, doi={10.1136/bmj.316.7139.1236}}