Kiedy wybrać ANOVA?
Analiza wariancji (ANOVA, ang. analysis of variance) porównuje średnie w więcej niż dwóch grupach albo w planach z kilkoma czynnikami. W pracach z psychologii odpowiada na pytania w rodzaju: czy trzy metody uczenia się dają różne wyniki egzaminu albo czy skuteczność treningu zależy od tego, czy uczestnicy dostają informację zwrotną. Definicję i najważniejsze wzory zebraliśmy w haśle ANOVA (analiza wariancji). Tutaj przechodzimy przez całą analizę krok po kroku na dwóch przykładach – od założeń po gotowy opis wyników w stylu APA, z kodem R i ścieżką w SPSS.
Dlaczego nie wystarczy seria testów t dla prób niezależnych? Przy trzech grupach potrzebne są trzy porównania. Jeśli każde wykonasz na poziomie α = .05, a w populacji nie ma żadnych różnic, prawdopodobieństwo co najmniej jednego fałszywego alarmu wynosi (dla niezależnych testów) 1 − (1 − .05)³ = .143. ANOVA zaczyna od jednego testu ogólnego (ang. omnibus), a pary grup sprawdza dopiero w testach post hoc, które kontrolują łączny błąd (zob. korekta Bonferroniego i porównania wielokrotne).
| Plan badania | Analiza |
|---|---|
| Jeden czynnik międzyobiektowy, trzy grupy lub więcej | Jednoczynnikowa ANOVA (domyślnie test F Welcha) – przykład 1 w tym wpisie |
| Dwa czynniki międzyobiektowe (np. 2 × 2) | Dwuczynnikowa ANOVA – przykład 2 w tym wpisie |
| Te same osoby badane kilka razy | ANOVA z powtarzanymi pomiarami |
| Porównanie grup z kontrolą zmiennej ilościowej (np. pretestu) | ANCOVA |
| Kilka powiązanych zmiennych zależnych naraz | MANOVA |
| Osoby zagnieżdżone w klasach, zespołach, szpitalach | Model wielopoziomowy |
| Dane porządkowe, silnie skośne, bardzo małe grupy | Test Kruskala–Wallisa |
| Tylko dwie grupy | Test t, najlepiej w wersji Welcha |
Jeśli nie masz pewności, czy ANOVA pasuje do Twojej hipotezy, zacznij od wpisu jak dobrać test statystyczny do hipotezy.
Logika ANOVA: skąd się bierze statystyka F?
Nazwa „analiza wariancji” bywa myląca, bo celem jest porównanie średnich. Droga do tego celu prowadzi jednak przez wariancję: całkowite zróżnicowanie wyników dzielimy na dwie części. Wariancja międzygrupowa mówi, jak daleko średnie grup leżą od średniej ogólnej. Wariancja wewnątrzgrupowa mówi, jak bardzo osoby różnią się od średniej własnej grupy – to „szum”, którego czynnik nie wyjaśnia.
- SS – suma kwadratów odchyleń (ang. sum of squares),
- MS – średni kwadrat, czyli suma kwadratów podzielona przez stopnie swobody,
- k – liczba grup, N – liczba wszystkich osób.
Jeśli hipoteza zerowa jest prawdziwa i wszystkie średnie w populacji są równe, oba średnie kwadraty szacują tę samą wariancję błędu, więc F oscyluje wokół 1. Różnice między grupami „pompują” licznik i F rośnie. Wartość p odczytujemy z rozkładu F o (k − 1, N − k) stopniach swobody. Dla pierwszego przykładu z tego wpisu tabela ANOVA wygląda tak:
| Źródło zmienności | SS | df | MS | F | p |
|---|---|---|---|---|---|
| Między grupami (metoda) | 846.00 | 2 | 423.00 | 12.09 | < .001 |
| Wewnątrz grup (błąd) | 3113.16 | 89 | 34.98 | ||
| Ogółem | 3959.16 | 91 |
Suma kwadratów między grupami to Σnj(Mj − M)², czyli 343.02 + 22.57 + 480.41 = 846.00 dla trzech grup o średnich 23.03, 25.44 i 30.12 wokół średniej ogólnej 26.36. Po podzieleniu sum przez stopnie swobody otrzymujemy F = 423.00 / 34.98 = 12.09. Wartość krytyczna F(2, 89) dla α = .05 wynosi 3.10, więc wynik jest istotny. ANOVA jest szczególnym przypadkiem modelu liniowego: test F porównuje model, w którym każda grupa ma własną średnią, z modelem z jedną wspólną średnią. To ujęcie porównywania modeli konsekwentnie rozwijają Maxwell i in. (2018).
Przykład 1: trzy metody uczenia się przed egzaminem
Dziewięćdziesiąt dwie osoby studiujące losowo przydzielono do trzech sposobów przygotowania do tego samego egzaminu (0–40 punktów): powtórnego czytania notatek, tworzenia map myśli albo nauki z fiszkami, które wymuszają przypominanie sobie materiału. Nie wszyscy przyszli na egzamin, dlatego grupy są nierówne (31, 27 i 34 osoby). Dane są symulowane, ale mają parametry typowe dla takich badań. Zmienną zależną jest wynik egzaminu, a zmienną niezależną – metoda uczenia się, czyli czynnik międzyobiektowy o trzech poziomach.
| Metoda uczenia się | n | M | SD | 95% CI dla M |
|---|---|---|---|---|
| Powtórne czytanie | 31 | 23.03 | 4.35 | [21.43, 24.63] |
| Mapy myśli | 27 | 25.44 | 5.91 | [23.11, 27.78] |
| Fiszki | 34 | 30.12 | 7.04 | [27.66, 32.57] |
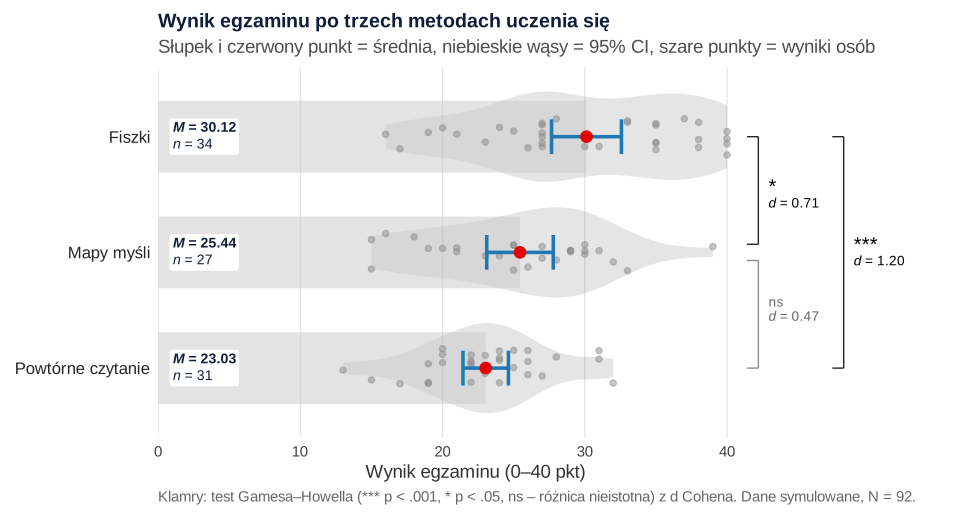
Wykres łączy kilka warstw: rozkład wyników, wyniki pojedynczych osób, średnią z 95% przedziałem ufności i wyniki porównań parami. Widać na nim trzy rzeczy. Po pierwsze, fiszki dają najwyższe wyniki. Po drugie, grupy różnią się rozproszeniem: odchylenie standardowe rośnie od 4.35 do 7.04 punktu, a największa wariancja jest 2.61 raza większa od najmniejszej. Po trzecie, w grupie fiszek cztery osoby zdobyły maksymalne 40 punktów – to słaby efekt sufitu, który przy łatwiejszym teście mógłby zniekształcić wyniki. Zanim policzysz jakikolwiek test, zawsze obejrzyj taki wykres.
Krok 1. Sprawdź założenia
Klasyczna ANOVA ma trzy założenia. Ich waga jest różna, dlatego sprawdzaj je w tej kolejności:
- Niezależność obserwacji. Każda osoba występuje w jednej grupie, a wyniki osób nie zależą od siebie. Tego założenia nie sprawdzi żaden test – wynika z planu badania. Jeśli te same osoby mierzysz kilka razy, użyj ANOVA z powtarzanymi pomiarami; jeśli osoby są zagnieżdżone w klasach czy zespołach – modelu wielopoziomowego.
- Normalność reszt. Założenie dotyczy rozkładu reszt (wynik osoby minus średnia jej grupy), a nie rozkładu zmiennej zależnej w całej próbie.
- Jednorodność wariancji (homogeniczność wariancji) – wariancje wyników w populacjach, z których pochodzą grupy, są równe.
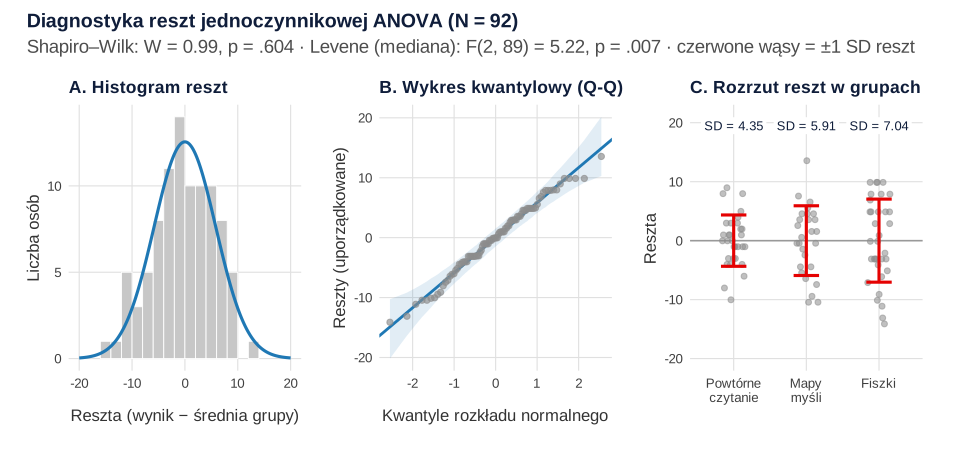
Normalność najlepiej oceniać wzrokowo: na histogramie reszt i na wykresie kwantylowym (Q-Q). W naszych danych reszty są symetryczne, a wszystkie punkty na wykresie Q-Q mieszczą się w obwiedni wyznaczonej dla danych z rozkładu normalnego. Test Shapiro–Wilka to potwierdza: W = 0.99, p = .604. Nawet wyraźniejsze odstępstwa nie byłyby powodem do paniki. Blanca i in. (2017) w symulacji Monte Carlo z trzema grupami i rozkładami typowymi dla nauk o zdrowiu i nauk społecznych pokazali, że test F zachował poprawny poziom błędu I rodzaju we wszystkich badanych warunkach – przy równych i nierównych liczebnościach.
Poważniejszym problemem są nierówne wariancje, zwłaszcza gdy grupy mają różne liczebności. Panel C rysunku 2 pokazuje, że rozrzut reszt rośnie razem ze średnią grupy, a test Levene’a (w wariancie z medianą) jest istotny: F(2, 89) = 5.22, p = .007.
Nie wybieraj jednak testu na podstawie testu Levene’a. Procedura dwuetapowa – „najpierw Levene, potem test klasyczny albo Welcha” – wydaje się rozsądna, ale nie chroni poziomu istotności. Zimmerman (2004) pokazał na przykładzie testu t, że taka procedura zwykle pogarsza sytuację, a najlepszą ochronę daje bezwarunkowe stosowanie testu dla oddzielnych wariancji, gdy liczebności grup są nierówne. Test Levene’a ma przy tym małą moc w małych próbach, a w dużych wykrywa różnice bez praktycznego znaczenia. Rozsądniej od razu wybrać test, który równości wariancji nie wymaga.
Krok 2. Test F Welcha zamiast klasycznego
Test F Welcha nie zakłada równości wariancji. Każda grupa dostaje wagę nj / sj², więc grupy o dużym rozrzucie mniej ważą w wyniku, a mianownikowe stopnie swobody są korygowane – stąd ich ułamkowa wartość. Delacre i in. (2019) argumentują, że w psychologii założenia normalności i równości wariancji są często nierealistyczne, a przy realistycznym zróżnicowaniu wariancji klasyczny test F daje obciążone wyniki. Spośród alternatyw (W Welcha, F* Browna–Forsythe’a) rekomendują domyślne stosowanie testu Welcha. Wzory i przykład z dwiema grupami znajdziesz w haśle test Welcha.
W naszym przykładzie oba testy dają podobny wynik:
- test F Welcha: F(2, 56.24) = 12.02, p < .001,
- klasyczny test F: F(2, 89) = 12.09, p < .001.
Taka zgodność nie jest jednak regułą. Rysunek 3 pokazuje wyniki symulacji: 20 000 razy losowaliśmy trzy grupy z populacji o tej samej średniej i liczyliśmy, jak często każdy z testów (błędnie) daje wynik istotny.
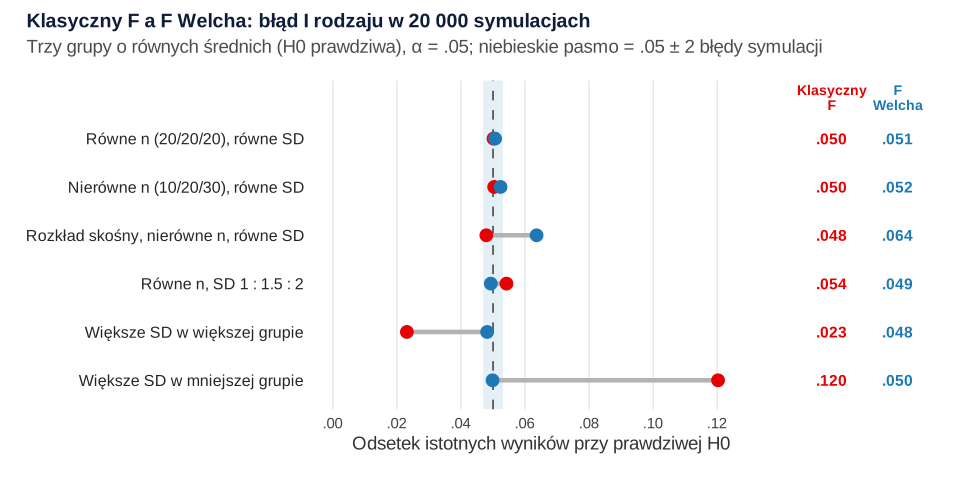
Gdy wariancje są równe, oba testy trzymają nominalne 5%. Kłopot zaczyna się przy nierównych wariancjach i liczebnościach. Jeśli największa wariancja przypada na najmniejszą grupę, klasyczny F daje 12.0% fałszywych alarmów – 2.4 raza więcej, niż obiecuje α. W odwrotnej sytuacji (tak jak w naszych danych, gdzie największą wariancję ma największa grupa) staje się zbyt zachowawczy: 2.3% fałszywych alarmów oznacza też utratę mocy. Test Welcha we wszystkich wariantach z rozkładem normalnym mieścił się w przedziale 4.8–5.2%. Nie jest jednak doskonały: przy skośnym rozkładzie i najmniejszej grupie liczącej 10 osób dawał 6.4% fałszywych alarmów. Jako domyślną analizę wybierz więc test Welcha, a przy małych i wyraźnie skośnych grupach rozważ dodatkowo metody odporne lub nieparametryczne (zob. alternatywy dla ANOVA).
Krok 3. Testy post hoc: które grupy się różnią?
Istotny test F mówi tylko tyle, że nie wszystkie średnie są równe. Które pary grup się różnią, sprawdzają testy post hoc – porównania par z kontrolą łącznego prawdopodobieństwa błędu I rodzaju. Wybór testu zależy przede wszystkim od tego, czy możesz założyć równe wariancje (tabelę porównawczą procedur znajdziesz w haśle testy post hoc):
- test HSD Tukeya – standard przy równych wariancjach (przy nierównych liczebnościach w wersji Tukeya–Kramera);
- test Gamesa–Howella – nie zakłada równych wariancji; każda para dostaje własny błąd standardowy i stopnie swobody Welcha.
Lee i Lee (2018) w przeglądzie testów porównań wielokrotnych zalecają przy naruszonej równości wariancji procedury, które jej nie wymagają: test Gamesa–Howella, T2 Tamhane’a oraz T3 i C Dunnetta. Sauder i DeMars (2019) sprawdzili w symulacji 18 procedur porównań parami dostępnych w SPSS. Błąd I rodzaju właściwie kontrolowały jedynie cztery testy zaprojektowane na wypadek naruszenia założeń (nierównych liczebności i wariancji); ich moc była zbliżona, nieco najwyższa dla testu Gamesa–Howella.
| Porównanie | Różnica (pkt) | 95% CI (Games–Howell) | p (Games–Howell) | p (Tukey) | d [95% CI] |
|---|---|---|---|---|---|
| Mapy myśli − powtórne czytanie | 2.41 | [−0.93, 5.75] | .199 | .273 | 0.47 [−0.06, 0.99] |
| Fiszki − powtórne czytanie | 7.09 | [3.62, 10.55] | < .001 | < .001 | 1.20 [0.66, 1.72] |
| Fiszki − mapy myśli | 4.67 | [0.68, 8.66] | .018 | .008 | 0.71 [0.19, 1.23] |
Oba testy prowadzą tu do tych samych wniosków: fiszki dają wyższy wynik niż powtórne czytanie (o 7.09 punktu) i niż mapy myśli (o 4.67 punktu). Różnica między mapami myśli a powtórnym czytaniem jest nieistotna, ale jej przedział ufności [−0.93, 5.75] jest szeroki – dane są zgodne zarówno z brakiem różnicy, jak i z umiarkowaną przewagą map myśli. Nieistotny wynik nie dowodzi więc, że obie metody są równie skuteczne. Zwróć też uwagę, że przy porównaniu fiszek z mapami myśli test Tukeya daje mniejsze p (.008) niż test Gamesa–Howella (.018). Tukey korzysta ze wspólnej wariancji błędu (34.98), wyraźnie mniejszej niż wariancja w grupie fiszek (49.56), więc niedoszacowuje błąd standardowy tej różnicy.
Jeśli przed badaniem miałeś konkretną hipotezę, np. „fiszki dają lepsze wyniki niż obie pozostałe metody”, zamiast wszystkich par przetestuj zaplanowane kontrasty. To mniej porównań, a więc mniejsza korekta i większa moc.
Krok 4. Wielkość efektu: η², ω² i d Cohena
Wartość p nie mówi, jak duża jest różnica. Lakens (2013) pokazuje, jak liczyć i raportować wielkości efektu dla testów t i ANOVA, tak by wyniki mogły służyć analizom mocy i metaanalizom. W ANOVA najczęściej spotkasz cztery miary odsetka wyjaśnionej zmienności:
- η² (eta kwadrat) = SSefekt / SScałk – odsetek całkowitej zmienności wyjaśniony przez czynnik. U nas 846.00 / 3959.16 = .21, 95% CI [.07, .35]. W próbie η² jest systematycznie zawyżone.
- ω² (omega kwadrat) = (SSmiędzy − dfmiędzy × MSwewn) / (SScałk + MSwewn) – koryguje to zawyżenie. U nas ω² = .19, 95% CI [.06, .33]; tę miarę warto podawać w opisie.
- Cząstkowe η² (η²p) = SSefekt / (SSefekt + SSbłąd) – w ANOVA jednoczynnikowej równe η², w planach czynnikowych pomija zmienność wyjaśnianą przez pozostałe efekty. To tę miarę SPSS podaje jako Partial Eta Squared.
- Uogólnione η² (η²G) – Olejnik i Algina (2003) pokazali, że cechy planu badania silnie wpływają na oszacowany odsetek wyjaśnionej wariancji, przez co cząstkowe η² i ω² mogą wprowadzać w błąd, i podali wzory na miary uogólnione, porównywalne między planami. Bakeman (2005) zaleca rutynowe raportowanie η²G w ANOVA z powtarzanymi pomiarami, bo zapewnia porównywalność schematów między- i wewnątrzobiektowych.
Dla porównań par podawaj d Cohena z przedziałem ufności (w tabeli wyżej: od 0.47 do 1.20). Jak czytać te wartości, wyjaśniamy w hasłach eta kwadrat i d Cohena oraz we wpisie wielkość efektu: jak ocenić znaczenie wyniku. Progi „mały–średni–duży” to tylko konwencja – lepiej odnieść wynik do efektów spotykanych w Twojej dziedzinie.
Krok 5. Opis wyników w stylu APA
W opisie podaj, jaki test wykonano, statystykę F ze stopniami swobody, dokładne p, wielkość efektu z przedziałem ufności, a potem wyniki porównań post hoc ze średnimi i odchyleniami standardowymi. Gotowy opis wyników przykładu 1:
Te same liczby możesz zebrać w tabeli. Wzór tabeli ANOVA w stylu APA (z kilkoma wariantami) znajdziesz w haśle tabela ANOVA w APA, a więcej gotowych zdań – we wpisie jak opisać wyniki w stylu APA.
Tabela 1
Wyniki egzaminu w grupach różniących się metodą uczenia się
| Metoda uczenia się | n | M | SD | 95% CI |
|---|---|---|---|---|
| Powtórne czytanie | 31 | 23.03a | 4.35 | [21.43, 24.63] |
| Mapy myśli | 27 | 25.44a | 5.91 | [23.11, 27.78] |
| Fiszki | 34 | 30.12b | 7.04 | [27.66, 32.57] |
Uwaga. N = 92. Średnie oznaczone różnymi literami w indeksie dolnym różnią się istotnie (p < .05, test Gamesa–Howella). Test F Welcha: F(2, 56.24) = 12.02, p < .001, ω² = .19, 95% CI [.06, .33]. CI = przedział ufności. Dane symulowane.
Przykład 2: ANOVA dwuczynnikowa, efekty główne i interakcja
W drugim przykładzie 102 osoby uczyły się rozwiązywać zadania ze statystyki. Część ćwiczyła na przykładach rozwiązanych krok po kroku (48 osób), część rozwiązywała zadania samodzielnie (54 osoby). Niezależnie od tego część uczestników po każdym zadaniu dostawała natychmiastową informację zwrotną, a pozostali nie dostawali jej wcale. To plan czynnikowy 2 × 2 z dwoma czynnikami międzyobiektowymi; zmienną zależną jest wynik testu końcowego (0–100 punktów). Po rezygnacjach liczebności komórek są nierówne – od 22 do 30 osób. Dane są symulowane.
Dwuczynnikowa ANOVA testuje trzy hipotezy: dwa efekty główne (rodzaju treningu i informacji zwrotnej) oraz efekt interakcji. Interakcja oznacza, że wpływ jednego czynnika zależy od poziomu drugiego. Kim (2014) zwraca uwagę, że powtarzanie jednoczynnikowych analiz dla kolejnych poziomów drugiego czynnika nie pozwala wykryć interakcji – dlatego oba czynniki trzeba ująć w jednym modelu.
| Rodzaj treningu | Informacja zwrotna | n | M | SD |
|---|---|---|---|---|
| Przykłady rozwiązane | Brak | 26 | 66.38 | 13.13 |
| Przykłady rozwiązane | Natychmiastowa | 22 | 64.55 | 13.37 |
| Samodzielne zadania | Brak | 30 | 52.87 | 11.16 |
| Samodzielne zadania | Natychmiastowa | 24 | 68.17 | 13.66 |
Wyniki dwuczynnikowej ANOVA (sumy kwadratów typu II – o wyborze typu piszemy niżej):
- interakcja rodzaju treningu i informacji zwrotnej: F(1, 98) = 11.35, p = .001, η²p = .10, 95% CI [.02, .23];
- efekt główny informacji zwrotnej: F(1, 98) = 8.06, p = .006, η²p = .08;
- efekt główny rodzaju treningu: F(1, 98) = 5.20, p = .025, η²p = .05.
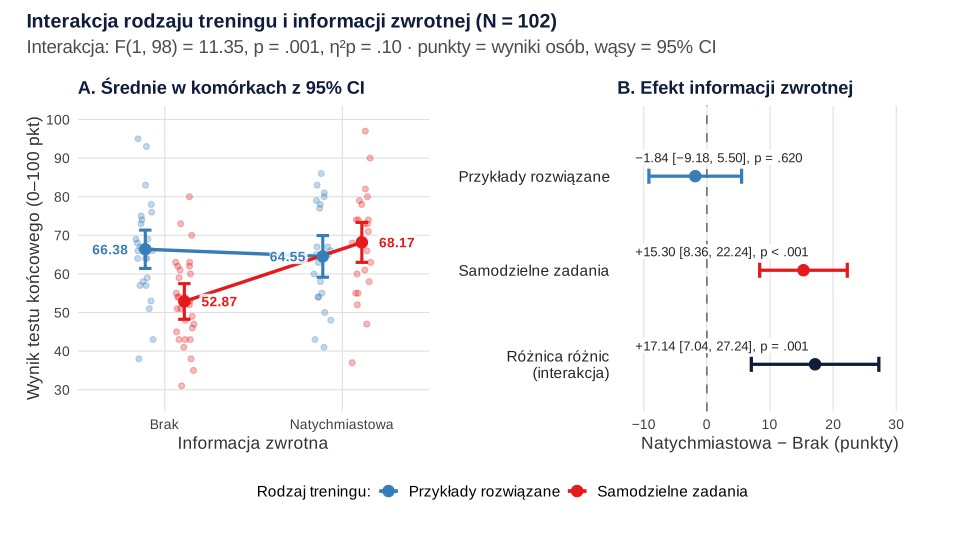
Rysunek 4 pokazuje, dlaczego przy istotnej interakcji efekty główne trzeba interpretować ostrożnie. Efekt główny treningu sugeruje, że przykłady rozwiązane są ogólnie lepsze, ale ta przewaga występuje tylko bez informacji zwrotnej. Gdy informacja zwrotna jest, średnie obu grup są zbliżone (64.55 i 68.17). Linie na wykresie się krzyżują – to interakcja nieporządkująca (ang. disordinal). Rosnow i Rosenthal (1989) przypominają, że efekt interakcji to reszta, która zostaje po usunięciu efektów głównych, a nie same różnice między średnimi w komórkach. W ich przeglądzie 320 artykułów z czasopism APA znaczna część badaczy interpretowała interakcje niepoprawnie, opisując jedynie efekty proste.
Efekty proste: jak rozłożyć interakcję
Efekt prosty to wpływ jednego czynnika przy ustalonym poziomie drugiego. Licz go na średnich brzegowych z modelu (pakiet emmeans w R, polecenie /EMMEANS … COMPARE w SPSS), bo wtedy korzystasz ze wspólnej wariancji błędu i stopni swobody całego modelu. Ponieważ pytanie badawcze dotyczy tego, kiedy informacja zwrotna pomaga, rozkładamy interakcję według rodzaju treningu:
- samodzielne zadania: natychmiastowa informacja zwrotna podnosi wynik o 15.30 punktu, 95% CI [8.36, 22.24], t(98) = 4.38, p < .001, d = 1.20;
- przykłady rozwiązane: różnica wynosi −1.84 punktu, 95% CI [−9.18, 5.50], t(98) = −0.50, p = .620, d = −0.14.
Możesz też spojrzeć z drugiej strony: bez informacji zwrotnej przykłady rozwiązane dają o 13.52 punktu więcej niż samodzielne zadania, 95% CI [6.73, 20.31], t(98) = 3.95, p < .001, d = 1.06, a z informacją zwrotną różnica jest nieistotna: −3.62 punktu, 95% CI [−11.10, 3.86], t(98) = −0.96, p = .339.
Uważaj na częsty skrót myślowy. Z tego, że efekt jest istotny w jednej grupie, a nieistotny w drugiej, nie wynika jeszcze, że efekty się różnią. O interakcji mówi test różnicy różnic: 15.30 − (−1.84) = 17.14 punktu, 95% CI [7.04, 27.24], t(98) = 3.37, p = .001. To dokładnie ten sam test co F dla interakcji (t² = 11.35 = F). Przy kilku efektach prostych rozważ korektę Holma lub Bonferroniego; w naszym przykładzie korekta Holma nie zmienia wniosków.
Nierówne liczebności: sumy kwadratów typu I, II i III
W planie zrównoważonym (równe liczebności komórek) czynniki są nieskorelowane i wszystkie sposoby liczenia sum kwadratów dają ten sam wynik. Przy nierównych liczebnościach część zmienności jest wspólna dla czynników i trzeba zdecydować, któremu efektowi ją przypisać. Stąd trzy typy sum kwadratów:
| Typ | Co testuje | Gdzie jest domyślny | Efekt treningu w przykładzie |
|---|---|---|---|
| I (sekwencyjny) | Każdy efekt po uwzględnieniu efektów wpisanych do modelu wcześniej – wynik zależy od kolejności | anova() w R | F(1, 98) = 5.38, p = .022 (trening wpisany jako pierwszy) |
| II | Efekt główny po uwzględnieniu drugiego efektu głównego, ale bez interakcji | car::Anova() w R | F(1, 98) = 5.20, p = .025 |
| III | Każdy efekt po uwzględnieniu wszystkich pozostałych, także interakcji; porównuje nieważone średnie brzegowe | SPSS (GLM), car::Anova(type = 3) z kodowaniem efektów | F(1, 98) = 3.78, p = .055 |
W naszych danych wybór typu zmienia wniosek o efekcie głównym treningu: w typie II jest on istotny, w typie III – nie. Test interakcji jest w obu typach identyczny (F = 11.35), bo to efekt najwyższego rzędu. Różnica bierze się z innej definicji średniej brzegowej. Typ III porównuje nieważone średnie brzegowe, czyli zwykłe średnie z dwóch komórek (65.47 vs 60.52 punktu, różnica 4.95). Hipoteza testowana w typie II zależy od liczebności komórek i jest bliższa porównaniu średnich wszystkich osób w danym rodzaju treningu (65.54 vs 59.67 punktu, różnica 5.88).
Który typ wybrać? Langsrud (2003) zauważa, że większość programów domyślnie liczy niezrównoważoną ANOVA na sumach kwadratów typu III, które opierają się na nierealistycznych modelach (z interakcją, ale bez odpowiadających jej efektów głównych), i po uwzględnieniu mocy obu podejść uznaje typ II za lepszy wybór. Smith i Cribbie (2014) również zalecają typ II do testowania efektów głównych, bo przy braku interakcji testuje on sensowne hipotezy i ma największą moc. Zasady praktyczne:
- Wybierz typ przed analizą i wpisz go do planu analiz lub prerejestracji. Szukanie typu, który daje p < .05, to odmiana p-hackingu.
- Zawsze podaj typ sum kwadratów w opisie metody albo w nocie tabeli.
- Przy istotnej interakcji opieraj wnioski na efektach prostych, a efekty główne traktuj jako uśrednienie efektów, które w różnych warunkach mogą mieć różny kierunek.
- Typ III w R tylko z kodowaniem efektów. Przy domyślnym w R kodowaniu zero-jedynkowym (
contr.treatment, ang. dummy coding) funkcjacar::Anova(type = 3)testuje co innego niż efekty główne. W naszych danych zwróciła dla treningu F(1, 98) = 15.62, p < .001, a dla informacji zwrotnej F(1, 98) = 0.25, p = .620 – to po prostu efekty proste na poziomach odniesienia (bez informacji zwrotnej i przy przykładach rozwiązanych). Przed typem III ustawoptions(contrasts = c("contr.sum", "contr.poly")).
Opis wyników dwuczynnikowej ANOVA (APA)
Przy istotnej interakcji zacznij od niej, potem opisz efekty proste, a efekty główne podaj na końcu z zastrzeżeniem. Gotowy opis wyników przykładu 2:
Tabela 2
Dwuczynnikowa analiza wariancji wyniku testu końcowego
| Źródło zmienności | SS | df | MS | F | p | η²p |
|---|---|---|---|---|---|---|
| Rodzaj treningu (A) | 847.29 | 1 | 847.29 | 5.20 | .025 | .05 |
| Informacja zwrotna (B) | 1313.04 | 1 | 1313.04 | 8.06 | .006 | .08 |
| A × B | 1848.47 | 1 | 1848.47 | 11.35 | .001 | .10 |
| Błąd | 15966.41 | 98 | 162.92 |
Uwaga. N = 102. Sumy kwadratów typu II. η²p = cząstkowe eta kwadrat. W typie III efekt rodzaju treningu: F(1, 98) = 3.78, p = .055; efekt informacji zwrotnej: F(1, 98) = 7.00, p = .010. Dane symulowane.
ANOVA w SPSS: ścieżka w menu
Jednoczynnikowa ANOVA z testem Welcha – Analyze → Compare Means → One-Way ANOVA:
- Przenieś wynik do pola Dependent List, a zmienną grupującą do pola Factor.
- W Options zaznacz Descriptive, Homogeneity of variance test i Welch (opcjonalnie Brown-Forsythe).
- W Post Hoc zaznacz Games-Howell w sekcji Equal Variances Not Assumed, a do porównania także Tukey.
- W nowszych wersjach SPSS zaznacz Estimate effect size for overall tests – program poda η², ε² i ω².
- Odczytaj tabelę Robust Tests of Equality of Means (wiersz Welch) i tabelę Multiple Comparisons.
Dwuczynnikowa ANOVA – Analyze → General Linear Model → Univariate:
- Wynik przenieś do pola Dependent Variable, oba czynniki do Fixed Factor(s).
- W Model zostaw Full factorial. Typ sum kwadratów (Sum of squares) domyślnie to Type III – zmień go na Type II, jeśli tak zaplanowałeś.
- W Options zaznacz Descriptive statistics, Estimates of effect size i Homogeneity tests.
- W EM Means przenieś interakcję trening*informacja. Efekty proste najprościej uzyskać w składni:
/EMMEANS=TABLES(trening*informacja) COMPARE(informacja) ADJ(BONFERRONI). - W Plots dodaj wykres interakcji (jeden czynnik na osi poziomej, drugi jako osobne linie) ze słupkami błędów 95% CI.
SPSS w kolumnie Partial Eta Squared podaje cząstkowe η² – opisuj je jako η²p, a nie η². Szczegółowe omówienie okien programu znajdziesz w podręczniku Fielda (2018), a te same analizy wykonasz też w darmowych programach jamovi i JASP.
ANOVA w R: kod i wynik
Oba przepisy są samodzielne: generują dane symulowane z tego wpisu i wykonują całą analizę. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń.
Jednoczynnikowa ANOVA: założenia, test Welcha, post hoc i ω²
R
library(car)          # leveneTest()
library(rstatix)      # games_howell_test()
library(effectsize)   # omega_squared()

# Dane symulowane: wynik egzaminu (0–40 pkt) po trzech metodach uczenia się
set.seed(389)
n <- c(31, 27, 34)
metoda <- factor(rep(c("Powtórne czytanie", "Mapy myśli", "Fiszki"), n),
                 levels = c("Powtórne czytanie", "Mapy myśli", "Fiszki"))
wynik <- unlist(mapply(function(n, m, s) pmin(pmax(round(rnorm(n, m, s)), 0), 40),
                       n, c(23, 25.5, 29), c(5, 6, 7.5)))
dane <- data.frame(metoda, wynik)

# 1. Statystyki opisowe
aggregate(wynik ~ metoda, data = dane,
          FUN = function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# 2. Model i założenia
model <- aov(wynik ~ metoda, data = dane)
shapiro.test(residuals(model))            # normalność reszt
leveneTest(wynik ~ metoda, data = dane)   # równość wariancji (wariant z medianą)

# 3. Test F Welcha (domyślnie var.equal = FALSE) i klasyczny test F
oneway.test(wynik ~ metoda, data = dane)
summary(model)

# 4. Wielkość efektu (ω² z dwustronnym 95% CI)
omega_squared(model, partial = FALSE, alternative = "two.sided")

# 5. Post hoc: Games–Howell (bez założenia równych wariancji) i Tukey HSD
as.data.frame(games_howell_test(dane, wynik ~ metoda))
TukeyHSD(model)

# 6. Alternatywa nieparametryczna
kruskal.test(wynik ~ metoda, data = dane)
Wynik w R
             metoda wynik.n wynik.M wynik.SD
1 Powtórne czytanie   31.00   23.03     4.35
2        Mapy myśli   27.00   25.44     5.91
3            Fiszki   34.00   30.12     7.04

	Shapiro-Wilk normality test

data:  residuals(model)
W = 0.98848, p-value = 0.6038

Levene's Test for Homogeneity of Variance (center = median)
      Df F value   Pr(>F)
group  2    5.22 0.007184 **
      89
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	One-way analysis of means (not assuming equal variances)

data:  wynik and metoda
F = 12.016, num df = 2.000, denom df = 56.244, p-value = 4.517e-05

            Df Sum Sq Mean Sq F value   Pr(>F)
metoda       2    846     423   12.09 2.26e-05 ***
Residuals   89   3113      35
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter | Omega2 |       95% CI
---------------------------------
metoda    |   0.19 | [0.06, 0.33]
    .y.            group1     group2 estimate   conf.low conf.high    p.adj
1 wynik Powtórne czytanie Mapy myśli 2.412186 -0.9286008  5.752974 1.99e-01
2 wynik Powtórne czytanie     Fiszki 7.085389  3.6214631 10.549315 2.33e-05
3 wynik        Mapy myśli     Fiszki 4.673203  0.6843311  8.662074 1.80e-02
  p.adj.signif
1           ns
2         ****
3            *
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = wynik ~ metoda, data = dane)

$metoda
                                 diff       lwr       upr     p adj
Mapy myśli-Powtórne czytanie 2.412186 -1.298733  6.123106 0.2731032
Fiszki-Powtórne czytanie     7.085389  3.584594 10.586184 0.0000171
Fiszki-Mapy myśli            4.673203  1.039295  8.307110 0.0080255


	Kruskal-Wallis rank sum test

data:  wynik by metoda
Kruskal-Wallis chi-squared = 18.457, df = 2, p-value = 9.82e-05
Dwuczynnikowa ANOVA 2 × 2: typ II i III, η²p i efekty proste
R
library(car)          # Anova()
library(emmeans)      # średnie brzegowe i efekty proste
library(effectsize)   # eta_squared()

# Dane symulowane: rodzaj treningu × informacja zwrotna, wynik testu (0–100 pkt)
set.seed(26)
komorki <- data.frame(trening = rep(c("Przykłady rozwiązane", "Samodzielne zadania"), each = 2),
                      informacja = rep(c("Brak", "Natychmiastowa"), times = 2),
                      n = c(26, 22, 30, 24), M = c(64, 66, 55, 71))
dane2 <- do.call(rbind, lapply(1:4, function(i) data.frame(
  trening = komorki$trening[i], informacja = komorki$informacja[i],
  wynik = pmin(pmax(round(rnorm(komorki$n[i], komorki$M[i], 12)), 0), 100))))
dane2$trening <- factor(dane2$trening)
dane2$informacja <- factor(dane2$informacja)

# Kodowanie efektów – warunek poprawnych sum kwadratów typu III
options(contrasts = c("contr.sum", "contr.poly"))
model2 <- lm(wynik ~ trening * informacja, data = dane2)
Anova(model2, type = 2)   # sumy kwadratów typu II
Anova(model2, type = 3)   # typ III (domyślny w SPSS)
eta_squared(Anova(model2, type = 2), partial = TRUE, alternative = "two.sided")

# Efekty proste: informacja zwrotna osobno w każdym rodzaju treningu
emm <- emmeans(model2, ~ informacja | trening)
emm
summary(pairs(emm, reverse = TRUE), infer = TRUE)
eff_size(emm, sigma = sigma(model2), edf = df.residual(model2), method = "revpairwise")
Wynik w R
Anova Table (Type II tests)

Response: wynik
                    Sum Sq Df F value   Pr(>F)
trening              847.3  1  5.2006 0.024746 *
informacja          1313.0  1  8.0593 0.005504 **
trening:informacja  1848.5  1 11.3457 0.001082 **
Residuals          15966.4 98
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Anova Table (Type III tests)

Response: wynik
                   Sum Sq Df   F value    Pr(>F)
(Intercept)        399491  1 2452.0308 < 2.2e-16 ***
trening               616  1    3.7830  0.054642 .
informacja           1140  1    6.9983  0.009504 **
trening:informacja   1848  1   11.3457  0.001082 **
Residuals           15966 98
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type II)

Parameter          | Eta2 (partial) |       95% CI
--------------------------------------------------
trening            |           0.05 | [0.00, 0.16]
informacja         |           0.08 | [0.01, 0.19]
trening:informacja |           0.10 | [0.02, 0.23]
trening = Przykłady rozwiązane:
 informacja     emmean   SE df lower.CL upper.CL
 Brak             66.4 2.50 98     61.4     71.4
 Natychmiastowa   64.5 2.72 98     59.1     69.9

trening = Samodzielne zadania:
 informacja     emmean   SE df lower.CL upper.CL
 Brak             52.9 2.33 98     48.2     57.5
 Natychmiastowa   68.2 2.61 98     63.0     73.3

Confidence level used: 0.95
trening = Przykłady rozwiązane:
 contrast              estimate  SE df lower.CL upper.CL t.ratio p.value
 Natychmiastowa - Brak    -1.84 3.7 98    -9.18      5.5  -0.497  0.6200

trening = Samodzielne zadania:
 contrast              estimate  SE df lower.CL upper.CL t.ratio p.value
 Natychmiastowa - Brak    15.30 3.5 98     8.36     22.2   4.377 <0.0001

Confidence level used: 0.95
trening = Przykłady rozwiązane:
 contrast              effect.size    SE df lower.CL upper.CL
 Natychmiastowa - Brak      -0.144 0.290 98   -0.719    0.431

trening = Samodzielne zadania:
 contrast              effect.size    SE df lower.CL upper.CL
 Natychmiastowa - Brak       1.199 0.287 98    0.629    1.768

sigma used for effect sizes: 12.76
Confidence level used: 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, ggtext i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggtext (wersja 0.1.2): Wilke, C. O., & Wiernik, B. M. (2022). ggtext: Improved text rendering support for ggplot2 [R package]. https://doi.org/10.32614/CRAN.package.ggtext
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Gdy założenia zawodzą: alternatywy dla ANOVA
- Nierówne wariancje – test F Welcha z porównaniami Gamesa–Howella, opisany wyżej; to rozwiązanie wystarcza w większości prac dyplomowych.
- Dane porządkowe, silnie skośne albo bardzo małe grupy – test Kruskala–Wallisa z porównaniami Dunna. Test porównuje rozkłady rang, a nie średnie, dlatego wynik opisuj jako „wyższe” lub „niższe” wyniki, a nie różnicę średnich. W przykładzie 1: χ²(2) = 18.46, p < .001; po korekcie Holma fiszki różnią się od powtórnego czytania (p < .001) i od map myśli (p = .033), a mapy myśli od powtórnego czytania – nie (p = .094).
- Wartości odstające i ciężkie ogony rozkładu – ANOVA na średnich przyciętych (np. funkcja
t1way()z pakietu WRS2), ale dopiero po sprawdzeniu, czy obserwacje odstające nie są po prostu błędami w danych. - Odpowiedzi na pojedyncze pytanie w skali Likerta – rozważ regresję porządkową zamiast traktowania kilku kategorii jak wyniku ilościowego.
- Pomiary powtarzane u tych samych osób – ANOVA z powtarzanymi pomiarami albo, przy danych porządkowych, test Friedmana.
Najczęstsze błędy w ANOVA
- Seria testów t zamiast ANOVA albo porównania par bez korekty – przy trzech grupach ryzyko co najmniej jednego fałszywego alarmu rośnie z .05 do .143.
- Sprawdzanie normalności całej zmiennej zależnej zamiast reszt – przy dużych różnicach między grupami rozkład całej próby bywa wielomodalny, choć reszty w grupach są normalne.
- Wybór testu na podstawie testu Levene’a – procedura dwuetapowa nie chroni poziomu istotności (Zimmerman, 2004); od początku zaplanuj test Welcha.
- Interpretowanie efektów głównych mimo istotnej interakcji albo opisywanie interakcji wyłącznie przez efekty proste (Rosnow i Rosenthal, 1989).
- Wniosek o interakcji z porównania wartości p („w jednej grupie istotne, w drugiej nie”) zamiast testu różnicy różnic.
- Typ III bez kodowania efektów w R i brak informacji o typie sum kwadratów w raporcie.
- Cząstkowe η² podpisane jako η² – w planach czynnikowych to różne miary; zawsze napisz, której użyłeś.
- „Brak różnic” na podstawie nieistotnego wyniku – podaj przedział ufności różnicy i pamiętaj o mocy testu; liczebność grup zaplanuj przed badaniem (zob. dobór liczebności próby).
Najczęstsze pytania
Jakie są założenia ANOVA?
Klasyczna ANOVA zakłada niezależność obserwacji, normalność reszt i równość wariancji w grupach. Najważniejsza jest niezależność – wynika z planu badania i nie da się jej naprawić żadnym testem. Test F jest odporny na umiarkowane odstępstwa od normalności (Blanca i in., 2017), a problem nierównych wariancji rozwiązuje test F Welcha.
Kiedy stosować ANOVA Welcha?
Domyślnie – zawsze, gdy porównujesz średnie trzech lub więcej niezależnych grup, a zwłaszcza przy nierównych liczebnościach. Delacre i in. (2019) rekomendują test Welcha jako domyślny wybór zamiast klasycznego testu F. Nie uzależniaj decyzji od testu Levene’a. W R użyj oneway.test(), a w SPSS zaznacz Welch w opcjach okna One-Way ANOVA.
Jaki test post hoc wybrać po ANOVA?
Przy równych wariancjach – test HSD Tukeya, a gdy wariancje są nierówne albo nie chcesz tego zakładać – test Gamesa–Howella (Sauder i DeMars, 2019). Porównania z jedną grupą kontrolną wykonasz testem Dunnetta, a po teście Kruskala–Wallisa – testem Dunna. Pełne zestawienie znajdziesz w haśle testy post hoc.
Jak opisać wynik ANOVA w stylu APA?
Podaj nazwę testu, F ze stopniami swobody, dokładne p i wielkość efektu z przedziałem ufności, np. F(2, 56.24) = 12.02, p < .001, ω² = .19, 95% CI [.06, .33]. Potem opisz porównania post hoc ze średnimi, odchyleniami standardowymi i d Cohena. Wzory tabel: tabela ANOVA w APA.
Czym się różni typ II od typu III sum kwadratów?
Różnice pojawiają się tylko przy nierównych liczebnościach komórek. Typ II testuje efekt główny po uwzględnieniu drugiego efektu głównego, a typ III – po uwzględnieniu wszystkich efektów, także interakcji (domyślnie w SPSS). Do testowania efektów głównych zaleca się typ II (Langsrud, 2003; Smith i Cribbie, 2014); test interakcji jest w obu typach identyczny.
Co zrobić, gdy interakcja w ANOVA jest istotna?
Opisz efekty proste, czyli wpływ jednego czynnika osobno na każdym poziomie drugiego (w R pakiet emmeans), i pokaż wykres interakcji z przedziałami ufności. Efekty główne traktuj ostrożnie, bo mogą uśredniać efekty o przeciwnych kierunkach (Rosnow i Rosenthal, 1989).
Powiązane hasła
Przeczytaj też
Jak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2017). Non-normal data: Is ANOVA still a valid option? Psicothema, 29(4), 552–557. https://doi.org/10.7334/psicothema2016.383 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Kim, H.-Y. (2014). Statistical notes for clinical researchers: Two-way analysis of variance (ANOVA)-exploring possible interaction between factors. Restorative Dentistry & Endodontics, 39(2), 143–147. https://doi.org/10.5395/rde.2014.39.2.143 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Langsrud, Ø. (2003). ANOVA for unbalanced data: Use Type II instead of Type III sums of squares. Statistics and Computing, 13(2), 163–167. https://doi.org/10.1023/A:1023260610025
- Lee, S., & Lee, D. K. (2018). What is the proper way to apply the multiple comparison test? Korean Journal of Anesthesiology, 71(5), 353–360. https://doi.org/10.4097/kja.d.18.00242 ● Otwarty dostęp
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Smith, C. E., & Cribbie, R. (2014). Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares. Journal of Data Science, 12(3), 385–404. https://doi.org/10.6339/JDS.201407_12(3).0001 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2017nonnormal, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Non-normal data: Is ANOVA still a valid option?}}, journal={Psicothema}, year={2017}, volume={29}, number={4}, pages={552--557}, doi={10.7334/psicothema2016.383}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@article{kim2014twoway, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Two-way analysis of variance (ANOVA)-exploring possible interaction between factors}}, journal={Restorative Dentistry \& Endodontics}, year={2014}, volume={39}, number={2}, pages={143--147}, doi={10.5395/rde.2014.39.2.143}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{langsrud2003anova, author={Langsrud, Øyvind}, title={{ANOVA for unbalanced data: Use Type II instead of Type III sums of squares}}, journal={Statistics and Computing}, year={2003}, volume={13}, number={2}, pages={163--167}, doi={10.1023/a:1023260610025}}@article{lee2018what, author={Lee, Sangseok and Lee, Dong Kyu}, title={{What is the proper way to apply the multiple comparison test?}}, journal={Korean Journal of Anesthesiology}, year={2018}, volume={71}, number={5}, pages={353--360}, doi={10.4097/kja.d.18.00242}}@book{maxwell2018designing, author={Maxwell, Scott E. and Delaney, Harold D. and Kelley, Ken}, title={{Designing experiments and analyzing data: A model comparison perspective}}, year={2018}, edition={3rd}, publisher={Routledge}, doi={10.4324/9781315642956}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@article{rosnow1989definition, author={Rosnow, Ralph L. and Rosenthal, Robert}, title={{Definition and interpretation of interaction effects}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={143--146}, doi={10.1037/0033-2909.105.1.143}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{smith2014factorial, author={Smith, Carrie E. and Cribbie, Robert}, title={{Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares}}, journal={Journal of Data Science}, year={2014}, volume={12}, number={3}, pages={385--404}, doi={10.6339/jds.201407_12(3).0001}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}