Co to jest MANOVA?
MANOVA (ang. multivariate analysis of variance, wielowymiarowa analiza wariancji) to rozszerzenie ANOVA na sytuację, w której grupy porównuje się jednocześnie pod względem kilku zmiennych zależnych (zob. zmienna zależna). Zamiast pytać, czy grupy różnią się średnią jednej zmiennej, MANOVA pyta, czy różnią się wektorem średnich (centroidem) – czyli profilem wyników na wszystkich zmiennych naraz – i uwzględnia przy tym korelacje między tymi zmiennymi.
Polskojęzyczne omówienie modelu, jego założeń i hipotez na tle jednowymiarowej ANOVA przedstawiają Aranowska i Rytel (2010), a przystępny przegląd – od wyboru statystyki testowej po raportowanie – Haase i Ellis (1987). W psychologii MANOVA ma sens przede wszystkim wtedy, gdy zmienne zależne są aspektami jednego konstruktu: na przykład trzema wymiarami wypalenia, kilkoma wskaźnikami lęku albo podskalami jednego kwestionariusza. Huberty i Morris (1989) wśród właściwych powodów analizy wielowymiarowej wymieniają właśnie identyfikację konstruktów leżących u podstaw zestawu zmiennych zależnych.
MANOVA odpowiada więc na pytanie o łączny układ różnic. Jeśli interesuje Cię każda zmienna osobno, lepszym wyborem jest seria jednowymiarowych analiz z korektą na porównania wielokrotne (zob. dlaczego MANOVA nie „chroni” przed błędem I rodzaju). Gdy do modelu dodasz zmienną towarzyszącą, analiza staje się MANCOVA – wielowymiarowym odpowiednikiem ANCOVA.
Statystyki testowe: ślad Pillaia, lambda Wilksa i inne
MANOVA porównuje dwie macierze sum kwadratów i iloczynów: międzygrupową H i wewnątrzgrupową E (wielowymiarowe odpowiedniki wariancji międzygrupowej i wewnątrzgrupowej). Informację o różnicach zawierają wartości własne λ macierzy E−1H – każda odpowiada jednemu kierunkowi, w którym grupy się rozchodzą. Ponieważ wartości własnych jest kilka, istnieje kilka sposobów ich połączenia w jedną statystykę; Aranowska i Rytel (2010) podkreślają, że w MANOVA nie ma jednego ustalonego sprawdzianu.
| Statystyka | Co mierzy | Wynik w przykładzie |
|---|---|---|
| Ślad Pillaia (V) | Suma udziałów wariancji wyjaśnionej na kolejnych wymiarach; domyślna w R | V = 0.34, F(6, 232) = 7.79 |
| Lambda Wilksa (Λ) | Część wariancji niewyjaśniona przez grupy – im mniejsza, tym większe różnice | Λ = .69, F(6, 230) = 7.91 |
| Ślad Hotellinga–Lawleya (T) | Suma wartości własnych | T = 0.42, F(6, 228) = 8.03 |
| Największy pierwiastek Roya (θ) | Tylko najsilniejszy wymiar różnic | θ = 0.32, F(3, 116) = 12.43 |
Przy jednym wymiarze różnic (np. dwie grupy) wszystkie cztery statystyki dają ten sam test. Gdy wymiarów jest więcej, mogą się różnić. Ślad Pillaia uchodzi za najbardziej odporny na naruszenia założeń, dlatego warto podawać go domyślnie, a lambdę Wilksa – gdy wymaga tego tradycja w danej dziedzinie. Wielowymiarową wielkość efektu liczy się jako η²p = V/s, gdzie s to mniejsza z liczb: liczba zmiennych zależnych albo liczba grup minus jeden.
Założenia MANOVA
- Niezależność obserwacji – każda osoba należy do jednej grupy i jest mierzona raz.
- Wielowymiarowa normalność w grupach – sprawdź rozkłady pojedynczych zmiennych i poszukaj wielowymiarowych obserwacji odstających za pomocą odległości Mahalanobisa.
- Jednorodność macierzy kowariancji – wielowymiarowy odpowiednik homogeniczności wariancji, sprawdzany testem M Boxa. Test ten jest bardzo czuły w dużych próbach; przy równych liczebnościach grup MANOVA ze śladem Pillaia dobrze znosi umiarkowane naruszenia.
- Liniowe, umiarkowane związki między zmiennymi zależnymi – zmienne niezwiązane nie tworzą sensownego zestawu, a skorelowane prawie idealnie (np. wynik ogólny skali i jej podskale) powodują współliniowość.
- Wystarczająca liczebność – w każdej grupie wyraźnie więcej osób niż zmiennych zależnych.
Przykład: wypalenie studenckie na trzech kierunkach
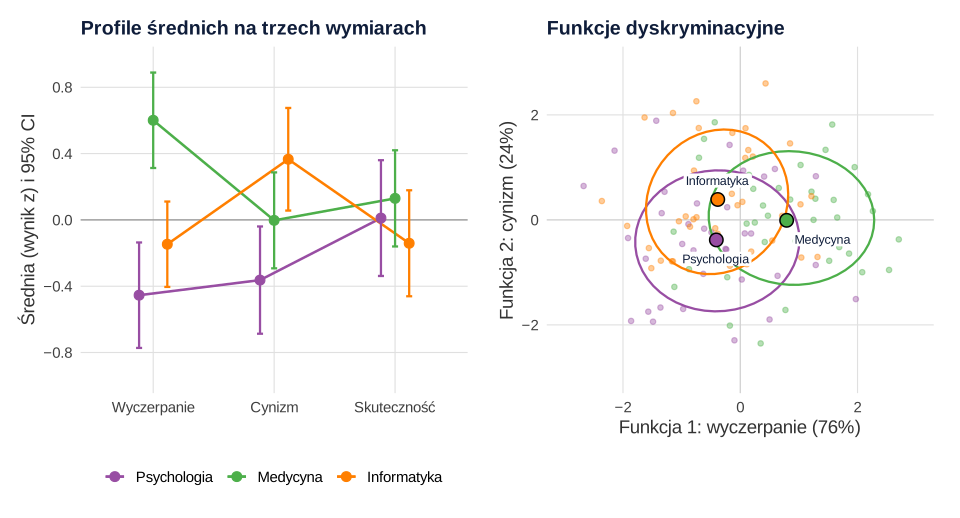
W badaniu (dane symulowane) 120 studentów – po 40 z psychologii, medycyny i informatyki – wypełniło kwestionariusz wypalenia z trzema wymiarami: wyczerpaniem, cynizmem i poczuciem skuteczności akademickiej (skala 0–6). Wymiary były ze sobą powiązane: korelacje wewnątrzgrupowe wyniosły .48 (wyczerpanie–cynizm), −.27 (wyczerpanie–skuteczność) i −.38 (cynizm–skuteczność).
| Kierunek | Wyczerpanie M (SD) | Cynizm M (SD) | Skuteczność M (SD) |
|---|---|---|---|
| Psychologia | 2.77 (1.14) | 1.54 (0.98) | 4.29 (0.92) |
| Medycyna | 3.98 (1.03) | 1.89 (0.88) | 4.38 (0.76) |
| Informatyka | 3.12 (0.92) | 2.25 (0.94) | 4.16 (0.84) |
Założenia. Test M Boxa nie wskazał na różnice macierzy kowariancji, χ²(12) = 8.04, p = .782. Wielowymiarowy test Shapiro-Wilka dla reszt był nieistotny (W = 0.98, p = .189), a największa kwadratowa odległość Mahalanobisa (12.21) nie przekroczyła wartości krytycznej χ²(3) dla α = .001 (16.27).
Wynik MANOVA. Kierunek studiów istotnie różnicował łączny profil wypalenia: ślad Pillaia V = 0.34, F(6, 232) = 7.79, p < .001, η²p = .17, 95% CI [.07, .24]. Lambda Wilksa prowadzi do tego samego wniosku, Λ = .69, F(6, 230) = 7.91, p < .001. To porównanie grup naturalnych (schemat korelacyjny), więc wynik nie mówi, że kierunek studiów powoduje wypalenie – studenci mogli się różnić już przy wyborze kierunku.
Co dalej? Analiza dyskryminacyjna zamiast serii ANOVA
Istotna MANOVA mówi tylko, że centroidy grup się różnią. Warne (2014) wskazuje, że właściwą procedurą następczą jest opisowa analiza dyskryminacyjna (DDA), choć w publikacjach stosuje się ją rzadko. Szuka ona liniowych kombinacji zmiennych zależnych – funkcji dyskryminacyjnych – które najlepiej różnicują grupy (Radkiewicz, 2010; Sherry, 2006). Szczegóły opisuje hasło analiza dyskryminacyjna.
W przykładzie powstały dwie funkcje. Pierwsza odpowiada za 76% różnic międzygrupowych (korelacja kanoniczna .49) i jest związana niemal wyłącznie z wyczerpaniem (współczynnik strukturalny .84; cynizm .01, skuteczność .16). Jej centroidy pokazują, że studenci medycyny różnią się od pozostałych przede wszystkim wyższym wyczerpaniem (0.79 wobec −0.41 i −0.38). Druga funkcja (24%, korelacja kanoniczna .30) jest istotna także samodzielnie, χ²(2) = 11.21, p = .004, i odzwierciedla cynizm (.98): studenci informatyki są bardziej cyniczni niż studenci psychologii (0.39 wobec −0.38). Do interpretacji funkcji używaj współczynników strukturalnych, czyli korelacji zmiennych z funkcją – standaryzowane wagi bywają mylące przy skorelowanych zmiennych.
Jednowymiarowe ANOVA dają zgodny, ale uboższy obraz: wyczerpanie F(2, 117) = 14.43, p < .001, η² = .20; cynizm F(2, 117) = 5.73, p = .004, η² = .09; skuteczność F(2, 117) = 0.73, p = .482, η² = .01. Jeśli je raportujesz, traktuj je jako osobne pytania i zastosuj korektę na porównania wielokrotne, a różnice między konkretnymi kierunkami sprawdzaj testami post hoc.
MANOVA nie „chroni” serii ANOVA przed błędem I rodzaju
W wielu pracach MANOVA służy tylko jako bramka: „jeśli jest istotna, wolno wykonać ANOVA dla każdej zmiennej bez korekty”. Huberty i Morris (1989) kwestionują tę praktykę. Ochrona działa bowiem tylko wtedy, gdy wszystkie hipotezy zerowe są prawdziwe naraz. Wystarczy, że grupy różnią się jedną zmienną: MANOVA staje się istotna i „otwiera bramkę” także dla zmiennych, w których różnic nie ma.
Pokazuje to mała symulacja (5000 powtórzeń; trzy grupy po 40 osób, trzy zmienne zależne skorelowane na poziomie .30). Gdy w populacji nie było żadnych różnic, procedura „MANOVA, potem ANOVA bez korekty” dała co najmniej jeden fałszywie istotny wynik w 3.9% powtórzeń. Gdy jednak różniła się tylko pierwsza zmienna (d = 0.6 między skrajnymi grupami), MANOVA była istotna w 53.0% powtórzeń, a fałszywie istotny wynik dla co najmniej jednej z dwóch pozostałych zmiennych pojawił się w 8.6% powtórzeń – wyraźnie powyżej zakładanych 5% (zob. błąd I rodzaju). Wybieraj więc MANOVA ze względu na pytanie o układ zmiennych, a nie jako zabezpieczenie.
Jak opisać wynik MANOVA w pracy (APA)
Podaj nazwę statystyki testowej, jej wartość, przybliżone F ze stopniami swobody, p i wielkość efektu, a potem wynik analizy następczej. Przykładowy opis:
Jeżeli zamiast analizy dyskryminacyjnej raportujesz jednowymiarowe ANOVA, dodaj informację o korekcie (np. „z korektą Holma”) i podaj η² dla każdej zmiennej. Pełną ścieżkę jednowymiarowej analizy znajdziesz w poradniku ANOVA krok po kroku.
Przykład w R
Kod generuje dane z przykładu, sprawdza równość macierzy kowariancji, wykonuje MANOVA (ślad Pillaia i lambda Wilksa), liczy wielowymiarowe η²p, jednowymiarowe ANOVA i opisową analizę dyskryminacyjną. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
MANOVA z analizą dyskryminacyjną
R
library(MASS); library(heplots); library(effectsize)
options(show.signif.stars = FALSE)
set.seed(267)
n <- 40
R <- matrix(c(1, .50, -.25,  .50, 1, -.45,  -.25, -.45, 1), 3)   # korelacje wymiarów wypalenia
S <- diag(c(1.1, 1.0, 0.9)) %*% R %*% diag(c(1.1, 1.0, 0.9))       # macierz kowariancji
sr <- list(Psychologia = c(3.0, 1.8, 4.2), Medycyna = c(3.8, 1.9, 4.3), Informatyka = c(3.1, 2.5, 3.8))
dane <- do.call(rbind, lapply(names(sr), function(k) {
  x <- pmin(pmax(round(mvrnorm(n, sr[[k]], S), 2), 0), 6)          # skala 0–6
  data.frame(kierunek = k, wyczerpanie = x[, 1], cynizm = x[, 2], skutecznosc = x[, 3])
}))
dane$kierunek <- factor(dane$kierunek, levels = names(sr))
Y <- as.matrix(dane[, c("wyczerpanie", "cynizm", "skutecznosc")])

boxM(Y, dane$kierunek)                          # równość macierzy kowariancji
model <- manova(Y ~ kierunek, data = dane)
summary(model, test = "Pillai")                 # ślad Pillaia
summary(model, test = "Wilks")                  # lambda Wilksa
eta_squared(model, alternative = "two.sided")   # wielowymiarowe cząstkowe eta kwadrat
summary.aov(model)                              # ANOVA dla każdej zmiennej osobno

# Analiza następcza: opisowa analiza dyskryminacyjna
dda <- lda(kierunek ~ wyczerpanie + cynizm + skutecznosc, data = dane)
round(dda$svd^2 / sum(dda$svd^2), 2)            # udział funkcji w różnicach między grupami
wyniki <- predict(dda)$x
reszty <- function(x) resid(lm(x ~ dane$kierunek))
round(cor(apply(Y, 2, reszty), apply(wyniki, 2, reszty)), 2)  # współczynniki strukturalne
Wynik w R
 Box's M-test for Homogeneity of Covariance Matrices

data:  Y by dane$kierunek
Chi-Sq (approx.) = 8.0387, df = 12, p-value = 0.7821

           Df  Pillai approx F num Df den Df    Pr(>F)
kierunek    2 0.33536   7.7898      6    232 1.198e-07
Residuals 117
           Df   Wilks approx F num Df den Df    Pr(>F)
kierunek    2 0.68705   7.9135      6    230 9.148e-08
Residuals 117
# Effect Size for ANOVA (Type I)

Parameter | Eta2 (partial) |       95% CI
-----------------------------------------
kierunek  |           0.17 | [0.07, 0.24]
 Response wyczerpanie :
             Df Sum Sq Mean Sq F value    Pr(>F)
kierunek      2  31.02 15.5101  14.435 2.495e-06
Residuals   117 125.72  1.0745

 Response cynizm :
             Df  Sum Sq Mean Sq F value   Pr(>F)
kierunek      2  10.012  5.0058  5.7344 0.004209
Residuals   117 102.133  0.8729

 Response skutecznosc :
             Df Sum Sq Mean Sq F value Pr(>F)
kierunek      2  1.038 0.51899  0.7336 0.4824
Residuals   117 82.772 0.70745

[1] 0.76 0.24
             LD1   LD2
wyczerpanie 0.84  0.41
cynizm      0.01  0.98
skutecznosc 0.16 -0.20
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (wielowymiarowy test Shapiro-Wilka i odległości Mahalanobisa – w pełnym skrypcie strony); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models [R package]. https://CRAN.R-project.org/package=heplots
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- mvnormtest (wersja 0.1.9.3): Jarek, S. (2024). mvnormtest: Normality test for multivariate variables [R package]. https://doi.org/10.32614/CRAN.package.mvnormtest
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- MANOVA jako „bramka” przed serią ANOVA bez korekty – nie kontroluje błędu I rodzaju, gdy choć jedna zmienna naprawdę różni grupy (Huberty i Morris, 1989).
- Przypadkowy zestaw zmiennych zależnych – do MANOVA wybieraj zmienne, które tworzą sensowną całość teoretyczną, a nie wszystkie zmienne z ankiety.
- Wynik ogólny i podskale w jednym modelu – suma jest liniową kombinacją podskal, więc macierz E staje się osobliwa albo prawie osobliwa.
- Interpretowanie tylko jednowymiarowych testów – pomija to informację o kombinacji zmiennych, dla której MANOVA w ogóle jest wykonywana; uzupełnij analizę o funkcje dyskryminacyjne (Warne, 2014).
- Mechaniczne podejście do testu M Boxa – w dużych próbach wykrywa nieistotne praktycznie różnice, w małych łatwo je przeocza. Patrz też na równoliczność grup i wybieraj ślad Pillaia.
- Wnioski przyczynowe z porównań grup naturalnych – różnice między kierunkami studiów, płciami czy grupami klinicznymi nie mówią, co je wywołało.
Najczęstsze pytania
Co to jest MANOVA?
MANOVA, czyli wielowymiarowa analiza wariancji, porównuje grupy jednocześnie pod względem kilku zmiennych zależnych. Testuje, czy grupy różnią się wektorem średnich (centroidem), i uwzględnia korelacje między zmiennymi. Sprawdza się, gdy zmienne zależne są aspektami jednego konstruktu, np. wymiarami wypalenia.
Czym różni się MANOVA od ANOVA?
ANOVA analizuje jedną zmienną zależną, a MANOVA – kilka naraz, jako zestaw. MANOVA może wykryć różnice w kombinacji zmiennych i daje jeden test zamiast kilku. Nie zastępuje jednak serii ANOVA z korektą, gdy interesuje Cię każda zmienna osobno.
Pillai czy Wilks – którą statystykę MANOVA wybrać?
Domyślnie podawaj ślad Pillaia, bo uchodzi za najbardziej odporny na nierówne liczebności i niejednorodne macierze kowariancji. Lambda Wilksa jest tradycyjnie popularna i zwykle prowadzi do tego samego wniosku. Przy dwóch grupach wszystkie cztery statystyki (Pillai, Wilks, Hotelling–Lawley, Roy) dają identyczny test.
Co zrobić po istotnej MANOVA?
Opisz, na czym polega różnica między grupami. Zalecaną analizą następczą jest opisowa analiza dyskryminacyjna: pokazuje, które kombinacje zmiennych najlepiej różnicują grupy. Jeśli raportujesz jednowymiarowe ANOVA, zastosuj korektę na porównania wielokrotne, bo istotna MANOVA ich nie „chroni”.
Jakie są założenia MANOVA?
Niezależność obserwacji, wielowymiarowa normalność w grupach (bez wielowymiarowych obserwacji odstających, np. według odległości Mahalanobisa), jednorodność macierzy kowariancji (test M Boxa), liniowe i umiarkowane korelacje między zmiennymi zależnymi oraz liczebność grup wyraźnie większa niż liczba zmiennych zależnych.
Jak zrobić MANOVA w SPSS?
Wybierz Analiza → Ogólny model liniowy → Wielu zmiennych. Zmienne zależne wstaw razem do pola zmiennych zależnych, a grupę jako czynnik stały. W Opcjach zaznacz testy jednorodności (test M Boxa i test Levene’a) oraz oceny wielkości efektu. SPSS poda cztery statystyki wielowymiarowe – raportuj ślad Pillaia.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aranowska, E., & Rytel, J. (2010). Wielowymiarowa analiza wariancji – MANOVA. Psychologia Społeczna, 5(2–3), 117–141. https://www.ceeol.com/search/article-detail?id=229288 ● Otwarty dostęp
- Haase, R. F., & Ellis, M. V. (1987). Multivariate analysis of variance. Journal of Counseling Psychology, 34(4), 404–413. https://doi.org/10.1037/0022-0167.34.4.404
- Huberty, C. J., & Morris, J. D. (1989). Multivariate analysis versus multiple univariate analyses. Psychological Bulletin, 105(2), 302–308. https://doi.org/10.1037/0033-2909.105.2.302
- Radkiewicz, P. (2010). Analiza dyskryminacyjna. Podstawowe założenia i zastosowania w badaniach społecznych. Psychologia Społeczna, 5(2–3), 142–161. https://www.ceeol.com/search/article-detail?id=229292 ● Otwarty dostęp
- Sherry, A. (2006). Discriminant analysis in counseling psychology research. The Counseling Psychologist, 34(5), 661–683. https://doi.org/10.1177/0011000006287103
- Warne, R. T. (2014). A primer on multivariate analysis of variance (MANOVA) for behavioral scientists. Practical Assessment, Research, and Evaluation, 19, Article 17. https://doi.org/10.7275/sm63-7h70 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{aranowska2010wielowymiarowa, author={Aranowska, Elżbieta and Rytel, Jolanta}, title={{Wielowymiarowa analiza wariancji – MANOVA}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={117--141}, url={https://www.ceeol.com/search/article-detail?id=229288}}@article{haase1987multivariate, author={Haase, Richard F. and Ellis, Michael V.}, title={{Multivariate analysis of variance}}, journal={Journal of Counseling Psychology}, year={1987}, volume={34}, number={4}, pages={404--413}, doi={10.1037/0022-0167.34.4.404}}@article{huberty1989multivariate, author={Huberty, Carl J. and Morris, John D.}, title={{Multivariate analysis versus multiple univariate analyses}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={2}, pages={302--308}, doi={10.1037/0033-2909.105.2.302}}@article{radkiewicz2010analiza, author={Radkiewicz, Piotr}, title={{Analiza dyskryminacyjna. Podstawowe założenia i zastosowania w badaniach społecznych}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={142--161}, url={https://www.ceeol.com/search/article-detail?id=229292}}@article{sherry2006discriminant, author={Sherry, Alissa}, title={{Discriminant analysis in counseling psychology research}}, journal={The Counseling Psychologist}, year={2006}, volume={34}, number={5}, pages={661--683}, doi={10.1177/0011000006287103}}@article{warne2014primer, author={Warne, Russell T.}, title={{A primer on multivariate analysis of variance (MANOVA) for behavioral scientists}}, journal={Practical Assessment, Research, and Evaluation}, year={2014}, volume={19}, eid={17}, doi={10.7275/sm63-7h70}}