Co to jest ANOVA?
ANOVA (analiza wariancji, ang. analysis of variance) to rodzina testów statystycznych, które porównują średnie w trzech lub więcej grupach albo w planach z kilkoma czynnikami. Podstawą testu jest statystyka F – stosunek zmienności między grupami do zmienności wewnątrz grup. Hipoteza zerowa mówi, że wszystkie średnie w populacji są równe, a alternatywna – że co najmniej jedna średnia różni się od pozostałych. W psychologii ANOVA służy zwykle do analizy eksperymentów z kilkoma warunkami oraz do porównań grup, np. osób z różnym wykształceniem.
Mishra i in. (2019) porządkują zastosowania tak: test t porównuje dwie średnie, a ANOVA – trzy lub więcej. Istotny wynik ogólny ANOVA oznacza, że różni się co najmniej jedna para średnich, więc trzeba go uzupełnić porównaniami wielokrotnymi. ANOVA z jednym czynnikiem to analiza jednoczynnikowa, z dwoma – dwuczynnikowa, a po dodaniu zmiennej towarzyszącej (kowariantu) – ANCOVA.
Dlaczego nie porównać grup serią testów t? Kim (2014) przypomina, że przy kilku porównaniach łączny błąd I rodzaju rośnie – do 1 − 0.95k przy k niezależnych porównaniach na poziomie α = .05. Dla trzech grup (trzy pary) to już .143, a dla czterech grup (sześć par) – .265. ANOVA najpierw testuje jedną hipotezę ogólną, a pary sprawdza się dopiero w testach post hoc z kontrolą tego błędu (zob. korekta Bonferroniego).
Logika ANOVA: stosunek dwóch wariancji
Całkowite zróżnicowanie wyników (sumę kwadratów odchyleń od średniej ogólnej) dzielimy na dwie części:
- Mj, nj – średnia i liczebność grupy j; M – średnia ogólna; xij – wynik osoby i w grupie j,
- SSmiędzy – suma kwadratów między grupami, z której liczy się wariancję międzygrupową,
- SSwewn – suma kwadratów wewnątrz grup, podstawa wariancji wewnątrzgrupowej (błędu),
- MS – średni kwadrat, czyli suma kwadratów podzielona przez stopnie swobody: k − 1 dla efektu i N − k dla błędu (k – liczba grup, N – liczba osób).
Gdy hipoteza zerowa jest prawdziwa, oba średnie kwadraty szacują tę samą wariancję błędu, więc F oscyluje wokół 1. Różnice między średnimi grup zwiększają licznik i F rośnie. Wartość p to prawdopodobieństwo uzyskania tak dużego lub większego F, gdyby H0 była prawdziwa – odczytujemy ją z rozkładu F o (k − 1, N − k) stopniach swobody. ANOVA jest szczególnym przypadkiem modelu liniowego: porównuje model z osobnymi średnimi grup z modelem z jedną wspólną średnią. Takie ujęcie porównywania modeli rozwijają Maxwell i in. (2018).
Przykład krok po kroku
Piętnaście osób oceniało listę słów na trzy sposoby (po pięć osób w warunku): pod względem wyglądu (czy słowo jest pisane wielkimi literami), brzmienia (czy rymuje się z podanym słowem) albo znaczenia (czy pasuje do zdania). Potem niespodziewanie poproszono je o odtworzenie słów. Wyniki (liczba odtworzonych słów, dane symulowane):
- wygląd: 6, 4, 5, 4, 6 – M = 5, SD = 1.00,
- brzmienie: 10, 4, 7, 8, 6 – M = 7, SD = 2.24,
- znaczenie: 8, 9, 8, 11, 9 – M = 9, SD = 1.22.
Średnia ogólna wynosi 7. Obliczenia:
- Suma kwadratów między grupami: SSmiędzy = 5 × (5 − 7)² + 5 × (7 − 7)² + 5 × (9 − 7)² = 20 + 0 + 20 = 40.
- Suma kwadratów wewnątrz grup: suma kwadratów odchyleń osób od średnich ich grup wynosi 4 + 20 + 6 = 30.
- Stopnie swobody: 3 − 1 = 2 dla efektu i 15 − 3 = 12 dla błędu.
- Średnie kwadraty: MSmiędzy = 40 / 2 = 20; MSwewn = 30 / 12 = 2.5.
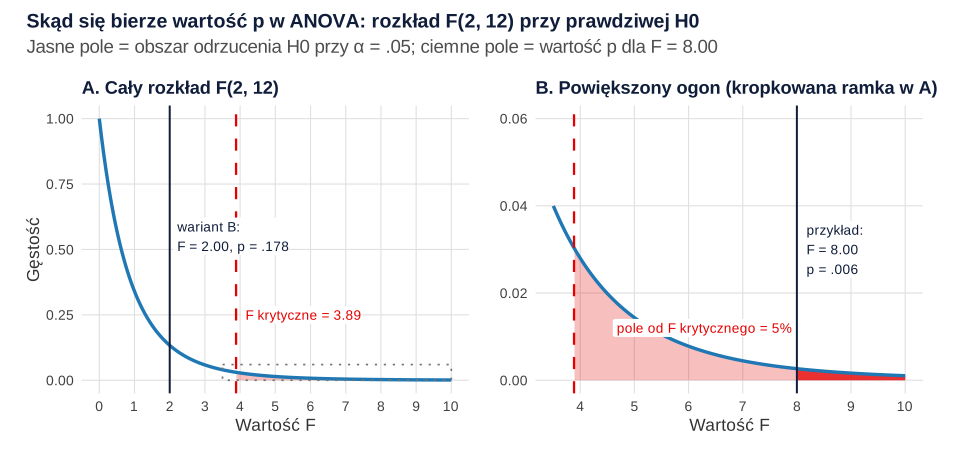
- Statystyka F: F = 20 / 2.5 = 8.00. Wartość krytyczna F(2, 12) dla α = .05 wynosi 3.89, a p = .006.
- Wielkość efektu: η² = 40 / 70 = .57, 95% CI [.10, .77]. W tak małej próbie η² jest wyraźnie zawyżone – mniej obciążona miara ω² wynosi .48.
| Źródło zmienności | SS | df | MS | F | p |
|---|---|---|---|---|---|
| Między grupami | 40 | 2 | 20.0 | 8.00 | .006 |
| Wewnątrz grup (błąd) | 30 | 12 | 2.5 | ||
| Ogółem | 70 | 14 |
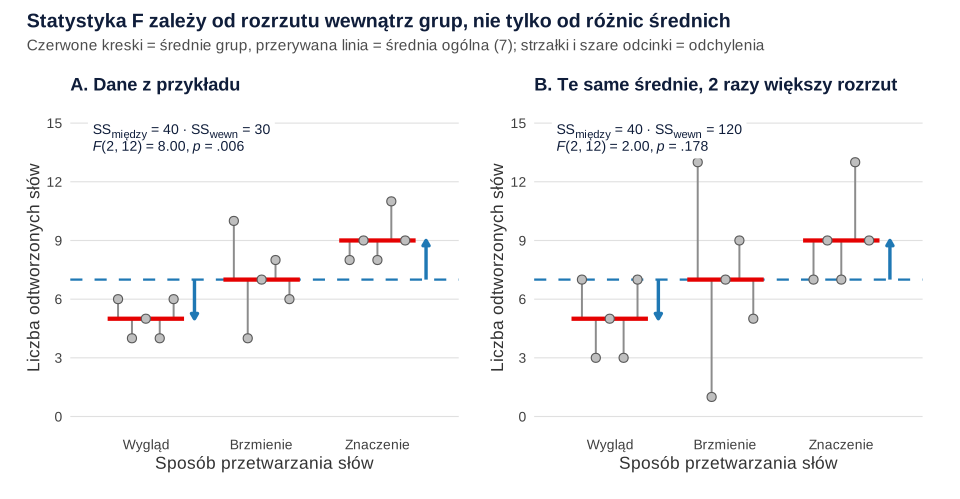
Rysunek 1 pokazuje sedno ANOVA: o istotności decyduje nie sama różnica średnich, tylko jej stosunek do rozrzutu wyników wewnątrz grup. Te same średnie 5, 7 i 9 przy dwa razy większym rozrzucie dają F(2, 12) = 2.00 i p = .178. Rysunek 2 pokazuje, skąd pochodzą wartości p: to pole pod krzywą rozkładu F na prawo od uzyskanej wartości.
Istotne F nie mówi, które grupy się różnią. Test HSD Tukeya wskazał tylko jedną istotną różnicę: osoby oceniające znaczenie odtworzyły średnio o 4 słowa więcej niż osoby oceniające wygląd, 95% CI [1.33, 6.67], p = .005. Dwie pozostałe różnice (po 2 słowa) nie były istotne, p = .155.
Rodzaje ANOVA
| Odmiana | Kiedy | Więcej |
|---|---|---|
| Jednoczynnikowa | Jeden czynnik międzyobiektowy, trzy grupy lub więcej | ANOVA krok po kroku |
| Dwuczynnikowa (czynnikowa) | Dwa czynniki lub więcej: efekty główne i interakcja | ten sam poradnik (przykład 2) |
| Z powtarzanymi pomiarami | Te same osoby w kilku warunkach lub pomiarach | ANOVA z powtarzanymi pomiarami |
| ANCOVA | Porównanie grup z kontrolą kowariantu, np. pretestu | ANCOVA |
| MANOVA | Kilka zmiennych zależnych analizowanych łącznie | MANOVA |
| ANOVA Welcha | Nierówne wariancje i liczebności grup | test Welcha |
| Test Kruskala–Wallisa | Nieparametryczna alternatywa dla jednoczynnikowej ANOVA | test Kruskala–Wallisa |
Osobną kwestią jest rodzaj czynnika. Zwykle czynniki są stałe – interesują nas dokładnie te poziomy, które zbadaliśmy (np. trzy konkretne metody uczenia się). Czynnik jest losowy, gdy jego poziomy to próbka z szerszej populacji, np. bodźce, terapeuci czy szkoły. Grzeszkiewicz-Radulska (2023) w polskiej monografii pokazuje, kiedy pytanie badawcze wymaga uwzględnienia czynnika losowego i że błędnie dobrany schemat analizy obniża trafność wniosków i prowadzi do ustaleń fałszywie pozytywnych. Takie dane analizuje się dziś zwykle w modelach wielopoziomowych.
Założenia ANOVA w skrócie
- Niezależność obserwacji – wynika z planu badania; przy pomiarach powtarzanych użyj odpowiedniej odmiany ANOVA.
- Normalność reszt – oceniaj ją na wykresie kwantylowym (Q-Q) reszt, a nie zmiennej zależnej w całej próbie. Test F jest odporny na typowe odstępstwa: Blanca i in. (2017) w symulacji z trzema grupami pokazali, że zachował poprawny poziom błędu I rodzaju we wszystkich warunkach z rozkładami typowymi dla nauk społecznych i nauk o zdrowiu.
- Jednorodność wariancji – ważna zwłaszcza przy nierównych liczebnościach. Delacre i in. (2019) zalecają domyślne stosowanie testu F Welcha, który tego założenia nie wymaga. Nie uzależniaj wyboru testu od wyniku testu Levene’a.
W naszym przykładzie test F Welcha daje F(2, 7.48) = 14.76, p = .003, więc wniosek się nie zmienia. Przy pięciu osobach w grupie testy założeń mają bardzo małą moc, dlatego ważniejsze od nich są plan badania i wykresy. Jak sprawdzić założenia na prawdziwych danych, pokazujemy w poradniku ANOVA krok po kroku.
Jak opisać wynik ANOVA (APA)
Podaj statystykę F z dwiema liczbami stopni swobody, dokładną wartość p, wielkość efektu z przedziałem ufności oraz wyniki porównań post hoc ze średnimi i odchyleniami standardowymi:
Jeśli zgodnie z planem analizy raportujesz test Welcha, w miejsce klasycznego wyniku wpisz F(2, 7.48) = 14.76, p = .003 – ułamkowe stopnie swobody podaj z dwoma miejscami po przecinku. Wzór tabeli znajdziesz w haśle tabela ANOVA w APA.
ANOVA w R
Kod liczy sumy kwadratów i statystykę F „ręcznie”, a potem to samo funkcją aov(), wraz z η², testem Welcha i porównaniami Tukeya. Liczby w haśle i na rysunkach pochodzą z tych obliczeń.
Jednoczynnikowa ANOVA od podstaw
R
library(effectsize)   # eta_squared()

# Dane symulowane: liczba odtworzonych słów (z 15) po trzech sposobach przetwarzania, po 5 osób
set.seed(2533)
slowa <- unlist(lapply(c(5, 7, 9), function(m) round(rnorm(5, m, 1.7))))
warunek <- factor(rep(c("Wygląd", "Brzmienie", "Znaczenie"), each = 5),
                  levels = c("Wygląd", "Brzmienie", "Znaczenie"))
dane <- data.frame(warunek, slowa)
tapply(dane$slowa, dane$warunek, mean)   # średnie grup

# Sumy kwadratów i F „ręcznie”
M_ogolna  <- mean(dane$slowa)
SS_miedzy <- sum(5 * (tapply(dane$slowa, dane$warunek, mean) - M_ogolna)^2)
SS_wewn   <- sum((dane$slowa - ave(dane$slowa, dane$warunek))^2)
F_obs     <- (SS_miedzy / 2) / (SS_wewn / 12)
c(SS_miedzy = SS_miedzy, SS_wewn = SS_wewn, F = F_obs, p = pf(F_obs, 2, 12, lower.tail = FALSE))

# To samo funkcją aov(), wielkość efektu, wariant Welcha i post hoc Tukeya
model <- aov(slowa ~ warunek, data = dane)
summary(model)
eta_squared(model, partial = FALSE, alternative = "two.sided")
oneway.test(slowa ~ warunek, data = dane)
TukeyHSD(model)
Wynik w R
   Wygląd Brzmienie Znaczenie
        5         7         9
   SS_miedzy      SS_wewn            F            p
40.000000000 30.000000000  8.000000000  0.006196398
            Df Sum Sq Mean Sq F value Pr(>F)
warunek      2     40    20.0       8 0.0062 **
Residuals   12     30     2.5
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter | Eta2 |       95% CI
-------------------------------
warunek   | 0.57 | [0.10, 0.77]

	One-way analysis of means (not assuming equal variances)

data:  slowa and warunek
F = 14.756, num df = 2.00, denom df = 7.48, p-value = 0.002533

  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = slowa ~ warunek, data = dane)

$warunek
                    diff        lwr      upr     p adj
Brzmienie-Wygląd       2 -0.6678637 4.667864 0.1545800
Znaczenie-Wygląd       4  1.3321363 6.667864 0.0046341
Znaczenie-Brzmienie    2 -0.6678637 4.667864 0.1545800
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2, ggtext i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Uznanie istotnego F za dowód, że wszystkie grupy się różnią – istotny wynik mówi tylko, że różni się co najmniej jedna para; które, pokażą testy post hoc.
- Seria testów t bez korekty – przy czterech grupach i sześciu porównaniach ryzyko co najmniej jednego fałszywego alarmu sięga .265.
- Zwykła ANOVA dla pomiarów powtarzanych – wyniki tych samych osób nie są niezależne; potrzebna jest ANOVA z powtarzanymi pomiarami albo model mieszany.
- Sprawdzanie normalności zmiennej zależnej w całej próbie zamiast reszt modelu.
- Brak wielkości efektu – samo p nie mówi, jak duży jest efekt; podaj η² lub ω² z przedziałem ufności.
- Opis efektów głównych mimo istotnej interakcji w ANOVA dwuczynnikowej – najpierw zinterpretuj interakcję i efekty proste.
Najczęstsze pytania
Co to jest ANOVA w statystyce?
ANOVA (analiza wariancji) to test porównujący średnie trzech lub więcej grup. Dzieli zmienność wyników na część między grupami i część wewnątrz grup, a ich stosunek – statystyka F – pokazuje, czy różnice średnich są większe, niż wynikałoby z przypadkowego rozrzutu wyników.
Kiedy stosować ANOVA, a kiedy test t?
Test t porównuje dwie średnie, a ANOVA – trzy lub więcej (Mishra i in., 2019). Seria testów t dla kilku grup zawyża łączny błąd I rodzaju: przy trzech porównaniach do .143 (Kim, 2014). Przy dwóch grupach oba podejścia dają ten sam wynik, bo F = t².
Co oznacza wynik F w ANOVA?
F to stosunek średniego kwadratu między grupami do średniego kwadratu wewnątrz grup. Wartość bliska 1 oznacza, że średnie różnią się tyle, ile można oczekiwać przy prawdziwej H0, a duże F (z małym p) – że co najmniej jedna średnia odstaje. W przykładzie z tego hasła F(2, 12) = 8.00, p = .006.
Co zrobić po istotnym wyniku ANOVA?
Sprawdź, które grupy się różnią, testami post hoc: Tukeya przy równych wariancjach albo Gamesa–Howella przy nierównych (zob. testy post hoc). Podaj też wielkość efektu, np. η² lub ω² z przedziałem ufności, i opisz kierunek różnic na podstawie średnich.
Jakie są założenia ANOVA?
Niezależność obserwacji, normalność reszt i równość wariancji w grupach. Test F jest odporny na umiarkowane odstępstwa od normalności (Blanca i in., 2017), a przy nierównych wariancjach lepiej od razu użyć testu F Welcha (Delacre i in., 2019).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2017). Non-normal data: Is ANOVA still a valid option? Psicothema, 29(4), 552–557. https://doi.org/10.7334/psicothema2016.383 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Grzeszkiewicz-Radulska, K. (2023). Wprowadzenie do analizy wariancji z czynnikami losowymi. Wydawnictwo Uniwersytetu Łódzkiego. https://doi.org/10.18778/8331-176-0 ● Otwarty dostęp: pełny tekst
- Kim, H.-Y. (2014). Analysis of variance (ANOVA) comparing means of more than two groups. Restorative Dentistry & Endodontics, 39(1), 74–77. https://doi.org/10.5395/rde.2014.39.1.74 ● Otwarty dostęp
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Mishra, P., Singh, U., Pandey, C. M., Mishra, P., & Pandey, G. (2019). Application of Student's t-test, analysis of variance, and covariance. Annals of Cardiac Anaesthesia, 22(4), 407–411. https://doi.org/10.4103/aca.ACA_94_19 ● Otwarty dostęp
Cytowania BibTeX
@article{blanca2017nonnormal, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Non-normal data: Is ANOVA still a valid option?}}, journal={Psicothema}, year={2017}, volume={29}, number={4}, pages={552--557}, doi={10.7334/psicothema2016.383}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@book{grzeszkiewicz2023wprowadzenie, author={Grzeszkiewicz-Radulska, Katarzyna}, title={{Wprowadzenie do analizy wariancji z czynnikami losowymi}}, year={2023}, publisher={Wydawnictwo Uniwersytetu Łódzkiego}, doi={10.18778/8331-176-0}}@article{kim2014analysis, author={Kim, Hae-Young}, title={{Analysis of variance (ANOVA) comparing means of more than two groups}}, journal={Restorative Dentistry \& Endodontics}, year={2014}, volume={39}, number={1}, pages={74--77}, doi={10.5395/rde.2014.39.1.74}}@book{maxwell2018designing, author={Maxwell, Scott E. and Delaney, Harold D. and Kelley, Ken}, title={{Designing experiments and analyzing data: A model comparison perspective}}, year={2018}, edition={3rd}, publisher={Routledge}, doi={10.4324/9781315642956}}@article{mishra2019application, author={Mishra, Prabhaker and Singh, Uttam and Pandey, Chandra M. and Mishra, Priyadarshni and Pandey, Gaurav}, title={{Application of Student's t-test, analysis of variance, and covariance}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={4}, pages={407--411}, doi={10.4103/aca.aca_94_19}}