Co to jest ANCOVA?
ANCOVA (ang. analysis of covariance, analiza kowariancji) to analiza wariancji, w której średnie grup porównuje się po statystycznym uwzględnieniu zmiennej ilościowej zmierzonej przed badaniem – kowariantu, nazywanego też zmienną towarzyszącą. W praktyce to połączenie analizy wariancji (ANOVA) i regresji liniowej: model zawiera czynnik grupujący (zmienną niezależną) oraz kowariant, a zmienną zależną jest wynik końcowy.
Typowe zastosowanie w psychologii to badanie z pomiarem przed interwencją i po niej: porównujesz poziom lęku po terapii w kilku grupach, a jako kowariant wprowadzasz lęk zmierzony przed terapią. ANCOVA pełni wtedy dwie funkcje:
- zwiększa precyzję – zmienność wyniku końcowego, którą wyjaśnia pomiar wyjściowy, zostaje usunięta z wariancji błędu, więc test efektu grupy ma większą moc;
- koryguje przypadkowe różnice wyjściowe – nawet przy losowym przydziale grupy rzadko startują z identycznego poziomu, a ANCOVA porównuje je tak, jakby wszystkie miały ten sam wynik w pre-teście.
Kowariant to szczególny rodzaj zmiennej kontrolnej. Ważne zastrzeżenie: ANCOVA nie zamienia badania korelacyjnego w eksperyment. Najlepiej działa w eksperymencie z losowym przydziałem do grup; przy porównywaniu grup naturalnych łatwo o błędne wnioski (zob. ANCOVA w grupach nierandomizowanych).
Model ANCOVA i średnie skorygowane
Jednoczynnikową ANCOVA z jednym kowariantem zapisuje się jako:
- Yij – wynik końcowy osoby i w grupie j, a Xij – jej wynik w kowariancie (np. w pre-teście);
- μ – średnia ogólna, αj – efekt grupy j, εij – błąd;
- β (w próbie b) – wspólne dla wszystkich grup nachylenie regresji wyniku końcowego na kowariant;
- MX – średnia kowariantu w całej próbie.
Z modelu wynika średnia skorygowana (ang. adjusted mean, w SPSS „szacowana średnia brzegowa”) – wynik, jakiego model oczekuje w grupie j przy średnim poziomie kowariantu:
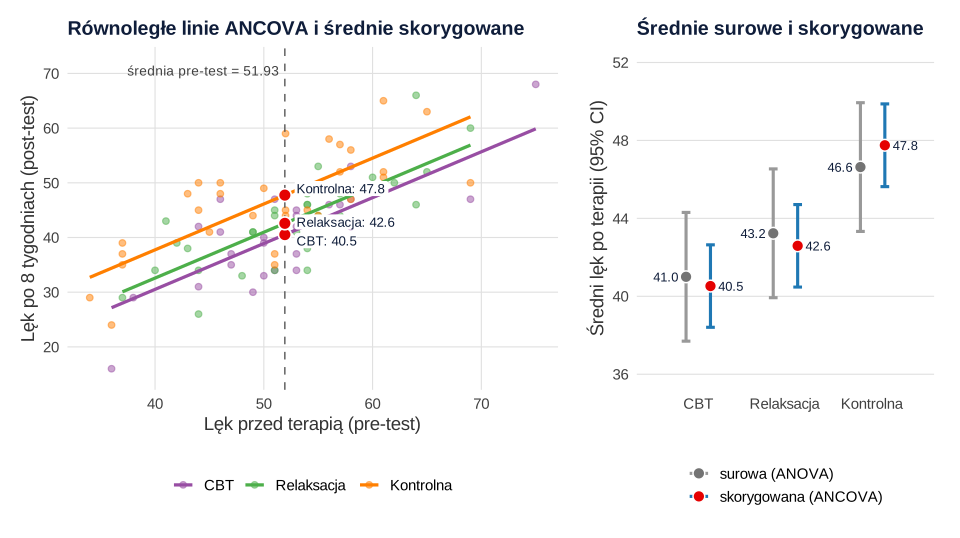
Jeśli grupa zaczynała powyżej średniej (MX,j > MX), jej średnia zostaje obniżona; jeśli poniżej – podwyższona. Geometrycznie ANCOVA dopasowuje w każdej grupie linię regresji o tym samym nachyleniu, a efekt grupy to pionowe odległości między tymi równoległymi liniami (rysunek 1).
Zysk na precyzji łatwo oszacować: wariancja błędu w ANCOVA wynosi w przybliżeniu tyle co w ANOVA pomnożone przez (1 − r²), gdzie r to korelacja kowariantu z wynikiem wewnątrz grup. Przy r = .70 wariancja błędu spada mniej więcej o połowę.
Założenia ANCOVA
- Liniowy związek kowariantu z wynikiem w każdej grupie – sprawdź go na wykresie rozrzutu.
- Jednorodność nachyleń regresji – linie mają to samo nachylenie we wszystkich grupach. Sprawdzisz to, dodając do modelu interakcję kowariant × grupa. Istotna interakcja oznacza, że efekt grupy zależy od poziomu kowariantu – to moderacja, którą trzeba opisać, a nie „wyrównywać”.
- Kowariant niezależny od interwencji – zmierzony przed nią, tak by sama interwencja nie mogła go zmienić.
- Rzetelny pomiar kowariantu – w badaniu randomizowanym błąd pomiaru zmniejsza tylko zysk na mocy, ale przy grupach nierandomizowanych prowadzi do niepełnej korekty.
- Założenia dotyczące reszt, jak w ANOVA: normalność rozkładu (np. test Shapiro-Wilka), homogeniczność wariancji (np. test Levene’a) i niezależność obserwacji.
Przykład: lęk po terapii w trzech grupach
W badaniu (dane symulowane) 90 osób z podwyższonym lękiem przydzielono losowo do trzech grup po 30 osób: terapii poznawczo-behawioralnej (CBT), treningu relaksacyjnego i grupy kontrolnej (lista oczekujących). Lęk mierzono skalą 0–80 przed rozpoczęciem i po 8 tygodniach. Mimo losowania grupa kontrolna zaczynała z poziomu lęku niższego o około 2 punkty.
| Grupa | Pre-test M (SD) | Post-test M (SD) | Średnia skorygowana [95% CI] |
|---|---|---|---|
| CBT | 52.50 (7.95) | 41.00 (9.09) | 40.52 [38.41, 42.64] |
| Relaksacja | 52.70 (8.06) | 43.23 (8.74) | 42.59 [40.47, 44.71] |
| Kontrolna | 50.60 (9.08) | 46.63 (9.47) | 47.75 [45.63, 49.88] |
Krok 1. Jednorodność nachyleń. Interakcja pre-test × grupa była nieistotna, F(2, 84) = 0.41, p = .663 (nachylenia w grupach: 0.92, 0.86 i 0.76), więc wspólne nachylenie jest uzasadnione. Reszty modelu nie odbiegały istotnie od rozkładu normalnego (W = 0.99, p = .610), a ich wariancje w grupach były zbliżone, F(2, 87) = 1.61, p = .205.
Krok 2. ANCOVA. Lęk wyjściowy silnie przewidywał lęk po 8 tygodniach, F(1, 86) = 126.57, p < .001, b = 0.84. Po jego uwzględnieniu efekt grupy był istotny, F(2, 86) = 12.11, p < .001, η²p = .22, 95% CI [.08, .36]. Dla porównania zwykła ANOVA na samych wynikach końcowych dała F(2, 87) = 2.91, p = .060, η² = .06. Różnica bierze się z wariancji błędu: kowariant zmniejszył ją z 82.92 do 33.94, czyli o 59.1%.
Krok 3. Średnie skorygowane i porównania. Dla grupy kontrolnej średnia skorygowana wynosi 46.63 − 0.84 × (50.60 − 51.93) = 47.75: grupa zaczynała niżej, więc jej średnia rośnie. Średnie grup CBT i relaksacji nieco maleją. Porównania parami z korektą Holma (zob. porównania wielokrotne) wykazały niższy lęk po CBT niż w grupie kontrolnej (różnica = −7.23, SE = 1.51, p < .001, 95% CI [−10.23, −4.22]) oraz po relaksacji niż w grupie kontrolnej (różnica = −5.16, p = .002). Grupy CBT i relaksacji nie różniły się istotnie (różnica = −2.07, p = .173).
ANCOVA, analiza zmian czy sam post-test?
W badaniu z pomiarem przed interwencją i po niej efekt można oszacować na trzy sposoby: porównać same wyniki końcowe, porównać wskaźniki zmiany (post − pre) albo wykonać ANCOVA. Vickers i Altman (2001) wskazują, że to, które z dwóch prostszych podejść daje większą moc, zależy od korelacji między pomiarem wyjściowym a końcowym. ANCOVA nie wymaga tego wyboru, bo wagę pre-testu (nachylenie b) szacuje z danych. Analiza zmian zakłada natomiast, że to nachylenie wynosi 1.
| Analiza | Różnica CBT − kontrolna | SE | 95% CI |
|---|---|---|---|
| ANOVA wyników końcowych | −5.63 | 2.35 | [−10.31, −0.96] |
| ANOVA wskaźników zmiany | −7.53 | 1.54 | [−10.59, −4.48] |
| ANCOVA z pre-testem | −7.23 | 1.51 | [−10.23, −4.22] |
Wszystkie trzy analizy wskazują na niższy lęk po CBT, ale przedział ufności dla samych wyników końcowych jest o ponad połowę szerszy niż w ANCOVA, a jego oszacowanie jest zaniżone przez niższy start grupy kontrolnej. Badania metodologiczne potwierdzają tę przewagę: w badaniach randomizowanych zarówno ANCOVA, jak i analiza zmian są nieobciążone, ale ANCOVA ma większą moc (Van Breukelen, 2006), a przy nierównowadze wyjściowej daje nieobciążone i bardziej precyzyjne oszacowania niż obie prostsze metody (Egbewale i in., 2014). W badaniu randomizowanym z pre-testem domyślnym wyborem jest ANCOVA – zaplanowana przed zebraniem danych.
ANCOVA w grupach nierandomizowanych
Częsty błąd to używanie ANCOVA do „wyrównania” grup, które naprawdę różnią się kowariantem – na przykład porównywanie pamięci u osób z depresją i bez niej „z kontrolą lęku”. Miller i Chapman (2001) wyjaśniają, że takie użycie ANCOVA, częste zwłaszcza w badaniach psychopatologii, zwykle nie pozwala osiągnąć zamierzonego celu, i omawiają rozwiązania alternatywne. Jeśli lęk jest częścią obrazu depresji, usunięcie związanej z nim wariancji usuwa też część tego, co różni grupy. Wynik opisuje wtedy hipotetyczne grupy o jednakowym lęku, których w populacji nie ma.
Drugi problem opisuje Van Breukelen (2006): gdy grupy bez losowego przydziału różnią się na starcie, ANCOVA i analiza zmian mogą prowadzić do sprzecznych wniosków, bo ANCOVA zakłada brak różnic wyjściowych (tzw. paradoks Lorda). W schemacie quasi-eksperymentalnym nie traktuj więc wyniku ANCOVA jako dowodu przyczynowego i opisz możliwe zmienne zakłócające. Plany takich badań i zagrożenia dla wnioskowania omawia klasyczny podręcznik Shadisha, Cooka i Campbella (2002).
Jak opisać wynik ANCOVA w pracy (APA)
Podaj test jednorodności nachyleń, efekt kowariantu, efekt grupy z η²p oraz średnie skorygowane z przedziałami ufności. Przykładowy opis wyniku z naszego badania:
Wyniki możesz też zestawić w tabeli – w układzie znanym z tabeli ANOVA w APA:
Tabela 1
Analiza kowariancji lęku po 8 tygodniach z lękiem przed interwencją jako kowariantem
| Źródło zmienności | SS | df | F | p | η2p |
|---|---|---|---|---|---|
| Lęk przed interwencją (kowariant) | 4295.64 | 1 | 126.57 | < .001 | .60 |
| Grupa | 821.83 | 2 | 12.11 | < .001 | .22 |
| Błąd | 2918.69 | 86 |
Uwaga. N = 90. Sumy kwadratów typu II (w modelu bez interakcji takie same jak typu III). Średnie skorygowane dla lęku wyjściowego 51.93: CBT = 40.52, relaksacja = 42.59, grupa kontrolna = 47.75. η2p = cząstkowe eta kwadrat.
Pamiętaj, że η²p z ANCOVA odnosi się do wariancji pomniejszonej o wpływ kowariantu, więc jest większe niż η² z ANOVA dla tych samych danych (.22 wobec .06). Więcej gotowych zdań znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod odtwarza dane z przykładu, sprawdza jednorodność nachyleń, wykonuje ANCOVA i liczy średnie skorygowane z porównaniami parami. Liczby w tekście, tabeli i na rysunku 1 pochodzą z tego kodu.
ANCOVA z pre-testem jako kowariantem
R
library(car); library(emmeans); library(effectsize)
set.seed(194)
n <- 30
grupa <- factor(rep(c("CBT", "Relaksacja", "Kontrolna"), each = n),
                levels = c("CBT", "Relaksacja", "Kontrolna"))
pre  <- round(rnorm(3 * n, mean = 52, sd = 8))                # lęk przed terapią (0–80)
efekt <- c(CBT = -5, Relaksacja = -2.5, Kontrolna = 0)[as.character(grupa)]
post <- round(10 + 0.7 * pre + efekt + rnorm(3 * n, 0, 6))    # lęk po 8 tygodniach
dane <- data.frame(grupa, pre, post)

# 1. Jednorodność nachyleń: czy interakcja pre × grupa jest istotna?
anova(lm(post ~ pre * grupa, data = dane))

# 2. ANCOVA: post-test w grupach z kontrolą pre-testu
model <- lm(post ~ pre + grupa, data = dane)
Anova(model, type = 2)          # w modelu bez interakcji typ II = typ III (SPSS)
eta_squared(Anova(model, type = 2), partial = TRUE, alternative = "two.sided")

# 3. Średnie skorygowane (dla pre = 51.93) i porównania parami z korektą Holma
emm <- emmeans(model, ~ grupa)
emm
pairs(emm, adjust = "holm")
Wynik w R
Analysis of Variance Table

Response: post
          Df Sum Sq Mean Sq  F value    Pr(>F)
pre        1 3956.6  3956.6 114.9910 < 2.2e-16 ***
grupa      2  821.8   410.9  11.9424 2.725e-05 ***
pre:grupa  2   28.4    14.2   0.4128    0.6631
Residuals 84 2890.3    34.4
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Anova Table (Type II tests)

Response: post
          Sum Sq Df F value    Pr(>F)
pre       4295.6  1 126.572 < 2.2e-16 ***
grupa      821.8  2  12.108 2.328e-05 ***
Residuals 2918.7 86
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type II)

Parameter | Eta2 (partial) |       95% CI
-----------------------------------------
pre       |           0.60 | [0.47, 0.69]
grupa     |           0.22 | [0.08, 0.36]
 grupa      emmean   SE df lower.CL upper.CL
 CBT          40.5 1.06 86     38.4     42.6
 Relaksacja   42.6 1.07 86     40.5     44.7
 Kontrolna    47.8 1.07 86     45.6     49.9

Confidence level used: 0.95
 contrast               estimate   SE df t.ratio p.value
 CBT - Relaksacja          -2.07 1.50 86  -1.373  0.1733
 CBT - Kontrolna           -7.23 1.51 86  -4.783 <0.0001
 Relaksacja - Kontrolna    -5.16 1.51 86  -3.413  0.0020

P value adjustment: holm method for 3 tests
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Kowariant zmierzony po interwencji – jeśli interwencja mogła go zmienić, ANCOVA usuwa część efektu, który chcesz zbadać.
- „Wyrównywanie” grup naturalnych – ANCOVA nie usuwa różnic między grupami, które istnieją w populacji (Miller i Chapman, 2001).
- Pominięcie testu jednorodności nachyleń – przy istotnej interakcji kowariant × grupa różnica między grupami zależy od poziomu kowariantu; opisz wtedy interakcję zamiast jednej średniej skorygowanej.
- Dobieranie kowariantów po obejrzeniu wyników – sprawdzanie kolejnych zestawów kowariantów, aż wynik stanie się istotny, to p-hacking. Kowariant wpisz do planu analiz przed zebraniem danych (prerejestracja).
- Raportowanie średnich surowych jako wyniku ANCOVA – test F dotyczy średnich skorygowanych; podaj je z 95% CI i nazwij wprost.
- Porównywanie η²p między analizami z różnymi kowariantami – cząstkowe miary efektu zależą od cech schematu badania i od innych zmiennych w modelu, przez co mogą wprowadzać w błąd (Olejnik i Algina, 2003).
Pełną ścieżkę analizy – od jednoczynnikowej ANOVA po porównania post hoc – opisuje poradnik ANOVA krok po kroku.
Najczęstsze pytania
Co to jest ANCOVA?
ANCOVA (analiza kowariancji) to analiza wariancji z dodatkową zmienną ilościową – kowariantem, np. wynikiem pre-testu. Porównuje średnie grup skorygowane o różnice w kowariancie i zmniejsza wariancję błędu, dzięki czemu test efektu grupy ma większą moc.
Czym różni się ANCOVA od ANOVA?
ANOVA porównuje surowe średnie grup. ANCOVA dodaje do modelu kowariant i porównuje średnie skorygowane, czyli oczekiwane wyniki grup przy tym samym poziomie kowariantu. W przykładzie na tej stronie ANOVA wyników końcowych dała p = .060, a ANCOVA z lękiem wyjściowym p < .001, bo kowariant zmniejszył wariancję błędu o 59.1%.
Jakie są założenia ANCOVA?
Liniowy związek kowariantu z wynikiem w każdej grupie, jednorodność nachyleń regresji (nieistotna interakcja kowariant × grupa), pomiar kowariantu przed interwencją i jego niezależność od niej, rzetelny pomiar kowariantu oraz założenia ANOVA dla reszt: normalność, równość wariancji i niezależność obserwacji.
Co to są średnie skorygowane w ANCOVA?
To średnie grup przewidywane przez model przy średnim poziomie kowariantu w całej próbie. Liczy się je ze wzoru M′ = MY − b × (MX, grupy − MX): grupa, która zaczynała powyżej średniej, ma średnią obniżoną, a grupa, która zaczynała poniżej – podwyższoną. W R podaje je funkcja emmeans(), w SPSS – szacowane średnie brzegowe.
ANCOVA czy ANOVA mieszana w badaniu pre-test–post-test?
Przy dwóch pomiarach interakcja grupa × czas w mieszanej ANOVA daje ten sam test co ANOVA wskaźników zmiany (post − pre). W badaniach randomizowanych ANCOVA z pre-testem jako kowariantem ma zwykle większą moc (Van Breukelen, 2006). Przy grupach nierandomizowanych oba podejścia mogą dać sprzeczne wnioski, dlatego opisz ograniczenia schematu.
Jak zrobić ANCOVA w SPSS?
Wybierz Analiza → Ogólny model liniowy → Jednej zmiennej. Wynik końcowy wstaw jako zmienną zależną, grupę jako czynnik stały, a pre-test jako współzmienną. Średnie skorygowane i porównania parami z korektą uzyskasz w opcjach średnich brzegowych (EM Means). Jednorodność nachyleń sprawdzisz w oknie Model, budując model niestandardowy z interakcją grupa × współzmienna.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Egbewale, B. E., Lewis, M., & Sim, J. (2014). Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study. BMC Medical Research Methodology, 14(1), Article 49. https://doi.org/10.1186/1471-2288-14-49 ● Otwarty dostęp
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
Cytowania BibTeX
@article{egbewale2014bias, author={Egbewale, Bolaji E. and Lewis, Martyn and Sim, Julius}, title={{Bias, precision and statistical power of analysis of covariance in the analysis of randomized trials with baseline imbalance: A simulation study}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={49}, doi={10.1186/1471-2288-14-49}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}