Co to jest zmienna kontrolna?
Zmienna kontrolna (ang. control variable) to zmienna, której wpływ na wynik badacz celowo neutralizuje, żeby lepiej oszacować związek interesującej go zmiennej niezależnej z zmienną zależną. Może to zrobić na etapie planu, na przykład utrzymując zmienną na stałym poziomie albo równoważąc ją między warunkami. Może też zrobić to na etapie analizy, wprowadzając ją do modelu jako dodatkowy predyktor (kowariant). Wtedy mówimy o kontroli statystycznej.
Nazwy łatwo pomylić. Grupa kontrolna to grupa osób bez interwencji, a pytanie kontrolne sprawdza uważność respondenta. Zmienna kontrolna jest natomiast cechą, np. wiekiem, neurotyzmem czy porą badania, której rolę chcemy wyłączyć z porównania.
Kontrola w planie i kontrola w analizie
| Sposób | Przykład | Co trzeba wiedzieć |
|---|---|---|
| Stały poziom | Wszyscy badani rano, w tej samej sali | Prosto i skutecznie, ale wynik dotyczy tylko tego poziomu |
| Równoważenie warunków | Kontrbalansowanie kolejności zadań | Działa w planach z powtarzanym pomiarem |
| Dobór lub dopasowanie | Pary osób o tym samym wieku i płci w obu grupach | Kontroluje tylko zmienne, według których dopasowano |
| Losowy przydział | Losowanie do warunków eksperymentu | Równoważy zmienne zmierzone i niezmierzone (w oczekiwaniu) |
| Kontrola statystyczna | Kowariant w regresji wielorakiej lub ANCOVA | Działa tylko wtedy, gdy zmienna pełni właściwą rolę przyczynową i jest dobrze zmierzona |
W pracach dyplomowych opartych na ankietach dominuje ostatni sposób. Jest wygodny, bo wystarczy dodać kolumnę do modelu. Właśnie dlatego bywa nadużywany.
Kontrola statystyczna ma też sens w eksperymencie. Tam nie służy do usuwania zakłóceń, bo te usuwa losowanie, lecz do zwiększenia precyzji. Zmienna zmierzona przed przydziałem do warunków, np. wynik pretestu, wyjaśnia część różnic między osobami. Wprowadzona jako kowariant zmniejsza wariancję błędu, więc zwęża przedział ufności efektu i zwiększa moc testu.
Dobre i złe zmienne kontrolne
Wprowadzenie zmiennej do modelu nie jest neutralne. Cinelli i in. (2024) nazywają „złą kontrolą” sytuację, w której dodanie zmiennej do regresji sprawia, że współczynnik przestaje odpowiadać efektowi, który miał reprezentować. Wysocki i in. (2022) pokazują, że przy niewłaściwie dobranych zmiennych kontrolnych oszacowanie bywa bardziej obciążone niż bez żadnej kontroli. Zalecają uzasadniać dobór zmiennych założoną strukturą przyczynową. To, czy zmienna jest dobrą kontrolą, zależy więc od jej miejsca w łańcuchu przyczyn, a nie od tego, czy koreluje z wynikiem:
- Wspólna przyczyna zmiennej niezależnej i wyniku, czyli zmienna zakłócająca – kontroluj.
- Przyczyna tylko wyniku – kontrola nie zmienia oszacowania, ale zmniejsza błąd standardowy, więc zwykle warto.
- Mediator, czyli zmienna leżąca na drodze od X do Y – nie kontroluj, jeśli pytasz o efekt całkowity. Kontrola „zjada” część efektu, którą chcesz zmierzyć (zob. mediacja).
- Zderzacz (ang. collider), czyli wspólny skutek X i Y – nie kontroluj. Kontrola tworzy fałszywy związek albo zniekształca prawdziwy.
- Skutek wyniku – nie kontroluj z tego samego powodu.
Przykład: media społecznościowe a objawy depresji
W symulowanym badaniu 500 studentów zmierzono dzienny czas w mediach społecznościowych (godziny) i objawy depresji (PHQ-9, 0–27). Ponieważ dane wygenerowaliśmy sami, znamy strukturę przyczynową i prawdziwy efekt całkowity jednej godziny: 0.60 pkt PHQ-9. Składa się na niego 0.30 pkt efektu bezpośredniego i 0.30 pkt działania przez skrócenie snu. Badacz ma do dyspozycji cztery potencjalne zmienne kontrolne: neurotyzm (wspólna przyczyna), stres egzaminacyjny (przyczyna tylko depresji), długość snu (mediator) i zgłoszenie się do poradni psychologicznej (zderzacz – skłaniają do niego i godziny w sieci, i objawy).
- Bez kontroli b = 1.46, 95% CI [1.22, 1.70]: efekt zawyżony ponad dwukrotnie, bo neurotyczni studenci i więcej czasu spędzają w sieci, i mają więcej objawów.
- Z neurotyzmem b = 0.58, 95% CI [0.32, 0.84] – blisko prawdy.
- Z neurotyzmem i stresem b = 0.55, 95% CI [0.32, 0.79]; błąd standardowy spadł z 0.133 do 0.119, a przedział się zwęził.
- Z neurotyzmem i snem b = 0.21, 95% CI [−0.07, 0.49], p = .134: kontrola mediatora usunęła połowę efektu i wynik stał się nieistotny.
- Z neurotyzmem i poradnią b = 0.13, 95% CI [−0.10, 0.37], p = .269: kontrola zderzacza zniekształciła efekt jeszcze bardziej.
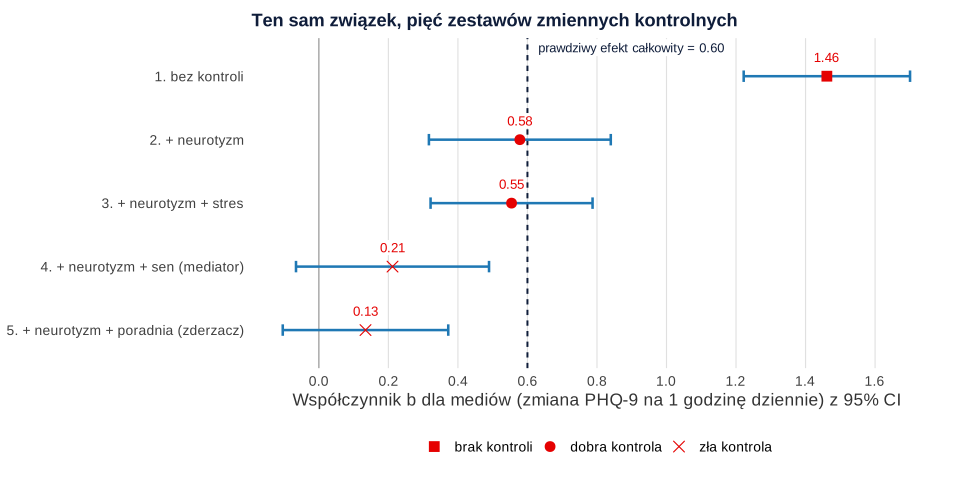
Wszystkie pięć modeli jest „poprawnych” statystycznie, a żaden test dopasowania nie wskaże tego właściwego. Wybór rozstrzyga wiedza o tym, co jest przyczyną czego. Narysuj ją jako diagram przed analizą, a w regresji zostaw tylko zmienne, które blokują ścieżki zakłócające.
Jak opisać zmienne kontrolne w pracy
Becker (2005) przeanalizował 60 artykułów z czołowych czasopism i znalazł trzy powtarzające się problemy. Autorzy nie uzasadniali, dlaczego włączają zmienne kontrolne, niejasno opisywali ich pomiar i niepełnie raportowali wyniki. Spector i Brannick (2011) dodają, że automatyczne „oczyszczanie” związków zmiennymi demograficznymi to metodologiczna miejska legenda. Zalecają jawnie określić rolę każdej zmiennej kontrolnej. Praktycznie oznacza to cztery rzeczy:
- dla każdej zmiennej kontrolnej podaj jedno zdanie uzasadnienia: dlaczego jest wspólną przyczyną X i Y albo przyczyną tylko Y;
- opisz jej pomiar i rzetelność tak samo starannie jak pomiar głównych zmiennych;
- pokaż wynik bez kontroli i z kontrolą, bo różnica jest informacją;
- w tabeli podaj współczynniki wszystkich predyktorów, ale interpretuj tylko ten, który odpowiada na pytanie badawcze.
Kolejne kroki budowy takiego modelu i tabelę wyników pokazujemy w poradniku regresja wieloraka krok po kroku. Jeśli zmienne kontrolne wprowadzasz w osobnym bloku, przyda się hasło regresja hierarchiczna.
Przykład w R
Kod generuje dane o znanej strukturze przyczynowej i szacuje współczynnik dla czasu w mediach społecznościowych w pięciu modelach różniących się zestawem zmiennych kontrolnych. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Pięć zestawów zmiennych kontrolnych w lm()
R
# Dane symulowane: czy czas w mediach społecznościowych (godz./dzień) wiąże się z objawami depresji (PHQ-9, 0–27)?
# Struktura przyczynowa przyjęta w symulacji (znamy ją, bo sami ją ustaliliśmy):
#   neurotyzm  -> media, neurotyzm -> depresja            (zmienna zakłócająca: dobra kontrola)
#   media -> sen -> depresja                             (mediator: zła kontrola, gdy pytamy o efekt całkowity)
#   media -> wizyta w poradni <- depresja                (zderzacz: zła kontrola)
#   stres egzaminacyjny -> depresja                      (przyczyna tylko wyniku: kontrola zwiększa precyzję)
set.seed(192)
n <- 500
neurotyzm <- rnorm(n, 0, 1)                                   # wynik standaryzowany
stres     <- rnorm(n, 0, 1)
media     <- pmax(0.2, 3 + 0.8 * neurotyzm + rnorm(n, 0, 1.2))  # godziny dziennie
sen       <- 7.5 - 0.30 * media + rnorm(n, 0, 0.8)              # godziny snu
depresja  <- 8 + 0.30 * media - 1.0 * (sen - 6.6) + 2.0 * neurotyzm + 1.5 * stres + rnorm(n, 0, 3)
poradnia  <- as.numeric(0.5 * media + 0.4 * depresja + rnorm(n, 0, 1.5) > quantile(0.5 * media + 0.4 * depresja, 0.80))
dane <- data.frame(media, neurotyzm, sen, poradnia, stres, depresja)

# Prawdziwy efekt całkowity 1 godziny mediów: 0.30 (bezpośrednio) + 0.30 × 1.0 (przez sen) = 0.60 pkt PHQ-9
modele <- list(
  "1. bez kontroli"                 = depresja ~ media,
  "2. + neurotyzm"                  = depresja ~ media + neurotyzm,
  "3. + neurotyzm + stres"          = depresja ~ media + neurotyzm + stres,
  "4. + neurotyzm + sen (mediator)" = depresja ~ media + neurotyzm + sen,
  "5. + neurotyzm + poradnia (zderzacz)" = depresja ~ media + neurotyzm + poradnia)
wyniki <- t(sapply(modele, function(f) {
  m <- lm(f, data = dane)
  c(b = coef(m)[["media"]], SE = coef(summary(m))["media", 2], confint(m)["media", ], p = coef(summary(m))["media", 4])
}))
round(wyniki, 3)

# Model 3 w całości (do raportu)
round(coef(summary(lm(depresja ~ media + neurotyzm + stres, data = dane))), 3)
round(summary(lm(depresja ~ media + neurotyzm + stres, data = dane))$r.squared, 3)
Wynik w R
                                         b    SE  2.5 % 97.5 %     p
1. bez kontroli                      1.461 0.122  1.222  1.701 0.000
2. + neurotyzm                       0.578 0.133  0.317  0.840 0.000
3. + neurotyzm + stres               0.554 0.119  0.321  0.787 0.000
4. + neurotyzm + sen (mediator)      0.212 0.141 -0.066  0.489 0.134
5. + neurotyzm + poradnia (zderzacz) 0.134 0.121 -0.104  0.372 0.269
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.088      0.387  18.305        0
media          0.554      0.119   4.675        0
neurotyzm      2.189      0.172  12.757        0
stres          1.543      0.135  11.430        0
[1] 0.514
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Kontrolujemy wszystko, co mamy”. Wrzucenie do modelu każdej zmiennej z ankiety (tzw. kitchen sink) łatwo wprowadza mediatory i zderzacze, a przy wielu predyktorach zwiększa też współliniowość.
- Wybór kontroli po wynikach – dodawanie i usuwanie zmiennych, aż efekt stanie się istotny. To forma p-hackingu; zestaw kontroli zapisz przed analizą.
- Płeć i wiek „z przyzwyczajenia”. Zmienne demograficzne są dobrą kontrolą tylko wtedy, gdy umiesz wskazać ich rolę przyczynową, a nie jako zastępstwo dla zmiennych teoretycznie ważnych (Spector i Brannick, 2011).
- Kontrola zmiennej zmierzonej po interwencji w eksperymencie. Jeśli manipulacja mogła ją zmienić, staje się mediatorem lub zderzaczem i niszczy korzyść z randomizacji.
- Przekonanie, że kontrola usuwa zakłócenie w całości. Słabo zmierzona zmienna kontrolna usuwa tylko część zakłócenia – szczegóły w haśle zmienna zakłócająca.
- Interpretowanie współczynników zmiennych kontrolnych jak efektów przyczynowych. Model ustawiony pod jeden efekt zwykle nie daje trafnych oszacowań dla pozostałych predyktorów.
Najczęstsze pytania
Czym różni się zmienna kontrolna od zmiennej zakłócającej?
Zmienna zakłócająca to wspólna przyczyna zmiennej niezależnej i wyniku, która tworzy fałszywy lub zniekształcony związek. Zmienna kontrolna to rola, jaką nadaje zmiennej badacz, gdy neutralizuje jej wpływ. Zmienną zakłócającą warto kontrolować, ale nie każda zmienna kontrolna jest zakłócająca – bywa przyczyną tylko wyniku albo, błędnie, mediatorem.
Jakie zmienne kontrolne wybrać do regresji?
Te, które według teorii i wcześniejszych badań są wspólnymi przyczynami predyktora i wyniku, oraz te, które wpływają tylko na wynik (zwiększają precyzję). Pomiń zmienne leżące na drodze przyczynowej (mediatory) i wspólne skutki predyktora i wyniku. Zestaw ustal przed analizą, najlepiej rysując diagram przyczynowy.
Czy płeć i wiek zawsze trzeba kontrolować?
Nie. Zmienne demograficzne kontroluj wtedy, gdy potrafisz wskazać, że wpływają i na predyktor, i na wynik. Dodawanie ich z przyzwyczajenia nie czyni analizy bardziej rygorystyczną, a może utrudnić interpretację, szczególnie w małych próbach.
Dlaczego po dodaniu zmiennej kontrolnej efekt przestał być istotny?
Możliwe są trzy wyjaśnienia: zmienna była zakłócająca i pierwotny efekt był zawyżony; zmienna jest mediatorem i jej kontrola usunęła część efektu, którą chcesz mierzyć; albo jest zderzaczem i zniekształciła związek. Statystyka tego nie rozstrzygnie – potrzebne jest uzasadnienie przyczynowe.
Co to jest zła zmienna kontrolna?
To zmienna, której dodanie do modelu sprawia, że współczynnik przestaje odpowiadać szukanemu efektowi. Typowe przykłady to mediator (gdy interesuje nas efekt całkowity), zderzacz, czyli wspólny skutek predyktora i wyniku, oraz zmienna zmierzona po interwencji, na którą interwencja mogła wpłynąć.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak wybrać zmienne do regresji
Dlaczego nie metoda krokowa i nie wybór według p: cel analizy, DAG, liczba predyktorów, LASSO z walidacją krzyżową i wzór opisu doboru zmiennych.
Czytaj →PoradnikBłąd tabeli 2
Dlaczego współczynniki zmiennych kontrolnych to nie efekty: palenie, nadciśnienie i udar w R, DAG, osobne modele i wzór opisu tabeli w pracy.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikCzy kontrolować wiek i płeć?
Kiedy wiek i płeć usuwają zakłócenie, kiedy tylko zwiększają precyzję, a kiedy szkodzą – z przykładem czterech modeli w R i wzorem opisu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Becker, T. E. (2005). Potential problems in the statistical control of variables in organizational research: A qualitative analysis with recommendations. Organizational Research Methods, 8(3), 274–289. https://doi.org/10.1177/1094428105278021
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{becker2005potential, author={Becker, Thomas E.}, title={{Potential problems in the statistical control of variables in organizational research: A qualitative analysis with recommendations}}, journal={Organizational Research Methods}, year={2005}, volume={8}, number={3}, pages={274--289}, doi={10.1177/1094428105278021}}@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{spector2011methodological, author={Spector, Paul E. and Brannick, Michael T.}, title={{Methodological urban legends: The misuse of statistical control variables}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={287--305}, doi={10.1177/1094428110369842}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}