Co to jest zmienna zakłócająca?
Zmienna zakłócająca (ang. confounder, confounding variable) to zmienna, która wpływa jednocześnie na zmienną niezależną (ekspozycję, predyktor) i na zmienną zależną. Przez to tworzy między nimi związek, który nie jest efektem jednej na drugą. Związek może być w całości pozorny, zawyżony, zaniżony, a nawet mieć odwrócony kierunek. Skrajne przypadki opisują hasła korelacja pozorna i paradoks Simpsona.
W praktyce zmienną zakłócającą rozpoznaje się po trzech cechach. Jest związana z ekspozycją. Wpływa na wynik niezależnie od ekspozycji. I nie leży na drodze przyczynowej od ekspozycji do wyniku, czyli nie jest jej skutkiem. Formalnie sprawa jest subtelniejsza. VanderWeele i Shpitser (2013) zauważają, że literatura przyczynowa precyzyjnie definiuje samo zakłócanie, ale nie zmienną zakłócającą. Proponują nazywać tak zmienną sprzed ekspozycji, która należy do minimalnego zestawu zmiennych wystarczającego do usunięcia zakłócenia. Zmienną, która tylko zmniejsza obciążenie, nazywają zastępczą zmienną zakłócającą (ang. surrogate confounder).
Jak zakłócenie zniekształca wynik
Zakłócenie to problem ścieżki tylnymi drzwiami: od ekspozycji do wyniku prowadzi droga, która omija bezpośredni wpływ i biegnie przez wspólną przyczynę. Rohrer (2018) pokazuje, jak diagramy przyczynowe pomagają takie ścieżki znaleźć i zablokować. Podkreśla też, że trafny wniosek przyczynowy zawsze opiera się na założeniach z wiedzy dziedzinowej. Grimes i Schulz (2002) przypominają, że w badaniach obserwacyjnych zakłócanie, błąd selekcji i błąd informacji występują zawsze w pewnym stopniu. Mogą przy tym dawać wysoce istotne, lecz pozorne wyniki, więc przypadek jako wyjaśnienie warto rozważać dopiero na końcu.
Zakłócenie nie zawsze zawyża efekt. W badaniach klinicznych częste jest zakłócenie przez wskazanie (ang. confounding by indication). Na terapię zgłaszają się częściej osoby z cięższymi objawami, więc w prostym porównaniu korzystający z terapii mają gorsze wyniki niż niekorzystający, a terapia „szkodzi”. Wspólną przyczyną jest tu wyjściowe nasilenie objawów: zwiększa szansę podjęcia terapii i nasilenie objawów w kolejnym pomiarze. Odwrotny kierunek ma efekt zdrowego ochotnika. Do programów profilaktycznych częściej zgłaszają się osoby zdrowsze i bardziej zmotywowane, co zawyża pozorne korzyści. W obu przypadkach kierunek zakłócenia da się przewidzieć z wiedzy o tym, kto trafia do której grupy. Opisz go w dyskusji, nawet jeśli nie możesz go zmierzyć.
| Etap | Metoda | Ograniczenie |
|---|---|---|
| Plan | Randomizacja | Jedyna metoda równoważąca także zmienne niezmierzone; często niemożliwa |
| Plan | Restrykcja (np. tylko osoby z wyższym wykształceniem) | Zawęża populację, do której stosuje się wynik |
| Plan | Dopasowanie par | Działa tylko dla zmiennych użytych do dopasowania |
| Analiza | Stratyfikacja – analiza w warstwach zmiennej | Szybko brakuje osób w warstwach |
| Analiza | Kontrola w modelu (regresja, ANCOVA) | Wymaga trafnego i rzetelnego pomiaru zmiennej oraz poprawnej postaci modelu |
Każda metoda analityczna usuwa zakłócenie tylko w takim stopniu, w jakim zmierzono zmienną zakłócającą. Tę lukę pokazuje przykład.
Przykład: Uniwersytet Trzeciego Wieku i funkcje poznawcze
Symulowane badanie obserwacyjne objęło 400 seniorów. 149 osób uczestniczyło w zajęciach Uniwersytetu Trzeciego Wieku (UTW), a 251 nie. Funkcjonowanie poznawcze oceniono testem MoCA (0–30). W symulacji UTW nie ma żadnego wpływu na MoCA. Obie zmienne zależą jednak od zasobów poznawczych z młodości (wykształcenie, zawód, nawyk czytania): osoby z większymi zasobami częściej zapisują się na zajęcia i mają wyższe wyniki. W badaniu zmierzono tylko niedoskonały wskaźnik tych zasobów – liczbę lat nauki – o rzetelności około .45.
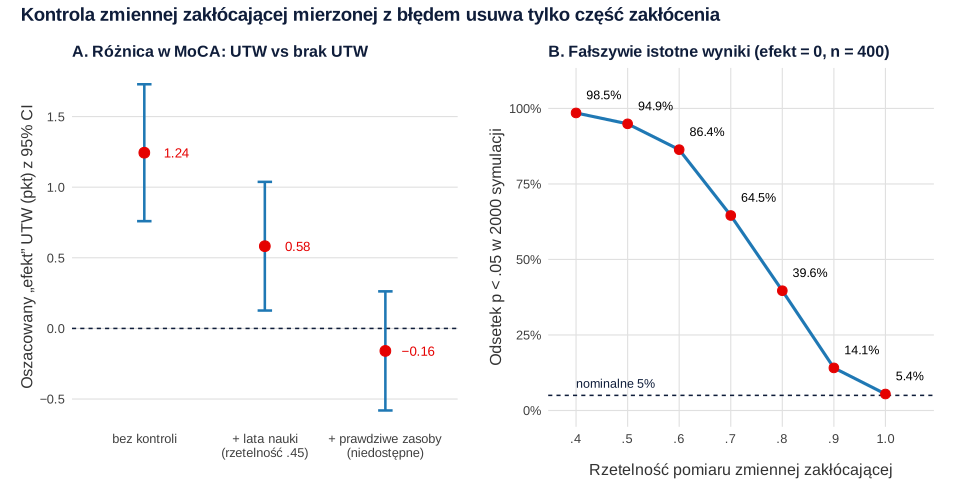
- Bez kontroli: uczestnicy UTW mieli średnio 24.85 pkt, a pozostali 23.60. Różnica wynosi b = 1.24, t(398) = 5.05, p < .001 – wygląda na wyraźny efekt.
- Z kontrolą lat nauki: b = 0.58, t(397) = 2.51, p = .012. Efekt zmalał o połowę, ale nadal jest „istotny”.
- Z kontrolą prawdziwych zasobów (w realnym badaniu niedostępnych): b = −0.16, t(397) = −0.74, p = .458, czyli brak efektu, zgodnie z prawdą.
Pozostałe 0.58 pkt to zakłócenie resztkowe (ang. residual confounding). Kontrolowanie wskaźnika mierzonego z błędem wyrównuje grupy pod względem wskaźnika, ale nie pod względem samej zmiennej zakłócającej. Westfall i Yarkoni (2016) wykazali, że takie strategie mają bardzo wysoki odsetek błędów I rodzaju, najwyższy przy dużych próbach i umiarkowanej rzetelności. Symulacja z rysunku 1B potwierdza to dla naszego scenariusza. Przy rzetelności wskaźnika .70 fałszywie istotny „efekt” UTW pojawia się w 64.5% badań, przy .90 – w 14.1%, a dopiero przy pomiarze bezbłędnym spada do nominalnych 5.4%.
Wniosek praktyczny: „kontrolowałem wykształcenie” nie znaczy „wykluczyłem zakłócenie przez wykształcenie”. Im słabszy pomiar zmiennej zakłócającej i im większa próba, tym bardziej zakłócenie resztkowe udaje prawdziwy efekt. Dobór kontrolowanych zmiennych, łącznie z pułapkami kontroli mediatorów i zderzaczy, omawia hasło zmienna kontrolna.
Jak opisać zmienne zakłócające w pracy
W metodzie wymień zmienne zakłócające, które uwzględniono, i źródło tej listy: teorię, wcześniejsze badania albo diagram przyczynowy. Podaj, jak je zmierzono i z jaką rzetelnością. W wynikach pokaż oszacowanie surowe i skorygowane (różnica między nimi mówi czytelnikowi, jak silne było zmierzone zakłócenie), a w dyskusji nazwij zmienne, których nie zmierzono, i możliwy kierunek ich wpływu. Ostrożne formułowanie wniosków z danych obserwacyjnych omawia poradnik jak napisać dyskusję wyników, a typowe pytania recenzentów o kontrolę – tekst zarzuty recenzentów do statystyki.
Przykład w R
Kod tworzy dane seniorów, w których udział w UTW nie wpływa na wynik MoCA, szacuje różnicę bez kontroli, z kontrolą wskaźnika i z kontrolą prawdziwej zmiennej zakłócającej, a następnie sprawdza w symulacji, jak często pojawia się fałszywie istotny efekt przy różnej rzetelności wskaźnika. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Zakłócenie, kontrola niedoskonałego wskaźnika i symulacja błędu I rodzaju
R
# Dane symulowane: czy udział w zajęciach Uniwersytetu Trzeciego Wieku (UTW) wiąże się z lepszym
# funkcjonowaniem poznawczym seniorów (test MoCA, 0–30)? W symulacji UTW NIE ma żadnego wpływu na MoCA.
# Zmienna zakłócająca: zasoby poznawcze z młodości (wykształcenie, zawód, czytanie) – zwiększają
# szansę udziału w UTW i podnoszą wynik MoCA.
set.seed(193)
n <- 400
zasoby <- rnorm(n, 0, 1)                                    # prawdziwa zmienna zakłócająca (standaryzowana)
utw    <- rbinom(n, 1, plogis(-0.8 + 1.2 * zasoby))         # udział w UTW (1 = tak)
moca   <- round(pmin(30, 24 + 1.8 * zasoby + 0 * utw + rnorm(n, 0, 2)))
# W badaniu mamy tylko niedoskonały wskaźnik zasobów: liczbę lat nauki (rzetelność ok. .50)
lata_nauki <- round(12 + 2.5 * (zasoby + rnorm(n, 0, 1)) / sqrt(2))
dane <- data.frame(utw, moca, lata_nauki, zasoby)

table(dane$utw)
round(tapply(dane$moca, dane$utw, mean), 2)
round(cor(dane$zasoby, dane$lata_nauki)^2, 2)            # rzetelność wskaźnika (kwadrat korelacji z prawdziwą zmienną)

uj <- function(m) round(coef(summary(m))["utw", ], 3)
uj(lm(moca ~ utw, data = dane))                            # 1. bez kontroli
uj(lm(moca ~ utw + lata_nauki, data = dane))               # 2. kontrola niedoskonałego wskaźnika
uj(lm(moca ~ utw + zasoby, data = dane))                   # 3. kontrola prawdziwej zmiennej (niedostępna w praktyce)

# Symulacja: jak często test „efektu” UTW daje p < .05, choć efekt wynosi 0,
# w zależności od rzetelności wskaźnika zmiennej zakłócającej (po 2000 powtórzeń)
symuluj <- function(rzet, n = 400, R = 2000) {
  mean(replicate(R, {
    z <- rnorm(n); u <- rbinom(n, 1, plogis(-0.8 + 1.2 * z)); y <- 24 + 1.8 * z + rnorm(n, 0, 2)
    w <- sqrt(rzet) * z + sqrt(1 - rzet) * rnorm(n)        # wskaźnik o zadanej rzetelności
    coef(summary(lm(y ~ u + w)))["u", 4] < .05
  }))
}
set.seed(2193)
rzetelnosci <- c(0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1.0)
odsetek_istotnych <- sapply(rzetelnosci, symuluj)
data.frame(rzetelnosc = rzetelnosci, odsetek_p_ponizej_05 = round(odsetek_istotnych, 3))
Wynik w R
  0   1
251 149
    0     1
23.60 24.85
[1] 0.45
  Estimate Std. Error    t value   Pr(>|t|)
     1.244      0.247      5.046      0.000
  Estimate Std. Error    t value   Pr(>|t|)
     0.582      0.232      2.512      0.012
  Estimate Std. Error    t value   Pr(>|t|)
    -0.159      0.214     -0.743      0.458
  rzetelnosc odsetek_p_ponizej_05
1        0.4                0.985
2        0.5                0.949
3        0.6                0.864
4        0.7                0.645
5        0.8                0.396
6        0.9                0.141
7        1.0                0.054
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2 (z patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Szukanie zmiennych zakłócających testami istotności („wiek nie różnicował grup, p = .21, więc go pominąłem”). O zakłóceniu decyduje wielkość związków i struktura przyczynowa, a nie wartość p w małej próbie.
- Uznawanie każdej zmiennej trzeciej za zakłócającą. Zmienna, na którą wpływa ekspozycja, jest mediatorem albo skutkiem, a jej kontrola zniekształca efekt.
- Ignorowanie błędu pomiaru zmiennej kontrolowanej. Jednopytaniowy wskaźnik czy przybliżona kategoria usuwa tylko część zakłócenia (Westfall i Yarkoni, 2016). Używaj rzetelnych miar albo modeli ze zmiennymi latentnymi.
- Przekonanie, że duża próba chroni przed zakłóceniem. Większa liczebność zmniejsza błąd losowy, ale nie obciążenie. Przy zakłóceniu resztkowym zwiększa wręcz odsetek fałszywie istotnych wyników.
- Brak wzmianki o niezmierzonych zmiennych zakłócających. W badaniu obserwacyjnym zawsze istnieją; uczciwa dyskusja nazywa najważniejsze z nich i ocenia, czy mogłyby wyjaśnić wynik (zob. analiza wrażliwości).
- Mylenie zakłócenia z interakcją. Zmienna zakłócająca zniekształca efekt; moderator sprawia, że efekt jest różny w różnych grupach. Ta sama zmienna może pełnić obie role, ale każdą sprawdza się inaczej.
Najczęstsze pytania
Jak rozpoznać zmienną zakłócającą?
Sprawdź trzy warunki: zmienna wiąże się z predyktorem, wpływa na wynik niezależnie od predyktora i nie jest skutkiem predyktora (nie leży na drodze przyczynowej). Ocenia się to na podstawie teorii, wcześniejszych badań i kolejności zdarzeń w czasie, a nie testem istotności w zebranych danych.
Co to jest zakłócenie resztkowe?
To zakłócenie, które zostaje po kontroli zmiennej zakłócającej, bo zmierzono ją z błędem, zbyt zgrubnie albo w złej postaci. Kontrola niedoskonałego wskaźnika (np. lat nauki zamiast zasobów poznawczych) wyrównuje grupy tylko częściowo, więc część fałszywego efektu pozostaje i może być istotna statystycznie.
Czy randomizacja usuwa wszystkie zmienne zakłócające?
W oczekiwaniu tak – losowy przydział sprawia, że zmienne zakłócające, także niezmierzone, rozkładają się w grupach podobnie. W konkretnym małym badaniu mogą zostać przypadkowe różnice, ale nie są one zakłóceniem systematycznym i uwzględnia je wartość p.
Czy duża próba chroni przed zmiennymi zakłócającymi?
Nie. Duża próba zmniejsza błąd losowy, ale nie obciążenie wynikające z zakłócenia. Przy zakłóceniu resztkowym im większa próba, tym częściej fałszywy efekt okazuje się istotny statystycznie.
Jakie są przykłady zmiennych zakłócających w psychologii?
Typowe to status socjoekonomiczny, wykształcenie, wiek, stan zdrowia somatycznego i cechy osobowości, np. neurotyzm. Przykładowo neurotyzm może zwiększać zarówno czas w mediach społecznościowych, jak i objawy depresji, tworząc między nimi związek niezależny od samego korzystania z mediów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Paradoks Simpsona – wizualizacja
Chmury punktów z przeciwnymi znakami, zmiana znaku w regresji w 1000 badaniach, odsetki jako średnia ważona i graf przyczynowy – pięć rysunków z kodem R.
Czytaj →PoradnikMetodologia badań – zadania z rozwiązaniami
Dziesięć zadań: zmienne i skale, schemat badania, zagrożenia trafności, regresja do średniej, hipotezy, operacjonalizacja, dobór próby, mediator i moderator.
Czytaj →PoradnikBłąd tabeli 2
Dlaczego współczynniki zmiennych kontrolnych to nie efekty: palenie, nadciśnienie i udar w R, DAG, osobne modele i wzór opisu tabeli w pracy.
Czytaj →PoradnikPropensity score: dopasowanie i ważenie
Badanie obserwacyjne krok po kroku w R: ATE czy ATT, dopasowanie 1:1 z kaliprem, wagi IPTW, równowaga SMD, bootstrap, E-value i opis do artykułu.
Czytaj →PoradnikJak napisać dyskusję wyników – wzory zdań
Osiem elementów dyskusji z gotowymi zdaniami: interpretacja, wyniki nieistotne, konkretne ograniczenia, granice uogólniania, implikacje i wnioski.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Grimes, D. A., & Schulz, K. F. (2002). Bias and causal associations in observational research. The Lancet, 359(9302), 248–252. https://doi.org/10.1016/s0140-6736(02)07451-2
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- VanderWeele, T. J., & Shpitser, I. (2013). On the definition of a confounder. The Annals of Statistics, 41(1), 196–220. https://doi.org/10.1214/12-aos1058 ● Otwarty dostęp
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{grimes2002bias, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Bias and causal associations in observational research}}, journal={The Lancet}, year={2002}, volume={359}, number={9302}, pages={248--252}, doi={10.1016/s0140-6736(02)07451-2}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{vanderweele2013definition, author={VanderWeele, Tyler J. and Shpitser, Ilya}, title={{On the definition of a confounder}}, journal={The Annals of Statistics}, year={2013}, volume={41}, number={1}, pages={196--220}, doi={10.1214/12-aos1058}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}