Regresja logistyczna – kiedy jej potrzebujesz
Regresję logistyczną stosujesz, gdy zmienna zależna ma dwie wartości: zdał – nie zdał, wystąpiły objawy – nie wystąpiły, skorzystał z oferty – nie skorzystał. Model opisuje, jak predyktory zmieniają szanse wystąpienia zdarzenia, a wynik podaje się zwykle jako iloraz szans (OR). Sperandei (2014) podkreśla jej główną zaletę: pozwala ocenić wpływ kilku zmiennych jednocześnie, a więc uwzględnić zmienne zakłócające. Definicję i podstawowe pojęcia znajdziesz w haśle regresja logistyczna; ten poradnik pokazuje cały proces na jednym przykładzie – od modelu przez interpretację i założenia po tabelę APA.
Dlaczego nie zwykła regresja liniowa na zmiennej 0/1? Bo przewidywane wartości mogą wyjść poza przedział od 0 do 1, reszty nie mogą mieć rozkładu normalnego ani stałej wariancji, a zależność prawdopodobieństwa od predyktora w rzeczywistości nie jest prostą linią: blisko 0 i blisko 1 zmienia się wolniej niż w środku. Regresja logistyczna modeluje więc nie samo prawdopodobieństwo, tylko jego logit – logarytm szans.
logit(p) = ln[p / (1 − p)] = b0 + b1X1 + … + bkXk
p = 1 / (1 + e−logit)
Szanse to nie to samo co prawdopodobieństwo. Prawdopodobieństwo .75 oznacza szanse 3 : 1 (0.75 / 0.25 = 3), a prawdopodobieństwo .50 – szanse 1 : 1. Bland i Altman (2000) wyjaśniają, że ilorazy szans są tak popularne, bo opisują związek dwóch zmiennych dychotomicznych z przedziałem ufności i pozwalają w regresji logistycznej uwzględnić inne zmienne. Współczynniki szacuje się metodą największej wiarygodności, a nie metodą najmniejszych kwadratów.
Jeśli wynik ma więcej niż dwie uporządkowane kategorie (np. ocena 2–5), zamiast dzielić go na dwie grupy, rozważ regresję porządkową. Nie dziel też na dwie części zmiennej ciągłej tylko po to, by użyć regresji logistycznej – dzielenie medianą wyrzuca informację.
Przykład: kto zdaje egzamin ze statystyki w pierwszym terminie?
W przykładzie (dane symulowane) 240 studentów odpowiedziało, ile godzin tygodniowo uczyło się do egzaminu (M = 5.86, SD = 3.55), wypełniło skalę lęku przed statystyką (średnia z pozycji 1–5; M = 2.94, SD = 0.75) i podało, czy chodziło na konsultacje (61 osób, 25.4%). Zmienna zależna to zdanie egzaminu w pierwszym terminie: zdały 154 osoby (64.2%). Wśród osób bez konsultacji zdało 60.9%, a wśród chodzących na konsultacje – 73.8%.
Plik do pobrania: regresja-logistyczna-dane-przyklad.csv – 240 wierszy, kolumny id, zdal (1 = tak), lek, godziny, konsultacje (1 = tak). Wszystkie liczby w tekście pochodzą z kodu w sekcji Przykład w R.
Zwróć uwagę na kodowanie: zmienna zależna ma wartości 0 i 1, a model przewiduje prawdopodobieństwo wartości 1. Predyktor dwuwartościowy (konsultacje) też koduj 0/1, a przy predyktorze o kilku kategoriach użyj kodowania zero-jedynkowego z jasno wskazaną kategorią odniesienia. Odwrócenie kodowania zmiennej zależnej odwraca znaki wszystkich współczynników.
Dopasowany model ma postać:
Model jako całość wyjaśnia wynik lepiej niż model bez predyktorów: test ilorazu wiarygodności χ²(3) = 57.19, p < .001. To porównanie dewiancji modelu zerowego (313.18) i pełnego (255.99).
Jak interpretować współczynniki i ilorazy szans
Współczynnik b mówi, o ile zmienia się logit przy wzroście predyktora o jednostkę, przy stałych pozostałych predyktorach. Logit jest mało intuicyjny, dlatego współczynnik przekształca się w iloraz szans: OR = eb. OR > 1 oznacza wzrost szans, OR < 1 – spadek, a OR = 1 – brak związku.
- Godziny nauki: b = 0.26, OR = 1.30, 95% CI [1.16, 1.48]. Każda dodatkowa godzina nauki tygodniowo wiąże się z szansami zdania wyższymi o 30% (mnożnik 1.30), przy tym samym lęku i udziale w konsultacjach. Pięć godzin więcej to nie 5 × 30%, tylko OR = 1.305 = 3.75 – ilorazy szans mnożą się, a nie dodają.
- Lęk przed statystyką: b = −1.24, OR = 0.29, 95% CI [0.18, 0.45]. Wzrost lęku o 1 punkt skali wiąże się z szansami zdania mniejszymi mniej więcej o 71%. Jeden punkt to jednak ponad jedno odchylenie standardowe tej skali; dla wzrostu o 1 SD (0.75 punktu) OR = 0.40.
- Konsultacje: b = 1.21, OR = 3.35, 95% CI [1.57, 7.59]. Szanse zdania u osób chodzących na konsultacje są 3.35 raza większe niż u osób o tym samym lęku i czasie nauki, które na konsultacje nie chodzą. Szeroki przedział wynika z tego, że konsultacje wybrało tylko 61 osób.
Ilorazów szans mniejszych od 1 nie porównuj „na oko” z większymi: OR = 0.29 to w przybliżeniu ten sam efekt co OR = 1 / 0.29 = 3.4 w przeciwnym kierunku. Szumilas (2010) przypomina, że o istotności związku świadczy przedział ufności i wartość p, a nie sama wielkość OR. Przedział ufności dla OR liczy się na skali logitu i przekształca wykładniczo, dlatego jest niesymetryczny wokół OR.
Iloraz szans to nie ryzyko względne. Zdanie „konsultacje zwiększają prawdopodobieństwo zdania 3.35 raza” jest błędne – przy 64% zdających byłoby to niemożliwe. Davies i in. (1998) pokazują, że iloraz szans interpretowany jako ryzyko względne zawsze zawyża efekt i że rozbieżność rośnie wraz z częstością wyniku; OR dobrze przybliża ryzyko względne tylko przy rzadkich zdarzeniach. W medycynie ten błąd jest szczególnie częsty – zob. statystyka dla lekarza.
Ostatnia pułapka: Mood (2010) wykazała, że współczynniki regresji logistycznej zmieniają się po dodaniu do modelu innych zmiennych nawet wtedy, gdy nie są one skorelowane z predyktorem, bo odzwierciedlają też nieobserwowaną heterogeniczność. Nie porównuj więc wprost OR z modeli o różnych zestawach predyktorów ani między grupami – do takich porównań lepiej nadają się prawdopodobieństwa przewidywane.
Prawdopodobieństwa przewidywane: wynik, który zrozumie każdy
Dla czytelnika (i promotora) najbardziej zrozumiałe jest przeliczenie modelu na prawdopodobieństwa dla konkretnych profili osób. Wystarczy wstawić wartości predyktorów do równania i przekształcić logit wzorem z pierwszej sekcji:
| Profil studenta | Przewidywane prawdopodobieństwo zdania | 95% CI |
|---|---|---|
| Niski lęk (2.2), 6 godzin nauki, bez konsultacji | .81 | [.72, .88] |
| Wysoki lęk (3.7), 2 godziny nauki, bez konsultacji | .19 | [.11, .32] |
| Wysoki lęk (3.7), 6 godzin nauki, bez konsultacji | .40 | [.30, .52] |
| Wysoki lęk (3.7), 6 godzin nauki, z konsultacjami | .70 | [.54, .82] |
Rysunek 1 pokazuje to samo dla pełnego zakresu godzin nauki. Widać na nim najważniejszą cechę modelu logistycznego: stały iloraz szans nie oznacza stałej zmiany prawdopodobieństwa. Krzywe są najbardziej strome w środku, a spłaszczają się przy prawdopodobieństwach bliskich 0 i 1.
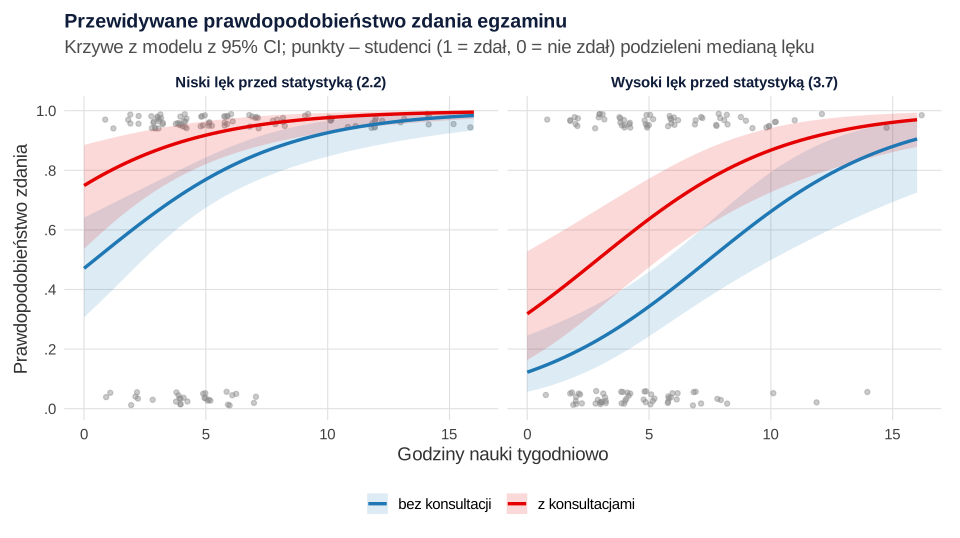
Ta sama dodatkowa godzina nauki (OR = 1.30) podnosi prawdopodobieństwo zdania z .20 do .25 (o 4.6 punktu procentowego), z .50 do .57 (o 6.6 punktu) i z .80 do .84 (o 3.9 punktu). Dlatego jedną liczbą opisującą efekt w punktach procentowych jest przeciętny efekt krańcowy (ang. average marginal effect, AME): średnia z całej próby zmiana przewidywanego prawdopodobieństwa. W przykładzie:
- dodatkowa godzina nauki – średnio +4.8 punktu procentowego;
- wzrost lęku o 1 punkt – średnio −22.3 punktu procentowego;
- konsultacje – średnio +20.0 punktu procentowego.
Szybka kontrola: współczynnik podzielony przez 4 daje górną granicę zmiany prawdopodobieństwa (osiąganą przy p = .50). Dla godzin to 0.26 / 4, czyli 6.6 punktu procentowego – AME (4.8) musi być mniejszy.
Założenia regresji logistycznej i jak je sprawdzić
Regresja logistyczna ma mniej założeń, niż sądzi wielu studentów – i inne niż regresja liniowa. Nie zakłada normalności rozkładu reszt ani predyktorów, ani homoskedastyczności. Peng i in. (2002) w swoich wytycznych raportowania wymieniają założenia do sprawdzenia i minimalny stosunek liczby obserwacji do liczby predyktorów. W praktyce sprawdź sześć rzeczy:
- Wynik dwuwartościowy i poprawne kodowanie. Upewnij się, która kategoria to 1.
- Niezależność obserwacji. Każda osoba występuje raz; przy pomiarach powtarzanych albo osobach zagnieżdżonych w grupach potrzebny jest model wielopoziomowy.
- Liniowość logitu względem predyktorów ciągłych. Model zakłada, że logit zmienia się liniowo z lękiem i godzinami nauki. Test Boxa–Tidwella dodaje do modelu człony X × ln(X); ich istotność wskazuje na nieliniowość. W przykładzie żaden nie był istotny: dla lęku z = 0.84, p = .399, dla godzin nauki (przesuniętych o 1, bo logarytm z zera nie istnieje) z = 1.19, p = .234. Gdy zależność jest nieliniowa, dodaj człon kwadratowy albo splajn.
- Brak silnej współliniowości. VIF wyniosły 1.09–1.20, więc predyktory nie powielają informacji.
- Obserwacje nietypowe i wpływowe. Żadna reszta standaryzowana nie przekroczyła 3, a największa odległość Cooka wyniosła 0.045. Pojedyncze obserwacje odstające sprawdź w danych, ale nie usuwaj ich tylko dlatego, że „psują” wynik.
- Wystarczająca liczba zdarzeń. Ważna jest liczebność rzadszej kategorii wyniku, a nie całej próby. Tu nie zdało 86 osób, a model ma 3 predyktory, czyli 28.7 zdarzenia na zmienną (EPV).
Ile osób potrzeba? Reguła „10 zdarzeń na zmienną” i jej krytyka
Popularna reguła mówi o co najmniej 10 zdarzeniach na predyktor. Van Smeden i in. (2016) w symulacjach pokazali, że problemy małej liczby zdarzeń zależą także od innych czynników, m.in. od całkowitej liczebności próby, i ocenili dowody wspierające tę regułę jako słabe. Riley i in. (2019) dla modeli predykcyjnych proponują zamiast reguły kciuka trzy kryteria, które pozwalają obliczyć minimalną liczebność, i przestrzegają przed regułą 10 zdarzeń na parametr. W pracy dyplomowej bezpieczniej założyć dużą liczbę zdarzeń i niewiele predyktorów – i nie wrzucać do modelu wszystkich zmiennych z ankiety. O planowaniu liczebności w ogóle piszemy w poradniku dobór liczebności próby.
Separacja: gdy model „przewiduje za dobrze”
Separacja zachodzi, gdy predyktor (lub ich kombinacja) idealnie rozdziela zdających i niezdających – np. w małej grupie 28 osób wszystkie 10 osób z konsultacjami zdało. Estymacja metodą największej wiarygodności nie ma wtedy skończonego rozwiązania. Objawy w wydruku: ogromny współczynnik (tu b = 24.50) i jeszcze większy błąd standardowy (4373.17), a w efekcie absurdalne p = 1.00. Program często tylko ostrzega, ale nie przerywa obliczeń. Rozwiązaniem jest regresja z karą Firtha – van Smeden i in. (2016) zauważają, że poprawia ona dokładność współczynników przy małej liczbie zdarzeń. W przykładzie dała skończone, ale bardzo niepewne oszacowanie: b = 5.88, SE = 2.40. Uczciwy wniosek jest taki, że efekt jest prawdopodobnie duży, ale jego wielkości nie da się z tych danych precyzyjnie oszacować.
Ocena modelu: dopasowanie, pseudo-R², klasyfikacja i kalibracja
Jedna liczba nie powie, czy model jest „dobry”. Oceń go z kilku stron.
Test ilorazu wiarygodności (χ²(3) = 57.19, p < .001) sprawdza, czy predyktory razem poprawiają dopasowanie względem modelu bez predyktorów. Tak samo porównasz modele zagnieżdżone, np. przed dodaniem i po dodaniu konsultacji.
Pseudo-R² to kilka różnych miar i żadna nie jest „procentem wyjaśnionej wariancji” jak R² w regresji liniowej. W przykładzie: McFadden .18, Cox–Snell .21, Nagelkerke .29, Tjur .21 (różnica średnich przewidywanych prawdopodobieństw między zdającymi a niezdającymi). Menard (2000) pokazał, że analogi R² różnią się zależnością od częstości wyniku i że wnioski z nich nie muszą się zgadzać z miarami trafności predykcji. Podaj jedną miarę, nazwij ją i nie interpretuj jej jak R² z regresji liniowej.
Tabela klasyfikacji przy progu .50: model poprawnie zaklasyfikował 71.7% osób, przy czułości 82.5% (zdający rozpoznani jako zdający) i swoistości 52.3%. Ta liczba sama w sobie mówi mało, bo „model”, który każdemu przypisze zdanie, trafiłby w 64.2% przypadków. Wynik zależy też od wybranego progu, dlatego lepszą miarą rozróżniania jest pole pod krzywą ROC: AUC = .77, 95% CI [.71, .83]. Oznacza to, że w losowo wybranej parze (osoba zdająca i niezdająca) model w 77% przypadków przypisze wyższe prawdopodobieństwo osobie zdającej.
Kalibracja sprawdza, czy przewidywane prawdopodobieństwa zgadzają się z obserwowanymi odsetkami. Test Hosmera–Lemeshowa dzieli próbę na 10 grup według przewidywanego prawdopodobieństwa i porównuje liczby zdarzeń oczekiwanych i obserwowanych: χ²(8) = 4.07, p = .851, czyli brak sygnału złego dopasowania. Test ma małą moc w małych próbach i bardzo dużą w ogromnych, dlatego lepiej pokazać wykres kalibracji (rysunek 2A): w każdej z 10 grup obserwowany odsetek zdających był bliski średniemu przewidywanemu prawdopodobieństwu.
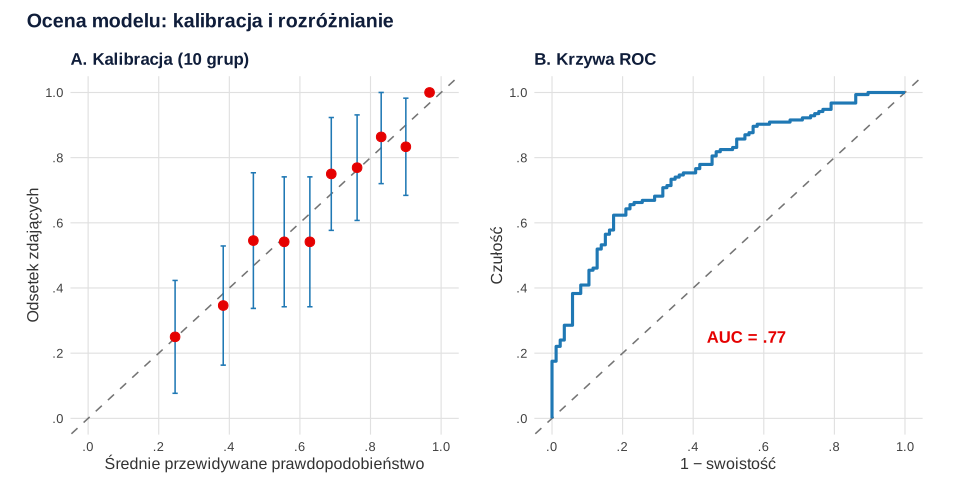
Wszystkie te miary policzono na tych samych danych, na których dopasowano model, więc są zawyżone. Steyerberg i in. (2001) pokazali, że ocena modelu na próbie, na której go zbudowano, przecenia jego trafność, a do korekty zalecają bootstrap, który daje stabilniejsze oszacowania niż podział próby na dwie części. Ma to znaczenie, gdy celem jest predykcja; gdy celem jest opis związków, wystarczy uczciwie nazwać miary „pozornymi”.
Jak opisać regresję logistyczną w pracy (APA)
W rozdziale wyników podaj: liczebność i liczbę zdarzeń, sposób kodowania zmiennej zależnej i predyktorów, test całego modelu, jedną miarę pseudo-R², a dla każdego predyktora b, SE, statystykę Walda lub z, p, OR i 95% CI dla OR. Peng i in. (2002) zalecają też informację o sprawdzeniu założeń i o trafności predykcji. Wyniki najwygodniej zebrać w tabeli. Wzór i plik Word znajdziesz w haśle tabela regresji logistycznej w APA, a ogólne zasady – w poradniku tabele APA – wzory i przykłady.
Tabela 1
Regresja logistyczna: predyktory zdania egzaminu ze statystyki w pierwszym terminie
| Predyktor | B | SE | Wald | p | OR | 95% CI dla OR | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | 2.60 | 0.70 | 13.84 | < .001 | 13.50 | 3.57 | 56.00 |
| Lęk przed statystyką (1–5) | −1.24 | 0.24 | 27.52 | < .001 | 0.29 | 0.18 | 0.45 |
| Godziny nauki tygodniowo | 0.26 | 0.06 | 18.99 | < .001 | 1.30 | 1.16 | 1.48 |
| Konsultacje (1 = tak) | 1.21 | 0.40 | 9.15 | .002 | 3.35 | 1.57 | 7.59 |
Uwaga. N = 240 (dane symulowane). Zmienna zależna: zdanie egzaminu (1; n = 154) wobec niezdania (0; n = 86). Model: χ2(3) = 57.19, p < .001; R2 Nagelkerkego = .29; AUC = .77, 95% CI [.71, .83]; test Hosmera–Lemeshowa χ2(8) = 4.07, p = .851. OR = iloraz szans; Wald = statystyka Walda z 1 stopniem swobody; 95% CI dla OR z profilu funkcji wiarygodności; LL i UL – dolna i górna granica przedziału ufności.
Jeśli liczysz model w SPSS, kolumna B to współczynnik b, Exp(B) to iloraz szans, a statystyka Walda to kwadrat statystyki z podawanej przez R (np. 5.25² = 27.52 dla lęku).
Więcej gotowych zdań do innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA. Jeśli Twój model ma więcej predyktorów, interakcje albo problem z separacją i potrzebujesz pomocy w jego doborze lub interpretacji, zajrzyj do oferty analiz statystycznych dla studentów – wyjaśnimy wyniki tak, abyś umiał(a) je samodzielnie obronić.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik regresja-logistyczna-dane-przyklad.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2–4 korzystają z obiektów dane, m0 i m1 z przepisu 1. Potrzebne pakiety: pROC, car, brglm2 i detectseparation.
1. Model, test ilorazu wiarygodności i ilorazy szans
R
# Regresja logistyczna: zdanie egzaminu ze statystyki (1 = tak) a lęk, godziny nauki i konsultacje (dane symulowane)
options(width = 110)
dane <- read.csv("regresja-logistyczna-dane-przyklad.csv")

# Opis próby
c(N = nrow(dane), zdalo = sum(dane$zdal), proc_zdalo = round(100 * mean(dane$zdal), 1))
round(sapply(dane[, c("lek", "godziny")], function(x) c(M = mean(x), SD = sd(x))), 2)
round(100 * tapply(dane$zdal, dane$konsultacje, mean), 1)        # % zdających: bez konsultacji (0) i z nimi (1)

# Model zerowy i pełny; test ilorazu wiarygodności (χ²)
m0 <- glm(zdal ~ 1, family = binomial, data = dane)
m1 <- glm(zdal ~ lek + godziny + konsultacje, family = binomial, data = dane)
anova(m0, m1, test = "LRT")

# Współczynniki: b, SE, z (Wald), p; Wald w zapisie SPSS = z²; OR = exp(b) z przedziałem profilowym
wsp <- summary(m1)$coefficients
ci <- exp(confint(m1))                              # 95% CI z profilu funkcji wiarygodności
tabela <- data.frame(b = wsp[, 1], SE = wsp[, 2], z = wsp[, 3], Wald = wsp[, 3]^2, p = wsp[, 4],
                     OR = exp(wsp[, 1]), OR_dolna = ci[, 1], OR_gorna = ci[, 2])
cbind(round(tabela[, 1:4], 2), p = round(tabela$p, 3), round(tabela[, 6:8], 2))

# Iloraz szans dla zmiany o więcej niż jedną jednostkę: +5 godzin nauki i +1 SD lęku
round(c(OR_5_godzin = exp(5 * coef(m1)[["godziny"]]), OR_1SD_leku = exp(sd(dane$lek) * coef(m1)[["lek"]])), 2)
Wynik w R
         N      zdalo proc_zdalo
     240.0      154.0       64.2
    lek godziny
M  2.94    5.86
SD 0.75    3.55
   0    1
60.9 73.8
Analysis of Deviance Table

Model 1: zdal ~ 1
Model 2: zdal ~ lek + godziny + konsultacje
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       239     313.18
2       236     255.99  3   57.185 2.346e-12 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                b   SE     z  Wald     p    OR OR_dolna OR_gorna
(Intercept)  2.60 0.70  3.72 13.84 0.000 13.50     3.57    56.00
lek         -1.24 0.24 -5.25 27.52 0.000  0.29     0.18     0.45
godziny      0.26 0.06  4.36 18.99 0.000  1.30     1.16     1.48
konsultacje  1.21 0.40  3.02  9.15 0.002  3.35     1.57     7.59
OR_5_godzin OR_1SD_leku
       3.75        0.40
2. Prawdopodobieństwa przewidywane i efekty krańcowe
R
# Prawdopodobieństwa przewidywane i przeciętne efekty krańcowe (kontynuacja przepisu 1: obiekty dane i m1)
options(width = 110)

# 1. Prawdopodobieństwo zdania dla kilku profili studentów (z 95% CI liczonym na skali logitu)
profile <- data.frame(lek = c(2.2, 3.7, 3.7, 3.7), godziny = c(6, 2, 6, 6), konsultacje = c(0, 0, 0, 1),
                      row.names = c("niski lęk, 6 h", "wysoki lęk, 2 h", "wysoki lęk, 6 h", "wysoki lęk, 6 h, konsultacje"))
pr <- predict(m1, newdata = profile, type = "link", se.fit = TRUE)
round(cbind(profile, p = plogis(pr$fit), dolna = plogis(pr$fit - 1.96 * pr$se.fit),
            gorna = plogis(pr$fit + 1.96 * pr$se.fit)), 3)

# 2. Ten sam OR, różne zmiany prawdopodobieństwa: +1 godzina nauki przy różnym punkcie wyjścia
p_start <- c(.20, .50, .80)
p_po <- plogis(qlogis(p_start) + coef(m1)[["godziny"]])
round(rbind(p_przed = p_start, p_po = p_po, roznica_pp = 100 * (p_po - p_start)), 3)
# OR = 2 przy wyjściowym prawdopodobieństwie .50: nowe prawdopodobieństwo i ryzyko względne
round(c(p_po = plogis(qlogis(.50) + log(2)), RR = plogis(qlogis(.50) + log(2)) / .50), 3)

# 3. Przeciętne efekty krańcowe (AME): średnia zmiana przewidywanego prawdopodobieństwa w próbie
ame_ciagly <- function(zm, h = 1e-4) {
  d1 <- dane; d1[[zm]] <- d1[[zm]] + h
  mean((predict(m1, d1, type = "response") - predict(m1, dane, type = "response")) / h)
}
d_tak <- transform(dane, konsultacje = 1); d_nie <- transform(dane, konsultacje = 0)
ame <- c(lek = ame_ciagly("lek"), godziny = ame_ciagly("godziny"),
         konsultacje = mean(predict(m1, d_tak, type = "response") - predict(m1, d_nie, type = "response")))
round(100 * ame, 1)                                   # w punktach procentowych
round(coef(m1)[-1] / 4 * 100, 1)                     # „reguła dzielenia przez 4”: górna granica efektu w pp
Wynik w R
                             lek godziny konsultacje     p dolna gorna
niski lęk, 6 h               2.2       6           0 0.813 0.723 0.879
wysoki lęk, 2 h              3.7       2           0 0.191 0.108 0.315
wysoki lęk, 6 h              3.7       6           0 0.405 0.297 0.522
wysoki lęk, 6 h, konsultacje 3.7       6           1 0.695 0.537 0.817
            [,1]  [,2]  [,3]
p_przed    0.200 0.500 0.800
p_po       0.246 0.566 0.839
roznica_pp 4.562 6.567 3.896
 p_po    RR
0.667 1.333
        lek     godziny konsultacje
      -22.3         4.8        20.0
        lek     godziny konsultacje
      -30.9         6.6        30.2
3. Ocena modelu: pseudo-R², klasyfikacja, AUC i kalibracja
R
# Ocena modelu: pseudo-R², klasyfikacja, AUC, test Hosmera–Lemeshowa i kalibracja (kontynuacja: dane, m0, m1)
options(width = 110)
suppressPackageStartupMessages(library(pROC))    # roc(), ci.auc()
p_hat <- fitted(m1); y <- dane$zdal; n <- nrow(dane)

# 1. Pseudo-R²: McFadden, Cox–Snell, Nagelkerke, Tjur
ll0 <- as.numeric(logLik(m0)); ll1 <- as.numeric(logLik(m1))
cox_snell <- 1 - exp(2 * (ll0 - ll1) / n)
round(c(McFadden = 1 - ll1 / ll0, Cox_Snell = cox_snell, Nagelkerke = cox_snell / (1 - exp(2 * ll0 / n)),
        Tjur = mean(p_hat[y == 1]) - mean(p_hat[y == 0])), 3)

# 2. Tabela klasyfikacji przy progu .50
pred <- as.integer(p_hat >= .50)
table(przewidywane = pred, obserwowane = y)
round(100 * c(trafnosc = mean(pred == y), czulosc = mean(pred[y == 1] == 1), swoistosc = mean(pred[y == 0] == 0),
              trafnosc_bez_modelu = max(mean(y), 1 - mean(y))), 1)

# 3. Pole pod krzywą ROC z 95% CI (metoda DeLonga)
r <- roc(y, p_hat, quiet = TRUE)
round(as.numeric(ci.auc(r)), 3)                     # dolna granica, AUC, górna granica

# 4. Test Hosmera–Lemeshowa (10 grup według decyli przewidywanego prawdopodobieństwa) i kalibracja
grupa <- cut(p_hat, quantile(p_hat, 0:10 / 10), include.lowest = TRUE, labels = FALSE)
obs <- tapply(y, grupa, sum); ocz <- tapply(p_hat, grupa, sum); ng <- tapply(y, grupa, length)
hl <- sum((obs - ocz)^2 / (ocz * (1 - ocz / ng)))
round(c(chi2_HL = hl, df = 8, p = pchisq(hl, 8, lower.tail = FALSE)), 3)
round(data.frame(n = as.vector(ng), przewidywane = as.vector(ocz / ng), obserwowane = as.vector(obs / ng)), 3)
Wynik w R
  McFadden  Cox_Snell Nagelkerke       Tjur
     0.183      0.212      0.291      0.213
            obserwowane
przewidywane   0   1
           0  45  27
           1  41 127
           trafnosc             czulosc           swoistosc trafnosc_bez_modelu
               71.7                82.5                52.3                64.2
[1] 0.714 0.773 0.833
chi2_HL      df       p
  4.067   8.000   0.851
    n przewidywane obserwowane
1  24        0.246       0.250
2  26        0.383       0.346
3  22        0.468       0.545
4  24        0.556       0.542
5  24        0.628       0.542
6  24        0.689       0.750
7  26        0.762       0.769
8  22        0.830       0.864
9  24        0.900       0.833
10 24        0.967       1.000
4. Założenia: liniowość logitu, VIF, wpływ, EPV i separacja
R
# Założenia i diagnostyka: liniowość logitu, współliniowość, obserwacje wpływowe, liczba zdarzeń, separacja
options(width = 110)
suppressPackageStartupMessages({
  library(car)               # vif()
  library(brglm2)            # brglmFit: regresja Firtha
  library(detectseparation)  # metoda detect_separation w glm()
})

# 1. Liniowość logitu – test Boxa–Tidwella: dodajemy x·ln(x); istotny człon oznacza nieliniowość
bt <- glm(zdal ~ lek + godziny + konsultacje + I(lek * log(lek)) + I((godziny + 1) * log(godziny + 1)),
          family = binomial, data = dane)
round(summary(bt)$coefficients[5:6, ], 3)

# 2. Współliniowość
round(vif(m1), 2)

# 3. Obserwacje nietypowe i wpływowe
c(reszty_std_ponad_3 = sum(abs(rstandard(m1)) > 3), max_odl_Cooka = round(max(cooks.distance(m1)), 3))

# 4. Liczba zdarzeń na parametr (rzadsza kategoria wyniku / liczba predyktorów)
c(rzadsza_kategoria = min(table(dane$zdal)), predyktory = 3, EPV = round(min(table(dane$zdal)) / 3, 1))

# 5. Separacja: mała grupa, w której wszyscy z konsultacjami zdali (dane symulowane)
set.seed(1718)
mala <- data.frame(konsultacje = rep(0:1, c(18, 10)), lek = round(rnorm(28, 3, 0.8), 1))
mala$zdal <- ifelse(mala$konsultacje == 1, 1, rbinom(28, 1, .45))
table(mala$konsultacje, mala$zdal)
ml <- suppressWarnings(glm(zdal ~ konsultacje + lek, family = binomial, data = mala))
round(summary(ml)$coefficients, 2)                                    # ogromne b i SE – objaw separacji
glm(zdal ~ konsultacje + lek, family = binomial, data = mala, method = "detect_separation")
mf <- glm(zdal ~ konsultacje + lek, family = binomial, data = mala, method = "brglmFit", type = "AS_mean")
round(cbind(b = coef(mf), SE = sqrt(diag(vcov(mf))), OR = exp(coef(mf))), 2)   # regresja Firtha
Wynik w R
                                    Estimate Std. Error z value Pr(>|z|)
I(lek * log(lek))                      1.161      1.375   0.844    0.399
I((godziny + 1) * log(godziny + 1))    0.288      0.242   1.190    0.234
        lek     godziny konsultacje
       1.20        1.09        1.14
reszty_std_ponad_3      max_odl_Cooka
             0.000              0.045
rzadsza_kategoria        predyktory               EPV
             86.0               3.0              28.7

     0  1
  0 11  7
  1  0 10
            Estimate Std. Error z value Pr(>|z|)
(Intercept)    12.70       6.98    1.82     0.07
konsultacje    24.50    4373.17    0.01     1.00
lek            -4.49       2.40   -1.87     0.06
Implementation: ROI | Solver: lpsolve
Separation: TRUE
Existence of maximum likelihood estimates
(Intercept) konsultacje         lek
          0         Inf           0
0: finite value, Inf: infinity, -Inf: -infinity
                b   SE      OR
(Intercept)  8.70 4.73 6008.53
konsultacje  5.88 2.40  357.43
lek         -3.10 1.61    0.05
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, Article 77. https://doi.org/10.1186/1471-2105-12-77
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- brglm2 (wersja 1.1.1): Kosmidis, I. (2026). brglm2: Bias reduction in generalized linear models [R package]. https://CRAN.R-project.org/package=brglm2
- detectseparation (wersja 0.4.0): Kosmidis, I., Schumacher, D., & Schwendinger, F. (2026). detectseparation: Detect and check for separation and infinite maximum likelihood estimates [R package]. https://doi.org/10.32614/CRAN.package.detectseparation
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w regresji logistycznej
- Interpretowanie OR jak ryzyka względnego („3 razy większe prawdopodobieństwo”). OR mówi o szansach; przy częstym wyniku różnica jest duża.
- Raportowanie samych b albo samych p. Podaj OR z 95% CI, a najlepiej także prawdopodobieństwa przewidywane lub efekty krańcowe.
- OR dla zmiany o „jednostkę”, która nic nie znaczy. Przy skalach o wąskim zakresie (np. 1–5) podaj OR dla 1 SD albo dla sensownej różnicy.
- Sprawdzanie normalności reszt i homoskedastyczności. To założenia regresji liniowej. W logistycznej sprawdzasz liniowość logitu, współliniowość, obserwacje wpływowe, liczbę zdarzeń i separację.
- „Model trafnie klasyfikuje 72% osób” bez punktu odniesienia. Porównaj z trafnością bez modelu (tu 64.2%) i podaj AUC.
- Ignorowanie ostrzeżeń o separacji i interpretowanie OR rzędu milionów. Sprawdź tabelę krzyżową i użyj regresji Firtha.
- Zbyt wiele predyktorów przy małej liczbie zdarzeń i dobór zmiennych metodą krokową na tych samych danych.
- Porównywanie OR między modelami lub grupami jak współczynników regresji liniowej (Mood, 2010).
Jak dobrać analizę, gdy zmienna zależna nie jest dwuwartościowa, pokazujemy we wpisie jak dobrać test statystyczny do hipotezy, a regresję z wynikiem ilościowym – w poradniku regresja wieloraka krok po kroku.
Najczęstsze pytania
Jakie założenia ma regresja logistyczna?
Zmienna zależna musi być dwuwartościowa, obserwacje niezależne, a logit liniowo związany z predyktorami ciągłymi (sprawdzisz to np. testem Boxa–Tidwella). Predyktory nie powinny być silnie współliniowe (VIF), warto sprawdzić obserwacje wpływowe, liczbę osób w rzadszej kategorii wyniku i brak separacji. Regresja logistyczna nie zakłada normalności reszt ani homoskedastyczności.
Czy iloraz szans 2 oznacza dwa razy większe prawdopodobieństwo?
Nie. OR = 2 oznacza dwukrotnie większe szanse, czyli stosunek p/(1 − p). Gdy zdarzenie jest rzadkie, OR jest bliski ryzyku względnemu, ale przy częstym wyniku różnica jest duża – np. wzrost prawdopodobieństwa z .50 do .67 to OR = 2, a ryzyko względne wynosi tylko 1.33. Aby mówić o prawdopodobieństwie, podaj prawdopodobieństwa przewidywane albo efekty krańcowe.
Co oznacza AUC w regresji logistycznej?
AUC to pole pod krzywą ROC: prawdopodobieństwo, że w losowo wybranej parze (osoba ze zdarzeniem i bez niego) model przypisze wyższe przewidywane prawdopodobieństwo osobie ze zdarzeniem. AUC = .50 oznacza brak zdolności rozróżniania, a 1 – rozróżnianie doskonałe. AUC nie mówi nic o kalibracji, czyli o tym, czy przewidywane prawdopodobieństwa zgadzają się z obserwowanymi odsetkami.
Co zrobić, gdy w regresji logistycznej wychodzi ogromny błąd standardowy?
Najczęstsza przyczyna to separacja: predyktor idealnie rozdziela obie kategorie wyniku, np. w jednej grupie wszyscy mają wynik 1. Sprawdź tabelę krzyżową predyktora z wynikiem i użyj regresji z karą Firtha, która daje skończone oszacowania. Inne przyczyny to bardzo mała liczba zdarzeń, rzadkie kategorie predyktora albo silna współliniowość.
Jak przedstawić wyniki regresji logistycznej w tabeli APA?
Dla każdego predyktora podaj B, SE, statystykę Walda (lub z), p, OR i 95% CI dla OR, a w nocie pod tabelą – liczebność i liczbę zdarzeń, kodowanie zmiennej zależnej, test ilorazu wiarygodności całego modelu i jedną miarę pseudo-R² (np. Nagelkerkego), ewentualnie AUC. Przykładową tabelę i wzór w Wordzie znajdziesz w haśle o tabeli regresji logistycznej w APA.
Powiązane hasła
Przeczytaj też
Regresja logistyczna w obrazkach
Prosta MNK na 0/1, krzywa S, logit a prawdopodobieństwo, interakcja w dwóch skalach i separacja – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikRegresja logistyczna – zadania z rozwiązaniami
Dziesięć zadań: szansa i logit, iloraz szans z tabeli i z modelu, prawdopodobieństwo dla osoby, wydruk glm, kontrola zmiennej, klasyfikacja, AUC, pseudo-R² i LRT – krok po kroku.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Masz w pracy regresję logistyczną i nie wiesz, jak ją opisać?
Sprawdzimy założenia i dopasowanie modelu, przeliczymy wyniki na zrozumiałe prawdopodobieństwa i wyjaśnimy je tak, abyś umiał(a) samodzielnie obronić je przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- Peng, C.-Y. J., Lee, K. L., & Ingersoll, G. M. (2002). An introduction to logistic regression analysis and reporting. The Journal of Educational Research, 96(1), 3–14. https://doi.org/10.1080/00220670209598786
- Riley, R. D., Snell, K. I. E., Ensor, J., Burke, D. L., Harrell, F. E., Jr., Moons, K. G. M., & Collins, G. S. (2019). Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes. Statistics in Medicine, 38(7), 1276–1296. https://doi.org/10.1002/sim.7992 ● Otwarty dostęp
- Sperandei, S. (2014). Understanding logistic regression analysis. Biochemia Medica, 24(1), 12–18. https://doi.org/10.11613/bm.2014.003 ● Otwarty dostęp
- Steyerberg, E. W., Harrell, F. E., Borsboom, G. J. J. M., Eijkemans, M. J. C., Vergouwe, Y., & Habbema, J. D. F. (2001). Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis. Journal of Clinical Epidemiology, 54(8), 774–781. https://doi.org/10.1016/s0895-4356(01)00341-9
- Szumilas, M. (2010). Explaining odds ratios. Journal of the Canadian Academy of Child and Adolescent Psychiatry, 19(3), 227–229. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/ ● Otwarty dostęp
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{peng2002introduction, author={Peng, Chao-Ying Joanne and Lee, Kuk Lida and Ingersoll, Gary M.}, title={{An introduction to logistic regression analysis and reporting}}, journal={The Journal of Educational Research}, year={2002}, volume={96}, number={1}, pages={3--14}, doi={10.1080/00220670209598786}}@article{riley2019minimum, author={Riley, Richard D. and Snell, Kym I. E. and Ensor, Joie and Burke, Danielle L. and Harrell, Frank E., Jr. and Moons, Karel G. M. and Collins, Gary S.}, title={{Minimum sample size for developing a multivariable prediction model: PART II – Binary and time-to-event outcomes}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={7}, pages={1276--1296}, doi={10.1002/sim.7992}}@article{sperandei2014understanding, author={Sperandei, Sandro}, title={{Understanding logistic regression analysis}}, journal={Biochemia Medica}, year={2014}, volume={24}, number={1}, pages={12--18}, doi={10.11613/bm.2014.003}}@article{steyerberg2001internal, author={Steyerberg, Ewout W. and Harrell, Frank E. and Borsboom, Gerard J. J. M. and Eijkemans, Marinus J. C. and Vergouwe, Yvonne and Habbema, J. Dik F.}, title={{Internal validation of predictive models: Efficiency of some procedures for logistic regression analysis}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={8}, pages={774--781}, doi={10.1016/s0895-4356(01)00341-9}}@article{szumilas2010explaining, author={Szumilas, Magdalena}, title={{Explaining odds ratios}}, journal={Journal of the Canadian Academy of Child and Adolescent Psychiatry}, year={2010}, volume={19}, number={3}, pages={227--229}, url={https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2938757/}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}