Czym jest CB-SEM i kiedy odpowiada na Twoje pytanie
CB-SEM (ang. covariance-based structural equation modeling) to odmiana modelowania równań strukturalnych, w której model jest hipotezą o tym, jak powstały wariancje i kowariancje zmiennych obserwowanych. Program szuka takich wartości parametrów, by macierz kowariancji odtworzona z modelu była jak najbliższa macierzy z próby. Jöreskog (1969) opisał tę logikę dla konfirmacyjnej analizy czynnikowej: dowolne parametry można ustalić, pozostałe oszacować metodą największej wiarygodności, a dopasowanie ocenić testem chi-kwadrat. Ta sama zasada obowiązuje w pełnym modelu z częścią pomiarową i strukturalną.
Z tej definicji wynikają trzy praktyczne konsekwencje. Po pierwsze, CB-SEM testuje model, więc ma sens tam, gdzie masz teorię przewidującą, które ścieżki istnieją, a które nie. Po drugie, zakłada model wspólnego czynnika: konstrukt jest przyczyną odpowiedzi na pozycje, jak w modelu refleksyjnym (szczegóły w poradniku model refleksyjny czy formatywny). Po trzecie, ocenia się go globalnie (czy model jako całość odtwarza dane) i lokalnie (gdzie się myli). Jeśli Twój cel jest głównie predykcyjny albo konstrukty są indeksami, rozważ PLS-SEM – porównanie obu podejść znajdziesz w poradniku PLS-SEM czy CB-SEM, a mapę całej rodziny metod w przewodniku modelowanie równań strukturalnych (SEM).
Ten tekst jest przewodnikiem po decyzjach: założeniach, identyfikacji, wyborze estymatora, ocenie dopasowania i interpretacji. Kompletny przykład z kodem lavaan krok po kroku opisujemy w osobnym poradniku CB-SEM w R.
Specyfikacja: model jako zestaw hipotez
Każda strzałka i każdy jej brak w modelu to hipoteza. Ładunek ustalony na zero mówi, że pozycja nie mierzy danego konstruktu; brak ścieżki między konstruktami mówi, że po uwzględnieniu pozostałych nie ma między nimi bezpośredniego związku. Dlatego zanim cokolwiek oszacujesz, narysuj wykres ścieżkowy i zapisz, z jakiej teorii wynika każda strzałka.
Anderson i Gerbing (1988) zalecają podejście dwuetapowe: najpierw oceń i ewentualnie popraw model pomiarowy (CFA), a dopiero potem model strukturalny, porównując serię modeli zagnieżdżonych. Dzięki temu nie mylisz problemów z pomiarem z problemami z teorią. Przy okazji zaplanuj z góry modele alternatywne: model bez ścieżki bezpośredniej, model z dodatkową ścieżką, model jednoczynnikowy zamiast dwuczynnikowego. Porównanie modeli zaplanowanych jest dużo mocniejszym argumentem niż ocena jednego modelu.
Pamiętaj też o kowariancjach reszt, które wynikają ze schematu badania – na przykład między tymi samymi pozycjami mierzonymi w dwóch falach albo między pozycjami odwróconymi. Wpisz je do modelu z góry, zamiast czekać, aż „podpowie” je program.
Założenia CB-SEM
Założenia CB-SEM dotyczą trzech poziomów: modelu, danych i próby.
| Założenie | Co oznacza | Jak sprawdzić lub co zrobić |
|---|---|---|
| Poprawna specyfikacja | model zawiera ścieżki, które istnieją w populacji | teoria, modele alternatywne, ocena lokalnego dopasowania |
| Model wspólnego czynnika | konstrukty są przyczynami wskaźników | kryteria pojęciowe; dla indeksów – kompozyty albo PLS-SEM |
| Liniowość związków | ścieżki opisują związki liniowe | wykresy rozrzutu wyników skal, analiza reszt |
| Rozkład wielowymiarowy normalny (dla ML) | wpływa na błędy standardowe i test χ² | skośność i kurtoza pozycji; estymatory odporne (MLR) |
| Skala pomiaru | ML traktuje wskaźniki jak zmienne ciągłe | przy 2–4 kategoriach odpowiedzi: WLSMV; przy 5+ zwykle MLR |
| Niezależność obserwacji | osoby nie są zagnieżdżone w grupach | dane z klas, zespołów, par – model wielopoziomowy |
| Braki danych losowe (MAR) | braki zależą od zmiennych obserwowanych | FIML zamiast usuwania przypadków |
| Wystarczająca liczebność | zbieżność, dopuszczalne rozwiązanie, moc | symulacja lub analiza mocy dla RMSEA |
Dwa założenia wymagają komentarza. Braki danych są w ankietach regułą, a usunięcie wszystkich osób z choćby jednym brakiem potrafi zmniejszyć próbę o jedną trzecią. Enders i Bandalos (2001) porównali w symulacji metody postępowania z brakami w SEM: pełna informacja największej wiarygodności (FIML) dawała przy brakach MCAR i MAR nieobciążone i najbardziej efektywne oszacowania oraz najmniej problemów ze zbieżnością. Więcej o mechanizmach braków w haśle braki danych MCAR, MAR i MNAR.
Liczebność próby to najczęstsze pytanie recenzentów i jednocześnie dziedzina najbardziej obciążona regułami kciuka („co najmniej 200 osób”, „10 osób na parametr”). Wolf i in. (2013) w serii symulacji typowych modeli SEM otrzymali wymagane liczebności od 30 do 460 osób – zależnie od liczby wskaźników i czynników, wielkości ładunków i ścieżek oraz braków danych – i pokazali ograniczenia popularnych reguł. Wniosek: liczebność uzasadniaj dla swojego modelu, np. analizą mocy opisaną niżej.
Identyfikacja: czy model w ogóle da się oszacować
Model jest zidentyfikowany, gdy jego parametry mają jednoznaczne wartości wynikające z macierzy kowariancji. Pierwszy krok to reguła t: liczba szacowanych parametrów nie może przekraczać liczby niezależnych informacji, czyli p(p + 1)/2 wariancji i kowariancji dla p zmiennych obserwowanych. Różnica to stopnie swobody modelu.
Reguła t jest warunkiem koniecznym, ale nie wystarczającym. Dodatkowo każda zmienna ukryta musi mieć ustaloną skalę: ładunek pierwszego wskaźnika równy 1 albo wariancję czynnika równą 1. Tabela pokazuje, jak wygląda bilans dla kilku prostych modeli CFA (dane symulowane, N = 300).
| Model | Wskaźniki (p) | Informacje | Parametry | df | Status |
|---|---|---|---|---|---|
| Jeden czynnik, 2 wskaźniki | 2 | 3 | 4 | −1 | niezidentyfikowany |
| Jeden czynnik, 3 wskaźniki | 3 | 6 | 6 | 0 | dokładnie zidentyfikowany – nie da się ocenić dopasowania |
| Dwa skorelowane czynniki po 2 wskaźniki | 4 | 10 | 9 | 1 | zidentyfikowany, ale tylko dzięki korelacji czynników |
| Dwa skorelowane czynniki po 3 wskaźniki | 6 | 21 | 13 | 8 | nadmiernie zidentyfikowany |
Trzeci wiersz ilustruje identyfikację empiryczną. Formalnie model ma df = 1, ale jego identyfikacja zależy od tego, czy korelacja czynników jest wyraźnie różna od zera. Gdy w drugiej symulowanej próbie korelacje między pozycjami obu czynników wynosiły od −.08 do .07, optymalizator zgłosił, że nie znalazł rozwiązania, ładunek drugiej pozycji drugiego czynnika „uciekł” do 385.86, a błędów standardowych nie dało się policzyć. Model był poprawny na papierze i niemożliwy do oszacowania na tych danych.
Bollen i Davis (2009) przypominają, że testy identyfikacji wbudowane w programy sprawdzają tylko identyfikację lokalną na podstawie oszacowań z próby, i podają dwie reguły: regułę co najmniej dwóch ścieżek wychodzących (warunek konieczny, ważny zwłaszcza dla konstruktów ze wskaźnikami przyczynowymi) i regułę egzogenicznego X (warunek wystarczający). W praktyce: planuj co najmniej trzy dobre wskaźniki na konstrukt, a jeśli program ostrzega o macierzy informacji, ujemnych wariancjach (przypadek Heywooda) lub braku zbieżności, zacznij od sprawdzenia identyfikacji, a nie od zmiany estymatora.
Estymatory: ML, MLR, WLSMV i inne
Domyślnym estymatorem CB-SEM jest metoda największej wiarygodności (ML). Zakłada wielowymiarowy rozkład normalny; gdy dane są skośne lub mają grube ogony, same oszacowania parametrów zwykle się nie psują, ale błędne stają się błędy standardowe i test χ². Curran i in. (1996) pokazali w symulacji CFA, że zwykła statystyka χ² rośnie wraz z odstępstwem od normalności, a przeskalowana statystyka Satorry–Bentlera nie jest obciążona przy żadnej badanej liczebności.
| Estymator | Kiedy | Uwagi |
|---|---|---|
| ML | dane ciągłe, w przybliżeniu normalne | punkt odniesienia; przy brakach danych z FIML |
| MLR (lub MLM) | dane ciągłe lub pozycje z 5 i więcej kategoriami, skośne | odporne błędy standardowe i przeskalowany χ²; MLR działa z FIML |
| WLSMV | pozycje porządkowe z 2–4 kategoriami | oparty na korelacjach polichorycznych; inne indeksy dopasowania niż ML |
| GLS | rzadko zalecany | przy błędnej specyfikacji daje zbyt optymistyczne dopasowanie |
| ADF (WLS) | bardzo duże próby | niestabilny w próbach typowych dla psychologii |
| ML z bootstrapem | efekty pośrednie, nietypowe rozkłady | przedziały percentylowe; zob. bootstrap w SEM |
Przy pozycjach typu Likerta decyzję ułatwia symulacja, którą przeprowadzili Rhemtulla i in. (2012). Kategorialna metoda najmniejszych kwadratów dokładniej szacowała ładunki, zwłaszcza przy mniej niż pięciu kategoriach, a odporny ML równie dobrze oceniał korelacje czynników i dopasowanie. Autorzy zalecają metody kategorialne przy mniej niż pięciu kategoriach, a odporny ML przy pięciu i więcej, małej próbie i w przybliżeniu symetrycznych progach. Jeśli porównujesz modele zagnieżdżone oszacowane MLR, pamiętaj, że różnica dwóch przeskalowanych statystyk nie jest poprawną statystyką testu – trzeba ją przeliczyć według specjalnej formuły, którą programy (np. lavTestLRT() w lavaan) stosują automatycznie (zob. test różnicy chi-kwadrat w SEM).
Ocena dopasowania bez polowania na progi
Dopasowanie ocenia się na dwóch poziomach. Globalnie sprawdzasz, czy model jako całość odtwarza macierz kowariancji: test χ² (w AMOS CMIN) oraz indeksy przybliżonego dopasowania – CFI, TLI, RMSEA z 90% przedziałem ufności i SRMR. Lokalnie szukasz miejsc, w których model się myli: w macierzy reszt i w indeksach modyfikacji.
Najczęściej cytowane wartości odcięcia pochodzą od Hu i Bentlera (1999): CFI i TLI bliskie .95, SRMR około .08, RMSEA około .06, raportowane łącznie. Marsh i in. (2004) przestrzegają jednak przed traktowaniem ich jak „złotych reguł”: w tych samych symulacjach wiele modeli z błędami specyfikacji miało dopasowanie akceptowalne nawet według nowych kryteriów, a indeksy lepiej sprawdzały się przy porównywaniu modeli zagnieżdżonych niż przy ocenie pojedynczego modelu.
Sprawdźmy to na symulacji. Model ma trzy skorelowane czynniki po cztery wskaźniki (ładunki .70). W wersji poprawnej dane pochodzą z dokładnie takiego modelu. W wersji z błędem w populacji istnieją dwa dodatkowe parametry, których badacz nie uwzględnia: ładunek krzyżowy jednej pozycji (.30) i kowariancja reszt dwóch innych (.20). Dla każdej liczebności (150, 300, 600 i 1200 osób) wylosowaliśmy po 250 prób.
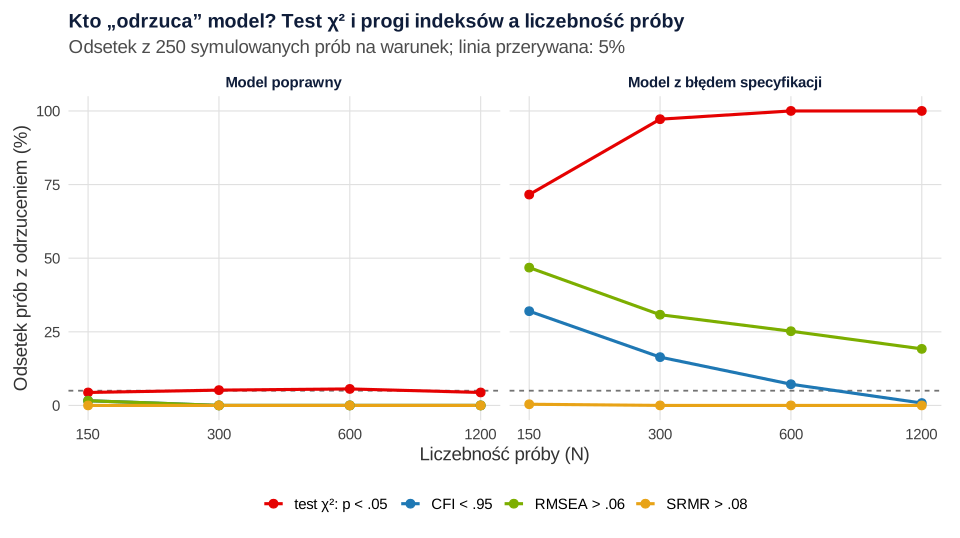
Wyniki dobrze pokazują, czym różnią się oba narzędzia. Dla modelu poprawnego test χ² odrzucał go w 4.4–5.6% prób, czyli tak często, jak powinien przy α = .05, a progi indeksów – prawie nigdy. Dla modelu z błędem test χ² odrzucał go w 71.6% prób przy 150 osobach i w 100% przy 600 i 1200 osobach. Progi indeksów zachowywały się odwrotnie: im większa próba, tym rzadziej sygnalizowały błąd. CFI poniżej .95 pojawiało się w 32.0% prób przy N = 150, ale tylko w 0.8% przy N = 1200, bo mediana CFI (.960–.966) leżała tuż powyżej progu. SRMR przekroczył .08 tylko w 0.4% prób.
Czy ten błąd ma znaczenie? W bardzo dużej próbie (N = 200 000) błędny model miał CFI = .964, TLI = .953, RMSEA = .056 i SRMR = .038 – według progów Hu i Bentlera dopasowanie „dobre”. Jednocześnie korelacja dwóch czynników, którą populacyjnie ustaliliśmy na .40, została oszacowana jako .521, bo pominięty ładunek krzyżowy „przepłynął” do korelacji. Dobre indeksy nie gwarantują nieobciążonych parametrów, które interpretujesz.
Co z tego wynika w praktyce:
- Zawsze raportuj test χ² z df i p. Gdy odrzuca model w dużej próbie, nie zbywaj go zdaniem „χ² jest wrażliwy na liczebność” – sprawdź, skąd bierze się niedopasowanie.
- Traktuj progi jako opis, nie werdykt. Podawaj RMSEA z 90% CI i interpretuj go razem z df: przy małej liczbie stopni swobody i małej próbie RMSEA bywa bardzo niestabilny.
- Szukaj niedopasowania lokalnie. Saris i in. (2009) proponują łączyć indeks modyfikacji z oczekiwaną zmianą parametru (EPC) i mocą testu MI, bo sam globalny indeks nie mówi, jak duży jest błąd specyfikacji ani gdzie leży. Reszty korelacyjne powyżej około .10 to dobre miejsce, by zacząć.
- Jeśli używasz lavaan 0.7, zauważ, że
gfito nowa wersja indeksu GFI z przedziałem ufności, a klasyczny GFI znany z AMOS i LISREL nazywa sięgfi_lisrel. Przegląd wszystkich indeksów i ich ograniczeń zawiera hasło GFI, a gotowy układ tabeli – tabela dopasowania modelu w APA.
Moc i liczebność próby
MacCallum i in. (1996) zaproponowali analizę mocy opartą na RMSEA: wielkość efektu to para wartości RMSEA (dla hipotezy zerowej i alternatywnej), a moc zależy od liczebności i liczby stopni swobody. Przykład: chcesz wykazać, że model nie jest „zły” (H0: RMSEA = .05, H1: RMSEA = .08) przy α = .05.
| df modelu | Moc przy N = 200 | Moc przy N = 420 | N dla mocy .80 |
|---|---|---|---|
| 8 | .257 | .469 | 953 |
| 24 | .510 | .847 | – |
| 61 | .836 | .995 | 185 |
Mały model z 8 stopniami swobody potrzebuje aż 953 osób, by z mocą .80 odróżnić dopasowanie bliskie od złego, a model z 61 stopniami swobody – 185 osób. Dlatego „mały, prosty model” wcale nie musi wymagać mniejszej próby. Analiza mocy RMSEA dotyczy jednak tylko globalnego dopasowania. Jeśli Twoja hipoteza dotyczy konkretnej ścieżki albo efektu pośredniego, policz moc dla tego parametru metodą symulacyjną (Wolf i in., 2013). Szerzej o uzasadnianiu liczebności piszemy w poradniku dobór liczebności próby.
Interpretacja parametrów
W wyniku CB-SEM dostajesz trzy wersje każdego parametru: niestandaryzowaną (w jednostkach zmiennych), standaryzowaną względem zmiennych ukrytych i w pełni standaryzowaną. Ścieżki strukturalne zwykle raportuje się w obu wersjach: b z błędem standardowym i przedziałem ufności oraz β. Ładunki – w wersji standaryzowanej. R² każdej zmiennej endogenicznej mówi, jaką część jej wariancji wyjaśnia model.
Najważniejsza zasada interpretacji brzmi: dobrze dopasowany model nie dowodzi kierunku strzałek. Modele równoważne dają identyczne dopasowanie przy zupełnie innych założeniach przyczynowych. W symulowanym przykładzie (N = 350) przeciążenie pracą (X), wyczerpanie (M) i zamiar odejścia z pracy (Y) połączyliśmy na trzy sposoby: X → M → Y, Y → M → X oraz M jako wspólna przyczyna X i Y. Wszystkie trzy modele miały ten sam wynik testu, χ²(1) = 0.64, p = .423, i te same standaryzowane ścieżki (.544 i .459), choć opowiadają trzy różne historie. Wybór między nimi rozstrzyga teoria i schemat badania (kolejność pomiarów, manipulacja eksperymentalna), a nie dopasowanie.
Dlatego w danych przekrojowych pisz o „związkach zgodnych z modelem”, a nie o „wpływie”. Przy efektach pośrednich podawaj przedział bootstrapowy i pamiętaj, że mediacja w danych z jednego pomiaru to model hipotetyczny – praktyczny przykład opisuje poradnik analiza mediacji krok po kroku.
Modyfikacje modelu: kiedy wolno, a kiedy nie
Indeksy modyfikacji pokazują, o ile spadłby χ² po uwolnieniu jednego parametru. Kuszą, bo kilka „poprawek” potrafi zamienić przeciętne dopasowanie w świetne. Każda taka zmiana to jednak decyzja podjęta na podstawie tych samych danych, które mają model testować. Zasady bezpiecznego postępowania:
- Dodawaj tylko parametry, które da się uzasadnić treścią pozycji lub schematem badania (np. podobne sformułowanie dwóch pozycji, ten sam wskaźnik w dwóch falach).
- Zmieniaj model po jednym parametrze i sprawdzaj EPC – duży MI przy małej EPC to często efekt dużej próby, nie poważny błąd.
- Zgłoś każdą modyfikację i oba modele: wyjściowy i końcowy. Model po modyfikacjach ma status eksploracyjny i wymaga potwierdzenia w nowej próbie.
- Nie dodawaj kowariancji reszt między pozycjami różnych konstruktów tylko po to, by poprawić indeksy – zmieniasz w ten sposób znaczenie konstruktów.
Co musi zawierać raport CB-SEM
Standardy JARS-Quant Amerykańskiego Towarzystwa Psychologicznego mają osobny moduł dla modelowania równań strukturalnych (Appelbaum i in., 2018). Na jego podstawie i na podstawie typowych uwag recenzentów warto sprawdzić, czy raport zawiera:
- uzasadnienie modelu i modeli alternatywnych, najlepiej z wykresem ścieżkowym;
- opis identyfikacji (sposób skalowania czynników, liczbę stopni swobody);
- liczebność, braki danych i sposób ich obsługi, rozkłady pozycji;
- estymator z uzasadnieniem i nazwę programu z wersją;
- test χ² z df i p, CFI, TLI, RMSEA z 90% CI i SRMR – oraz informację o lokalnym dopasowaniu;
- wszystkie ładunki i ścieżki z błędami standardowymi lub przedziałami ufności, R², korelacje czynników;
- listę modyfikacji z uzasadnieniem;
- macierz korelacji (lub kowariancji) z odchyleniami standardowymi w materiałach dodatkowych, by inni mogli odtworzyć analizę.
Wzór krótkiego opisu oceny modelu w sekcji wyników – z liczbami z przykładu w poradniku CB-SEM w R (dane symulowane, N = 420):
Ogólne zasady zapisu wyników znajdziesz w poradniku jak opisać wyniki w stylu APA, a typowe uwagi recenzentów do modeli SEM – w tekście o zarzutach recenzentów do statystyki.
Najczęstsze błędy w CB-SEM
- Brak teorii dla modelu. CB-SEM bez hipotez o tym, których ścieżek nie ma, staje się wyszukiwaniem dobrze dopasowanego modelu.
- Progi jako kryterium zaliczenia. CFI = .951 nie znaczy, że model jest poprawny, a CFI = .948 – że jest błędny.
- Ignorowanie testu χ². Istotny χ² w dużej próbie wymaga sprawdzenia reszt, a nie tylko komentarza o liczebności.
- Wskaźniki formatywne w modelu refleksyjnym. Indeksy zachowań czy zdarzeń wymagają innego modelu pomiaru.
- Estymator niedopasowany do danych. ML dla pozycji z trzema kategoriami albo dla wyraźnie skośnych danych daje błędne p i przedziały.
- Usuwanie osób z brakami. FIML zwykle daje lepsze wyniki niż usuwanie przypadków.
- Nieopisane modyfikacje. Każda dodana kowariancja reszt i każdy usunięty wskaźnik muszą być w raporcie.
- Język przyczynowy. Model równoważny z odwróconymi strzałkami pasuje do danych równie dobrze.
Jeśli przygotowujesz artykuł z modelem SEM i potrzebujesz drugiej pary oczu przy specyfikacji, wyborze estymatora albo odpowiedzi na uwagi recenzentów, zajrzyj do oferty analiz dla badaczy.
Przykład w R
Kod odtwarza wszystkie liczby z tego przewodnika. Bloki kodu są domyślnie zwinięte – rozwiń je, gdy chcesz sprawdzić obliczenia. Pełny przykład analizy krok po kroku znajdziesz w poradniku o CB-SEM w pakiecie lavaan.
1. Identyfikacja: reguła t i identyfikacja empiryczna
R
# P3, przepis 1: identyfikacja – reguła t, stopnie swobody i identyfikacja empiryczna (dane symulowane)
library(lavaan)
set.seed(303)
pop <- '
  F1 =~ 0.7*x1 + 0.7*x2 + 0.7*x3
  F2 =~ 0.7*y1 + 0.7*y2 + 0.7*y3
  F1 ~~ 0.4*F2
'
d <- simulateData(pop, sample.nobs = 300, standardized = TRUE)

# Liczba informacji p(p + 1)/2 i stopnie swobody dla czterech modeli
info <- function(p) p * (p + 1) / 2
modele <- list(
  jeden_czynnik_2_wskazniki  = 'F1 =~ x1 + x2',
  jeden_czynnik_3_wskazniki  = 'F1 =~ x1 + x2 + x3',
  dwa_czynniki_po_2          = 'F1 =~ x1 + x2
                                F2 =~ y1 + y2',
  dwa_czynniki_po_3          = 'F1 =~ x1 + x2 + x3
                                F2 =~ y1 + y2 + y3')
wyniki <- t(sapply(modele, function(m) {
  f <- suppressWarnings(cfa(m, data = d))
  p <- length(lavNames(f, "ov"))
  c(wskazniki = p, informacje = info(p), parametry = unname(fitMeasures(f, "npar")), df = unname(fitMeasures(f, "df")))
}))
wyniki
# Model z dwoma wskaźnikami na czynnik jest identyfikowany tylko dzięki korelacji czynników.
# Identyfikacja empiryczna: gdy korelacja czynników jest bliska zera, model „rozpada się”.
pop0 <- sub("0.4\\*F2", "0*F2", pop)
d0 <- simulateData(pop0, sample.nobs = 300, standardized = TRUE)
f0 <- tryCatch(cfa(modele$dwa_czynniki_po_2, data = d0), warning = function(w) conditionMessage(w))
f0
f0b <- suppressWarnings(cfa(modele$dwa_czynniki_po_2, data = d0))
pe0 <- parameterEstimates(f0b)[c(1:4, 9), c("lhs", "op", "rhs", "est", "se")]
pe0[, 4:5] <- round(pe0[, 4:5], 3); pe0
round(cor(d0)[c("x1", "x2", "y1", "y2"), c("x1", "x2", "y1", "y2")], 2)
Wynik w R
                          wskazniki informacje parametry df
jeden_czynnik_2_wskazniki         2          3         4 -1
jeden_czynnik_3_wskazniki         3          6         6  0
dwa_czynniki_po_2                 4         10         9  1
dwa_czynniki_po_3                 6         21        13  8
[1] "lavaan->lav_step11_estoptim():  \n   the optimizer warns that a solution has NOT been found!"
  lhs op rhs     est se
1  F1 =~  x1   1.000  0
2  F1 =~  x2   2.087 NA
3  F2 =~  y1   1.000  0
4  F2 =~  y2 385.860 NA
9  F1 ~~  F1   0.231 NA
     x1    x2    y1   y2
x1 1.00  0.51  0.02 0.06
x2 0.51  1.00 -0.08 0.07
y1 0.02 -0.08  1.00 0.51
y2 0.06  0.07  0.51 1.00
2. Symulacja: test χ² i progi indeksów a liczebność próby
R
# P3, przepis 2: jak często test χ² i progi indeksów odrzucają model poprawny i model z błędem specyfikacji
# Symulacja: 3 czynniki × 4 wskaźniki, ładunki .70, korelacje czynników .30–.50 (dane symulowane)
library(lavaan)
set.seed(3003)
pop_wspolna <- '
  A =~ 0.7*a1 + 0.7*a2 + 0.7*a3 + 0.7*a4
  B =~ 0.7*b1 + 0.7*b2 + 0.7*b3 + 0.7*b4
  C =~ 0.7*c1 + 0.7*c2 + 0.7*c3 + 0.7*c4
  A ~~ 0.4*B
  A ~~ 0.3*C
  B ~~ 0.5*C
'
# Model z błędem: w populacji jest ładunek krzyżowy a4 na B (.30) i kowariancja reszt b3–b4 (.20),
# a badacz szacuje czysty model trzyczynnikowy
pop_blad <- paste(pop_wspolna, 'B =~ 0.3*a4
  b3 ~~ 0.2*b4')
model <- '
  A =~ a1 + a2 + a3 + a4
  B =~ b1 + b2 + b3 + b4
  C =~ c1 + c2 + c3 + c4
'
N <- c(150, 300, 600, 1200); R <- 250
jedna <- function(pop, n) {
  d <- simulateData(pop, sample.nobs = n, standardized = TRUE)
  f <- cfa(model, data = d)
  if (!lavInspect(f, "converged")) return(rep(NA, 4))
  fitMeasures(f, c("pvalue", "cfi", "rmsea", "srmr"))
}
wyniki <- do.call(rbind, lapply(c(poprawny = pop_wspolna, z_bledem = pop_blad), function(pop) {
  do.call(rbind, lapply(N, function(n) {
    m <- t(replicate(R, jedna(pop, n)))
    data.frame(n = n,
               chi2_odrzuca = mean(m[, "pvalue"] < .05, na.rm = TRUE),
               CFI_ponizej_95 = mean(m[, "cfi"] < .95, na.rm = TRUE),
               RMSEA_powyzej_06 = mean(m[, "rmsea"] > .06, na.rm = TRUE),
               SRMR_powyzej_08 = mean(m[, "srmr"] > .08, na.rm = TRUE),
               CFI_mediana = median(m[, "cfi"], na.rm = TRUE),
               RMSEA_mediana = median(m[, "rmsea"], na.rm = TRUE),
               SRMR_mediana = median(m[, "srmr"], na.rm = TRUE))
  }))
}))
wyniki$model <- rep(c("poprawny", "z bledem"), each = length(N))
wyniki[, 2:8] <- round(wyniki[, 2:8], 3)
wyniki
write.csv(wyniki, "kod/p3-dopasowanie-symulacja.csv", row.names = FALSE)

# Wartości bliskie populacyjnym dla modelu z błędem: jedna bardzo duża próba (N = 200 000)
d_duza <- simulateData(pop_blad, sample.nobs = 200000, standardized = TRUE)
f_duza <- cfa(model, data = d_duza)
round(fitMeasures(f_duza, c("cfi", "tli", "rmsea", "srmr")), 3)
s_duza <- standardizedSolution(f_duza)
round(s_duza$est.std[s_duza$op == "~~" & s_duza$lhs == "A" & s_duza$rhs == "B"], 3)   # korelacja A–B (prawdziwa .40)
Wynik w R
              n chi2_odrzuca CFI_ponizej_95 RMSEA_powyzej_06 SRMR_powyzej_08
poprawny.1  150        0.044          0.016            0.016           0.000
poprawny.2  300        0.052          0.000            0.000           0.000
poprawny.3  600        0.056          0.000            0.000           0.000
poprawny.4 1200        0.044          0.000            0.000           0.000
z_bledem.1  150        0.716          0.320            0.468           0.004
z_bledem.2  300        0.972          0.164            0.308           0.000
z_bledem.3  600        1.000          0.072            0.252           0.000
z_bledem.4 1200        1.000          0.008            0.192           0.000
           CFI_mediana RMSEA_mediana SRMR_mediana    model
poprawny.1       1.000         0.006        0.047 poprawny
poprawny.2       1.000         0.005        0.034 poprawny
poprawny.3       1.000         0.000        0.024 poprawny
poprawny.4       1.000         0.000        0.017 poprawny
z_bledem.1       0.960         0.058        0.060 z bledem
z_bledem.2       0.964         0.055        0.050 z bledem
z_bledem.3       0.966         0.055        0.044 z bledem
z_bledem.4       0.963         0.057        0.042 z bledem
  cfi   tli rmsea  srmr
0.964 0.953 0.056 0.038
[1] 0.521
3. Modele równoważne i moc testu RMSEA
R
# P3, przepis 3: modele równoważne i moc testu dopasowania opartego na RMSEA
library(lavaan)
set.seed(3333)
# Dane symulowane: przeciążenie pracą (X) -> wyczerpanie (M) -> zamiar odejścia z pracy (Y), N = 350
pop <- '
  M ~ 0.5*X
  Y ~ 0.45*M + 0.05*X
'
d <- simulateData(pop, sample.nobs = 350, standardized = TRUE)
m_przod  <- 'M ~ X
             Y ~ M'          # X -> M -> Y
m_tyl    <- 'M ~ Y
             X ~ M'          # Y -> M -> X (odwrócony kierunek)
m_wspolna <- 'X ~ M
              Y ~ M
              X ~~ 0*Y'      # M jako wspólna przyczyna X i Y
fity <- lapply(list(przod = m_przod, tyl = m_tyl, wspolna_przyczyna = m_wspolna), sem, data = d)
t(sapply(fity, function(f) round(fitMeasures(f, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)))
lapply(fity, function(f) { s <- standardizedSolution(f); s <- s[s$op == "~", c("lhs", "op", "rhs", "est.std")]; s$est.std <- round(s$est.std, 3); s })

# Moc testu bliskiego dopasowania (MacCallum i in., 1996): H0 RMSEA = .05, H1 RMSEA = .08
library(semTools)
round(findRMSEApower(rmsea0 = .05, rmseaA = .08, df = c(8, 24, 61), n = 200), 3)
round(findRMSEApower(rmsea0 = .05, rmseaA = .08, df = c(8, 24, 61), n = 420), 3)
findRMSEAsamplesize(rmsea0 = .05, rmseaA = .08, df = 8, power = .80)
findRMSEAsamplesize(rmsea0 = .05, rmseaA = .08, df = 61, power = .80)
Wynik w R
                  chisq df pvalue cfi rmsea  srmr
przod             0.642  1  0.423   1     0 0.013
tyl               0.642  1  0.423   1     0 0.013
wspolna_przyczyna 0.642  1  0.423   1     0 0.013
$przod
  lhs op rhs est.std
1   M  ~   X   0.544
2   Y  ~   M   0.459

$tyl
  lhs op rhs est.std
1   M  ~   Y   0.459
2   X  ~   M   0.544

$wspolna_przyczyna
  lhs op rhs est.std
1   X  ~   M   0.544
2   Y  ~   M   0.459

[1] 0.257 0.510 0.836
[1] 0.469 0.847 0.995
[1] 953
[1] 185
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i semTools; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym różni się CB-SEM od zwykłej analizy ścieżek?
Analiza ścieżek łączy zmienne obserwowane, np. wyniki skal policzone jako średnie, więc traktuje je jak mierzone bez błędu. CB-SEM łączy model pomiarowy (konstrukty jako zmienne ukryte wyznaczane przez pozycje) z modelem strukturalnym i szacuje związki między konstruktami po uwzględnieniu błędu pomiaru. Analiza ścieżek jest szczególnym przypadkiem SEM, w którym każdy konstrukt ma jeden bezbłędny wskaźnik.
Jak policzyć stopnie swobody w modelu SEM?
Policz liczbę niezależnych informacji, czyli p(p + 1)/2 wariancji i kowariancji dla p zmiennych obserwowanych, i odejmij liczbę szacowanych parametrów (ładunki, wariancje reszt, wariancje i kowariancje czynników, ścieżki). Na przykład 6 wskaźników daje 21 informacji, a model z dwoma skorelowanymi czynnikami po 3 wskaźniki ma 13 parametrów, więc df = 8. Model z df < 0 nie jest zidentyfikowany, a z df = 0 nie pozwala ocenić dopasowania.
Czy istotny test chi-kwadrat oznacza, że model SEM jest zły?
Oznacza, że model nie odtwarza dokładnie macierzy kowariancji w populacji, ale nie mówi, jak duże jest niedopasowanie ani gdzie leży. W dużych próbach test wykrywa także drobne błędy specyfikacji, które mogą mieć jednak znaczenie dla parametrów. Zamiast go pomijać, sprawdź reszty korelacyjne i indeksy modyfikacji z oczekiwaną zmianą parametru i oceń, czy niedopasowanie da się wyjaśnić treścią pozycji.
Jakie wartości CFI i RMSEA są wystarczające w CB-SEM?
Najczęściej cytuje się CFI i TLI bliskie .95, RMSEA około .06 i SRMR około .08 (Hu i Bentler, 1999), ale nie są to uniwersalne granice. Zależą od liczby zmiennych, wielkości ładunków, liczebności próby i estymatora, a modele z błędami specyfikacji często je spełniają. Raportuj wszystkie indeksy razem z testem χ² i RMSEA z 90% przedziałem ufności i uzupełnij je oceną lokalnego dopasowania.
Kiedy w CB-SEM wybrać estymator MLR, a kiedy WLSMV?
MLR wybierz dla zmiennych ciągłych albo pozycji typu Likerta z co najmniej pięcioma kategoriami, gdy rozkłady są skośne lub masz braki danych (MLR działa z FIML). WLSMV jest przeznaczony dla pozycji porządkowych z dwiema do czterech kategorii i opiera się na korelacjach polichorycznych. Przy pięciu i więcej kategoriach oraz w przybliżeniu symetrycznych rozkładach oba podejścia zwykle dają podobne wnioski o strukturze.
Powiązane hasła
Przeczytaj też
CB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM)
Model pomiarowy i strukturalny, rodzaje modeli SEM, CB-SEM czy PLS-SEM, symulacja w R i etapy analizy od teorii do raportu.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →Przygotowujesz artykuł z modelem SEM?
Pomożemy dobrać specyfikację i estymator, przeprowadzić analizę w R i przygotować opis wyników, który odpowie na typowe pytania recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Bollen, K. A., & Davis, W. R. (2009). Two rules of identification for structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 523–536. https://doi.org/10.1080/10705510903008261
- Curran, P. J., West, S. G., & Finch, J. F. (1996). The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis. Psychological Methods, 1(1), 16–29. https://doi.org/10.1037/1082-989x.1.1.16
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- MacCallum, R. C., Browne, M. W., & Sugawara, H. M. (1996). Power analysis and determination of sample size for covariance structure modeling. Psychological Methods, 1(2), 130–149. https://doi.org/10.1037/1082-989X.1.2.130
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Saris, W. E., Satorra, A., & van der Veld, W. M. (2009). Testing structural equation models or detection of misspecifications? Structural Equation Modeling: A Multidisciplinary Journal, 16(4), 561–582. https://doi.org/10.1080/10705510903203433 ● Otwarty dostęp: pełny tekst
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{anderson1988structural, author={Anderson, James C. and Gerbing, David W.}, title={{Structural equation modeling in practice: A review and recommended two-step approach}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={411--423}, doi={10.1037/0033-2909.103.3.411}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{bollen2009two, author={Bollen, Kenneth A. and Davis, Walter R.}, title={{Two rules of identification for structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={3}, pages={523--536}, doi={10.1080/10705510903008261}}@article{curran1996robustness, author={Curran, Patrick J. and West, Stephen G. and Finch, John F.}, title={{The robustness of test statistics to nonnormality and specification error in confirmatory factor analysis}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={16--29}, doi={10.1037/1082-989x.1.1.16}}@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{maccallum1996power, author={MacCallum, Robert C. and Browne, Michael W. and Sugawara, Hazuki M.}, title={{Power analysis and determination of sample size for covariance structure modeling}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={130--149}, doi={10.1037/1082-989x.1.2.130}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@article{saris2009testing, author={Saris, Willem E. and Satorra, Albert and van der Veld, William M.}, title={{Testing structural equation models or detection of misspecifications?}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={4}, pages={561--582}, doi={10.1080/10705510903203433}}@article{wolf2013sample, author={Wolf, Erika J. and Harrington, Kelly M. and Clark, Shaunna L. and Miller, Mark W.}, title={{Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety}}, journal={Educational and Psychological Measurement}, year={2013}, volume={73}, number={6}, pages={913--934}, doi={10.1177/0013164413495237}}