Co to jest CFI?
CFI (ang. Comparative Fit Index, porównawczy indeks dopasowania) to indeks dopasowania modelu w SEM i CFA, który mówi, o ile lepiej twój model odtwarza dane niż model bazowy. Model bazowy (niezależności) zakłada, że wszystkie zmienne są nieskorelowane. CFI przyjmuje wartości od 0 do 1; im bliżej 1, tym większa poprawa względem modelu bazowego. Bentler (1990) zaproponował CFI jako miarę względnego zmniejszenia niecentralności między dwoma modelami zagnieżdżonymi. Indeks miał też naprawić wadę wcześniejszego NFI, który w małych próbach zaniża dopasowanie.
CFI należy do indeksów przyrostowych (porównawczych), tak jak TLI i NFI. Różni się tym od indeksów bezwzględnych, takich jak RMSEA czy SRMR, które oceniają rozbieżność modelu bez punktu odniesienia. To rozróżnienie wyjaśnia większość nieporozumień wokół CFI.
Wzór na CFI
CFI korzysta z tego, że wartość χ² pomniejszona o liczbę stopni swobody szacuje niecentralność, czyli to, jak bardzo model odbiega od danych ponad błąd losowy:
gdzie M oznacza model badany, a B – model bazowy. Licznik to niedopasowanie twojego modelu, mianownik – niedopasowanie modelu, który nie zakłada żadnych związków. Funkcje max() obcinają wynik do przedziału 0–1. Gdy χ²M jest mniejsze od dfM, CFI wynosi dokładnie 1. W przeciwieństwie do TLI CFI nie zawiera kary za złożoność modelu.
Przykład: CFI policzone ręcznie
Czterysta osób (dane symulowane) wypełniło 6-pozycyjną skalę perfekcjonizmu (odpowiedzi 1–7). Pozycje pf1 i pf2 są sformułowane podobnie i mają dodatkową wspólną wariancję, której model jednoczynnikowy nie uwzględnia. Wyniki modelu jednoczynnikowego:
- model badany: χ²M(9) = 46.80;
- model bazowy: χ²B(15) = 692.31 (średnia korelacja pozycji .40);
- niecentralność modelu: 46.80 − 9 = 37.80, modelu bazowego: 692.31 − 15 = 677.30;
- CFI = 1 − 37.80/677.30 = .944.
Model zmniejszył więc niedopasowanie modelu bazowego o 94.4%. Pozostałe indeksy: TLI = .907, RMSEA = .102, SRMR = .046. Po dodaniu uzasadnionej treściowo kowariancji błędów pf1–pf2 dopasowanie się wyrównało: χ²(8) = 6.63, CFI = 1.000, RMSEA = .000, SRMR = .014. Różnica ΔCFI = .056 pokazuje, jak duży był skutek pominięcia jednego parametru.
Jak interpretować CFI: progi i ich ograniczenia
Najczęściej cytowane kryterium pochodzi od Hu i Bentlera (1999): CFI bliskie .95 lub wyższe, oceniane łącznie z drugim indeksem, np. SRMR ≤ .08 albo RMSEA ≤ .06. Starsza konwencja .90 bywa dziś traktowana jako dopasowanie co najwyżej akceptowalne. Progi te mają jednak ograniczenia:
- Marsh i in. (2004) przestrzegają przed traktowaniem ich jak „złotych reguł”. W symulacjach Hu i Bentlera wiele modeli z błędami specyfikacji miało dopasowanie akceptowalne nawet według nowych kryteriów, a indeksy lepiej sprawdzały się w porównywaniu modeli zagnieżdżonych niż w ocenie pojedynczego modelu.
- Kenny i McCoach (2003) pokazali, że przy rosnącej liczbie zmiennych CFI i TLI na ogół się pogarszają, a RMSEA się poprawia. Ta sama wartość CFI znaczy więc co innego w modelu z 6 i z 40 pozycjami.
- Lai i Green (2016) wyjaśniają, dlaczego CFI i RMSEA mogą dawać sprzeczne oceny. Patrzą na tę samą rozbieżność z różnych perspektyw, a ich progi są arbitralne. Rozbieżność nie musi więc wskazywać konkretnego błędu modelu.
Dlaczego CFI zależy od siły korelacji
Ponieważ CFI porównuje model z modelem niezależności, wynik zależy od tego, jak źle pasuje model bazowy. Gdy pozycje korelują słabo, model bazowy pasuje „nieźle”, mianownik jest mały i nawet drobne niedopasowanie mocno obniża CFI. Rysunek 1 pokazuje to na wartościach populacyjnych. Błąd modelu jest zawsze ten sam (pominięta korelacja reszt .25 między dwiema pozycjami), zmienia się tylko siła ładunków.
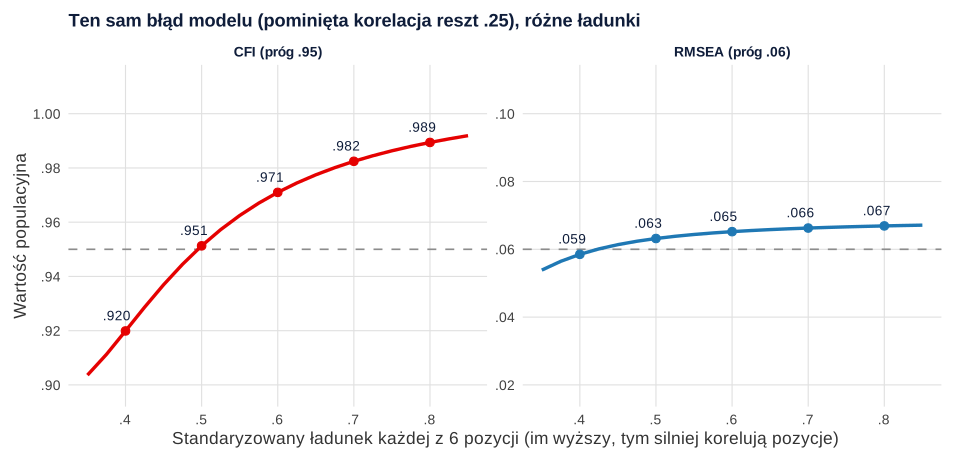
Przy ładunkach .40 (średnia korelacja pozycji .17) CFI wynosi .920 i nie spełnia progu .95. Przy ładunkach .80 (średnia korelacja .65) ten sam błąd daje CFI = .989. RMSEA zmienia się w tym czasie tylko z .059 do .067. Niski CFI przy słabo skorelowanych pozycjach nie musi oznaczać gorszego modelu, a wysoki CFI przy silnych korelacjach nie gwarantuje braku błędów. Dlatego zawsze podawaj kilka indeksów i sprawdzaj reszty.
ΔCFI w porównaniach modeli i inwariancji pomiaru
CFI szczególnie przydaje się do porównywania modeli zagnieżdżonych, bo – w przeciwieństwie do testu różnicy chi-kwadrat – w dużych próbach nie reaguje na każdą drobną różnicę. Cheung i Rensvold (2002) sprawdzili w symulacji 20 indeksów przy testowaniu inwariancji między grupami. Polecili ΔCFI jako miarę niezależną od złożoności modelu i liczebności próby i zaproponowali dla niej wartość krytyczną: spadek CFI o więcej niż .01 po nałożeniu ograniczeń sugeruje brak inwariancji pomiaru.
Wersje CFI w programach
Ten sam model może mieć w wydruku kilka wartości CFI. Przy estymacji ML jest jedna, liczona ze zwykłego χ². Przy estymatorach odpornych, takich jak MLR, lavaan podaje dodatkowo CFI „skalowany” i „odporny” (cfi.robust). Do raportu wybierz wersję odporną, bo uwzględnia ona korektę statystyki testu w obu modelach. Przy pozycjach porządkowych i WLSMV CFI bywa wyraźnie inny niż przy ML na tych samych danych, a progi wyprowadzone w symulacjach dla ML nie przenoszą się wprost na ten estymator. Model bazowy też musi być ten sam: w analizach wielogrupowych i z brakami danych (FIML) programy różnie go definiują, dlatego CFI z dwóch programów może się nieco różnić.
Jak opisać CFI w pracy (APA)
Podaj CFI z trzema miejscami po przecinku albo dwoma (bez zera przed kropką) razem z χ², TLI, RMSEA z 90% CI i SRMR. Napisz, którą wersję raportujesz (zwykłą, skalowaną czy odporną przy MLR) i z jakimi progami porównujesz wyniki.
CFI w R (lavaan)
Kod tworzy dane z przykładu, odczytuje χ² modelu i modelu bazowego, liczy CFI ręcznie, dopasowuje model bazowy osobno, porównuje model z kowariancją błędów (ΔCFI) i liczy populacyjne CFI oraz RMSEA dla tego samego błędu specyfikacji przy różnej sile ładunków. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
CFI ręcznie i wpływ siły korelacji
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 400 osób wypełniło 6-pozycyjną skalę perfekcjonizmu (odpowiedzi 1–7).
# W populacji pozycje pf1 i pf2 mają dodatkowo wspólną wariancję (podobne sformułowanie),
# której model jednoczynnikowy nie uwzględnia.
set.seed(103)
pop <- '
  perfekcjonizm =~ 0.75*pf1 + 0.70*pf2 + 0.68*pf3 + 0.65*pf4 + 0.62*pf5 + 0.60*pf6
  pf1 ~~ 0.18*pf2
'
z <- simulateData(pop, sample.nobs = 400, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.4 * x), 1), 7)))

fit <- cfa('perfekcjonizm =~ pf1 + pf2 + pf3 + pf4 + pf5 + pf6', data = dane)
fm <- fitMeasures(fit, c("chisq", "df", "pvalue", "baseline.chisq", "baseline.df", "cfi", "tli", "rmsea", "srmr"))
round(fm, 3)

# 1. CFI ręcznie: 1 − max(χ²M − dfM, 0) / max(χ²B − dfB, χ²M − dfM, 0)
ncp_m <- max(fm[["chisq"]] - fm[["df"]], 0)
ncp_b <- max(fm[["baseline.chisq"]] - fm[["baseline.df"]], ncp_m, 0)
c(ncp_model = ncp_m, ncp_baseline = ncp_b, CFI = 1 - ncp_m / ncp_b)

# 2. Model bazowy (niezależności): same wariancje, wszystkie kowariancje = 0
fit_b <- cfa('pf1 ~~ pf1
              pf2 ~~ pf2
              pf3 ~~ pf3
              pf4 ~~ pf4
              pf5 ~~ pf5
              pf6 ~~ pf6', data = dane)
round(fitMeasures(fit_b, c("chisq", "df")), 3)
round(mean(cor(dane)[lower.tri(cor(dane))]), 3)          # średnia korelacja pozycji

# 3. Model z kowariancją błędów pf1–pf2 i porównanie (ΔCFI)
fit2 <- cfa('perfekcjonizm =~ pf1 + pf2 + pf3 + pf4 + pf5 + pf6
             pf1 ~~ pf2', data = dane)
round(fitMeasures(fit2, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
round(fitMeasures(fit2, "cfi") - fitMeasures(fit, "cfi"), 3)

# 4. Ten sam błąd specyfikacji (korelacja reszt pf1–pf2 = .25), różna siła ładunków.
#    Wartości populacyjne: F = rozbieżność modelu dopasowanego do macierzy populacyjnej,
#    CFI = 1 − F(model) / F(bazowy), RMSEA = √(F(model) / df). Nie zależą od N.
cfi_pop <- function(lambda, r_reszt = 0.25) {
  L <- matrix(rep(lambda, 6)); S <- L %*% t(L); diag(S) <- 1
  S[1, 2] <- S[2, 1] <- S[1, 2] + r_reszt * (1 - lambda^2)
  dimnames(S) <- list(paste0("pf", 1:6), paste0("pf", 1:6))
  f <- cfa('perfekcjonizm =~ pf1 + pf2 + pf3 + pf4 + pf5 + pf6', sample.cov = S, sample.nobs = 1e5)
  F_m <- fitMeasures(f, "chisq") / 1e5; F_b <- fitMeasures(f, "baseline.chisq") / 1e5
  c(lambda = lambda, sr_korelacja = mean(S[lower.tri(S)]), CFI = unname(1 - F_m / F_b), RMSEA = unname(sqrt(F_m / 9)))
}
tab <- t(sapply(c(0.4, 0.5, 0.6, 0.7, 0.8), cfi_pop))
round(tab, 3)
Wynik w R
         chisq             df         pvalue baseline.chisq    baseline.df
        46.802          9.000          0.000        692.305         15.000
           cfi            tli          rmsea           srmr
         0.944          0.907          0.102          0.046
   ncp_model ncp_baseline          CFI
   37.801715   677.304752     0.944188
  chisq      df
692.305  15.000
[1] 0.403
 chisq     df pvalue    cfi  rmsea   srmr
 6.631  8.000  0.577  1.000  0.000  0.014
  cfi
0.056
     lambda sr_korelacja   CFI RMSEA
[1,]    0.4        0.174 0.920 0.059
[2,]    0.5        0.262 0.951 0.063
[3,]    0.6        0.371 0.971 0.065
[4,]    0.7        0.498 0.982 0.066
[5,]    0.8        0.646 0.989 0.067
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- CFI ≥ .95 jako dowód poprawności modelu. Próg to reguła kciuka, a CFI nie pokazuje, gdzie model nie pasuje.
- Porównywanie CFI modeli o różnej liczbie zmiennych albo z różnymi estymatorami (np. ML i WLSMV) bez komentarza.
- Raportowanie CFI bez χ² i RMSEA. Czytelnik nie oceni wtedy, czy niski CFI wynika ze słabych korelacji pozycji.
- Mylenie CFI z TLI. TLI karze za liczbę parametrów i może przekraczać 1, CFI jest obcięty do zakresu 0–1.
- Zwykły CFI przy estymacji MLR, zamiast wersji odpornej (
cfi.robustw lavaan), której wymaga ta estymacja.
Pełną ocenę dopasowania opisują poradniki CB-SEM krok po kroku i inwariancja pomiaru krok po kroku; zestawienie wyników przygotujesz według wzoru tabeli dopasowania modelu CFA.
Najczęstsze pytania
Jaka wartość CFI oznacza dobre dopasowanie modelu?
Najczęściej za dobre dopasowanie uznaje się CFI ≥ .95 (Hu i Bentler, 1999), a wartości .90–.95 bywają opisywane jako akceptowalne. Progi to reguły kciuka: oceniaj CFI razem z χ², RMSEA i SRMR oraz resztami modelu.
Czym różni się CFI od TLI?
Oba porównują model z modelem bazowym, ale TLI odnosi niedopasowanie do liczby stopni swobody, więc karze za złożoność i może przekraczać 1. CFI używa samej niecentralności (χ² − df) i jest obcięty do zakresu 0–1. Zwykle TLI jest nieco niższy niż CFI, jak w przykładzie (.907 wobec .944).
Dlaczego CFI jest niski, choć RMSEA jest dobre?
Najczęściej dlatego, że zmienne słabo ze sobą korelują: model bazowy pasuje wtedy stosunkowo dobrze, a każde niedopasowanie modelu badanego stanowi dużą część jego niedopasowania. RMSEA nie ma takiego punktu odniesienia, więc oba indeksy mogą dawać różne oceny tego samego modelu.
Jak wykorzystać ΔCFI w analizie inwariancji pomiaru?
Porównaj CFI modelu z ograniczeniami równości (np. równe ładunki w grupach) z CFI modelu mniej ograniczonego. Spadek CFI o więcej niż .01 traktuje się jako sygnał, że ograniczenie nie jest spełnione, czyli że dany poziom inwariancji nie został osiągnięty.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
- Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 9(2), 233–255. https://doi.org/10.1207/s15328007sem0902_5
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Kenny, D. A., & McCoach, D. B. (2003). Effect of the number of variables on measures of fit in structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 10(3), 333–351. https://doi.org/10.1207/s15328007sem1003_1
- Lai, K., & Green, S. B. (2016). The problem with having two watches: Assessment of fit when RMSEA and CFI disagree. Multivariate Behavioral Research, 51(2-3), 220–239. https://doi.org/10.1080/00273171.2015.1134306
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
Cytowania BibTeX
@article{bentler1990comparative, author={Bentler, P. M.}, title={{Comparative fit indexes in structural models}}, journal={Psychological Bulletin}, year={1990}, volume={107}, number={2}, pages={238--246}, doi={10.1037/0033-2909.107.2.238}}@article{cheung2002evaluating, author={Cheung, Gordon W. and Rensvold, Roger B.}, title={{Evaluating goodness-of-fit indexes for testing measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2002}, volume={9}, number={2}, pages={233--255}, doi={10.1207/s15328007sem0902_5}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{kenny2003effect, author={Kenny, David A. and McCoach, D. Betsy}, title={{Effect of the number of variables on measures of fit in structural equation modeling}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2003}, volume={10}, number={3}, pages={333--351}, doi={10.1207/s15328007sem1003_1}}@article{lai2016problem, author={Lai, Keke and Green, Samuel B.}, title={{The problem with having two watches: Assessment of fit when RMSEA and CFI disagree}}, journal={Multivariate Behavioral Research}, year={2016}, volume={51}, number={2-3}, pages={220--239}, doi={10.1080/00273171.2015.1134306}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}