Co to jest identyfikacja modelu SEM?
Identyfikacja modelu (ang. model identification) to warunek, by każdy wolny parametr modelu SEM dało się jednoznacznie wyznaczyć z wariancji i kowariancji zmiennych obserwowalnych (oraz średnich, jeśli model je obejmuje). Model jest niezidentyfikowany, gdy różne zestawy parametrów odtwarzają dane równie dobrze. Program nie ma wtedy podstaw, by wybrać jeden z nich. Identyfikacja to własność modelu, a nie danych. Sprawdzasz ją przed analizą, na etapie rysowania wykresu ścieżkowego.
Zwykle wyróżnia się trzy sytuacje:
- model niedoidentyfikowany (underidentified) – parametrów jest więcej niż informacji albo część parametrów nie daje się rozdzielić. Oszacowania nie są jednoznaczne;
- model dokładnie zidentyfikowany (just-identified) – parametrów jest tyle, ile informacji; df = 0, χ² = 0. Model odtwarza dane idealnie, więc jego dopasowania nie da się sprawdzić;
- model nadidentyfikowany (overidentified) – informacji jest więcej niż parametrów; df > 0. Tylko taki model można testować wskaźnikami dopasowania.
Reguła t: policz informacje i parametry
Pierwszy krok to porównanie liczby niepowtarzalnych elementów macierzy kowariancji z liczbą wolnych parametrów t. Dla p zmiennych obserwowalnych:
Dla jednego czynnika z wariancją ustaloną na 1 każdy wskaźnik dodaje dwa parametry (ładunek i wariancję reszty):
| Liczba wskaźników | Informacje p(p + 1)/2 | Parametry | df | Status |
|---|---|---|---|---|
| 2 | 3 | 4 | −1 | niedoidentyfikowany |
| 3 | 6 | 6 | 0 | dokładnie zidentyfikowany |
| 4 | 10 | 8 | 2 | nadidentyfikowany |
| 5 | 15 | 10 | 5 | nadidentyfikowany |
| 6 | 21 | 12 | 9 | nadidentyfikowany |
Reguła t jest konieczna, ale niewystarczająca. Model może mieć dodatnie stopnie swobody, a mimo to zawierać fragment, którego nie da się oszacować. Dlatego stosuje się dodatkowe reguły dla typowych modeli.
Reguły identyfikacji w praktyce
- Skala każdej zmiennej latentnej. Zmienna ukryta nie ma własnej jednostki. Ustal ją, przyjmując jeden ładunek równy 1 (zmienna markerowa, domyślnie w lavaan) albo wariancję czynnika równą 1 (
std.lv = TRUE). Oba sposoby dają ten sam model: to samo χ², te same df i te same ładunki standaryzowane. - Reguła trzech wskaźników (model pomiarowy): jeśli każdy czynnik ma co najmniej trzy wskaźniki, każdy wskaźnik ładuje tylko jeden czynnik, a reszty są nieskorelowane, model jest zidentyfikowany.
- Reguła dwóch wskaźników: czynnik z dwoma wskaźnikami jest zidentyfikowany tylko w modelu z innymi czynnikami, z którymi koreluje (co najmniej jedna kowariancja różna od zera).
- Część strukturalna: modele rekurencyjne (bez pętli zwrotnych i bez skorelowanych zakłóceń) są zidentyfikowane. Dla modeli nierekurencyjnych Rigdon (1995) podał graficzną regułę, która jest warunkiem koniecznym i wystarczającym dla najczęściej szacowanych modeli blokowo-rekurencyjnych.
- Zmienne formatywne: Bollen i Davis (2009) dowodzą, że zmienna ze wskaźnikami przyczynowymi musi mieć co najmniej dwie ścieżki wychodzące (reguła 2+ emitted paths). MacCallum i Browne (1993) opisali problemy z identyfikacją, które powodują takie zmienne (zob. formatywna zmienna latentna, model MIMIC).
- Modele wielogrupowe i porządkowe: identyfikacja wymaga ustaleń także dla średnich i progów. Wu i Estabrook (2016) pokazali, że przy pozycjach porządkowych same warunki identyfikacji działają jak ograniczenia inwariancji (zob. inwariancja pomiaru w CB-SEM).
Programy SEM sprawdzają też identyfikację empirycznie, na podstawie macierzy informacji. Bollen i Davis (2009) przypominają jednak, że takie testy sprawdzają tylko identyfikację lokalną i opierają się na oszacowaniach z próby. Dlatego regułami warto posłużyć się jeszcze przed analizą.
Przykład: samoocena szkolna i społeczna
300 osób (dane symulowane) wypełniło po cztery pozycje samooceny szkolnej (sz1–sz4) i społecznej (sp1–sp4). Kolejne modele w lavaan pokazują wszystkie trzy sytuacje.
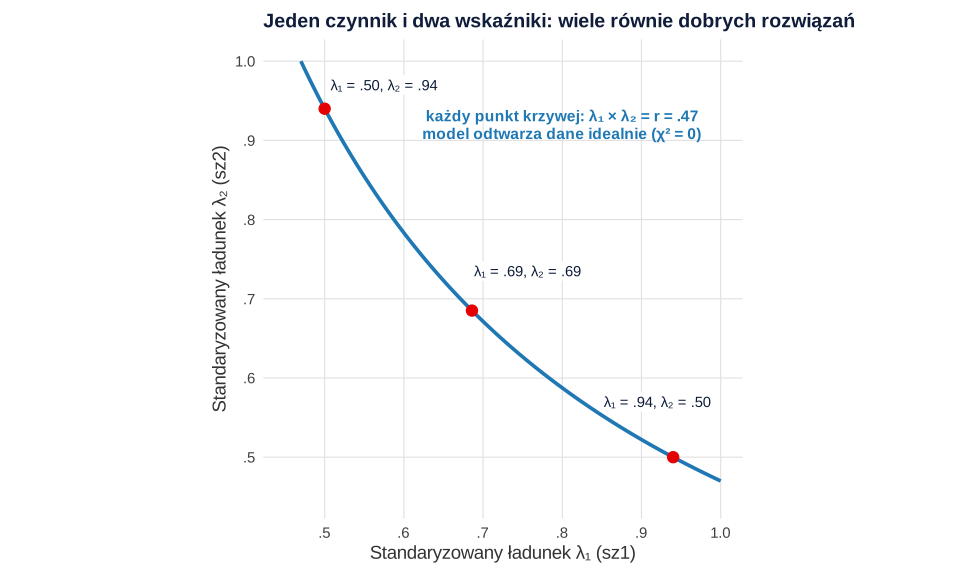
- Jeden czynnik, dwie pozycje (sz1, sz2): df = −1. lavaan ostrzega, że nie może odwrócić macierzy informacji, i nie podaje błędów standardowych. Korelacja pozycji wynosi r = .47 i jest jedyną informacją o ładunkach. Każda para ładunków o iloczynie .47 – np. .50 i .94 albo .69 i .69 – odtwarza ją idealnie (rysunek 1).
- Jeden czynnik, trzy pozycje: 6 parametrów, 6 informacji, χ² = 0, df = 0. Ładunki da się oszacować, ale nie ma czego testować.
- Cztery pozycje bez ustalonej skali (wszystkie ładunki i wariancja czynnika wolne): 9 parametrów i ponownie brak błędów standardowych. Po ustaleniu skali dowolnym sposobem: χ²(2) = 2.75, a standaryzowane ładunki (.69, .72, .67, .74) są identyczne w obu wersjach.
- Dwa czynniki po dwie pozycje: 9 parametrów, df = 1. Model jest zidentyfikowany dzięki korelacji czynników (.38, SE = 0.08), a ładunki mają rozsądne błędy standardowe (0.095–0.116).
Identyfikacja empiryczna: model poprawny w teorii, problem w danych
Model dwóch czynników po dwie pozycje jest zidentyfikowany tylko wtedy, gdy czynniki naprawdę korelują. W drugiej próbie 300 osób (dane symulowane) korelacja czynników w populacji wynosiła 0. Ten sam model dał wtedy ostrzeżenie optymalizatora, że nie znaleziono rozwiązania. Oszacowania były absurdalne – ładunek sp1 = 29.13 przy korelacji czynników −.002 – a błędów standardowych nie było. To empiryczna niedoidentyfikowalność. Model jest formalnie poprawny, ale wartość parametru bliska zeru usuwa informację potrzebną do identyfikacji. Podobne kłopoty powodują ładunki bliskie zera albo prawie współliniowe predyktory. Objawami bywają też ujemne wariancje (przypadek Heywooda) i brak zbieżności.
Jak opisać identyfikację w pracy
W części metodologicznej wystarczy jedno lub dwa zdania. Napisz, jak ustalono skalę zmiennych latentnych, ile stopni swobody ma model i na jakiej regule opiera się identyfikacja, gdy model jest nietypowy. Wzór:
Liczbę stopni swobody i parametrów odczytasz w lavaan z fitMeasures(model, c("npar", "df")). Liczby we wzorze dotyczą modelu dwóch czynników samooceny po cztery pozycje z przykładu (ostatni fragment kodu). Więcej o budowie i testowaniu całych modeli znajdziesz we wpisach CB-SEM krok po kroku i modelowanie równań strukturalnych: od teorii do raportu.
Przykład w R
Kod liczy regułę t dla 2–6 wskaźników i pokazuje w lavaan modele niedoidentyfikowane, dokładnie zidentyfikowane i nadidentyfikowane. Porównuje też dwa sposoby ustalania skali i odtwarza przypadek empirycznej niedoidentyfikowalności. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Identyfikacja modeli CFA w lavaan
R
# Identyfikacja modelu SEM: reguła t, skalowanie czynnika, identyfikacja empiryczna (lavaan)
library(lavaan)

# 1. Reguła t: liczba informacji p(p+1)/2 vs liczba wolnych parametrów (1 czynnik, wariancja = 1)
k <- 2:6
data.frame(wskazniki = k, informacje = k * (k + 1) / 2, parametry = 2 * k, df = k * (k + 1) / 2 - 2 * k)

# Dane symulowane: 300 osób, dwa czynniki samooceny (szkolna i społeczna), pozycje 1–5 standaryzowane
set.seed(112)
gen <- function(n, r) {
  f <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, r, r, 1), 2))
  l <- c(.75, .70, .65, .70)
  x <- cbind(sapply(l, function(a) a * f[, 1] + sqrt(1 - a^2) * rnorm(n)),
             sapply(l, function(a) a * f[, 2] + sqrt(1 - a^2) * rnorm(n)))
  colnames(x) <- c(paste0("sz", 1:4), paste0("sp", 1:4)); as.data.frame(x)
}
dane <- gen(300, r = .45)

# 2. Jeden czynnik, dwa wskaźniki: df = −1, model niezidentyfikowany
f2 <- try(cfa('F =~ sz1 + sz2', data = dane), silent = TRUE)
cat("Dwa wskaźniki:", if (inherits(f2, "try-error")) conditionMessage(attr(f2, "condition")) else
  paste("df =", fitMeasures(f2, "df")), "\n")

# 3. Trzy wskaźniki: model dokładnie zidentyfikowany (df = 0, chi2 = 0, nic nie testujemy)
f3 <- cfa('F =~ sz1 + sz2 + sz3', data = dane)
round(fitMeasures(f3, c("npar", "chisq", "df")), 3)

# 4. Brak skalowania: wszystkie ładunki i wariancja czynnika wolne
f_bez <- cfa('F =~ NA*sz1 + sz2 + sz3 + sz4', data = dane)
cat("Bez skali: npar =", fitMeasures(f_bez, "npar"), "\n")
# Dwa poprawne sposoby skalowania dają ten sam model (te same chi2 i df, te same ładunki standaryzowane)
f_marker <- cfa('F =~ sz1 + sz2 + sz3 + sz4', data = dane)                       # ładunek sz1 = 1
f_std    <- cfa('F =~ sz1 + sz2 + sz3 + sz4', data = dane, std.lv = TRUE)        # wariancja F = 1
round(rbind(marker = fitMeasures(f_marker, c("chisq", "df")), std_lv = fitMeasures(f_std, c("chisq", "df"))), 3)
round(cbind(marker = standardizedSolution(f_marker)$est.std[1:4], std_lv = standardizedSolution(f_std)$est.std[1:4]), 3)

# 5. Dwa czynniki po dwa wskaźniki: formalnie zidentyfikowany (df = 1), jeśli czynniki są skorelowane
m22 <- 'szkolna =~ sz1 + sz2
        spoleczna =~ sp1 + sp2'
f22 <- cfa(m22, data = dane, std.lv = TRUE)
round(fitMeasures(f22, c("npar", "df")), 0)
pe <- parameterEstimates(f22)
print(pe[pe$op %in% c("=~", "~~") & pe$lhs != pe$rhs | pe$op == "=~", c("lhs", "op", "rhs", "est", "se")], digits = 2, row.names = FALSE)

# 6. Identyfikacja empiryczna: ten sam model, gdy w populacji czynniki są nieskorelowane
set.seed(1120)
dane0 <- gen(300, r = 0)
f22_0 <- cfa(m22, data = dane0, std.lv = TRUE)
pe0 <- parameterEstimates(f22_0)
print(pe0[pe0$op == "=~" | (pe0$op == "~~" & pe0$lhs != pe0$rhs), c("lhs", "op", "rhs", "est", "se")], digits = 2, row.names = FALSE)

# 7. Dla rysunku: przy dwóch wskaźnikach każda para ładunków o iloczynie r(sz1, sz2) pasuje idealnie
r12 <- cor(dane$sz1, dane$sz2); round(r12, 3)

# 8. Typowy model do opisu w pracy: dwa czynniki po cztery pozycje, wariancje czynników = 1
f44 <- cfa('szkolna =~ sz1 + sz2 + sz3 + sz4
            spoleczna =~ sp1 + sp2 + sp3 + sp4', data = dane, std.lv = TRUE)
c(informacje = 8 * 9 / 2, round(fitMeasures(f44, c("npar", "df")), 0))
Wynik w R
  wskazniki informacje parametry df
1         2          3         4 -1
2         3          6         6  0
3         4         10         8  2
4         5         15        10  5
5         6         21        12  9
Warning message:
lavaan->lav_model_vcov():
   Could not compute standard errors! The information matrix could not be
   inverted. This may be a symptom that the model is not identified.
Dwa wskaźniki: df = -1
 npar chisq    df
    6     0     0
Warning message:
lavaan->lav_model_vcov():
   Could not compute standard errors! The information matrix could not be
   inverted. This may be a symptom that the model is not identified.
Bez skali: npar = 9
       chisq df
marker 2.747  2
std_lv 2.747  2
     marker std_lv
[1,]  0.692  0.692
[2,]  0.718  0.718
[3,]  0.670  0.670
[4,]  0.736  0.736
npar   df
   9    1
       lhs op       rhs  est    se
   szkolna =~       sz1 0.79 0.116
   szkolna =~       sz2 0.61 0.096
 spoleczna =~       sp1 0.61 0.095
 spoleczna =~       sp2 0.78 0.112
   szkolna ~~ spoleczna 0.38 0.083
Warning message:
lavaan->lav_step11_estoptim():
   the optimizer warns that a solution has NOT been found!
       lhs op       rhs    est se
   szkolna =~       sz1  0.576 NA
   szkolna =~       sz2  0.947 NA
 spoleczna =~       sp1 29.132 NA
 spoleczna =~       sp2  0.019 NA
   szkolna ~~ spoleczna -0.002 NA
[1] 0.47
informacje       npar         df
        36         17         19
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Brak ustalonej skali czynnika, np. po zapisie
NA*dla pierwszego ładunku bezstd.lv = TRUE. Model traci identyfikację, choć wygląda poprawnie. - Czynnik z dwoma wskaźnikami jako jedyny w modelu albo nieskorelowany z innymi. Dodaj trzeci wskaźnik albo osadź czynnik w większym modelu.
- Interpretowanie modelu z df = 0 jako „idealnie dopasowanego”. χ² = 0 i CFI = 1 są tu automatyczne, a nie dowodem trafności teorii.
- Dokładanie kowariancji reszt i ładunków krzyżowych „do skutku”. Każdy nowy parametr zmniejsza df i może zniszczyć identyfikację (zob. kowariancja reszt w SEM, indeksy modyfikacji).
- Ignorowanie ostrzeżeń. Komunikat o macierzy informacji, brak zbieżności, ujemne wariancje albo ogromne błędy standardowe to sygnały problemu z identyfikacją, często empirycznego.
- Mylenie identyfikacji z dopasowaniem. Model zidentyfikowany może być źle dopasowany, a dobrze dopasowany model dokładnie zidentyfikowany niczego nie testuje.
Najczęstsze pytania
Co to znaczy, że model SEM jest niedoidentyfikowany?
Że ma więcej wolnych parametrów niż informacji w danych albo część parametrów nie daje się rozdzielić, więc wiele różnych zestawów wartości odtwarza dane tak samo dobrze. Program nie poda wtedy jednoznacznych oszacowań, a lavaan zwykle ostrzega, że nie może policzyć błędów standardowych.
Jak policzyć stopnie swobody modelu SEM?
Odejmij liczbę wolnych parametrów od liczby niepowtarzalnych elementów macierzy kowariancji, p(p + 1)/2. Dla ośmiu zmiennych jest 36 elementów; model dwóch czynników po cztery pozycje z wariancjami czynników równymi 1 ma 17 parametrów, czyli 19 stopni swobody.
Ile wskaźników musi mieć czynnik w CFA?
Bezpiecznie – co najmniej trzy. Czynnik z trzema wskaźnikami jest sam w sobie dokładnie zidentyfikowany, z czterema i więcej – nadidentyfikowany. Czynnik z dwoma wskaźnikami jest zidentyfikowany tylko w modelu z innym czynnikiem, z którym wyraźnie koreluje.
Czy model z zerowymi stopniami swobody jest dobry?
Nie da się tego ocenić. Przy df = 0 model odtwarza dane idealnie z definicji: χ² = 0, CFI = 1 i RMSEA = 0. Wskaźniki dopasowania niczego wtedy nie testują, więc o jakości modelu świadczą tylko teoria i sensowność oszacowań.
Co to jest empiryczna niedoidentyfikowalność?
Sytuacja, w której model jest zidentyfikowany w teorii, ale w konkretnych danych parametr potrzebny do identyfikacji jest bliski zera, np. korelacja czynników mających po dwa wskaźniki. Objawy to brak zbieżności, absurdalne oszacowania, ujemne wariancje i brak błędów standardowych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM): od teorii do raportu
SEM bez skrótów myślowych: model pomiarowy i strukturalny, CB-SEM a PLS-SEM, dopasowanie, założenia oraz raportowanie wyników.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Davis, W. R. (2009). Two rules of identification for structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 523–536. https://doi.org/10.1080/10705510903008261
- MacCallum, R. C., & Browne, M. W. (1993). The use of causal indicators in covariance structure models: Some practical issues. Psychological Bulletin, 114(3), 533–541. https://doi.org/10.1037/0033-2909.114.3.533
- Rigdon, E. E. (1995). A necessary and sufficient identification rule for structural models estimated in practice. Multivariate Behavioral Research, 30(3), 359–383. https://doi.org/10.1207/s15327906mbr3003_4
- Wu, H., & Estabrook, R. (2016). Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes. Psychometrika, 81(4), 1014–1045. https://doi.org/10.1007/s11336-016-9506-0 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bollen2009two, author={Bollen, Kenneth A. and Davis, Walter R.}, title={{Two rules of identification for structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={3}, pages={523--536}, doi={10.1080/10705510903008261}}@article{maccallum1993use, author={MacCallum, Robert C. and Browne, Michael W.}, title={{The use of causal indicators in covariance structure models: Some practical issues}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={533--541}, doi={10.1037/0033-2909.114.3.533}}@article{rigdon1995necessary, author={Rigdon, Edward E.}, title={{A necessary and sufficient identification rule for structural models estimated in practice}}, journal={Multivariate Behavioral Research}, year={1995}, volume={30}, number={3}, pages={359--383}, doi={10.1207/s15327906mbr3003_4}}@article{wu2016identification, author={Wu, Hao and Estabrook, Ryne}, title={{Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes}}, journal={Psychometrika}, year={2016}, volume={81}, number={4}, pages={1014--1045}, doi={10.1007/s11336-016-9506-0}}