Co to jest inwariancja pomiaru w CB-SEM?
Inwariancja pomiaru (niezmienność pomiarowa, ang. measurement invariance) oznacza, że związek pozycji kwestionariusza z mierzonym konstruktem jest taki sam w porównywanych grupach albo w kolejnych pomiarach. Tylko wtedy różnica średnich wyników dotyczy konstruktu, a nie zmiany sposobu działania narzędzia. W CB-SEM (SEM opartym na kowariancjach) sprawdza się ją w konfirmacyjnej analizie czynnikowej. Kolejne modele nakładają równości parametrów pomiarowych i sprawdza się, czy dopasowanie istotnie się pogarsza. Vandenberg i Lance (2000) nazywają inwariancję logicznym warunkiem wstępnym porównań średnich i parametrów strukturalnych. Meredith (1993) wprowadził rozróżnienie na inwariancję słabą, silną i ścisłą.
Pełną procedurę dla porównań między grupami (wielogrupowa CFA, pozycje porządkowe, częściowa inwariancja) opisuje poradnik inwariancja pomiaru krok po kroku. To hasło skupia się na drugim, częstym w psychologii przypadku: inwariancji podłużnej, czyli tej samej skali mierzonej u tych samych osób kilka razy.
Poziomy inwariancji i co pozwalają porównać
| Poziom | Co jest równe w pomiarach (grupach) | Co wolno porównać |
|---|---|---|
| Konfiguracyjna | Ta sama struktura: liczba czynników i przypisanie pozycji | Nic ilościowo; to model bazowy |
| Metryczna (słaba) | Ładunki | Wariancje, kowariancje i związki czynnika z innymi zmiennymi |
| Skalarna (silna) | Ładunki i wyrazy wolne | Średnie czynnika |
| Ścisła | Ładunki, wyrazy wolne i wariancje reszt | Średnie i wariancje sum surowych |
Kolejne modele porównuje się testem różnicy χ² i zmianami wskaźników dopasowania. Putnick i Bornstein (2016) zebrali stosowane kryteria. Najczęstsze to spadek CFI nie większy niż .01. Chen (2007) proponuje dodatkowo wzrost RMSEA nie większy niż .015. Gdy pełna inwariancja nie zachodzi, można uwolnić pojedyncze parametry (inwariancja częściowa) i porównywać średnie na podstawie pozostałych pozycji.
Co jest szczególnego w inwariancji podłużnej?
W badaniu podłużnym obie „grupy” to ci sami ludzie. Dlatego model nie jest wielogrupowy, tylko jednogrupowy z czynnikiem dla każdego pomiaru (T1, T2) i korelacją między nimi. Widaman i in. (2010) podkreślają, że przy kilku wskaźnikach w każdym pomiarze można sprawdzić inwariancję w czasie. Jeśli zachodzi, wyniki zmiennej latentnej z kolejnych pomiarów są na tej samej metryce, a wnioski o zmianie – mocniejsze. Trzy praktyczne różnice:
- Skorelowane reszty tej samej pozycji w czasie. Specyfika pozycji (np. jej sformułowanie) wraca w każdym pomiarze. Te kowariancje reszt wynikają ze schematu badania i powinny być w modelu od początku, a nie dodawane na podstawie indeksów modyfikacji.
- Średnie w jednym modelu. Średnią czynnika w T1 ustala się na 0, a średnia w T2 jest szacowana. Przy inwariancji skalarnej to bezpośrednio zmiana konstruktu w czasie.
- Zmiana znaczenia pozycji z czasem. Pozycja może zmieniać się z powodów niezwiązanych z konstruktem: zmienia się kontekst życia, osoby uczą się kwestionariusza, rośnie skłonność do określonych odpowiedzi. Dotyczy to zwłaszcza schematów podłużnych obejmujących okresy przejściowe.
Przykład: samotność na początku studiów i po roku
360 studentów pierwszego roku (dane symulowane) dwukrotnie wypełniło pięciopozycyjną skalę samotności (1–5): w październiku (T1) i rok później (T2). Pozycja s3 brzmi „brakuje mi ludzi, z którymi mogę gdzieś wyjść”. W drugim roku zajęć w stałych grupach było mniej, co podnosi odpowiedzi na s3 niezależnie od samotności. Wyniki kolejnych modeli:
| Model | χ²(df) | CFI | RMSEA | SRMR | Porównanie |
|---|---|---|---|---|---|
| Konfiguracyjna | 25.44 (29) | 1.000 | .000 | .025 | – |
| Metryczna | 30.05 (33) | 1.000 | .000 | .029 | Δχ²(4) = 4.61, p = .330; ΔCFI = .000 |
| Skalarna | 181.66 (37) | .932 | .104 | .057 | Δχ²(4) = 151.61, p < .001; ΔCFI = −.068; ΔRMSEA = .104 |
| Częściowa skalarna (wolny wyraz wolny s3) | 35.42 (36) | 1.000 | .000 | .031 | vs metryczna: Δχ²(3) = 5.37, p = .146; ΔCFI = .000 |
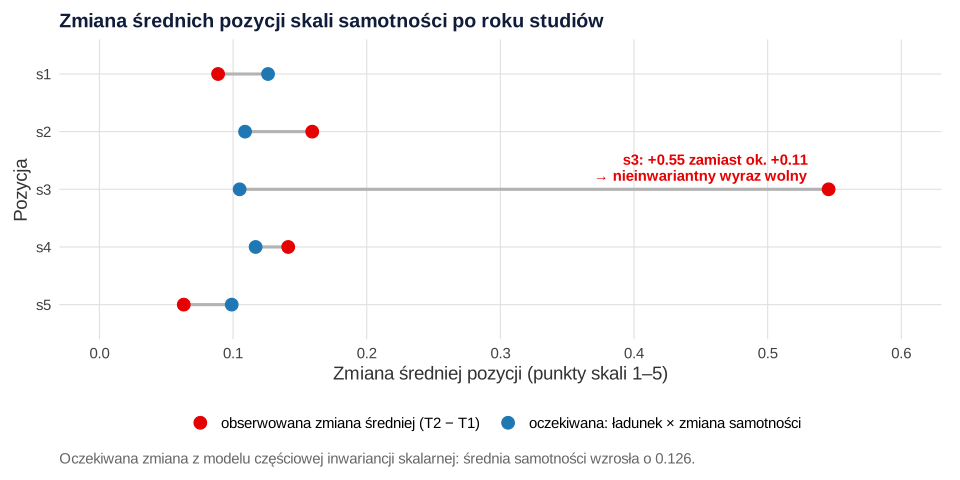
Inwariancja metryczna zachodzi, a pełna skalarna – wyraźnie nie. Test punktowy dla równości wyrazów wolnych wskazał przede wszystkim s3 (χ²(1) = 123.69). Następne były s1 (15.31) i s5 (12.86), ale po uwolnieniu tylko wyrazu wolnego s3 model częściowej inwariancji skalarnej nie różni się od metrycznego. Wyraz wolny s3 wzrósł z 2.28 do 2.72 punktu przy tym samym poziomie samotności. Rysunek 1 pokazuje, skąd bierze się problem. Średnie czterech pozycji zmieniły się zgodnie z oczekiwaniem wynikającym ze zmiany samotności (o 0.06–0.16 punktu), a średnia s3 wzrosła o 0.55.
Konsekwencje dla wniosku o zmianie są duże:
- W modelu częściowej inwariancji średnia samotności wzrosła o 0.126 (p = .003), czyli o 0.17 odchylenia standardowego z T1.
- Model pełnej inwariancji skalarnej (źle dopasowany) dawał wzrost 0.208, czyli 0.28 SD. Tyle samo pokazała suma surowa pozycji (d = 0.28).
Porównanie sum surowych przeszacowało wzrost samotności o ponad 60%, bo zmiana jednej pozycji została potraktowana jako zmiana konstruktu.
Jak opisać inwariancję podłużną w pracy (APA)
Podaj model bazowy (z kowariancjami reszt tych samych pozycji), kryteria, tabelę kolejnych modeli i decyzje o uwolnionych parametrach. Wzór:
Tabelę modeli przygotuj według wzoru tabeli dopasowania modelu CFA. Inwariancja podłużna jest też warunkiem wstępnym analiz zmian i wzajemnych wpływów, np. modeli cross-lagged. Jej odpowiednikiem dla kompozytów w PLS-SEM jest MICOM.
Przykład w R
Kod tworzy dane z przykładu i buduje cztery modele podłużnej inwariancji z etykietami równości. Porównuje je testem różnicy i zmianami wskaźników, uruchamia test punktowy, porównuje średnie czynnika i sum surowych, a na końcu liczy dane do rysunku 1.
Inwariancja podłużna w lavaan (dwa pomiary)
R
# Podłużna inwariancja pomiaru w CB-SEM (lavaan): ta sama skala samotności na początku i po roku studiów
library(lavaan)

# Dane symulowane: 360 studentów pierwszego roku, 5 pozycji (1–5) w dwóch pomiarach.
# Prawdziwy wzrost samotności: 0.20 SD. Pozycja s3 ("brakuje mi ludzi, z którymi mogę wyjść")
# po roku ma wyższy wyraz wolny niezależnie od samotności (zmiana kontekstu: mniej zajęć w grupach).
set.seed(114)
n <- 360
lv <- MASS::mvrnorm(n, c(0, 0.20), matrix(c(1, .60, .60, 1.05), 2))
lam <- c(.80, .75, .70, .75, .65); nu <- c(2.4, 2.6, 2.3, 2.5, 2.7)
gen <- function(eta, shift3 = 0, u) sapply(1:5, function(j)
  nu[j] + (j == 3) * shift3 + lam[j] * 0.9 * eta + u[, j])
u1 <- matrix(rnorm(n * 5, sd = .55), n); u2 <- 0.35 * u1 + matrix(rnorm(n * 5, sd = .52), n)  # specyfika pozycji powraca
x1 <- gen(lv[, 1], 0, u1); x2 <- gen(lv[, 2], 0.35, u2)
dane <- as.data.frame(round(cbind(x1, x2), 2))
names(dane) <- c(paste0("s", 1:5, "_t1"), paste0("s", 1:5, "_t2"))
round(colMeans(dane), 2)

# Ta sama pozycja w obu pomiarach ma skorelowane reszty (zob. kowariancja reszt w SEM)
reszty <- paste0("s", 1:5, "_t1 ~~ s", 1:5, "_t2", collapse = "\n")

konf <- paste('
  T1 =~ s1_t1 + s2_t1 + s3_t1 + s4_t1 + s5_t1
  T2 =~ s1_t2 + s2_t2 + s3_t2 + s4_t2 + s5_t2', reszty, sep = "\n")
metr <- paste('
  T1 =~ 1*s1_t1 + l2*s2_t1 + l3*s3_t1 + l4*s4_t1 + l5*s5_t1
  T2 =~ 1*s1_t2 + l2*s2_t2 + l3*s3_t2 + l4*s4_t2 + l5*s5_t2', reszty, sep = "\n")
# skalarna: równe wyrazy wolne; średnia T1 = 0, średnia T2 szacowana
wyrazy <- function(wolne = NULL) {
  w <- sapply(1:5, function(j) if (j %in% wolne)
    sprintf("s%d_t1 ~ 1\ns%d_t2 ~ 1", j, j) else sprintf("s%d_t1 ~ i%d*1\ns%d_t2 ~ i%d*1", j, j, j, j))
  paste(c(w, "T1 ~ 0*1", "T2 ~ 1"), collapse = "\n")
}
skal  <- paste(metr, wyrazy(), sep = "\n")
czesc <- paste(metr, wyrazy(wolne = 3), sep = "\n")    # częściowa: wolny wyraz wolny s3

fk <- cfa(konf, data = dane, meanstructure = TRUE)
fm <- cfa(metr, data = dane, meanstructure = TRUE)
fs <- cfa(skal, data = dane)
fc <- cfa(czesc, data = dane)
miary <- c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")
tab <- round(rbind(konfiguracyjna = fitMeasures(fk, miary), metryczna = fitMeasures(fm, miary),
                   skalarna = fitMeasures(fs, miary), czesciowa_skalarna = fitMeasures(fc, miary)), 3)
print(tab)
round(c(dCFI_metr = tab[2, "cfi"] - tab[1, "cfi"], dRMSEA_metr = tab[2, "rmsea"] - tab[1, "rmsea"],
        dCFI_skal = tab[3, "cfi"] - tab[2, "cfi"], dRMSEA_skal = tab[3, "rmsea"] - tab[2, "rmsea"],
        dCFI_czesc = tab[4, "cfi"] - tab[2, "cfi"], dRMSEA_czesc = tab[4, "rmsea"] - tab[2, "rmsea"]), 3)
lavTestLRT(fk, fm, fs)
lavTestLRT(fm, fc)

# Które równości wyrazów wolnych najbardziej szkodzą? Test punktowy (score test) dla ograniczeń i1–i5
sc <- lavTestScore(fs)$uni
pt <- parTable(fs); nazwa <- setNames(paste(pt$lhs, pt$op, pt$rhs), pt$plabel)
sc$ograniczenie <- paste(nazwa[sc$lhs], "=", nazwa[sc$rhs])
print(sc[order(-sc$X2), c("ograniczenie", "X2", "p.value")][1:5, ], digits = 3, row.names = FALSE)

# Średnia samotności po roku (T1 = 0), w jednostkach SD z T1
sd_t1 <- function(f) sqrt(lavInspect(f, "est")$psi["T1", "T1"])
m_s <- parameterEstimates(fs); m_c <- parameterEstimates(fc)
d_s <- m_s[m_s$lhs == "T2" & m_s$op == "~1", ]; d_c <- m_c[m_c$lhs == "T2" & m_c$op == "~1", ]
round(rbind(pelna_skalarna = c(srednia_T2 = d_s$est, p = d_s$pvalue, w_SD = d_s$est / sd_t1(fs)),
            czesciowa = c(srednia_T2 = d_c$est, p = d_c$pvalue, w_SD = d_c$est / sd_t1(fc))), 3)
# wyrazy wolne s3 w częściowym modelu
print(m_c[m_c$lhs %in% c("s3_t1", "s3_t2") & m_c$op == "~1", c("lhs", "est", "se")], digits = 3, row.names = FALSE)
# różnica sum surowych (T2 − T1) w jednostkach SD z T1
suma1 <- rowSums(dane[, 1:5]); suma2 <- rowSums(dane[, 6:10])
round(c(d_suma = (mean(suma2) - mean(suma1)) / sd(suma1)), 3)
# Dla rysunku: obserwowana zmiana średniej każdej pozycji (T2 − T1) i zmiana oczekiwana,
# gdyby pozycja zmieniała się tylko przez samotność: ładunek × różnica średnich czynnika (model częściowy)
lam_c <- m_c[m_c$lhs == "T1" & m_c$op == "=~", "est"]
zmiana <- data.frame(pozycja = paste0("s", 1:5),
                     obserwowana = colMeans(dane[, 6:10]) - colMeans(dane[, 1:5]),
                     oczekiwana = lam_c * d_c$est)
print(round(zmiana[, -1], 3))
saveRDS(zmiana, "zmiana-pozycji.rds")
Wynik w R
s1_t1 s2_t1 s3_t1 s4_t1 s5_t1 s1_t2 s2_t2 s3_t2 s4_t2 s5_t2
 2.47  2.63  2.28  2.53  2.76  2.56  2.79  2.83  2.67  2.82
                     chisq df pvalue   cfi rmsea  srmr
konfiguracyjna      25.441 29  0.655 1.000 0.000 0.025
metryczna           30.050 33  0.615 1.000 0.000 0.029
skalarna           181.655 37  0.000 0.932 0.104 0.057
czesciowa_skalarna  35.423 36  0.496 1.000 0.000 0.031
   dCFI_metr  dRMSEA_metr    dCFI_skal  dRMSEA_skal   dCFI_czesc dRMSEA_czesc
       0.000        0.000       -0.068        0.104        0.000        0.000

Chi-Squared Difference Test

   Df    AIC    BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fk 29 7133.7 7273.6  25.441
fm 33 7130.3 7254.6  30.050      4.609 0.02056       4     0.3298
fs 37 7273.9 7382.7 181.655    151.605 0.32016       4     <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Chi-Squared Difference Test

   Df    AIC    BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
fm 33 7130.3 7254.6 30.050
fc 36 7129.6 7242.3 35.423      5.373 0.046874       3     0.1464
              ograniczenie     X2 p.value
     s3_t1 ~1  = s3_t2 ~1  123.69   0.000
     s1_t1 ~1  = s1_t2 ~1   15.31   0.000
     s5_t1 ~1  = s5_t2 ~1   12.86   0.000
 T1 =~ s3_t1 = T2 =~ s3_t2   5.39   0.020
 T1 =~ s2_t1 = T2 =~ s2_t2   4.02   0.045
               srednia_T2     p  w_SD
pelna_skalarna      0.208 0.000 0.282
czesciowa           0.126 0.003 0.169
   lhs  est    se
 s3_t1 2.28 0.043
 s3_t2 2.72 0.045
d_suma
 0.282
      obserwowana oczekiwana
s1_t2       0.089      0.126
s2_t2       0.159      0.109
s3_t2       0.546      0.105
s4_t2       0.141      0.117
s5_t2       0.063      0.099
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie sum surowych bez sprawdzenia inwariancji. W przykładzie suma surowa przeszacowała zmianę z 0.17 do 0.28 SD.
- Model wielogrupowy dla danych powtarzanych. Traktowanie T1 i T2 jak niezależnych grup ignoruje zależność obserwacji. Użyj modelu jednogrupowego z czynnikiem dla każdego pomiaru.
- Brak kowariancji reszt tej samej pozycji w czasie. Bez nich model bazowy jest źle określony, a ładunki i korelacja czynników w czasie – obciążone.
- Uwalnianie wielu wyrazów wolnych naraz. Uwalniaj po jednym, zaczynając od największego testu punktowego, i sprawdzaj model po każdej zmianie. Częściowa inwariancja wymaga, by większość pozycji pozostała równa.
- Kryteria ΔCFI stosowane mechanicznie. Putnick i Bornstein (2016) przypominają, że nie ma konsensusu co do progów. Podawaj zarówno Δχ², jak i zmiany wskaźników, a decyzję uzasadnij treścią pozycji.
- Pomijanie interpretacji nieinwariantnej pozycji. Wzrost wyrazu wolnego s3 to też wynik: pozycja reaguje na zmianę kontekstu studiów. Opisz to w dyskusji.
Najczęstsze pytania
Jak sprawdzić inwariancję pomiaru w badaniu podłużnym?
Zbuduj jednogrupowy model CFA z osobnym czynnikiem dla każdego pomiaru, skorelowanymi czynnikami i skorelowanymi resztami tej samej pozycji w czasie. Następnie kolejno zrównaj ładunki, wyrazy wolne i ewentualnie wariancje reszt etykietami w składni lavaan. Każdy model porównaj z poprzednim testem różnicy χ² oraz zmianą CFI i RMSEA.
Dlaczego w inwariancji podłużnej koreluje się reszty tych samych pozycji?
Bo specyfika pozycji, np. jej sformułowanie, powraca w każdym pomiarze u tych samych osób. Te kowariancje wynikają ze schematu badania, więc wpisz je do modelu bazowego od początku. Ich pominięcie zniekształca ładunki i korelację czynnika w czasie.
Co oznacza inwariancja skalarna?
Że w porównywanych grupach lub pomiarach równe są zarówno ładunki, jak i wyrazy wolne pozycji. Osoby o tym samym poziomie konstruktu mają wtedy te same oczekiwane odpowiedzi, więc różnice średnich pozycji wynikają z różnic konstruktu. Dopiero na tym poziomie wolno porównywać średnie czynnika.
Czy przy braku inwariancji skalarnej można porównać średnie w czasie?
Można, jeśli uda się uzyskać częściową inwariancję skalarną: uwolnić wyrazy wolne pojedynczych pozycji, a pozostałe zostawić równe. Porównuj wtedy średnie czynnika, a nie sumy surowe. W przykładzie na tej stronie suma surowa zawyżała wzrost samotności z 0.17 do 0.28 SD.
Jakie kryteria przyjąć przy ocenie inwariancji pomiaru?
Najczęściej przyjmuje się, że inwariancja nie zachodzi, gdy CFI spada o więcej niż .01, często razem ze wzrostem RMSEA o więcej niż .015. Podaj też test różnicy χ², bo kryteria te nie są uniwersalne i nie ma co do nich konsensusu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Inwariancja podłużna pomiaru
Trzy pomiary w lavaan: kowariancje reszt, measEq.syntax, częściowa inwariancja w jednym pomiarze, odpadanie i progi – co zmienia się we wniosku o zmianie.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
- Meredith, W. (1993). Measurement invariance, factor analysis and factorial invariance. Psychometrika, 58(4), 525–543. https://doi.org/10.1007/bf02294825
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Vandenberg, R. J., & Lance, C. E. (2000). A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Organizational Research Methods, 3(1), 4–70. https://doi.org/10.1177/109442810031002
- Widaman, K. F., Ferrer, E., & Conger, R. D. (2010). Factorial invariance within longitudinal structural equation models: Measuring the same construct across time. Child Development Perspectives, 4(1), 10–18. https://doi.org/10.1111/j.1750-8606.2009.00110.x ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{chen2007sensitivity, author={Chen, Fang Fang}, title={{Sensitivity of goodness of fit indexes to lack of measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={3}, pages={464--504}, doi={10.1080/10705510701301834}}@article{meredith1993measurement, author={Meredith, William}, title={{Measurement invariance, factor analysis and factorial invariance}}, journal={Psychometrika}, year={1993}, volume={58}, number={4}, pages={525--543}, doi={10.1007/bf02294825}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{vandenberg2000review, author={Vandenberg, Robert J. and Lance, Charles E.}, title={{A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research}}, journal={Organizational Research Methods}, year={2000}, volume={3}, number={1}, pages={4--70}, doi={10.1177/109442810031002}}@article{widaman2010factorial, author={Widaman, Keith F and Ferrer, Emilio and Conger, Rand D}, title={{Factorial invariance within longitudinal structural equation models: Measuring the same construct across time}}, journal={Child Development Perspectives}, year={2010}, volume={4}, number={1}, pages={10--18}, doi={10.1111/j.1750-8606.2009.00110.x}}