Co to jest CFA?
Konfirmacyjna analiza czynnikowa (CFA, ang. confirmatory factor analysis) to metoda sprawdzania, czy dane są zgodne z z góry określoną strukturą czynnikową: ile jest czynników, które pozycje ładują który czynnik i które czynniki mogą ze sobą korelować. Model zapisuje się przed analizą na podstawie teorii albo wcześniejszych badań, a CFA ocenia, jak dobrze odtwarza on macierz kowariancji pozycji. Jöreskog (1969) opisał ogólne podejście, w którym część parametrów ustala się (np. ładunek krzyżowy = 0), a pozostałe szacuje metodą największej wiarygodności i ocenia testem chi-kwadrat.
W psychologii CFA służy przede wszystkim do sprawdzania struktury kwestionariuszy: przy adaptacji skali, ocenie trafności teoretycznej i jako pierwszy krok przed modelem strukturalnym. Jest szczególnym przypadkiem SEM – modelem samego pomiaru, bez ścieżek między czynnikami.
CFA a EFA
| Cecha | EFA (eksploracyjna) | CFA (konfirmacyjna) |
|---|---|---|
| Pytanie | Ile czynników i jakie pozycje je tworzą? | Czy zakładana struktura pasuje do danych? |
| Ładunki krzyżowe | szacowane dla wszystkich pozycji | zwykle ustalone na 0 |
| Rotacja | potrzebna | niepotrzebna – struktura jest zadana |
| Ocena | wykres osypiska, analiza równoległa, interpretowalność | χ², CFI, RMSEA, SRMR, reszty, indeksy modyfikacji |
| Porównanie modeli | ograniczone | formalne (test różnicy χ², AIC, BIC) |
Nie przeprowadzaj EFA i CFA na tych samych danych w celu „potwierdzenia” wyniku EFA. Jeśli strukturę wyłoniła EFA, CFA wykonaj na nowej próbie albo na losowo wydzielonej połowie danych. Szerzej opisuje to wpis analiza czynnikowa EFA i CFA.
Etapy CFA: specyfikacja, identyfikacja, estymacja, ocena
Specyfikacja. Zapisz, które pozycje ładują który czynnik, i ustal pozostałe ładunki na 0. Czynniki zwykle mogą korelować. Kowariancje błędów dodawaj tylko z uzasadnieniem, np. przy pozycjach o niemal identycznym sformułowaniu.
Identyfikacja. Każdy czynnik potrzebuje skali: albo pierwszy ładunek ustala się na 1 (metoda wskaźnika referencyjnego, domyślna w lavaan), albo wariancję czynnika na 1. Model musi też mieć nieujemną liczbę stopni swobody. Przy p pozycjach dane dostarczają p(p + 1)/2 wariancji i kowariancji. W przykładzie niżej osiem pozycji daje 36 informacji, a model dwuczynnikowy ma 17 parametrów: 6 swobodnych ładunków, 8 wariancji błędów, 2 wariancje czynników i 1 korelację. Daje to df = 19 (zob. identyfikacja modelu SEM).
Estymacja. Standardem jest ML, przy wyraźnej nienormalności MLR, a przy pozycjach porządkowych z małą liczbą kategorii WLSMV.
Ocena. Dopasowanie globalne opisują χ² (CMIN), CFI, TLI, RMSEA z przedziałem ufności i SRMR. Dopasowanie lokalne sprawdzisz w resztach i indeksach modyfikacji. Na koniec oceń same ładunki i korelacje czynników.
Przykład: dwuczynnikowa skala wypalenia studenckiego
Trzystu dwudziestu studentów (dane symulowane) wypełniło 8 pozycji skali wypalenia (odpowiedzi 1–7): cztery mierzą wyczerpanie (wy1–wy4), cztery – dystans wobec studiów (dy1–dy4). Pozycje wy3 i wy4 są sformułowane bardzo podobnie.
Analizę zaplanowano przed obejrzeniem danych: model zakładany, jeden model konkurencyjny i z góry określona reguła, że kowariancję błędów można dodać tylko dla pary pozycji o niemal identycznej treści. Taki plan chroni przed dopasowywaniem modelu do przypadkowych cech próby.
Krok 1: model zakładany. Dwa skorelowane czynniki, bez kowariancji błędów: χ²(19) = 33.32, p = .022, CFI = .982, TLI = .973, RMSEA = .049, 90% CI [.018, .075], SRMR = .034. Indeksy są dobre, ale test χ² odrzuca dokładne dopasowanie. Standaryzowane ładunki wynoszą od .60 do .75, a korelacja czynników .62.
Krok 2: model konkurencyjny. Model jednoczynnikowy dopasował się znacznie gorzej: χ²(20) = 156.88, CFI = .825, RMSEA = .146, SRMR = .083. Test różnicy potwierdza przewagę modelu dwuczynnikowego: Δχ²(1) = 123.56, p < .001.
Krok 3: dopasowanie lokalne. Największy indeks modyfikacji (MI = 17.52) dotyczy kowariancji błędów wy3 i wy4. Oczekiwana standaryzowana zmiana parametru wynosi .43. Kolejne MI (10.03 dla wy1–wy2 i 9.32 dla wy2–wy4) są wyraźnie mniejsze, a reszty korelacyjne nie przekraczają |.08|. Ponieważ podobieństwo treści wy3 i wy4 jest znane z góry, dodanie tej jednej kowariancji ma uzasadnienie merytoryczne (zob. kowariancja reszt w SEM). Pozostałych sugestii nie wprowadzono.
Krok 4: model końcowy. χ²(18) = 17.12, p = .515, CFI = 1.000, RMSEA = .000, 90% CI [.000, .047], SRMR = .026. Poprawa jest istotna: Δχ²(1) = 16.20, p < .001. Kowariancja błędów wynosi r = .31, 95% CI [.19, .44]. Rysunek 1 pokazuje ładunki i korelacje w modelu końcowym.
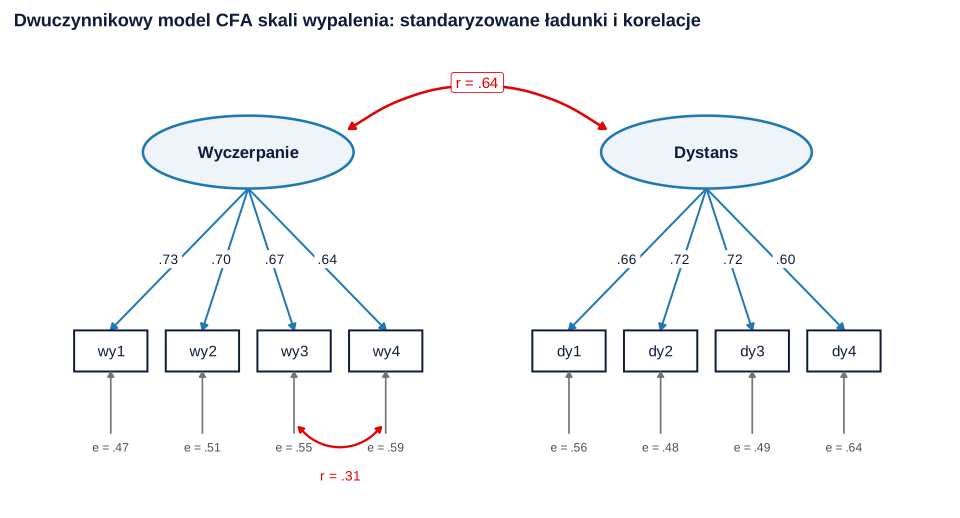
Zwróć uwagę na zmianę ładunków. W modelu bez kowariancji błędów wy3 i wy4 miały najwyższe ładunki (.75 i .73), bo ich wspólna wariancja „metodologiczna” zasilała czynnik. Po jej uwzględnieniu spadły do .67 i .64. Korelacja czynników wynosi .64, 95% CI [.54, .74]. Wyczerpanie i dystans są więc powiązane, ale wyraźnie odrębne (zob. AVE).
Jak opisać CFA w pracy (APA)
Jackson i in. (2009) przejrzeli 194 artykuły z CFA i stwierdzili, że autorzy niemal zawsze podają test χ², ale często pomijają informacje o brakach danych i ocenie normalności. DiStefano i Hess (2005) przeanalizowali, co raportują autorzy stosujący CFA do walidacji skal, i sformułowali zalecenia, a Schreiber i in. (2006) zebrali minimalny zestaw informacji do raportu z CFA i SEM. W praktyce podaj:
- specyfikację modelu (rysunek), sposób identyfikacji i estymator;
- liczebność, braki danych i ich obsługę, ocenę rozkładów;
- χ² z df i p, CFI, TLI, RMSEA z 90% CI, SRMR – dla modelu zakładanego, konkurencyjnych i końcowego;
- każdą modyfikację z uzasadnieniem;
- standaryzowane ładunki, korelacje czynników i miary rzetelności (wzór: tabela dopasowania modelu CFA w APA).
CFA w R (lavaan)
Kod tworzy dane z przykładu i przechodzi przez wszystkie etapy: liczbę informacji i stopni swobody, model dwuczynnikowy, standaryzowane ładunki, reszty i indeksy modyfikacji, porównanie z modelem jednoczynnikowym oraz model końcowy z kowariancją błędów. Liczby w tekście, opisie APA i na rysunku 1 pochodzą z tego kodu.
Dwuczynnikowy model CFA krok po kroku
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 320 studentów wypełniło 8-pozycyjną skalę wypalenia studenckiego (odpowiedzi 1–7):
# wyczerpanie (wy1–wy4) i dystans wobec studiów (dy1–dy4). Pozycje wy3 i wy4 mają podobne sformułowanie,
# więc w populacji ich błędy pomiaru są skorelowane (efekt metody).
set.seed(102)
pop <- '
  wyczerpanie =~ 0.78*wy1 + 0.74*wy2 + 0.66*wy3 + 0.62*wy4
  dystans     =~ 0.75*dy1 + 0.72*dy2 + 0.70*dy3 + 0.58*dy4
  wyczerpanie ~~ 0.55*dystans
  wy3 ~~ 0.22*wy4
'
z <- simulateData(pop, sample.nobs = 320, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.4 * x), 1), 7)))

# 1. Liczba informacji i stopnie swobody: p(p + 1)/2 wariancji i kowariancji
p <- ncol(dane); p * (p + 1) / 2

# 2. Model dwuczynnikowy (identyfikacja: pierwszy ładunek każdego czynnika = 1, domyślnie w lavaan)
model2 <- '
  wyczerpanie =~ wy1 + wy2 + wy3 + wy4
  dystans     =~ dy1 + dy2 + dy3 + dy4
'
fit2 <- cfa(model2, data = dane)
c(parametry = lavInspect(fit2, "npar"), df = fitMeasures(fit2, "df"))
round(fitMeasures(fit2, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr")), 3)

# 3. Standaryzowane ładunki i korelacja czynników
st <- standardizedSolution(fit2)
st[st$op %in% c("=~", "~~") & st$lhs != st$rhs, c("lhs", "op", "rhs", "est.std", "se", "ci.lower", "ci.upper")]

# 4. Gdzie model nie pasuje lokalnie: największe reszty korelacyjne i indeksy modyfikacji
res <- residuals(fit2, type = "cor")$cov
res[upper.tri(res, diag = TRUE)] <- NA
ind <- which(abs(res) > 0.05, arr.ind = TRUE)
data.frame(para = paste(rownames(res)[ind[, 1]], colnames(res)[ind[, 2]], sep = "–"), reszta = round(res[ind], 3))
mi <- modindices(fit2, sort. = TRUE)
head(mi[, c("lhs", "op", "rhs", "mi", "epc", "sepc.all")], 4)

# 5. Konkurencyjny model jednoczynnikowy (test różnicy chi-kwadrat)
model1 <- 'wypalenie =~ wy1 + wy2 + wy3 + wy4 + dy1 + dy2 + dy3 + dy4'
fit1 <- cfa(model1, data = dane)
round(fitMeasures(fit1, c("chisq", "df", "cfi", "rmsea", "srmr")), 3)
lavTestLRT(fit1, fit2)

# 6. Model z uzasadnioną kowariancją błędów wy3–wy4 (podobne sformułowanie pozycji)
model2b <- paste(model2, "wy3 ~~ wy4", sep = "\n")
fit2b <- cfa(model2b, data = dane)
round(fitMeasures(fit2b, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr")), 3)
lavTestLRT(fit2b, fit2)
st_b <- standardizedSolution(fit2b)
st_b[(st_b$op == "~~" & st_b$lhs != st_b$rhs) | st_b$op == "=~", c("lhs", "op", "rhs", "est.std", "ci.lower", "ci.upper")]
Wynik w R
[1] 36
parametry     df.df
       17        19
         chisq             df         pvalue            cfi            tli
        33.324         19.000          0.022          0.982          0.973
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr
         0.049          0.018          0.075          0.034
           lhs op     rhs est.std    se ci.lower ci.upper
1  wyczerpanie =~     wy1   0.686 0.038    0.612    0.759
2  wyczerpanie =~     wy2   0.656 0.039    0.579    0.734
3  wyczerpanie =~     wy3   0.753 0.033    0.688    0.819
4  wyczerpanie =~     wy4   0.732 0.035    0.664    0.800
5      dystans =~     dy1   0.663 0.040    0.584    0.742
6      dystans =~     dy2   0.719 0.037    0.646    0.792
7      dystans =~     dy3   0.720 0.037    0.646    0.793
8      dystans =~     dy4   0.598 0.044    0.512    0.685
19 wyczerpanie ~~ dystans   0.623 0.050    0.524    0.721
     para reszta
1 wy2–wy1  0.072
2 dy4–wy1  0.050
3 wy4–wy2 -0.060
4 dy2–wy2  0.055
5 dy4–wy2  0.074
6 wy4–wy3  0.058
7 dy1–wy3 -0.052
8 dy2–wy4  0.052
       lhs op rhs     mi    epc sepc.all
41     wy3 ~~ wy4 17.520  0.385    0.425
28     wy1 ~~ wy2 10.027  0.236    0.240
36     wy2 ~~ wy4  9.324 -0.250   -0.251
26 dystans =~ wy3  6.408 -0.308   -0.196
  chisq      df     cfi   rmsea    srmr
156.880  20.000   0.825   0.146   0.083

Chi-Squared Difference Test

     Df    AIC    BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit2 19 8169.9 8234.0  33.325
fit1 20 8291.5 8351.8 156.880     123.56 0.61886       1  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
         chisq             df         pvalue            cfi            tli
        17.124         18.000          0.515          1.000          1.002
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr
         0.000          0.000          0.047          0.026

Chi-Squared Difference Test

      Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit2b 18 8155.7 8223.6 17.124
fit2  19 8169.9 8234.0 33.325     16.201 0.21795       1  5.697e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
           lhs op     rhs est.std ci.lower ci.upper
1  wyczerpanie =~     wy1   0.728    0.653    0.803
2  wyczerpanie =~     wy2   0.703    0.626    0.780
3  wyczerpanie =~     wy3   0.671    0.589    0.754
4  wyczerpanie =~     wy4   0.643    0.557    0.730
5      dystans =~     dy1   0.664    0.585    0.744
6      dystans =~     dy2   0.719    0.646    0.793
7      dystans =~     dy3   0.715    0.642    0.789
8      dystans =~     dy4   0.602    0.516    0.688
9          wy3 ~~     wy4   0.313    0.187    0.438
20 wyczerpanie ~~ dystans   0.641    0.541    0.741
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Dopasowywanie” modelu indeksami modyfikacji. Dodawanie kolejnych kowariancji błędów, aż indeksy przekroczą progi, zamienia CFA w eksplorację. Każda zmiana wymaga uzasadnienia treściowego, a liczne zmiany – replikacji.
- EFA i CFA na tych samych danych jako „potwierdzenie” struktury.
- Ocena wyłącznie globalnego dopasowania. Model z CFI = .98 może mieć słabe ładunki, ujemne wariancje błędów albo korelację czynników bliską 1.
- ML dla pozycji z 3–4 kategoriami odpowiedzi zamiast WLSMV lub przynajmniej MLR.
- Brak modelu konkurencyjnego. Porównaj model zakładany przynajmniej z jednoczynnikowym; przy porównaniu grup sprawdź inwariancję pomiaru.
Przebieg pełnej walidacji skali opisuje poradnik jak zbudować i zwalidować skalę psychometryczną, a porównanie grup – inwariancja pomiaru krok po kroku.
Najczęstsze pytania
Czy CFA można zrobić na tych samych danych co EFA?
Nie jako potwierdzenie. Struktura wyłoniona w EFA zawsze będzie dobrze pasować do danych, z których powstała. CFA wykonaj na nowej próbie albo podziel dane losowo na dwie części: na jednej przeprowadź EFA, na drugiej CFA.
Jak policzyć stopnie swobody w modelu CFA?
Policz informacje w danych, p(p + 1)/2 dla p pozycji, i odejmij liczbę swobodnych parametrów: ładunków (bez ustalonych na 1), wariancji błędów, wariancji i kowariancji czynników. Dla 8 pozycji i dwóch czynników: 36 − 17 = 19.
Kiedy wolno dodać kowariancję błędów w CFA?
Gdy masz uzasadnienie niezależne od indeksu modyfikacji: niemal identyczne sformułowanie pozycji, odwrócone kodowanie, ten sam pomiar w dwóch falach. Dodawaj pojedyncze kowariancje, opisz każdą w pracy i sprawdź, jak zmieniły się ładunki i korelacje czynników.
Jaki estymator wybrać w CFA dla skali Likerta?
Przy 5–7 kategoriach i rozkładach zbliżonych do symetrycznych zwykle wystarcza ML albo MLR (odporny na nienormalność). Przy 2–4 kategoriach lub silnej asymetrii użyj estymatora dla danych porządkowych, np. WLSMV, opartego na korelacjach polichorycznych.
Co zrobić, gdy model CFA ma dobre CFI, ale istotny test chi-kwadrat?
Przy kilkuset osobach test χ² wykrywa nawet drobne odchylenia, więc istotny wynik nie musi dyskwalifikować modelu. Sprawdź reszty i indeksy modyfikacji, by zobaczyć, skąd bierze się niedopasowanie, i opisz je w pracy obok indeksów dopasowania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Konfirmacyjna analiza czynnikowa (CFA) w jamovi
Okno Confirmatory Factor Analysis na skali z dwoma czynnikami: kowariancja reszt z uzasadnieniem, ładunki standaryzowane, χ² i wskaźniki dopasowania, indeksy modyfikacji, omega z modelu – z kodem jmv.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- DiStefano, C., & Hess, B. (2005). Using confirmatory factor analysis for construct validation: An empirical review. Journal of Psychoeducational Assessment, 23(3), 225–241. https://doi.org/10.1177/073428290502300303
- Jackson, D. L., Gillaspy, J. A., & Purc-Stephenson, R. (2009). Reporting practices in confirmatory factor analysis: An overview and some recommendations. Psychological Methods, 14(1), 6–23. https://doi.org/10.1037/a0014694
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schreiber, J. B., Nora, A., Stage, F. K., Barlow, E. A., & King, J. (2006). Reporting structural equation modeling and confirmatory factor analysis results: A review. The Journal of Educational Research, 99(6), 323–338. https://doi.org/10.3200/joer.99.6.323-338
Cytowania BibTeX
@article{distefano2005using, author={DiStefano, Christine and Hess, Brian}, title={{Using confirmatory factor analysis for construct validation: An empirical review}}, journal={Journal of Psychoeducational Assessment}, year={2005}, volume={23}, number={3}, pages={225--241}, doi={10.1177/073428290502300303}}@article{jackson2009reporting, author={Jackson, Dennis L. and Gillaspy, J. Arthur and Purc-Stephenson, Rebecca}, title={{Reporting practices in confirmatory factor analysis: An overview and some recommendations}}, journal={Psychological Methods}, year={2009}, volume={14}, number={1}, pages={6--23}, doi={10.1037/a0014694}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{schreiber2006reporting, author={Schreiber, James B. and Nora, Amaury and Stage, Frances K. and Barlow, Elizabeth A. and King, Jamie}, title={{Reporting structural equation modeling and confirmatory factor analysis results: A review}}, journal={The Journal of Educational Research}, year={2006}, volume={99}, number={6}, pages={323--338}, doi={10.3200/joer.99.6.323-338}}