Co to jest PCFI?
PCFI (ang. parsimony comparative fit index, oszczędnościowy indeks dopasowania porównawczego) to CFI pomnożony przez współczynnik oszczędności (ang. parsimony ratio). Ten współczynnik to stosunek stopni swobody modelu badacza do stopni swobody modelu bazowego. PCFI nagradza więc modele, które dobrze odtwarzają dane przy niewielkiej liczbie swobodnych parametrów, i karze modele „przeparametryzowane”.
Idea pochodzi od Mulaika i in. (1989). Zauważyli oni, że zwykłe indeksy dopasowania nie uwzględniają oszczędności, a przez to falsyfikowalności modelu. Model z wieloma swobodnymi parametrami dopasuje się prawie do wszystkiego, więc jego dobre dopasowanie mało mówi. Zaproponowali, by korygować indeksy właśnie przez współczynnik oszczędności. Zastosowany do NFI daje PNFI, do CFI – PCFI, a do GFI – PGFI. Sam CFI zaproponował Bentler (1990) jako indeks niecentralności, który nie zaniża dopasowania w małych próbach tak jak NFI.
Wzór
dfM to stopnie swobody modelu badacza, a dfB – modelu bazowego (niezależności). Przy p zmiennych obserwowalnych model bazowy ma dfB = p(p − 1)/2, bo szacuje tylko wariancje. Dla 10 pozycji to 45. Każdy dodatkowy parametr zmniejsza dfM o 1 i tym samym obniża współczynnik oszczędności o 1/45. PCFI rośnie po dodaniu parametru tylko wtedy, gdy CFI wzrośnie wystarczająco, by to zrównoważyć.
Z wzoru wynikają trzy ważne własności:
- PCFI ma niski sufit. Nawet przy CFI = 1 nie przekroczy dfM/dfB. Dla typowej CFA z 10 pozycjami i 2 czynnikami to 34/45 = .756. Wartości PCFI nie da się więc oceniać progami znanymi z CFI (.90, .95).
- Model nasycony ma PCFI = 0, bo dfM = 0, choć jego CFI wynosi 1.
- Wartość zależy od liczby zmiennych. Porównuj PCFI tylko między modelami dla tych samych danych i tego samego zestawu zmiennych.
Przykład: cztery modele, jedne dane
Trzysta pięćdziesiąt osób (dane symulowane) wypełniło 10 pozycji skali zaangażowania w naukę (1–5): pięć dotyczy zaangażowania poznawczego (P1–P5), pięć – emocjonalnego (E1–E5). Prawdziwy model ma dwa skorelowane czynniki. Porównujemy cztery modele:
- A – jeden czynnik ogólny;
- B – dwa skorelowane czynniki (model prawdziwy);
- C – model B plus trzy kowariancje błędów o najwyższych indeksach modyfikacji (P1–P3, P1–P4, P2–P3);
- D – model B plus osiem takich kowariancji.
| Model | χ² | df | CFI | PCFI | PNFI | RMSEA | BIC |
|---|---|---|---|---|---|---|---|
| A: jeden czynnik | 253.76 | 35 | .776 | .604 | .585 | .134 | 9849.98 |
| B: dwa czynniki | 35.51 | 34 | .998 | .754 | .729 | .011 | 9637.59 |
| C: B + 3 kowariancje | 25.88 | 31 | 1.000 | .689 | .671 | .000 | 9645.53 |
| D: B + 8 kowariancji | 17.07 | 26 | 1.000 | .578 | .568 | .000 | 9666.01 |
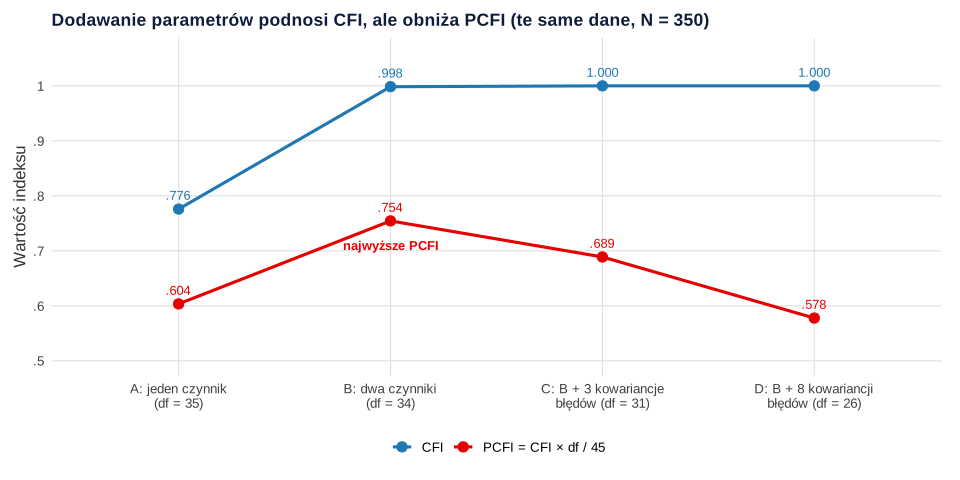
CFI nie odróżnia modeli B, C i D – wszystkie mają .998–1.000. PCFI wskazuje model B (.754), a modele z dodanymi kowariancjami błędów tracą: C ma .689, D – .578. Tę samą kolejność daje PNFI i BIC. Inaczej wypada test różnicy χ²: model C jest istotnie lepszy od B, Δχ²(3) = 9.63, p = .022. AIC również lekko faworyzuje C (9552.94 wobec 9556.57). Kowariancje w modelu C nie istnieją jednak w populacji. To przypadkowe cechy próby, „wyłowione” z indeksów modyfikacji.
Przykład pokazuje, do czego PCFI się nadaje: jako jeden z argumentów przeciw komplikowaniu modelu tylko po to, by poprawić dopasowanie. Preacher (2006) zwraca jednak uwagę, że liczba swobodnych parametrów nie mierzy w pełni oszczędności. Modele o tej samej liczbie parametrów, ale innej strukturze mogą różnić się skłonnością do dopasowania się do dowolnych danych. PCFI, który liczy tylko stopnie swobody, tej różnicy nie widzi.
Ile „kosztuje” jeden parametr
Z wzoru łatwo policzyć, jak bardzo musi wzrosnąć CFI, żeby dodatkowy parametr się opłacił. Model B ma CFI = .998 i df = 34, więc PCFI = .998 × 34/45 = .754. Model C ma o trzy parametry więcej (df = 31). Żeby dorównać modelowi B, musiałby mieć CFI ≥ .998 × 34/31 = 1.095, a to niemożliwe, bo CFI nie przekracza 1. Gdy CFI jest już bliski 1, każdy dodany parametr obniża PCFI. Parametr może się „opłacić” tylko wtedy, gdy model wyjściowy jest wyraźnie źle dopasowany. Tak było przy przejściu od modelu A do B: oddzielenie dwóch czynników podniosło CFI z .776 do .998, więc PCFI wzrósł mimo utraty jednego stopnia swobody.
Ta sama logika pokazuje ograniczenie indeksu. Przy dużej liczbie zmiennych dfB jest bardzo duże, a kara za pojedynczy parametr – minimalna. Przy 30 pozycjach dfB = 435, więc jeden parametr obniża współczynnik oszczędności zaledwie o .002. W dużych modelach PCFI słabo różnicuje modele, które różnią się kilkoma parametrami. Lepiej wtedy oprzeć się na BIC i ocenie merytorycznej.
Jak używać PCFI
- Do porównywania modeli na tych samych danych – wyższy PCFI oznacza lepszy kompromis między dopasowaniem a oszczędnością. Pojedyncza wartość PCFI niewiele mówi.
- Razem z innymi kryteriami: BIC lub AIC (zob. AIC i BIC w SEM), testem różnicy χ² dla modeli zagnieżdżonych i oceną merytoryczną parametrów.
- Do oceny bezwzględnego dopasowania używaj CFI, RMSEA i SRMR. Hu i Bentler (1999) zaproponowali progi dla tych indeksów, ale nie dla PCFI.
- Zdecyduj o zestawie porównywanych modeli przed analizą. Porównanie modeli wymyślonych po obejrzeniu indeksów modyfikacji jest eksploracyjne, niezależnie od tego, który indeks je rozstrzyga.
- Policz ręcznie, jeśli program go nie podaje. AMOS wypisuje PCFI w zestawieniu miar oszczędności. W lavaan wystarczy CFI × df /
baseline.df.
Jak opisać porównanie modeli (APA)
PCFI w R (lavaan)
Kod generuje dane z przykładu, szacuje model jedno- i dwuczynnikowy, buduje modele C i D z kowariancjami błędów o najwyższych indeksach modyfikacji, liczy PCFI ze wzoru (lavaan go nie wypisuje) i porównuje go z CFI, PNFI, RMSEA, AIC, BIC oraz testem różnicy χ². Liczby w tekście, w tabeli i na rysunku 1 pochodzą z tego kodu.
PCFI czterech modeli
R
# R127 – PCFI (parsimony CFI): CFI × (df modelu / df modelu bazowego)
# Dane symulowane: 350 osób, 10 pozycji skali zaangażowania w naukę (1–5):
# zaangażowanie poznawcze (P1–P5) i emocjonalne (E1–E5).
suppressPackageStartupMessages(library(lavaan))
populacja <- '
  pozn =~ 0.75*P1 + 0.70*P2 + 0.70*P3 + 0.65*P4 + 0.60*P5
  emoc =~ 0.75*E1 + 0.70*E2 + 0.70*E3 + 0.65*E4 + 0.60*E5
  pozn ~~ 0.55*emoc
'
set.seed(127)
z <- simulateData(populacja, sample.nobs = 350, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(3 + 1.1 * x), 1), 5)))

m_A <- 'zaang =~ P1 + P2 + P3 + P4 + P5 + E1 + E2 + E3 + E4 + E5'
m_B <- 'pozn =~ P1 + P2 + P3 + P4 + P5
        emoc =~ E1 + E2 + E3 + E4 + E5'
fit_B <- cfa(m_B, data = dane)
# modele C i D: model B plus 3 albo 8 kowariancji błędów o największych indeksach modyfikacji
mi <- modindices(fit_B, sort. = TRUE)
mi <- mi[mi$op == "~~", ]
head(mi[, c("lhs", "op", "rhs", "mi")], 8)
dodaj <- function(k) paste(m_B, paste(mi$lhs[1:k], "~~", mi$rhs[1:k], collapse = "\n"), sep = "\n")
modele <- list(A_jeden_czynnik = m_A, B_dwa_czynniki = m_B, C_plus_3_kow = dodaj(3), D_plus_8_kow = dodaj(8))
fity <- lapply(modele, cfa, data = dane)

tab <- t(sapply(fity, function(f) {
  fm <- fitMeasures(f, c("chisq", "df", "baseline.df", "cfi", "pnfi", "rmsea", "aic", "bic"))
  c(fm[c("chisq", "df", "cfi")], pcfi = unname(fm["cfi"] * fm["df"] / fm["baseline.df"]),
    fm[c("pnfi", "rmsea", "aic", "bic")])
}))
round(tab, 3)
unname(fitMeasures(fity[[1]], "baseline.df"))
# test różnicy chi-kwadrat B vs C
anova(fity$B_dwa_czynniki, fity$C_plus_3_kow)
Wynik w R
   lhs op rhs    mi
35  P1 ~~  P3 7.243
36  P1 ~~  P4 4.481
43  P2 ~~  P3 4.219
37  P1 ~~  P5 2.741
61  P4 ~~  E3 2.620
65  P5 ~~  E2 2.473
62  P4 ~~  E4 2.338
45  P2 ~~  P5 1.946
                  chisq df   cfi  pcfi  pnfi rmsea      aic      bic
A_jeden_czynnik 253.763 35 0.776 0.604 0.585 0.134 9772.824 9849.982
B_dwa_czynniki   35.508 34 0.998 0.754 0.729 0.011 9556.568 9637.585
C_plus_3_kow     25.875 31 1.000 0.689 0.671 0.000 9552.935 9645.526
D_plus_8_kow     17.071 26 1.000 0.578 0.568 0.000 9554.132 9666.012
[1] 45

Chi-Squared Difference Test

                    Df    AIC    BIC  Chisq Chisq diff    RMSEA Df diff
fity$C_plus_3_kow   31 9552.9 9645.5 25.875
fity$B_dwa_czynniki 34 9556.6 9637.6 35.508     9.6327 0.079479       3
                    Pr(>Chisq)
fity$C_plus_3_kow
fity$B_dwa_czynniki    0.02196 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Stosowanie do PCFI progu .90 lub .95. Przy 10 pozycjach i dwóch czynnikach PCFI nie przekroczy .756 nawet przy idealnym dopasowaniu.
- Porównywanie PCFI modeli dla różnych zestawów zmiennych – zmienia się dfB, a więc skala indeksu.
- Uznanie PCFI za pełną miarę oszczędności. Liczy tylko parametry, nie ich układ.
- Dodawanie kowariancji błędów do skutku i raportowanie samego CFI = 1.000. PCFI i BIC pokazują koszt takiego postępowania. Szerzej o tym w przewodniku CB-SEM i w haśle kowariancja reszt w SEM.
Gotowy kod porównywania modeli w lavaan znajdziesz we wpisie CB-SEM w R.
Najczęstsze pytania
Jaka wartość PCFI jest dobra?
PCFI nie ma uzgodnionego progu, bo jego maksimum zależy od liczby stopni swobody: przy 10 pozycjach i dwóch czynnikach nawet idealny model ma PCFI = .756. Indeks ten służy do porównywania modeli na tych samych danych – liczy się, który model ma wyższy PCFI, a nie, czy przekracza określoną liczbę.
Czym różni się PCFI od CFI?
CFI ocenia dopasowanie względem modelu bazowego bez względu na liczbę parametrów, więc dodanie parametru nigdy go nie obniża. PCFI mnoży CFI przez df modelu / df modelu bazowego, dlatego każdy dodatkowy parametr musi „zapłacić” wzrostem dopasowania.
Jak policzyć PCFI w lavaan?
lavaan nie wypisuje PCFI, ale można go policzyć: fm <- fitMeasures(fit, c("cfi", "df", "baseline.df")), a potem fm["cfi"] * fm["df"] / fm["baseline.df"]. AMOS podaje PCFI w zestawieniu miar oszczędności.
Czy PCFI zastępuje AIC i BIC?
Nie. Wszystkie te miary karzą za złożoność, ale robią to inaczej i nie zawsze wskazują ten sam model – w przykładzie z tego hasła PCFI i BIC wybrały model dwuczynnikowy, a AIC lekko faworyzował model z dodatkowymi kowariancjami błędów. Podawaj kilka kryteriów i rozstrzygaj merytorycznie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Mulaik, S. A., James, L. R., Van Alstine, J., Bennett, N., Lind, S., & Stilwell, C. D. (1989). Evaluation of goodness-of-fit indices for structural equation models. Psychological Bulletin, 105(3), 430–445. https://doi.org/10.1037/0033-2909.105.3.430
- Preacher, K. J. (2006). Quantifying Parsimony in Structural Equation Modeling. Multivariate Behavioral Research, 41(3), 227–259. https://doi.org/10.1207/s15327906mbr4103_1 ● Otwarty dostęp
Cytowania BibTeX
@article{bentler1990comparative, author={Bentler, P. M.}, title={{Comparative fit indexes in structural models}}, journal={Psychological Bulletin}, year={1990}, volume={107}, number={2}, pages={238--246}, doi={10.1037/0033-2909.107.2.238}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{mulaik1989evaluation, author={Mulaik, Stanley A. and James, Larry R. and Van Alstine, Judith and Bennett, Nathan and Lind, Sherri and Stilwell, C. Dean}, title={{Evaluation of goodness-of-fit indices for structural equation models}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={3}, pages={430--445}, doi={10.1037/0033-2909.105.3.430}}@article{preacher2006quantifying, author={Preacher, Kristopher J.}, title={{Quantifying Parsimony in Structural Equation Modeling}}, journal={Multivariate Behavioral Research}, year={2006}, volume={41}, number={3}, pages={227--259}, doi={10.1207/s15327906mbr4103_1}}