Czym jest modelowanie równań strukturalnych
Modelowanie równań strukturalnych (ang. structural equation modeling, SEM) to rodzina metod, które w jednym modelu łączą dwa zadania: pomiar konstruktów, których nie obserwujemy bezpośrednio, i układ zależności między nimi. Lęku, samotności czy zaangażowania nie zmierzysz linijką. Obserwujesz odpowiedzi na pozycje kwestionariusza, a konstrukt traktujesz jako zmienną ukrytą, która te odpowiedzi wyjaśnia. Bollen (2002) przegląda definicje zmiennej ukrytej i pokazuje, że ta sama idea stoi za analizą czynnikową, modelami krzywych latentnych, IRT, analizą klas ukrytych i SEM.
Model SEM ma dwie części. Model pomiarowy mówi, które pozycje mierzą który konstrukt i jak silnie (ładunki czynnikowe). Model strukturalny to zestaw równań regresji między konstruktami: kto na kogo „wpływa”, czyli – w danych przekrojowych – jakie związki zakłada teoria. Krótką definicję i przykład znajdziesz w haśle SEM w słowniku, a symbole stosowane na rysunkach – w haśle wykres ścieżkowy.
Ten tekst jest mapą całej rodziny metod. Pokazujemy, jakie są rodzaje modeli SEM, kiedy wybrać CB-SEM, a kiedy PLS-SEM, i co zyskujesz w porównaniu z analizą na średnich z pozycji. Każdy etap pracy rozwijają osobne poradniki:
- CB-SEM – założenia i interpretacja: identyfikacja, estymatory, ocena dopasowania;
- CB-SEM w R: kompletny przykład w pakiecie lavaan, z danymi do pobrania;
- PLS-SEM krok po kroku i PLS-SEM czy CB-SEM: podejście wariancyjne i porównanie obu rodzin;
- model refleksyjny czy formatywny: decyzja, od której zależy cały model pomiarowy.
Co SEM daje w porównaniu z regresją na wynikach skal
Typowa analiza w psychologii wygląda tak: liczysz średnie z pozycji każdej skali i wprowadzasz je do regresji albo analizy ścieżek. To podejście zakłada milcząco, że wyniki skal są mierzone bez błędu. SEM daje trzy rzeczy, których ta analiza nie daje:
- Korektę na błąd pomiaru. Związki między zmiennymi ukrytymi nie są osłabiane przez niepełną rzetelność skal. Pokazujemy to na liczbach w następnej sekcji.
- Test całego modelu. Model z założonymi brakami ścieżek implikuje określoną macierz kowariancji; porównanie jej z macierzą z próby (test χ² i indeksy dopasowania) mówi, czy teoria jest zgodna z danymi. Jöreskog (1969) opisał tę logikę dla konfirmacyjnej analizy czynnikowej.
- Wiele równań naraz. Efekty pośrednie, kilka zmiennych zależnych, porównanie grup i pomiary w czasie szacujesz w jednym modelu, ze wspólną oceną dopasowania i z poprawnymi błędami standardowymi.
Pierwsza z tych zalet jest najmniej oczywista, a często najważniejsza. Błąd pomiaru nie tylko osłabia pojedyncze korelacje. Gdy w regresji masz kilka predyktorów mierzonych z różną rzetelnością, „kontrola” jednej zmiennej przez drugą działa tylko częściowo, a współczynniki mogą się przesuwać w trudnym do przewidzenia kierunku. Model ze zmiennymi ukrytymi szacuje związki między konstruktami, a nie między ich niedoskonałymi wskaźnikami, pod warunkiem że model pomiarowy jest poprawny.
Ta elastyczność ma swoją cenę. MacCallum i Austin (2000) w przeglądzie zastosowań SEM w czasopismach psychologicznych uznali metodę za użyteczną w wielu planach badawczych, ale zwrócili uwagę na chroniczne problemy metodologiczne literatury stosowanej, które wymagają większej uwagi badaczy. Najważniejsze z nich omawiamy w sekcji o błędach.
Przykład: średnie z pozycji a zmienne ukryte
Przykład (dane symulowane): 300 studentów wypełniło czteropozycyjną skalę wsparcia społecznego i czteropozycyjną skalę samotności. W populacji, z której pochodzą dane, korelacja obu konstruktów wynosi −.40, a każda pozycja ma ładunek .65 – typowy dla krótkich skal kwestionariuszowych. Alfa Cronbacha wyniosła .775 dla wsparcia i .744 dla samotności.
Gdy policzysz średnie z pozycji i skorelujesz je (co odpowiada standaryzowanemu współczynnikowi w regresji z jednym predyktorem), dostaniesz r = −.304, 95% CI [−.403, −.197]. Model SEM, w którym oba konstrukty są zmiennymi ukrytymi, daje β = −.404, 95% CI [−.534, −.273], przy bardzo dobrym dopasowaniu: χ²(19) = 15.40, p = .697, CFI = 1.000, RMSEA = .000, SRMR = .023. Analiza na średnich zaniżyła związek o około jedną czwartą, bo błąd pomiaru w obu skalach osłabia korelację. Klasyczna korekta na niepełną rzetelność (podzielenie r przez pierwiastek z iloczynu rzetelności obu skal) daje −.400, czyli prawie to samo co SEM. SEM robi to jednak w ramach jednego modelu, z przedziałami ufności, testem dopasowania i możliwością dodania kolejnych zmiennych.
Czy to reguła, czy przypadek jednej próby? Powtórzyliśmy eksperyment 300 razy dla trzech poziomów ładunków (.50, .65 i .80) i trzech liczebności (100, 250 i 500 osób).
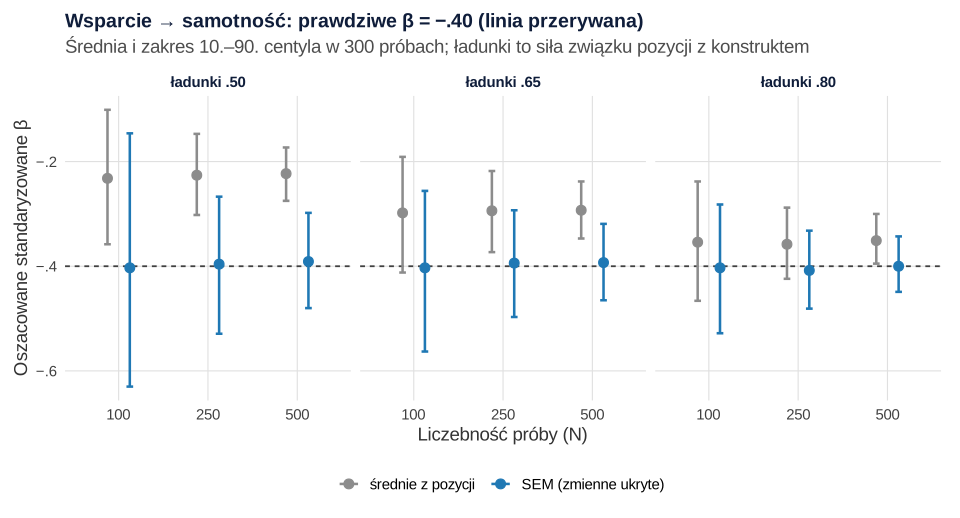
Rysunek pokazuje dwie strony tego samego kompromisu. Analiza na średnich jest systematycznie obciążona: przy ładunkach .50 (rzetelność średniej z czterech pozycji około .57) średnie oszacowanie wynosiło od −.223 do −.232 zamiast −.40, przy ładunkach .65 (rzetelność około .75) – od −.293 do −.298, a przy ładunkach .80 (rzetelność około .88) – od −.351 do −.358. Większa próba tego nie naprawia: zawęża przedział wokół złej wartości. Model SEM był w przybliżeniu nieobciążony we wszystkich warunkach (średnie od −.391 do −.408), ale płaci za to większą zmiennością. Przy ładunkach .50 i 100 osobach odchylenie standardowe oszacowań wynosiło 0.184 wobec 0.100 dla średnich, a 10% prób dawało β słabsze niż −.146; w 2% prób rozwiązanie było niedopuszczalne.
Praktyczny wniosek: SEM najwięcej daje przy skalach o umiarkowanej rzetelności, pod warunkiem że próba jest wystarczająco duża, by oszacowania były stabilne. Przy słabych wskaźnikach i małej próbie lepiej poprawić pomiar albo zwiększyć próbę, niż liczyć na to, że model „odzyska” prawdziwy związek. Szerzej o zmiennych ukrytych i błędzie pomiaru piszemy w haśle o rzetelności.
Słowniczek: osiem pojęć, bez których nie przeczytasz wyniku SEM
| Pojęcie | Co oznacza | Na rysunku |
|---|---|---|
| Zmienna jawna | zmienna mierzona bezpośrednio, np. odpowiedź na pozycję albo wynik testu | prostokąt |
| Zmienna ukryta | konstrukt, którego nie obserwujemy, wyznaczany przez kilka zmiennych jawnych | elipsa |
| Zmienna egzogeniczna i endogeniczna | egzogeniczna nie ma w modelu przyczyn (tylko z niej wychodzą strzałki), endogeniczna jest wyjaśniana przez inne zmienne | do endogenicznej prowadzi co najmniej jedna strzałka |
| Ładunek | siła związku konstruktu z pozycją; w wersji standaryzowanej zwykle .50–.90 | strzałka od elipsy do prostokąta |
| Reszta i zakłócenie | reszta to część odpowiedzi na pozycję niewyjaśniona przez konstrukt; zakłócenie – część zmiennej endogenicznej niewyjaśniona przez model | mała strzałka lub kółko przy zmiennej |
| Ścieżka | współczynnik regresji między zmiennymi; podaje się go niestandaryzowany (b) i standaryzowany (β) | strzałka jednokierunkowa |
| Efekt pośredni | iloczyn ścieżek prowadzących od X do Y przez mediator | ciąg strzałek X → M → Y |
| Stopnie swobody i dopasowanie | liczba informacji minus liczba parametrów; dodatnie df pozwalają sprawdzić, czy model odtwarza dane (CFI, RMSEA) | nie widać ich na rysunku – wynikają z brakujących strzałek |
Ostatni wiersz jest najważniejszy. To brakujące strzałki, a nie obecne, sprawiają, że model jest testowalny: każda ścieżka ustalona na zero to ograniczenie, które dane mogą potwierdzić albo podważyć. Model, w którym wszystko łączy się ze wszystkim, ma zero stopni swobody i zawsze „idealnie pasuje” – ale niczego nie testuje.
Rodzaje modeli SEM
Pod nazwą SEM kryje się wiele modeli, które różnią się tym, co jest mierzone i jakie pytanie zadajesz. Tabela pokazuje najczęstsze z nich wraz z typowym pytaniem badawczym z psychologii.
| Model | Co zawiera | Przykładowe pytanie | Gdzie więcej |
|---|---|---|---|
| Analiza ścieżek | tylko zmienne obserwowane (np. wyniki skal) | Czy stres wiąże się z wypaleniem przez brak snu? | mediacja |
| Konfirmacyjna analiza czynnikowa (CFA) | tylko model pomiarowy | Czy kwestionariusz ma trzy wymiary? | EFA i CFA |
| Pełny model SEM | model pomiarowy i strukturalny | Czy samowspółczucie wiąże się z depresyjnością przez ruminację? | CB-SEM w R |
| Model MIMIC | zmienna ukryta z przyczynami i wskaźnikami | Czy płeć wiąże się z poziomem czynnika i z odpowiedziami na pojedyncze pozycje? | model MIMIC |
| Model wielogrupowy | ten sam model w kilku grupach | Czy skala mierzy to samo u kobiet i mężczyzn? | inwariancja pomiaru |
| Model wyższego rzędu | czynnik ogólny nad czynnikami szczegółowymi | Czy cztery wymiary dobrostanu tworzą jeden czynnik ogólny? | konstrukty wyższego rzędu |
| Modele podłużne | te same konstrukty w kilku falach | Czy samotność poprzedza objawy depresyjne, czy odwrotnie? | CLPM i RI-CLPM |
Wszystkie te modele można szacować w podejściu opartym na kowariancjach (CB-SEM). Część z nich – przede wszystkim modele ścieżkowe ze zmiennymi złożonymi – szacuje się też w podejściu wariancyjnym (PLS-SEM). Wybór między nimi to druga, po modelu pomiarowym, najważniejsza decyzja.
CB-SEM czy PLS-SEM
CB-SEM szuka parametrów, które najlepiej odtwarzają macierz kowariancji, i zakłada model wspólnego czynnika: konstrukt jest przyczyną odpowiedzi. PLS-SEM tworzy z pozycji ważone sumy (kompozyty) i szacuje ścieżki tak, by maksymalizować wyjaśnioną wariancję zmiennych zależnych. Sarstedt i in. (2016) zwracają uwagę, że trzeba oddzielić rodzaj pomiaru (refleksyjny lub formatywny) od modelu estymacji (czynnik wspólny lub kompozyt). W ich symulacji PLS dawał obciążenia przy szacowaniu modeli czynnikowych, a CB-SEM – przy szacowaniu modeli kompozytowych. Dijkstra i Henseler (2015) zaproponowali spójny PLS (PLSc), który koryguje oszacowania przy pomiarze refleksyjnym i w symulacji miał obciążenie porównywalne z CB-SEM.
| Kryterium | CB-SEM | PLS-SEM |
|---|---|---|
| Cel | testowanie teorii, ocena dopasowania modelu | wyjaśnianie i przewidywanie zmiennych zależnych |
| Model konstruktu | wspólny czynnik (pomiar refleksyjny) | kompozyt; czynnik po korekcie PLSc |
| Ocena modelu | test χ², CFI, TLI, RMSEA, SRMR, reszty | R², ocena modelu pomiarowego, moc predykcyjna (PLSpredict) |
| Konstrukty formatywne | trudne (identyfikacja, MIMIC) | naturalne (tryb B) |
| Typowe oprogramowanie | lavaan, Mplus, AMOS | seminr, cSEM, SmartPLS |
Hair i in. (2019) podsumowują kryteria wyboru i raportowania PLS-SEM, m.in. uzasadnienie metody i liczebności próby oraz ocenę modelu pomiarowego i strukturalnego. Rönkkö i Evermann (2013) pokazują z kolei, że wiele rozpowszechnionych przekonań o przewagach PLS – np. o tym, że „działa w małych próbach” – nie znajduje potwierdzenia. Praktyczna reguła brzmi więc: wybór metody uzasadniaj modelem konstruktu i celem badania, a nie wielkością próby czy nienormalnością danych. Jeśli konstrukty są refleksyjne, a celem jest test teorii, pierwszym wyborem jest CB-SEM. Jeśli konstrukty są indeksami albo liczy się predykcja, rozważ PLS-SEM. Szczegółowe porównanie z symulacją znajdziesz w poradniku PLS-SEM czy CB-SEM, a przykład analizy w R – w tekście PLS-SEM w R.
Proces analizy SEM: od teorii do raportu
- Teoria i model. Zapisz hipotezy jako wykres ścieżkowy. Każda strzałka i każdy jej brak to założenie. Zaplanuj też modele alternatywne.
- Model pomiaru. Dla każdego konstruktu zdecyduj, czy wskaźniki są refleksyjne, czy formatywne, i zaplanuj co najmniej trzy dobre wskaźniki na konstrukt.
- Liczebność próby. Wolf i in. (2013) w symulacjach typowych modeli SEM uzyskali wymagane liczebności od 30 do 460 osób, zależnie od liczby wskaźników i czynników, wielkości ładunków i ścieżek oraz braków danych. Zamiast reguł kciuka uzasadnij liczebność dla swojego modelu (zob. dobór liczebności próby).
- Przygotowanie danych. Sprawdź rozkłady pozycji, braki danych i wartości odstające; przekoduj pozycje odwrócone.
- Model pomiarowy. Anderson i Gerbing (1988) zalecają, by najpierw ocenić i ewentualnie poprawić model pomiarowy (CFA), a dopiero potem model strukturalny. Sprawdź ładunki, rzetelność złożoną i trafność różnicową.
- Model strukturalny. Oszacuj ścieżki, efekty pośrednie (z bootstrapem) i R², porównaj model z modelami alternatywnymi.
- Raport. Opisz decyzje, wyniki i ograniczenia tak, by inna osoba mogła odtworzyć analizę.
Do szacowania modeli CB-SEM w R służy przede wszystkim pakiet lavaan – bezpłatne, otwarte oprogramowanie do modelowania ze zmiennymi ukrytymi (Rosseel, 2012). W tym samym celu używa się też programów komercyjnych, takich jak Mplus czy AMOS. Wyniki są porównywalne, ale nazwy indeksów i ustawienia domyślne bywają różne, dlatego w raporcie zawsze podawaj program i jego wersję.
Jak czytać model SEM w cudzym artykule
Nawet jeśli sam nie planujesz analizy SEM, prędzej czy później zrecenzujesz albo zacytujesz badanie, które ją stosuje. Zanim przyjmiesz wnioski, zadaj siedem pytań:
- Czy model wynika z teorii? Czy autorzy uzasadniają każdą ścieżkę i rozważają modele alternatywne, czy pokazują tylko jeden, dobrze dopasowany model?
- Czy oceniono model pomiarowy? Czy podano ładunki, rzetelność i korelacje konstruktów, zanim przedstawiono ścieżki?
- Jaki estymator i dlaczego? Czy pasuje do skali odpowiedzi i rozkładów, a braki danych opisano i obsłużono?
- Czy raportują test χ², a nie tylko wybrane indeksy? Czy podano RMSEA z przedziałem ufności i informację o lokalnym dopasowaniu?
- Czy model modyfikowano? Ile parametrów dodano na podstawie indeksów modyfikacji i czy wyniki potwierdzono w niezależnej próbie?
- Czy schemat badania uzasadnia kierunek strzałek? W danych przekrojowych model z odwróconymi strzałkami może pasować identycznie.
- Czy można odtworzyć analizę? Czy w artykule lub materiałach dodatkowych jest macierz korelacji, kod albo dane?
Odpowiedź „nie” na pierwsze, czwarte lub szóste pytanie to poważny sygnał ostrzegawczy. Brak macierzy korelacji jest niestety częsty, ale łatwy do naprawienia – możesz poprosić o nią autorów.
Co powinien zawierać raport
Standardy JARS-Quant Amerykańskiego Towarzystwa Psychologicznego mają osobny moduł dla SEM (Appelbaum i in., 2018). McDonald i Ho (2002) zalecają, by raport zawierał szczegółowe uzasadnienie modelu i modeli alternatywnych, opis identyfikowalności, sposób postępowania z nienormalnością i brakami danych, pełny zestaw parametrów z błędami standardowymi oraz – często – macierz korelacji i reszty obok indeksów dopasowania. Szczegółową listę kontrolną podajemy w przewodniku CB-SEM – założenia i interpretacja, a tabelę dopasowania – w haśle tabela dopasowania modelu w APA.
Wzór akapitu z opisem analizy w sekcji metody (dostosuj nazwy i liczby do swojego badania):
Kiedy SEM nie jest dobrym wyborem
- Nie masz teorii modelu. SEM bez hipotez o brakujących ścieżkach zamienia się w szukanie dobrze dopasowanego modelu. Do eksploracji struktury skali lepsza jest eksploracyjna analiza czynnikowa.
- Każdy konstrukt ma jeden wskaźnik. Wtedy zostaje analiza ścieżek – bez korekty na błąd pomiaru.
- Próba jest bardzo mała w stosunku do modelu. Rozwiązania niedopuszczalne i brak zbieżności to sygnał, że model jest zbyt złożony dla danych; uprość model albo zwiększ próbę.
- Dane są zagnieżdżone, a model tego nie uwzględnia. Uczniowie w klasach, pacjenci u terapeutów czy pomiary w dzienniczku nie są niezależnymi obserwacjami. Zwykły model SEM zaniży wtedy błędy standardowe; potrzebny jest model wielopoziomowy (zob. model wielopoziomowy krok po kroku) albo wielopoziomowa wersja SEM.
- Odpowiedzi mają dwie–trzy kategorie, a analizujesz je jak zmienne ciągłe. SEM nadal jest dobrym wyborem, ale z estymatorem dla danych porządkowych; zwykła metoda największej wiarygodności zaniży wtedy ładunki.
- Pytanie jest przyczynowe, a dane przekrojowe. SEM nie zamieni korelacji w przyczynowość – kierunek strzałek pochodzi z teorii i schematu badania, nie z analizy.
Najczęstsze błędy w analizach SEM
- Traktowanie dopasowania jako dowodu teorii. Modele równoważne, z odwróconymi strzałkami, pasują do danych identycznie.
- Mechaniczne progi. CFI powyżej .95 nie gwarantuje poprawnego modelu; model z pominiętym parametrem może spełniać progi i dawać obciążone ścieżki.
- Brak modelu pomiarowego przed strukturalnym. Bez oceny CFA nie wiesz, czy problem leży w pomiarze, czy w teorii.
- Modyfikacje według indeksów modyfikacji bez uzasadnienia. Model dopasowany do jednej próby rzadko replikuje się w kolejnej.
- Wskaźniki formatywne modelowane refleksyjnie. Indeks zdarzeń lub zachowań to nie skala refleksyjna.
- Wybór PLS-SEM „bo próba jest mała”. Liczebność nie jest uzasadnieniem metody.
- Raport bez macierzy korelacji i opisu decyzji. Czytelnik nie może sprawdzić ani odtworzyć analizy.
Jeśli planujesz badanie z modelem SEM albo musisz odpowiedzieć na uwagi recenzenta do takiej analizy, możemy pomóc w specyfikacji, obliczeniach i opisie wyników w ramach analiz statystycznych dla badaczy.
Przykład w R
Kod odtwarza przykład i symulację z tego przewodnika. Pełną analizę modelu SEM krok po kroku (dopasowanie, modyfikacje, bootstrap, tabela APA) pokazujemy w poradniku o CB-SEM w pakiecie lavaan.
1. Średnie z pozycji a zmienne ukryte: przykład i symulacja
R
# P5, przepis 1: ten sam związek oszacowany na średnich z pozycji (analiza ścieżek) i na zmiennych ukrytych (SEM)
# Dane symulowane: wsparcie społeczne (X) -> poczucie samotności (Y), prawdziwa korelacja konstruktów −.40
library(lavaan)
pop <- function(l) sprintf('                       # model populacyjny: wszystkie wariancje ustalone, X i Y mają wariancję 1
  X =~ %1$s*x1 + %1$s*x2 + %1$s*x3 + %1$s*x4
  Y =~ %1$s*y1 + %1$s*y2 + %1$s*y3 + %1$s*y4
  Y ~ -0.40*X
  X ~~ 1*X
  Y ~~ 0.84*Y
  x1 ~~ %2$s*x1; x2 ~~ %2$s*x2; x3 ~~ %2$s*x3; x4 ~~ %2$s*x4
  y1 ~~ %2$s*y1; y2 ~~ %2$s*y2; y3 ~~ %2$s*y3; y4 ~~ %2$s*y4', l, 1 - l^2)
model <- '
  X =~ x1 + x2 + x3 + x4
  Y =~ y1 + y2 + y3 + y4
  Y ~ X'

alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }   # alfa Cronbacha

# Jedno badanie: N = 300, ładunki .65
set.seed(513)
d <- simulateData(pop(0.65), sample.nobs = 300)
srX <- rowMeans(d[, paste0("x", 1:4)]); srY <- rowMeans(d[, paste0("y", 1:4)])
aX <- alfa(d[, paste0("x", 1:4)]); aY <- alfa(d[, paste0("y", 1:4)])
round(c(alfa_X = aX, alfa_Y = aY), 3)
ct <- cor.test(srX, srY)
round(c(beta_srednie = unname(ct$estimate), dolna = ct$conf.int[1], gorna = ct$conf.int[2]), 3)
f <- sem(model, data = d)
s <- standardizedSolution(f); s <- s[s$op == "~", ]
round(c(beta_SEM = s$est.std, dolna = s$ci.lower, gorna = s$ci.upper), 3)
round(fitMeasures(f, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
# Korekta na niepełną rzetelność (wzór Spearmana): r / sqrt(alfa_X * alfa_Y)
round(unname(ct$estimate) / sqrt(aX * aY), 3)

# Symulacja: ładunki .50 / .65 / .80 i N = 100 / 250 / 500, po 300 powtórzeń
set.seed(5150)
warunki <- expand.grid(ladunek = c(0.50, 0.65, 0.80), n = c(100, 250, 500))
sym <- do.call(rbind, lapply(seq_len(nrow(warunki)), function(i) {
  l <- warunki$ladunek[i]; n <- warunki$n[i]
  w <- t(replicate(300, {
    d <- simulateData(pop(l), sample.nobs = n)
    r_sr <- cor(rowMeans(d[, 1:4]), rowMeans(d[, 5:8]))
    f <- suppressWarnings(sem(model, data = d))
    ok <- lavInspect(f, "converged") && suppressWarnings(lavInspect(f, "post.check"))
    b <- if (lavInspect(f, "converged")) standardizedSolution(f)$est.std[standardizedSolution(f)$op == "~"] else NA
    c(r_sr, b, ok)
  }))
  data.frame(ladunek = l, n = n, metoda = c("średnie z pozycji", "SEM (zmienne ukryte)"),
             srednia = c(mean(w[, 1]), mean(w[, 2], na.rm = TRUE)),
             sd = c(sd(w[, 1]), sd(w[, 2], na.rm = TRUE)),
             p10 = c(quantile(w[, 1], .10), quantile(w[, 2], .10, na.rm = TRUE)),
             p90 = c(quantile(w[, 1], .90), quantile(w[, 2], .90, na.rm = TRUE)),
             niedopuszczalne = c(0, mean(w[, 3] == 0)))
}))
sym[, 4:8] <- round(sym[, 4:8], 3)
sym
write.csv(sym, "kod/p5-symulacja.csv", row.names = FALSE)
# Rzetelność (omega) średniej z czterech pozycji przy danym ładunku
sapply(c(0.50, 0.65, 0.80), function(l) round((4 * l)^2 / ((4 * l)^2 + 4 * (1 - l^2)), 3))
Wynik w R
alfa_X alfa_Y
 0.775  0.744
beta_srednie        dolna        gorna
      -0.304       -0.403       -0.197
beta_SEM    dolna    gorna
  -0.404   -0.534   -0.273
 chisq     df pvalue    cfi  rmsea   srmr
15.401 19.000  0.697  1.000  0.000  0.023
[1] -0.4
   ladunek   n               metoda srednia    sd    p10    p90 niedopuszczalne
1     0.50 100    średnie z pozycji  -0.232 0.100 -0.358 -0.101            0.00
2     0.50 100 SEM (zmienne ukryte)  -0.403 0.184 -0.630 -0.146            0.02
3     0.65 100    średnie z pozycji  -0.298 0.089 -0.412 -0.191            0.00
4     0.65 100 SEM (zmienne ukryte)  -0.403 0.123 -0.563 -0.256            0.00
5     0.80 100    średnie z pozycji  -0.354 0.090 -0.466 -0.238            0.00
6     0.80 100 SEM (zmienne ukryte)  -0.403 0.101 -0.528 -0.282            0.00
7     0.50 250    średnie z pozycji  -0.226 0.062 -0.302 -0.147            0.00
8     0.50 250 SEM (zmienne ukryte)  -0.396 0.112 -0.529 -0.267            0.00
9     0.65 250    średnie z pozycji  -0.294 0.061 -0.373 -0.218            0.00
10    0.65 250 SEM (zmienne ukryte)  -0.394 0.080 -0.497 -0.293            0.00
11    0.80 250    średnie z pozycji  -0.358 0.055 -0.424 -0.288            0.00
12    0.80 250 SEM (zmienne ukryte)  -0.408 0.061 -0.481 -0.332            0.00
13    0.50 500    średnie z pozycji  -0.223 0.042 -0.275 -0.173            0.00
14    0.50 500 SEM (zmienne ukryte)  -0.391 0.072 -0.480 -0.298            0.00
15    0.65 500    średnie z pozycji  -0.293 0.041 -0.347 -0.238            0.00
16    0.65 500 SEM (zmienne ukryte)  -0.393 0.055 -0.465 -0.319            0.00
17    0.80 500    średnie z pozycji  -0.351 0.037 -0.395 -0.300            0.00
18    0.80 500 SEM (zmienne ukryte)  -0.400 0.042 -0.449 -0.343            0.00
[1] 0.571 0.745 0.877
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lavaan; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym różni się model pomiarowy od strukturalnego w SEM?
Model pomiarowy opisuje, jak konstrukty (zmienne ukryte) są mierzone przez pozycje kwestionariusza – to ładunki czynnikowe i wariancje błędów. Model strukturalny opisuje związki między konstruktami, czyli równania regresji, efekty pośrednie i korelacje. W analizie najpierw ocenia się model pomiarowy (CFA), a dopiero potem strukturalny.
Kiedy warto użyć modelowania równań strukturalnych zamiast regresji?
Gdy konstrukty mierzysz kilkoma pozycjami i chcesz oszacować związki między nimi bez osłabienia przez błąd pomiaru, gdy model zawiera kilka zmiennych zależnych lub efekty pośrednie albo gdy chcesz przetestować dopasowanie całej teorii. Jeśli każdy konstrukt ma jeden wskaźnik i nie masz hipotez o strukturze, wystarczy regresja lub analiza ścieżek.
Jakie są rodzaje modeli SEM?
Najczęściej spotykane to analiza ścieżek (tylko zmienne obserwowane), konfirmacyjna analiza czynnikowa (tylko model pomiarowy), pełny model SEM, model MIMIC, modele wielogrupowe (np. do badania inwariancji), modele wyższego rzędu i modele podłużne, takie jak cross-lagged. Wszystkie można szacować w CB-SEM, a część z nich także w PLS-SEM.
Jakiego programu użyć do modelowania równań strukturalnych?
Modele CB-SEM szacuje się najczęściej w pakiecie lavaan dla R (bezpłatnym i otwartym) albo w programach komercyjnych, takich jak Mplus i AMOS; modele PLS-SEM – m.in. w pakietach seminr i cSEM dla R oraz w SmartPLS. Wybór programu ma mniejsze znaczenie niż poprawna specyfikacja modelu, ale w raporcie zawsze podaj program, wersję i estymator.
Powiązane hasła
Przeczytaj też
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →PoradnikModel refleksyjny czy formatywny?
Kryteria decyzji Jarvis i in. (2003), symulacja skutków błędnej specyfikacji modelu pomiaru i model MIMIC w lavaan – z opisem do artykułu.
Czytaj →Planujesz badanie z modelem równań strukturalnych?
Pomożemy przełożyć teorię na model, dobrać metodę i liczebność próby, przeprowadzić analizę i przygotować jej opis do artykułu lub projektu.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Bollen, K. A. (2002). Latent variables in psychology and the social sciences. Annual Review of Psychology, 53(1), 605–634. https://doi.org/10.1146/annurev.psych.53.100901.135239
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika, 34(2), 183–202. https://doi.org/10.1007/bf02289343
- MacCallum, R. C., & Austin, J. T. (2000). Applications of structural equation modeling in psychological research. Annual Review of Psychology, 51(1), 201–226. https://doi.org/10.1146/annurev.psych.51.1.201
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Rönkkö, M., & Evermann, J. (2013). A critical examination of common beliefs about partial least squares path modeling. Organizational Research Methods, 16(3), 425–448. https://doi.org/10.1177/1094428112474693
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007 ● Otwarty dostęp
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. https://doi.org/10.1177/0013164413495237 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{anderson1988structural, author={Anderson, James C. and Gerbing, David W.}, title={{Structural equation modeling in practice: A review and recommended two-step approach}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={411--423}, doi={10.1037/0033-2909.103.3.411}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{bollen2002latent, author={Bollen, Kenneth A.}, title={{Latent variables in psychology and the social sciences}}, journal={Annual Review of Psychology}, year={2002}, volume={53}, number={1}, pages={605--634}, doi={10.1146/annurev.psych.53.100901.135239}}@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{joreskog1969general, author={Jöreskog, K. G.}, title={{A general approach to confirmatory maximum likelihood factor analysis}}, journal={Psychometrika}, year={1969}, volume={34}, number={2}, pages={183--202}, doi={10.1007/bf02289343}}@article{maccallum2000applications, author={MacCallum, Robert C. and Austin, James T.}, title={{Applications of structural equation modeling in psychological research}}, journal={Annual Review of Psychology}, year={2000}, volume={51}, number={1}, pages={201--226}, doi={10.1146/annurev.psych.51.1.201}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{ronkko2013critical, author={Rönkkö, Mikko and Evermann, Joerg}, title={{A critical examination of common beliefs about partial least squares path modeling}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={3}, pages={425--448}, doi={10.1177/1094428112474693}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{sarstedt2016estimation, author={Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M. and Thiele, Kai O. and Gudergan, Siegfried P.}, title={{Estimation issues with PLS and CBSEM: Where the bias lies!}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={3998--4010}, doi={10.1016/j.jbusres.2016.06.007}}@article{wolf2013sample, author={Wolf, Erika J. and Harrington, Kelly M. and Clark, Shaunna L. and Miller, Mark W.}, title={{Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety}}, journal={Educational and Psychological Measurement}, year={2013}, volume={73}, number={6}, pages={913--934}, doi={10.1177/0013164413495237}}