Co to jest SRMR?
SRMR (ang. standardized root mean square residual, standaryzowany pierwiastek średniego kwadratu reszt) to wskaźnik dopasowania modelu w modelowaniu równań strukturalnych i w konfirmacyjnej analizie czynnikowej. Mówi, o ile średnio korelacje odtworzone przez model różnią się od korelacji zaobserwowanych w danych. SRMR = 0 oznacza, że model odtwarza korelacje bez błędu. Im wyższa wartość, tym większe przeciętne rozbieżności.
SRMR jest bezwzględnym wskaźnikiem dopasowania. Nie porównuje Twojego modelu z modelem bazowym, jak CFI czy TLI. Nie zawiera też kary za złożoność, jak RMSEA. To po prostu „przeciętna reszta” w metryce korelacji, dlatego łatwo go zrozumieć: SRMR = .05 to mniej więcej typowa rozbieżność rzędu pięciu setnych w korelacji.
Wzór i sposób liczenia
Model SEM przewiduje macierz kowariancji zmiennych obserwowanych (Σ̂). Program porównuje ją z macierzą z próby (S). Każdą różnicę dzieli przez iloczyn odchyleń standardowych, więc reszty trafiają do metryki korelacji. Potem podnosi je do kwadratu, uśrednia i wyciąga pierwiastek:
gdzie p to liczba zmiennych obserwowanych, a p(p + 1)/2 to liczba niepowtarzalnych elementów macierzy (wariancje i kowariancje). Przy 8 pozycjach skali jest ich 36. Programy różnią się szczegółami. Wersja Bentlera (domyślna w lavaan i EQS) uśrednia także elementy przekątnej. Inne wersje liczą tylko korelacje albo dołączają reszty średnich. Wynik może się więc nieco różnić między programami. W przykładzie niżej ten sam model ma SRMR = .059 w wersji Bentlera i .066 bez przekątnej.
Poszczególne składniki wzoru to reszty korelacyjne. W tabeli nazywa się je zwykle macierzą reszt (uwaga: nie są to reszty standaryzowane w sensie z, które dzieli się przez błąd standardowy). SRMR streszcza tę macierz jedną liczbą. McDonald i Ho (2002) zalecają dlatego, aby w raporcie obok wskaźników dopasowania pokazywać także rozbieżności, bo czytelnik może wtedy sam ocenić, gdzie model nie pasuje.
Jak interpretować SRMR
Najczęściej cytowany próg pochodzi z symulacji Hu i Bentlera (1999): SRMR bliskie .08 lub niższe, oceniane razem z drugim wskaźnikiem (np. CFI lub RMSEA). Wartości poniżej .05 zwykle opisuje się jako bardzo dobre dopasowanie. Marsh i in. (2004) przestrzegają jednak przed traktowaniem tych progów jak „złotych reguł”, bo odpowiadają one konkretnym warunkom symulacji. Trzy własności SRMR są ważne w praktyce:
- Zależy od liczebności próby. Nawet idealnie poprawny model ma w małej próbie SRMR wyraźnie większe od zera, bo korelacje z próby różnią się od populacyjnych przez sam błąd losowy (rysunek 1).
- Jest średnią, więc rozmywa lokalne problemy. Jedna źle opisana pozycja może dawać duże reszty w kilku komórkach, a SRMR i tak zmieści się pod progiem, jeśli pozostałe 30 komórek pasuje dobrze.
- Dobrze działa w dużych modelach. Maydeu-Olivares i in. (2018) pokazali, że przedziały ufności i testy bliskiego dopasowania oparte na SRMR były trafne przy modelach od 10 do 60 zmiennych, a te oparte na RMSEA – tylko w małych modelach.
Klasycznie SRMR jest liczbą opisową bez testu. Nowsze programy podają jednak także jego błąd standardowy, test dokładnego dopasowania oraz nieobciążoną wersję wskaźnika (uSRMR) z 90% CI i testem bliskiego dopasowania (w lavaan: lavResiduals(), element summary). Pavlov i in. (2021) pokazali, że przy danych normalnych taki test trzyma poziom błędu I rodzaju lepiej niż klasyczny test chi-kwadrat. Przy danych nienormalnych był trafny głównie w małych modelach.
Przykład: SRMR pod progiem, a model wciąż błędny
Trzystu studentów (dane symulowane) wypełniło 8 pozycji skali wypalenia akademickiego (1–7): cztery pozycje wyczerpania (w1–w4) i cztery cynizmu (c1–c4). Pozycja c4 („Wątpię w sens nauki, bo jestem wykończony”) w populacji ładuje oba czynniki. Model M1 to standardowa dwuczynnikowa CFA bez tego ładunku krzyżowego.
| Model | χ²(df) | p | CFI | RMSEA | SRMR |
|---|---|---|---|---|---|
| M1: dwa czynniki, bez ładunku krzyżowego | 41.44 (19) | .002 | .961 | .063 | .059 |
| M2: + ładunek wyczerpania na c4 | 16.98 (18) | .524 | 1.000 | .000 | .024 |
Według progu .08 model M1 „pasuje”. Suma kwadratów 36 reszt wynosi jednak 0.124, a cztery największe reszty dotyczą tej samej pozycji: c4–w4 = .161, c4–w2 = .152, c4–w1 = .150 i c4–w3 = .135. Razem dają 72.5% sumy kwadratów, na której opiera się SRMR. Taki układ reszt (jedna pozycja koreluje z drugim czynnikiem silniej, niż przewiduje model) wskazuje na brakujący ładunek krzyżowy. Ten sam sygnał dają indeksy modyfikacji. W M2 standaryzowany ładunek krzyżowy wynosi .33 (SE = 0.06), p < .001, a SRMR spada do .024. Dla M1 lavaan podaje też test dokładnego dopasowania oparty na SRMR (z = 4.58, p < .001) oraz uSRMR = .051, 90% CI [.031, .070]. Przedział obejmuje wartość .05, więc test bliskiego dopasowania nie odrzuca modelu (p = .479). Oba wyniki nie wskazują jednak, w którym miejscu model zawodzi – to widać dopiero w resztach.
W prawdziwym badaniu dodanie ładunku krzyżowego wymaga uzasadnienia treściowego (tu: dwuznaczne sformułowanie pozycji). Inna możliwa decyzja to przeredagowanie albo usunięcie pozycji. Sam spadek SRMR nie wystarcza jako argument.
SRMR a liczebność próby
Rysunek 1 pokazuje symulację dla tych samych dwóch modeli przy liczebności od 100 do 1600 osób.
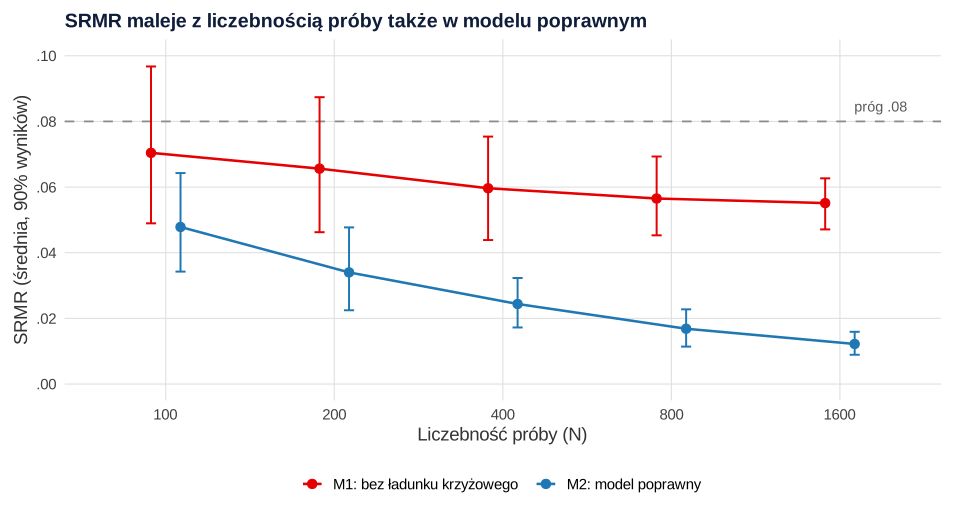
Model poprawny przy N = 100 ma średnio SRMR = .048, a przy N = 1600 – .012. Wynik .048 nie wskazuje więc na błąd modelu, tylko na małą próbę. Model błędny wraz ze wzrostem próby zbliża się do swojej wartości populacyjnej (.055 przy N = 1600). Średnio nie przekracza progu .08 przy żadnej liczebności. SRMR pod progiem nie dowodzi, że model jest poprawny. Przy małej próbie niewielka różnica SRMR między modelami może też wynikać z samego przypadku.
Jak opisać SRMR w pracy (APA)
Podaj SRMR razem z χ², df, p, CFI i RMSEA z 90% CI. Napisz, jakim programem i estymatorem go policzono, bo definicje się różnią. Gdy dopasowanie poprawiasz, opisz, na podstawie których reszt to zrobiłeś. Zestawienie kilku modeli najlepiej pokazać w tabeli dopasowania modelu w APA.
SRMR w R (lavaan)
Kod tworzy dane z przykładu, dopasowuje oba modele, liczy SRMR „ręcznie” z macierzy reszt i sprawdza, które reszty mają największy udział. Liczby w tekście pochodzą z tego kodu, a rysunek 1 – z osobnej symulacji (ten sam model populacyjny, 200 powtórzeń dla każdej liczebności).
SRMR z wyniku lavaan i z macierzy reszt
R
suppressPackageStartupMessages(library(lavaan))   # CFA i wskaźniki dopasowania

# Dane symulowane: 300 studentów, 8 pozycji skali wypalenia akademickiego (1–7):
# wyczerpanie (w1–w4) i cynizm (c1–c4). W populacji pozycja c4 („Wątpię w sens nauki,
# bo jestem wykończony”) ładuje oba czynniki – model M1 tego ładunku krzyżowego nie ma.
set.seed(3)
populacja <- '
  wyczerpanie =~ 0.75*w1 + 0.70*w2 + 0.65*w3 + 0.60*w4 + 0.35*c4
  cynizm      =~ 0.70*c1 + 0.75*c2 + 0.65*c3 + 0.45*c4
  wyczerpanie ~~ 0.40*cynizm
'
z <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.3 * x), 1), 7)))

m1 <- 'wyczerpanie =~ w1 + w2 + w3 + w4
       cynizm      =~ c1 + c2 + c3 + c4'
m2 <- paste(m1, '\n wyczerpanie =~ c4')
fit1 <- cfa(m1, data = dane)
fit2 <- cfa(m2, data = dane)

# 1. SRMR i inne wskaźniki obu modeli
round(rbind(M1 = fitMeasures(fit1, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")),
            M2 = fitMeasures(fit2, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))), 3)

# 2. SRMR „ręcznie”: reszty korelacyjne (wersja Bentlera), średnia z p(p + 1)/2 = 36 elementów
S     <- lavInspect(fit1, "sampstat")$cov
Sigma <- fitted(fit1)$cov
D     <- diag(1 / sqrt(diag(S)))
reszty <- D %*% (S - Sigma) %*% D
dimnames(reszty) <- dimnames(S)
dolny <- reszty[lower.tri(reszty, diag = TRUE)]
c(elementy = length(dolny), suma_kwadratow = sum(dolny^2), srmr_recznie = sqrt(mean(dolny^2)))

# 3. Które reszty „robią” SRMR? Pięć największych |reszt| i ich udział w sumie kwadratów
r <- reszty; r[upper.tri(r)] <- NA
tab <- as.data.frame(as.table(r)); tab <- tab[!is.na(tab$Freq), ]
tab$udzial <- tab$Freq^2 / sum(tab$Freq^2)
tab <- tab[order(-abs(tab$Freq)), ]
head(transform(tab, Freq = round(Freq, 3), udzial = round(udzial, 3)), 5)
round(c(udzial_4_reszt_c4 = sum(tab$udzial[tab$Var1 == "c4" & grepl("^w", tab$Var2)])), 3)

# 4. Ładunek krzyżowy w M2
pe <- standardizedSolution(fit2)
pe[pe$lhs == "wyczerpanie" & pe$rhs == "c4", c("lhs", "op", "rhs", "est.std", "se", "pvalue")]

# 5. SRMR ze wszystkich elementów (lavaan, Bentler) a wersja bez przekątnej
round(c(srmr_bentler = unname(fitMeasures(fit1, "srmr_bentler")),
        srmr_bez_przekatnej = sqrt(mean(reszty[lower.tri(reszty)]^2))), 3)

# 6. Test dokładnego dopasowania i przedział ufności dla SRMR (M1)
lavResiduals(fit1)$summary
Wynik w R
    chisq df pvalue   cfi rmsea  srmr
M1 41.441 19  0.002 0.961 0.063 0.059
M2 16.980 18  0.524 1.000 0.000 0.024
      elementy suma_kwadratow   srmr_recznie
   36.00000000     0.12376186     0.05863301
   Var1 Var2   Freq udzial
32   c4   w4  0.161  0.209
16   c4   w2  0.152  0.188
8    c4   w1  0.150  0.181
24   c4   w3  0.135  0.148
15   c3   w2 -0.078  0.049
udzial_4_reszt_c4
            0.725
          lhs op rhs est.std    se pvalue
9 wyczerpanie =~  c4   0.328 0.061      0
       srmr_bentler srmr_bez_przekatnej
              0.059               0.066
                          cov
srmr                    0.059
srmr.se                 0.006
srmr.exactfit.z         4.584
srmr.exactfit.pvalue    0.000
usrmr                   0.051
usrmr.se                0.012
usrmr.ci.lower          0.031
usrmr.ci.upper          0.070
usrmr.closefit.h0.value 0.050
usrmr.closefit.z        0.053
usrmr.closefit.pvalue   0.479
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „SRMR < .08, więc model jest dobry”. Średnia może ukryć duże reszty skupione wokół jednej pozycji. Zawsze przejrzyj macierz reszt.
- Porównywanie SRMR z różnych programów bez komentarza. Wersja Bentlera, wersja bez przekątnej i wersja z resztami średnich dają różne liczby.
- Ocena małej próby według tych samych progów co dużej. Przy N = 100 nawet model poprawny ma SRMR bliskie .05.
- Raportowanie samego SRMR. Podawaj go obok χ², CFI i RMSEA. Każdy wskaźnik jest wrażliwy na inny rodzaj błędu.
- Poprawianie modelu „pod SRMR” przez dodawanie kowariancji reszt bez uzasadnienia treściowego. Taki model gorzej się replikuje. W konfirmacyjnej części pracy opisz każdą zmianę.
- Mylenie SRMR w CB-SEM i w PLS-SEM. W PLS SRMR liczy się z macierzy odtworzonej przez model kompozytowy i ocenia razem z dULS i dG. Progów z CB-SEM nie przenoś tam automatycznie.
Pełną ścieżkę oceny modelu – od dopasowania przez reszty po interpretację parametrów – opisuje poradnik CB-SEM krok po kroku, a kod do całej analizy – CB-SEM w R.
Najczęstsze pytania
Jaka wartość SRMR oznacza dobre dopasowanie modelu?
Najczęściej przyjmuje się, za Hu i Bentlerem (1999), że SRMR do około .08 – oceniany razem z drugim wskaźnikiem, np. CFI – świadczy o akceptowalnym dopasowaniu, a wartości poniżej .05 o bardzo dobrym. To reguła kciuka, a nie test: w małej próbie nawet model poprawny ma SRMR bliskie .05, a model z wyraźnym błędem może mieć SRMR poniżej .08.
Czym SRMR różni się od RMSEA?
SRMR to przeciętna reszta w metryce korelacji – opisuje, jak daleko model jest od danych, bez kary za liczbę parametrów. RMSEA opiera się na statystyce χ² i stopniach swobody, więc nagradza oszczędność modelu i ma przedział ufności. W dużych modelach przedziały i testy oparte na SRMR okazały się trafniejsze niż oparte na RMSEA.
Dlaczego SRMR w R wychodzi inaczej niż w innym programie?
Programy używają różnych definicji: wersja Bentlera (lavaan, EQS) uśrednia reszty z całej macierzy razem z przekątną, inne liczą tylko korelacje albo dołączają reszty średnich. Różnice bywają rzędu kilku tysięcznych do setnych, dlatego w pracy podaj program, wersję i estymator.
Co zrobić, gdy SRMR jest dobre, a test chi-kwadrat istotny?
Przejrzyj macierz reszt korelacyjnych i indeksy modyfikacji. Jeśli największe reszty skupiają się wokół jednej pozycji albo pary pozycji, model ma lokalny błąd, który SRMR uśrednił. Zmianę modelu wprowadzaj tylko wtedy, gdy ma uzasadnienie treściowe, i opisz ją w pracy.
Czy SRMR można stosować w PLS-SEM?
Tak, ale liczy się go z macierzy odtworzonej przez model kompozytowy i ocenia razem z odległościami dULS i dG, najlepiej z testem bootstrapowym. Progów wypracowanych w CB-SEM nie przenoś automatycznie do PLS.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Maydeu-Olivares, A., Shi, D., & Rosseel, Y. (2018). Assessing fit in structural equation models: A Monte-Carlo evaluation of RMSEA versus SRMR confidence intervals and tests of close fit. Structural Equation Modeling: A Multidisciplinary Journal, 25(3), 389–402. https://doi.org/10.1080/10705511.2017.1389611 ● Otwarty dostęp: pełny tekst
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Pavlov, G., Maydeu-Olivares, A., & Shi, D. (2021). Using the standardized root mean squared residual (SRMR) to assess exact fit in structural equation models. Educational and Psychological Measurement, 81(1), 110–130. https://doi.org/10.1177/0013164420926231 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{maydeuolivares2018assessing, author={Maydeu-Olivares, Alberto and Shi, Dexin and Rosseel, Yves}, title={{Assessing fit in structural equation models: A Monte-Carlo evaluation of RMSEA versus SRMR confidence intervals and tests of close fit}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2018}, volume={25}, number={3}, pages={389--402}, doi={10.1080/10705511.2017.1389611}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{pavlov2021using, author={Pavlov, Goran and Maydeu-Olivares, Alberto and Shi, Dexin}, title={{Using the standardized root mean squared residual (SRMR) to assess exact fit in structural equation models}}, journal={Educational and Psychological Measurement}, year={2021}, volume={81}, number={1}, pages={110--130}, doi={10.1177/0013164420926231}}