Co to jest hierarchiczna zmienna latentna?
Hierarchiczna zmienna latentna (konstrukt wyższego rzędu, ang. higher-order construct, hierarchical latent variable) to zmienna ukryta, której wskaźnikami nie są pozycje kwestionariusza, tylko inne zmienne latentne. W najczęstszym przypadku – modelu czynnikowym drugiego rzędu – kilka czynników pierwszego rzędu (np. wymiarów skali) jest wyjaśnianych przez jeden czynnik ogólny. Przykład z psychologii: dobrostan psychiczny jako czynnik ogólny nad autonomią, poczuciem kompetencji, relacjami i poczuciem sensu.
Konstrukt wyższego rzędu pozwala jednocześnie mówić o ogólnym poziomie konstruktu i o jego wymiarach. Rindskopf i Rose (1988) pokazali, jak testować takie modele w konfirmacyjnej analizie czynnikowej i jak umieścić je w hierarchii modeli, której dopasowanie można porównywać. Szersze omówienie, także dla PLS-SEM, znajdziesz w poradniku modelowanie konstruktów wyższego rzędu.
Jak zbudowany jest model drugiego rzędu?
Model ma dwa piętra równań. Pozycja x zależy od swojego wymiaru η (ładunek λ1), a wymiar – od czynnika ogólnego ξ (ładunek λ2):
ε to wariancja unikatowa pozycji, a ζ (zakłócenie czynnika pierwszego rzędu) to specyfika wymiaru – ta część np. autonomii, której nie wyjaśnia dobrostan ogólny. Wpływ czynnika ogólnego na pozycję jest pośredni i wynosi λ1 × λ2 (w jednostkach standaryzowanych). Model drugiego rzędu zakłada więc, że korelacje między wymiarami w całości wynikają z czynnika ogólnego.
W praktyce spotkasz cztery typy konstruktów wyższego rzędu, zależnie od tego, czy relacje na każdym piętrze są refleksyjne, czy formatywne. Najczęstszy w psychologii jest typ refleksyjno-refleksyjny, opisany wyżej. W typie refleksyjno-formatywnym wymiary współtworzą konstrukt ogólny, tak jak formatywna zmienna latentna powstaje ze swoich wskaźników. Sarstedt i in. (2019) opisują, jak w PLS-SEM określać, szacować i walidować oba typy metodą powtarzanych wskaźników i metodą dwuetapową.
Zwróć uwagę na identyfikację. Czynnik drugiego rzędu potrzebuje co najmniej trzech wymiarów. Przy dwóch wymiarach trzeba nałożyć dodatkowe ograniczenie, np. równe ładunki drugiego rzędu. Przy trzech wymiarach model jest zidentyfikowany, ale ma dokładnie takie samo dopasowanie jak model trzech skorelowanych czynników. Trzy korelacje zostają zastąpione trzema ładunkami, więc dopasowanie nie może rozstrzygnąć, który model jest lepszy.
Przykład: dobrostan psychiczny i jego cztery wymiary
450 osób (dane symulowane) wypełniło 12-pozycyjną skalę dobrostanu (1–7) z czterema wymiarami po trzy pozycje. Korelacje między czynnikami pierwszego rzędu wynosiły od .48 do .63, więc wymiary wyraźnie się łączą. Porównano trzy modele CFA:
| Model | χ²(df) | CFI | TLI | RMSEA | SRMR | BIC |
|---|---|---|---|---|---|---|
| Cztery skorelowane czynniki | 54.10 (48), p = .253 | .996 | .994 | .017 | .026 | 15917.84 |
| Czynnik drugiego rzędu | 54.49 (50), p = .308 | .997 | .996 | .014 | .026 | 15906.01 |
| Jeden czynnik (12 pozycji) | 396.71 (54), p < .001 | .770 | .718 | .119 | .079 | 16223.80 |
Model drugiego rzędu jest zagnieżdżony w modelu skorelowanych czynników. Zastępuje sześć korelacji czterema ładunkami, więc ma o dwa stopnie swobody więcej. Test różnicy χ² nie wykazał pogorszenia dopasowania, Δχ²(2) = 0.39, p = .824, a BIC był niższy. Model drugiego rzędu jest więc prostszym i równie dobrym opisem danych. Model jednoczynnikowy, który ignoruje wymiary, jest dopasowany zdecydowanie gorzej. Wymiary są potrzebne, ale ich korelacje można wyjaśnić jednym czynnikiem ogólnym.
Standaryzowane ładunki drugiego rzędu wyniosły: autonomia 0.71, 95% CI [0.62, 0.80], kompetencja 0.70 [0.61, 0.78], relacje 0.70 [0.61, 0.79] i sens 0.88 [0.80, 0.95]. Dobrostan ogólny wyjaśnia więc od 49% (kompetencja, relacje) do 77% (sens) wariancji wymiarów. Reszta to specyfika wymiaru.
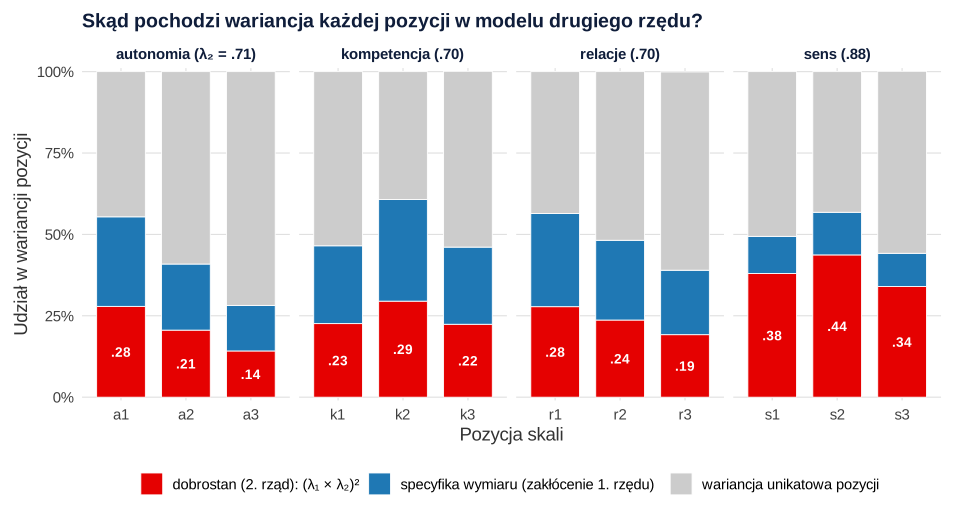
Rysunek 1 pokazuje, co oznacza wynik ogólny skali. Na przykład w pozycji a1 dobrostan ogólny odpowiada za 28% wariancji, specyfika autonomii za kolejne 28%, a 45% to wariancja unikatowa. Dla sumy wszystkich 12 pozycji omega całkowita wynosi .879, a omega hierarchiczna – .736. Oznacza to, że ok. 74% wariancji wyniku ogólnego pochodzi z czynnika drugiego rzędu. Reszta wiąże się ze specyfiką wymiarów albo z błędem. Wynik ogólny skali opisuje więc głównie dobrostan ogólny, ale nie wyłącznie.
Model drugiego rzędu a model bifaktorowy
Alternatywą jest model bifaktorowy. Czynnik ogólny ładuje w nim bezpośrednio na wszystkie pozycje, a obok są ortogonalne czynniki specyficzne. Model drugiego rzędu jest jego ograniczoną wersją: zakłada, że stosunek wpływu czynnika ogólnego do wpływu wymiaru jest stały dla wszystkich pozycji danego wymiaru. Chen i in. (2006) porównali oba modele na danych o jakości życia (N = 403). Model bifaktorowy był lepiej dopasowany i łatwiej pozwalał ocenić, czy wymiary przewidują zmienne zewnętrzne ponad czynnikiem ogólnym. Jeśli pytasz o unikalny wkład wymiarów, rozważ model bifaktorowy. Jeśli pytasz o konstrukt ogólny i strukturę teorii, wystarczy model drugiego rzędu.
Gdy porównujesz grupy, inwariancję trzeba sprawdzić na obu piętrach. Chen i in. (2005) testowali kolejno konfigurację, ładunki pierwszego i drugiego rzędu, wyrazy wolne pozycji i czynników pierwszego rzędu, zakłócenia i wariancje reszt. Dopiero potem porównywali średnie czynnika ogólnego (zob. inwariancja pomiaru w CB-SEM).
Jak opisać model drugiego rzędu w pracy (APA)
Podaj porównanie z modelem skorelowanych czynników (test różnicy i kryteria informacyjne), ładunki drugiego rzędu i informację, jaką część wariancji wyniku ogólnego wyjaśnia czynnik ogólny. Wzór:
Jeśli ładunki drugiego rzędu i dopasowanie masz zestawić w tabeli, skorzystaj ze wzoru tabeli analizy czynnikowej w APA. Szerszy kontekst walidacji skali wielowymiarowej daje wpis jak zbudować i zwalidować skalę psychometryczną.
Przykład w R
Kod tworzy dane z przykładu i szacuje trzy modele CFA. Potem porównuje model drugiego rzędu z modelem skorelowanych czynników, liczy omegę całkowitą i hierarchiczną, pokazuje równoważność modeli przy trzech wymiarach i rozkład wariancji z rysunku 1.
Czynnik drugiego rzędu w lavaan
R
# Czynnik drugiego rzędu (konstrukt wyższego rzędu) w lavaan: dobrostan psychiczny
library(lavaan)

# Dane symulowane (N = 450): dobrostan -> 4 wymiary -> po 3 pozycje (skala 1–7)
set.seed(110)
n <- 450
g  <- rnorm(n)                                        # dobrostan (czynnik drugiego rzędu)
l2 <- c(autonomia = .80, kompetencja = .70, relacje = .75, sens = .85)
l1 <- list(a = c(.75, .70, .65), k = c(.70, .75, .70), r = c(.80, .70, .65), s = c(.75, .80, .70))
F  <- sapply(l2, function(l) l * g + sqrt(1 - l^2) * rnorm(n))
dane <- do.call(cbind, lapply(1:4, function(j) sapply(l1[[j]], function(l)
  pmin(pmax(round(4.8 + 1.2 * (l * F[, j] + sqrt(1 - l^2) * rnorm(n))), 1), 7))))
colnames(dane) <- c(paste0("a", 1:3), paste0("k", 1:3), paste0("r", 1:3), paste0("s", 1:3))
dane <- as.data.frame(dane)
round(colMeans(dane), 2)

pomiar <- '
  autonomia   =~ a1 + a2 + a3
  kompetencja =~ k1 + k2 + k3
  relacje     =~ r1 + r2 + r3
  sens        =~ s1 + s2 + s3
'
# 1. Cztery skorelowane czynniki pierwszego rzędu
f_1rz <- cfa(pomiar, data = dane)
# 2. Czynnik drugiego rzędu wyjaśnia korelacje wymiarów
f_2rz <- cfa(paste(pomiar, "\ndobrostan =~ autonomia + kompetencja + relacje + sens"), data = dane)
# 3. Jeden czynnik ogólny (12 pozycji bez wymiarów)
f_1cz <- cfa('dobrostan =~ a1 + a2 + a3 + k1 + k2 + k3 + r1 + r2 + r3 + s1 + s2 + s3', data = dane)

miary <- c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr", "aic", "bic")
round(rbind(pierwszy_rzad = fitMeasures(f_1rz, miary), drugi_rzad = fitMeasures(f_2rz, miary),
            jeden_czynnik = fitMeasures(f_1cz, miary)), 3)
lavTestLRT(f_2rz, f_1rz)

# korelacje czynników pierwszego rzędu
round(lavInspect(f_1rz, "cor.lv"), 2)
# standaryzowane ładunki drugiego rzędu i R² wymiarów
st <- standardizedSolution(f_2rz)
print(st[st$lhs == "dobrostan" & st$op == "=~", c("rhs", "est.std", "ci.lower", "ci.upper")], digits = 2, row.names = FALSE)
round(lavInspect(f_2rz, "rsquare")[c("autonomia", "kompetencja", "relacje", "sens")], 2)

# 4. Ile wariancji wyniku ogólnego (suma 12 pozycji) pochodzi z czynnika drugiego rzędu?
#    omega hierarchiczna = (suma ładunków pośrednich λ1 × λ2)^2 / wariancja sumy (macierz modelowa)
est <- lavInspect(f_2rz, "est")
L1 <- est$lambda[, c("autonomia", "kompetencja", "relacje", "sens")]
g2 <- est$beta[c("autonomia", "kompetencja", "relacje", "sens"), "dobrostan"]
Sig <- lavInspect(f_2rz, "implied")$cov
lam_g <- L1 %*% g2 * sqrt(est$psi["dobrostan", "dobrostan"])
var_sumy <- sum(Sig)
omega_h <- sum(lam_g)^2 / var_sumy
omega_t <- (sum(Sig) - sum(est$theta)) / var_sumy
round(c(omega_calkowita = omega_t, omega_hierarchiczna = omega_h), 3)

# 5. Przy trzech wymiarach model drugiego rzędu jest równoważny modelowi trzech skorelowanych czynników
p3 <- 'autonomia =~ a1 + a2 + a3
  kompetencja =~ k1 + k2 + k3
  relacje =~ r1 + r2 + r3'
round(rbind(trzy_skorelowane = fitMeasures(cfa(p3, data = dane), c("chisq", "df")),
            drugi_rzad_3 = fitMeasures(cfa(paste(p3, "\ndobrostan =~ autonomia + kompetencja + relacje"), data = dane), c("chisq", "df"))), 3)

# 6. Rozkład wariancji każdej pozycji: czynnik drugiego rzędu, specyfika wymiaru, unikatowość
std <- lavInspect(f_2rz, "std")
L1s <- std$lambda[, c("autonomia", "kompetencja", "relacje", "sens")]
g2s <- std$beta[c("autonomia", "kompetencja", "relacje", "sens"), "dobrostan"]
ogolna <- as.numeric((L1s %*% g2s)^2); wymiar <- rowSums(L1s^2) - ogolna; unikat <- diag(std$theta)
rozklad <- data.frame(pozycja = rownames(L1s), ogolna = round(ogolna, 3), wymiar = round(wymiar, 3), unikatowa = round(unikat, 3))
print(rozklad, row.names = FALSE)
saveRDS(rozklad, "rozklad-wariancji.rds")
Wynik w R
  a1   a2   a3   k1   k2   k3   r1   r2   r3   s1   s2   s3
4.75 4.75 4.69 4.68 4.70 4.77 4.60 4.66 4.66 4.72 4.68 4.71
                chisq df pvalue   cfi   tli rmsea  srmr      aic      bic
pierwszy_rzad  54.097 48  0.253 0.996 0.994 0.017 0.026 15794.56 15917.84
drugi_rzad     54.485 50  0.308 0.997 0.996 0.014 0.026 15790.95 15906.01
jeden_czynnik 396.711 54  0.000 0.770 0.718 0.119 0.079 16125.17 16223.80

Chi-Squared Difference Test

      Df   AIC   BIC  Chisq Chisq diff RMSEA Df diff Pr(>Chisq)
f_1rz 48 15795 15918 54.097
f_2rz 50 15791 15906 54.485    0.38844     0       2     0.8235
            autonm kmptnc relacj sens
autonomia     1.00
kompetencja   0.48   1.00
relacje       0.49   0.51   1.00
sens          0.63   0.61   0.61 1.00
         rhs est.std ci.lower ci.upper
   autonomia    0.71     0.62     0.80
 kompetencja    0.70     0.61     0.78
     relacje    0.70     0.61     0.79
        sens    0.88     0.80     0.95
  autonomia kompetencja     relacje        sens
       0.50        0.49        0.49        0.77
    omega_calkowita omega_hierarchiczna
              0.879               0.736
                  chisq df
trzy_skorelowane 23.281 24
drugi_rzad_3     23.281 24
 pozycja ogolna wymiar unikatowa
      a1  0.279  0.275     0.446
      a2  0.206  0.203     0.591
      a3  0.142  0.140     0.718
      k1  0.226  0.239     0.535
      k2  0.295  0.312     0.393
      k3  0.224  0.237     0.540
      r1  0.278  0.286     0.436
      r2  0.237  0.245     0.518
      r3  0.192  0.198     0.609
      s1  0.380  0.114     0.506
      s2  0.437  0.131     0.432
      s3  0.340  0.102     0.559
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Model drugiego rzędu z trzema wymiarami „potwierdzony” dopasowaniem. Przy trzech wymiarach dopasowanie jest identyczne jak w modelu skorelowanych czynników (w kodzie: χ²(24) = 23.28 w obu), więc o wyborze decyduje teoria.
- Czynnik ogólny przy słabo skorelowanych wymiarach. Jeśli korelacje wymiarów są niskie, ładunki drugiego rzędu też będą niskie, a wynik ogólny skali będzie mieszanką odrębnych cech. Sprawdź korelacje czynników pierwszego rzędu, zanim zbudujesz konstrukt ogólny.
- Brak porównania z modelami konkurencyjnymi. Pokaż, że model drugiego rzędu nie jest gorszy od modelu skorelowanych czynników i lepszy od jednoczynnikowego. Gdy pytanie dotyczy unikalnego wkładu wymiarów, porównaj go też z modelem bifaktorowym.
- Utożsamianie wyniku ogólnego z czynnikiem ogólnym. Suma pozycji zawiera także specyfikę wymiarów. Omega hierarchiczna mówi, jaka część wariancji wyniku pochodzi z czynnika ogólnego.
- Rzetelność kompozytowa liczona dla konstruktu drugiego rzędu jak dla zwykłego czynnika. Wskaźnikami czynnika ogólnego są wymiary, a nie pozycje. Takie miary licz na właściwym piętrze modelu (Sarstedt i in., 2019).
Najczęstsze pytania
Kiedy stosować czynnik drugiego rzędu?
Gdy teoria zakłada, że kilka wymiarów skali to przejawy jednego konstruktu ogólnego, a czynniki pierwszego rzędu są wyraźnie skorelowane. Model drugiego rzędu pozwala wtedy mówić jednocześnie o poziomie ogólnym i o wymiarach. Potrzebujesz co najmniej trzech wymiarów, a sprawdzić model można dopiero przy czterech i więcej.
Dlaczego model drugiego rzędu z trzema czynnikami ma takie samo dopasowanie jak model skorelowany?
Trzy korelacje czynników zostają zastąpione trzema ładunkami drugiego rzędu, więc liczba parametrów i dopasowanie są identyczne. Na tej stronie oba modele mają χ²(24) = 23.28. Dopasowanie nie rozstrzyga więc, który model wybrać – decyduje teoria.
Jak zapisać czynnik drugiego rzędu w lavaan?
Najpierw zdefiniuj czynniki pierwszego rzędu, np. autonomia =~ a1 + a2 + a3, a potem czynnik ogólny z czynnikami jako wskaźnikami: dobrostan =~ autonomia + kompetencja + relacje + sens. Model oszacuj funkcją cfa(), a z modelem skorelowanych czynników porównaj go funkcją lavTestLRT().
Czym różni się model drugiego rzędu od bifaktorowego?
W modelu drugiego rzędu czynnik ogólny wpływa na pozycje pośrednio, przez wymiary. W modelu bifaktorowym ładuje na pozycje bezpośrednio, obok ortogonalnych czynników specyficznych. Model bifaktorowy lepiej nadaje się do sprawdzania, czy wymiary przewidują coś ponad czynnik ogólny.
Co to jest omega hierarchiczna?
To odsetek wariancji wyniku ogólnego skali (sumy pozycji), który pochodzi z czynnika ogólnego. Omega całkowita obejmuje także wariancję wymiarów. W przykładzie na tej stronie omega hierarchiczna wynosi .736, a całkowita .879, więc wynik ogólny opisuje głównie dobrostan ogólny, ale zawiera też specyfikę wymiarów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modelowanie zmiennych i konstruktów wyższego rzędu
Jak odróżnić wspólny czynnik od kompozytu, wybrać typ modelu drugiego rzędu, zwalidować obie warstwy i poprawnie opisać wynik.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chen, F. F., Sousa, K. H., & West, S. G. (2005). Teacher’s corner: Testing measurement invariance of second-order factor models. Structural Equation Modeling: A Multidisciplinary Journal, 12(3), 471–492. https://doi.org/10.1207/s15328007sem1203_7
- Chen, F. F., West, S., & Sousa, K. (2006). A comparison of bifactor and second-order models of quality of life. Multivariate Behavioral Research, 41(2), 189–225. https://doi.org/10.1207/s15327906mbr4102_5
- Rindskopf, D., & Rose, T. (1988). Some theory and applications of confirmatory second-order factor analysis. Multivariate Behavioral Research, 23(1), 51–67. https://doi.org/10.1207/s15327906mbr2301_3
- Sarstedt, M., Hair, J. F., Cheah, J.-H., Becker, J.-M., & Ringle, C. M. (2019). How to specify, estimate, and validate higher-order constructs in PLS-SEM. Australasian Marketing Journal, 27(3), 197–211. https://doi.org/10.1016/j.ausmj.2019.05.003 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{chen2005testing, author={Chen, Fang Fang and Sousa, Karen H. and West, Stephen G.}, title={{Teacher’s corner: Testing measurement invariance of second-order factor models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2005}, volume={12}, number={3}, pages={471--492}, doi={10.1207/s15328007sem1203_7}}@article{chen2006comparison, author={Chen, Fang Fang and West, Stephen and Sousa, Karen}, title={{A comparison of bifactor and second-order models of quality of life}}, journal={Multivariate Behavioral Research}, year={2006}, volume={41}, number={2}, pages={189--225}, doi={10.1207/s15327906mbr4102_5}}@article{rindskopf1988some, author={Rindskopf, David and Rose, Tedd}, title={{Some theory and applications of confirmatory second-order factor analysis}}, journal={Multivariate Behavioral Research}, year={1988}, volume={23}, number={1}, pages={51--67}, doi={10.1207/s15327906mbr2301_3}}@article{sarstedt2019how, author={Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Becker, Jan-Michael and Ringle, Christian M.}, title={{How to specify, estimate, and validate higher-order constructs in PLS-SEM}}, journal={Australasian Marketing Journal}, year={2019}, volume={27}, number={3}, pages={197--211}, doi={10.1016/j.ausmj.2019.05.003}}