Co to jest AVE?
AVE (ang. average variance extracted, średnia wyodrębniona wariancja) to przeciętna część wariancji wskaźników, którą wyjaśnia ich czynnik. Jeśli AVE wynosi .55, czynnik odpowiada średnio za 55% wariancji swoich pozycji, a pozostałe 45% to błąd pomiaru i wariancja specyficzna. Miara pochodzi z pracy Fornella i Larckera (1981), którzy zaproponowali ocenę modeli strukturalnych opartą na wariancji wspólnej, a nie wyłącznie na teście chi-kwadrat.
AVE liczy się dla konstruktów mierzonych refleksyjnie, czyli takich, w których czynnik jest przyczyną odpowiedzi na pozycje (zob. modele refleksyjne i formatywne). W pracach z psychologii pojawia się w dwóch miejscach: jako argument za trafnością zbieżną (pozycje „zbiegają się” na swoim czynniku) i jako składnik kryterium Fornella–Larckera, które sprawdza trafność różnicową.
Wzór na AVE
Dla konstruktu mierzonego przez K wskaźników:
gdzie λk to ładunek czynnikowy wskaźnika k, a θk – wariancja jego błędu. Przy ładunkach całkowicie standaryzowanych θk = 1 − λk², więc wzór upraszcza się do średniej kwadratów ładunków:
Henseler i in. (2015) zauważają, że tak liczona AVE jest równoważna średniej rzetelności pojedynczych wskaźników. Dwie konsekwencje warto zapamiętać. Po pierwsze, ładunek .71 odpowiada λ² = .50, więc AVE ≥ .50 wymaga, by ładunki były przeciętnie co najmniej w tej okolicy. Po drugie, AVE nie rośnie z liczbą pozycji, w przeciwieństwie do rzetelności kompozytowej (CR) czy omegi McDonalda. Dziesięć pozycji o ładunkach .60 da wysoką CR, ale AVE zostanie na poziomie .36.
Jak interpretować AVE: próg .50 i kryterium Fornella–Larckera
Cheung i in. (2024) przypominają dwie reguły wywodzone z pracy Fornella i Larckera:
- trafność zbieżna: AVE nie powinna być niższa niż .50, czyli czynnik ma wyjaśniać co najmniej połowę wariancji swoich wskaźników;
- trafność różnicowa (kryterium Fornella–Larckera): AVE każdego z dwóch konstruktów ma przewyższać ich wariancję wspólną, czyli kwadrat korelacji. Równoważnie √AVE ma być większy niż bezwzględna korelacja z każdym innym konstruktem.
Ci sami autorzy krytykują obie reguły. To reguły kciuka, które pomijają błąd próbkowania, a wysoka AVE „toleruje” wysokie korelacje między konstruktami. Henseler i in. (2015) pokazali w symulacji, że kryterium Fornella–Larckera i analiza ładunków krzyżowych często nie wykrywają braku trafności różnicowej. W PLS-SEM problem się nasila, bo metoda zawyża ładunki, a więc i AVE. Zaproponowali w zamian HTMT z progiem .85 lub .90. Rönkkö i Cho (2022) zalecają z kolei patrzeć na korelację czynników z CFA razem z jej przedziałem ufności.
Przykład: AVE dla trzech skal
Dwieście osiemdziesiąt osób (dane symulowane) wypełniło trzy skale po cztery pozycje: wsparcia społecznego, samotności i satysfakcji z życia. Model CFA z trzema skorelowanymi czynnikami dobrze pasował do danych: χ²(51) = 54.01, p = .360, CFI = .997, RMSEA = .015, SRMR = .039. Dobre dopasowanie nie przesądza jednak o jakości pomiaru. Rysunek 1 pokazuje kwadraty standaryzowanych ładunków i wynikające z nich AVE.
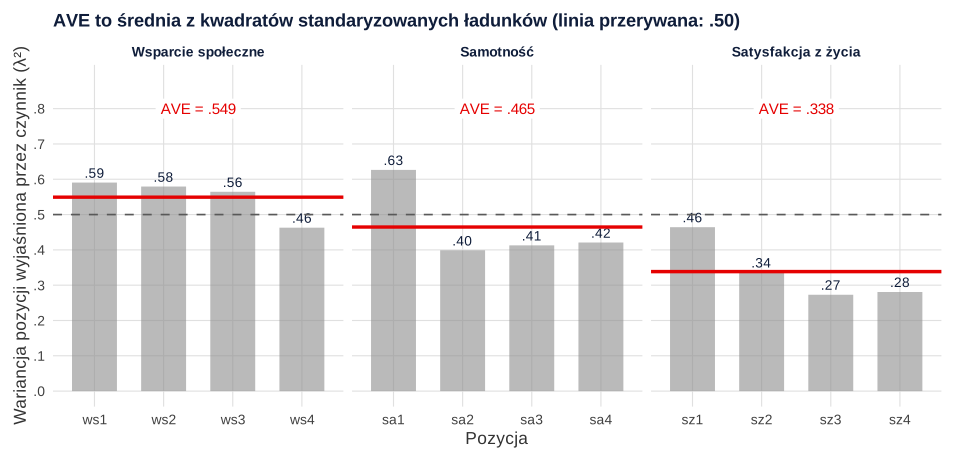
Wsparcie społeczne spełnia próg (AVE = .549). Samotność jest tuż poniżej (.465): jedna pozycja ma λ² = .63, a trzy pozostałe około .40–.42. Satysfakcja z życia ma AVE = .338, mimo że wszystkie jej ładunki są istotne i wynoszą od .52 do .68. Rzetelność kompozytowa tych skal to .829, .772 i .671. Satysfakcja jest więc mierzona umiarkowanie rzetelnie jako suma, ale czynnik wyjaśnia przeciętnie tylko co trzecią część wariancji pozycji.
Kryterium Fornella–Larckera zestawia √AVE z korelacjami czynników:
| Konstrukt | Wsparcie | Samotność | Satysfakcja |
|---|---|---|---|
| Wsparcie | .742 | ||
| Samotność | −.788 | .684 | |
| Satysfakcja | .394 | −.518 | .581 |
Korelacja wsparcia z samotnością (|r| = .788) przewyższa zarówno √AVE wsparcia (.742), jak i √AVE samotności (.684). Według kryterium Fornella–Larckera trafność różnicowa tej pary nie jest więc potwierdzona. Inne kryteria wypadają łagodniej. HTMT wynosi .761, czyli mniej niż .85, a 95% CI korelacji z CFA to [−.864, −.712], więc nie obejmuje −1. Rozbieżność wynika z niskiej AVE samotności, przez którą kryterium Fornella–Larckera staje się bardzo surowe. To dobra ilustracja uwagi Cheunga i in. (2024), że reguły oparte na AVE nie powinny być jedynym argumentem. W pracy pokaż wszystkie trzy wskaźniki i omów, czy wsparcie i samotność to w twojej teorii odrębne konstrukty.
Uwaga techniczna: funkcja AVE() z pakietu semTools daje .550, .468 i .338. Różnice w trzecim miejscu wynikają z tego, że liczy AVE w metryce niestandaryzowanej (iloraz sum wariancji). Średnia z kwadratów ładunków standaryzowanych daje .549, .465 i .338.
Co zrobić, gdy AVE jest niższa niż .50?
- Sprawdź treść pozycji o najniższych ładunkach. Pozycja może mierzyć coś obok konstruktu, mieć niejasne sformułowanie albo efekt sufitu.
- Nie usuwaj pozycji tylko po to, by podnieść AVE. Usunięcie zawęża treść konstruktu i osłabia trafność teoretyczną; decyzję uzasadnij merytorycznie i sprawdź ją na nowej próbie.
- Sprawdź, czy konstrukt jest jednowymiarowy. Jeśli pozycje tworzą w rzeczywistości dwa podwymiary, wspólny czynnik wyjaśni z każdej z nich mniej wariancji. Wtedy lepszym rozwiązaniem może być model z dwoma czynnikami albo konstrukt wyższego rzędu, a nie usuwanie pozycji.
- Raportuj AVE razem z CR i ładunkami. AVE .45 przy CR .80 to inna sytuacja niż AVE .30 przy CR .60.
- Przy adaptacji skali porównaj wynik z badaniami oryginalnymi. Wiele krótkich skal o szerokiej treści ma AVE poniżej .50 i mimo to sprawdza się w badaniach.
Jak opisać AVE w pracy (APA)
Podaj model, w którym liczono ładunki (CFA albo PLS-SEM), przyjęte progi i ich źródło. Pokaż AVE i CR dla każdej skali, najlepiej w jednej tabeli z alfą lub omegą (wzór: tabela rzetelności skal w APA). Przy trafności różnicowej dodaj macierz Fornella–Larckera albo HTMT.
AVE w R (lavaan i semTools)
Kod tworzy dane z przykładu, szacuje trójczynnikowy model CFA i liczy AVE na dwa sposoby: ręcznie jako średnią kwadratów standaryzowanych ładunków i funkcją AVE() z pakietu semTools. Dalej liczy rzetelność kompozytową, macierz Fornella–Larckera, korelacje czynników z 95% CI i HTMT. Liczby w tekście, tabeli i na rysunku 1 pochodzą z tego kodu.
AVE, rzetelność kompozytowa i trafność różnicowa
R
suppressPackageStartupMessages({library(lavaan); library(semTools)})

# Dane symulowane: 280 studentów, trzy skale po 4 pozycje (odpowiedzi 1–5):
# wsparcie społeczne (ws1–ws4), samotność (sa1–sa4) i satysfakcja z życia (sz1–sz4).
set.seed(99)
pop <- '
  wsparcie    =~ 0.80*ws1 + 0.76*ws2 + 0.78*ws3 + 0.72*ws4
  samotnosc   =~ 0.76*sa1 + 0.72*sa2 + 0.74*sa3 + 0.68*sa4
  satysfakcja =~ 0.70*sz1 + 0.62*sz2 + 0.55*sz3 + 0.48*sz4
  wsparcie  ~~ -0.80*samotnosc
  wsparcie  ~~  0.40*satysfakcja
  samotnosc ~~ -0.45*satysfakcja
'
z <- simulateData(pop, sample.nobs = 280, standardized = TRUE)
prog <- c(-Inf, -1.3, -0.45, 0.4, 1.25, Inf)
dane <- as.data.frame(lapply(z, function(x) as.numeric(cut(x, prog, labels = FALSE))))

model <- '
  wsparcie    =~ ws1 + ws2 + ws3 + ws4
  samotnosc   =~ sa1 + sa2 + sa3 + sa4
  satysfakcja =~ sz1 + sz2 + sz3 + sz4
'
fit <- cfa(model, data = dane)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)

# 1. Standaryzowane ładunki, ich kwadraty i AVE liczone ręcznie (średnia z λ²)
st <- standardizedSolution(fit)
lad <- st[st$op == "=~", c("lhs", "rhs", "est.std")]
lad$lambda2 <- lad$est.std^2
lad$blad <- 1 - lad$lambda2
print(transform(lad, est.std = round(est.std, 3), lambda2 = round(lambda2, 3), blad = round(blad, 3)), row.names = FALSE)
ave_recznie <- tapply(lad$lambda2, lad$lhs, mean)
round(ave_recznie, 3)

# 2. To samo w semTools (obs.var = FALSE: wariancje z modelu, jak w ręcznym wzorze); obok rzetelność kompozytowa
round(AVE(fit, obs.var = FALSE), 3)
round(unlist(compRelSEM(fit)), 3)

# 3. Kryterium Fornella–Larckera: √AVE na przekątnej, korelacje czynników poza nią
fl <- lavInspect(fit, "cor.lv")
diag(fl) <- sqrt(AVE(fit, obs.var = FALSE)[rownames(fl)])
round(fl, 3)

# 4. Korelacje czynników z 95% CI (czy CI obejmuje |1|?) oraz HTMT
kor <- st[st$op == "~~" & st$lhs != st$rhs & st$lhs %in% c("wsparcie", "samotnosc", "satysfakcja"),
          c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
print(transform(kor, est.std = round(est.std, 3), ci.lower = round(ci.lower, 3), ci.upper = round(ci.upper, 3)), row.names = FALSE)
round(htmt(model, data = dane), 3)
Wynik w R
 chisq     df pvalue    cfi  rmsea   srmr
54.007 51.000  0.360  0.997  0.015  0.039
         lhs rhs est.std lambda2  blad
    wsparcie ws1   0.769   0.591 0.409
    wsparcie ws2   0.761   0.579 0.421
    wsparcie ws3   0.751   0.564 0.436
    wsparcie ws4   0.680   0.463 0.537
   samotnosc sa1   0.792   0.627 0.373
   samotnosc sa2   0.632   0.399 0.601
   samotnosc sa3   0.642   0.413 0.587
   samotnosc sa4   0.649   0.421 0.579
 satysfakcja sz1   0.681   0.464 0.536
 satysfakcja sz2   0.580   0.336 0.664
 satysfakcja sz3   0.522   0.273 0.727
 satysfakcja sz4   0.530   0.281 0.719
  samotnosc satysfakcja    wsparcie
      0.465       0.338       0.549
   wsparcie   samotnosc satysfakcja
      0.550       0.468       0.338
   wsparcie   samotnosc satysfakcja
      0.829       0.772       0.671
            wsparc smtnsc stysfk
wsparcie     0.742
samotnosc   -0.788  0.684
satysfakcja  0.394 -0.518  0.581
       lhs         rhs est.std ci.lower ci.upper
  wsparcie   samotnosc  -0.788   -0.864   -0.712
  wsparcie satysfakcja   0.394    0.255    0.533
 samotnosc satysfakcja  -0.518   -0.650   -0.387
            wsparc smtnsc stysfk
wsparcie     1.000
samotnosc    0.761  1.000
satysfakcja  0.398  0.511  1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling [R package]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- AVE liczone z ładunków niestandaryzowanych. Średnia kwadratów ma sens tylko dla ładunków całkowicie standaryzowanych.
- AVE dla konstruktów formatywnych. Wskaźniki formatywne nie muszą ze sobą korelować, więc AVE nie ma tu interpretacji (zob. formatywna zmienna latentna).
- Utożsamianie AVE z rzetelnością. CR i omega opisują rzetelność sumy pozycji, a AVE – przeciętną jakość pojedynczej pozycji.
- Kryterium Fornella–Larckera jako jedyny dowód trafności różnicowej, zwłaszcza w PLS-SEM, gdzie zawyżone ładunki (zob. ładunek zewnętrzny) sprzyjają „zaliczeniu” kryterium.
- Porównanie √AVE z kwadratem korelacji (albo AVE z samą korelacją). Porównuj AVE z r² albo √AVE z |r|.
Całą procedurę oceny modelu pomiarowego znajdziesz w poradnikach jak zbudować i zwalidować skalę oraz PLS-SEM krok po kroku.
Najczęstsze pytania
Co oznacza AVE poniżej 0.5?
Czynnik wyjaśnia przeciętnie mniej niż połowę wariancji swoich pozycji, a większą część stanowi błąd pomiaru i wariancja specyficzna. Nie musi to dyskwalifikować skali – sprawdź pozycje o najniższych ładunkach, rzetelność kompozytową i wyniki innych badań, ale nie usuwaj pozycji wyłącznie po to, by przekroczyć próg.
Jak policzyć AVE z ładunków czynnikowych?
Podnieś do kwadratu standaryzowane ładunki wszystkich pozycji konstruktu i policz ich średnią. Dla ładunków .77, .76, .75 i .68 daje to (.59 + .58 + .56 + .46)/4 ≈ .55. W R ładunki odczytasz z standardizedSolution(), a gotową wartość poda semTools::AVE().
Czym różni się AVE od rzetelności kompozytowej?
Rzetelność kompozytowa (CR) opisuje rzetelność wyniku łącznego i rośnie wraz z liczbą pozycji, a AVE opisuje przeciętną jakość pojedynczej pozycji i od liczby pozycji nie zależy. Dlatego skala z wieloma umiarkowanymi ładunkami może mieć CR powyżej .70 i jednocześnie AVE poniżej .50.
Jak AVE wykorzystuje się w kryterium Fornella–Larckera?
Trafność różnicowa dwóch konstruktów jest według niego potwierdzona, gdy AVE każdego z nich przewyższa kwadrat ich korelacji, czyli gdy √AVE jest większy od bezwzględnej korelacji. Badania symulacyjne pokazały, że kryterium to bywa zawodne, dlatego warto uzupełnić je o HTMT albo przedział ufności korelacji z CFA.
Czy AVE w PLS-SEM liczy się tak samo jak w CFA?
Wzór jest ten sam, ale ładunki pochodzą z innego modelu: PLS-SEM traktuje konstrukty jako kompozyty, co zawyża ładunki, a więc i AVE. Wartość AVE z PLS-SEM jest zwykle wyższa niż z CFA na tych samych danych; przy konstruktach refleksyjnych rozważ PLSc.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikTrafność zbieżna i różnicowa: AVE i HTMT
AVE i rzetelność złożona z ładunków lavaan, HTMT z bootstrapem, krytyka Fornella–Larckera i co zrobić, gdy dwa konstrukty są trudne do odróżnienia.
Czytaj →PoradnikKalkulator AVE, CR i HTMT
AVE, rzetelność złożona i tabela Fornella–Larckera z ładunków oraz HTMT i HTMT2 z wklejonej macierzy korelacji. Zgodny z R i semTools.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745–783. https://doi.org/10.1007/s10490-023-09871-y ● Otwarty dostęp
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Rönkkö, M., & Cho, E. (2022). An updated guideline for assessing discriminant validity. Organizational Research Methods, 25(1), 6–14. https://doi.org/10.1177/1094428120968614 ● Otwarty dostęp
Cytowania BibTeX
@article{cheung2024reporting, author={Cheung, Gordon W. and Cooper-Thomas, Helena D. and Lau, Rebecca S. and Wang, Linda C.}, title={{Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations}}, journal={Asia Pacific Journal of Management}, year={2024}, volume={41}, number={2}, pages={745--783}, doi={10.1007/s10490-023-09871-y}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{ronkko2022updated, author={Rönkkö, Mikko and Cho, Eunseong}, title={{An updated guideline for assessing discriminant validity}}, journal={Organizational Research Methods}, year={2022}, volume={25}, number={1}, pages={6--14}, doi={10.1177/1094428120968614}}