Co to jest rzetelność kompozytowa (ρC)?
Rzetelność kompozytowa (ang. composite reliability, CR, ρC, czasem „rzetelność złożona”) to oszacowanie rzetelności sumy pozycji skali wyliczone z ładunków czynnikowych modelu pomiarowego. Mówi, jaka część wariancji wyniku sumarycznego pochodzi z mierzonego konstruktu, a jaka z błędu pomiaru. Jest standardowym elementem oceny modelu pomiarowego w SEM – zarówno kowariancyjnym, jak i PLS – obok AVE i miar trafności różnicowej.
Podstawą jest model pozycji kongenerycznych opisany przez Jöreskoga (1971): każda pozycja mierzy ten sam konstrukt, ale może mieć inny ładunek i inną wariancję błędu. W psychologii to założenie jest znacznie realistyczniejsze niż model tau-równoważny, na którym opiera się alfa Cronbacha. Raykov (1997) pokazał, jak oszacować rzetelność kompozytu z miar kongenerycznych w modelu strukturalnym, i że taki estymator nie ma ogólnej skłonności do zaniżania rzetelności, którą ma alfa. W jednoczynnikowej CFA ρC to ten sam współczynnik, który w psychometrii nazywa się omegą McDonalda; Flora (2020) wyjaśnia, którą odmianę omegi wybrać zależnie od modelu CFA.
Wzór
- λi – ładunek standaryzowany pozycji i;
- θi = 1 − λi² – standaryzowana wariancja błędu pozycji (przy założeniu, że błędy są nieskorelowane).
Ten sam wynik daje wersja niestandaryzowana – z ładunkami i wariancjami błędu w jednostkach pozycji, gdy wariancję czynnika ustalono na 1. Programy różnią się szczegółem mianownika: pakiet semTools domyślnie bierze obserwowaną wariancję sumy zamiast odtworzonej z modelu, dlatego wynik może się różnić na trzecim miejscu po przecinku (w przykładzie .821 wobec .819).
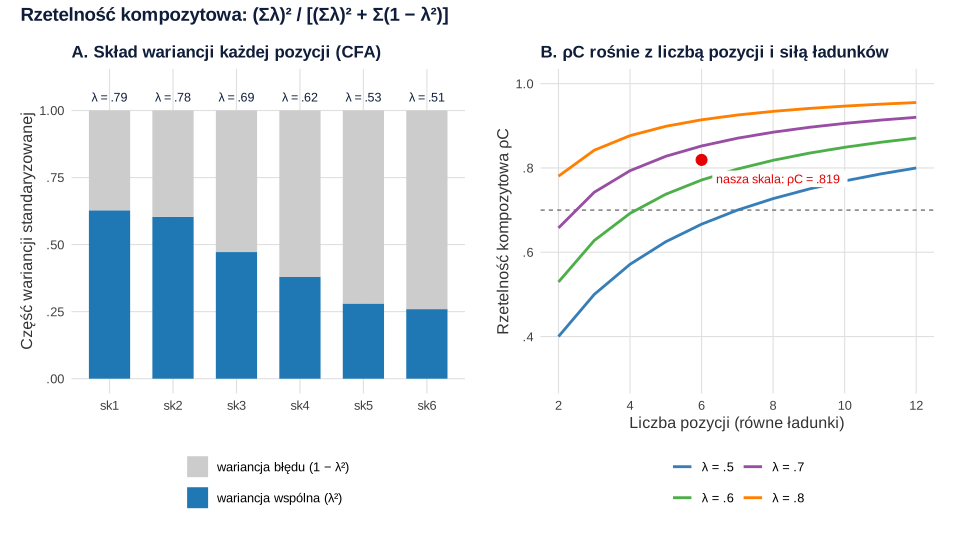
Licznik to wariancja „prawdziwa” sumy (kwadrat sumy ładunków), mianownik – cała jej wariancja. Wzór wymaga, by pozycje mierzyły jeden konstrukt i miały nieskorelowane błędy. Gdy w modelu są kowariancje reszt, trzeba je dodać do mianownika – inaczej ρC zostanie zawyżone. Rysunek 1B pokazuje, że ρC rośnie zarówno z siłą ładunków, jak i z liczbą pozycji: sześć pozycji z ładunkami .60 daje ρC = .771, a trzy pozycje z ładunkami .70 – tylko .742.
Rzetelność kompozytową i AVE upowszechnili w ocenie modeli strukturalnych Fornell i Larcker (1981), proponując system oceny oparty na miarach wariancji wspólnej w modelu pomiarowym i strukturalnym. AVE to średnia kwadratów ładunków – mówi o przeciętnej pozycji, a ρC o sumie wszystkich pozycji.
Przykład: skala poczucia własnej skuteczności w nauce
Sześć pozycji skali poczucia własnej skuteczności w nauce (1–7) wypełniło 250 studentów (dane symulowane). Pozycje są celowo różnej jakości – od bardzo dobrych do słabych.
Krok 1 – ładunki z CFA. Ładunki standaryzowane wyniosły .792, .777, .687, .616, .529 i .509.
Krok 2 – sumy. Σλ = 3.911, więc (Σλ)² = 15.30. Suma wariancji błędu Σ(1 − λ²) = 3.377.
Krok 3 – wynik. ρC = 15.30 / (15.30 + 3.377) = .819. AVE = .437.
| Współczynnik | Jak liczony | Wartość |
|---|---|---|
| ρC ze wzoru | Ładunki standaryzowane CFA (CB-SEM) | .819 |
| ρC w semTools | Ładunki CFA, mianownik z obserwowanej wariancji sumy | .821 |
| Alfa Cronbacha | Średnia kowariancja pozycji | .814 |
| ρC bez najsłabszej pozycji (sk6) | CFA na 5 pozycjach | .817 |
| ρC w PLS-SEM | Ładunki PLS (seminr) | .815 |
| ρA w PLS-SEM | Wagi PLS (seminr) | .842 |
Interpretacja. Około 82% wariancji sumy sześciu pozycji to wariancja konstruktu, około 18% – błąd pomiaru. Zwyczajowa wartość minimalna .70 jest przekroczona; Henseler i in. (2016) przypominają, że minimum .70 dla rzetelności rekomendowali Nunnally i Bernstein. Jednocześnie AVE = .437 jest poniżej .50: przeciętna pozycja wyjaśnia mniej niż połowę swojej wariancji. Wysoka ρC nie oznacza więc, że każda pozycja jest dobra – sumowanie wielu przeciętnych pozycji daje rzetelny wynik. Usunięcie najsłabszej pozycji (λ = .509) nieznacznie obniżyło ρC (.817): nawet słaba pozycja dokłada trochę wariancji prawdziwej.
ρC w PLS-SEM i ρA
W PLS-SEM ten sam wzór stosuje się do ładunków PLS, które są korelacjami pozycji z kompozytem (zob. ładunek zewnętrzny). W przykładzie ładunki PLS różniły się od CFA (np. sk2: .863 wobec .777), ale ρC wyszło podobne (.815). Henseler i in. (2016) zaznaczają, że ρC i alfa odnoszą się do sum pozycji, a jedyną spójną miarą rzetelności wyników konstruktów PLS jest ρA Dijkstry–Henselera – w przykładzie .842. Dlatego w PLS-SEM raportuj zwykle alfę, ρA i ρC razem, a ρA traktuj jako główną informację o rzetelności kompozytu z wagami PLS. Ta sama rzetelność służy do korekty ścieżek w PLSc.
Co ρC mówi, a czego nie
| Pytanie | Czy ρC odpowiada? | Czego użyć zamiast |
|---|---|---|
| Jaka część wariancji sumy to konstrukt? | Tak | – |
| Czy skala jest jednowymiarowa? | Nie – wzór to zakłada | Dopasowanie CFA, analiza równoległa |
| Czy każda pozycja jest dobra? | Nie | Ładunki, AVE |
| Czy wynik jest stabilny w czasie? | Nie | rzetelność test–retest |
| Czy skala mierzy to, co ma mierzyć? | Nie | trafność, HTMT |
ρC to miara spójności wewnętrznej w jednym pomiarze. Dobra rzetelność kompozytowa jest warunkiem koniecznym, ale niewystarczającym, by wynik skali nadawał się do wnioskowania. Pamiętaj też, że oszacowanie pochodzi z próby: przy małym N ładunki, a więc i ρC, mają spory błąd losowy. Jeśli porównujesz rzetelność w grupach, sprawdź najpierw inwariancję pomiaru.
Jak opisać rzetelność kompozytową w pracy (APA)
Podaj ρC dla każdej skali razem z AVE i zakresem ładunków; zaznacz, z jakiego modelu pochodzą ładunki. Wyniki kilku skal zbierz w tabeli (zob. tabela rzetelności skal w APA).
Rzetelność kompozytowa w R
Kod tworzy dane z przykładu, liczy ρC ręcznie z ładunków CFA, porównuje wynik z pakietem semTools i alfą Cronbacha, sprawdza skutek usunięcia najsłabszej pozycji i szacuje ten sam konstrukt w PLS-SEM (seminr). Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
ρC w CB-SEM (lavaan, semTools) i w PLS-SEM (seminr)
R
# Dane symulowane: 250 studentów, 6 pozycji skali poczucia własnej skuteczności w nauce (1–7);
# pozycje kongeneryczne – różnie silnie związane z konstruktem; dodatkowo zaangażowanie w naukę (3 pozycje)
suppressPackageStartupMessages({library(lavaan); library(semTools); library(seminr)})
set.seed(136)
n <- 250
SKU <- rnorm(n); ZAA <- 0.5 * SKU + rnorm(n, sd = sqrt(.75))
poz <- function(f, l) round(pmin(pmax(4.6 + 1.2 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 7))
lam <- c(.85, .80, .75, .60, .50, .40)
dane <- data.frame(sapply(lam, function(l) poz(SKU, l)), sapply(c(.8, .75, .7), function(l) poz(ZAA, l)))
names(dane) <- c(paste0("sk", 1:6), paste0("za", 1:3))

# 1. CFA (CB-SEM) i rho_C „ręcznie” ze standaryzowanych ładunków
fit <- cfa('SKU =~ sk1 + sk2 + sk3 + sk4 + sk5 + sk6
            ZAA =~ za1 + za2 + za3', data = dane)
st <- standardizedSolution(fit)
l <- st$est.std[st$op == "=~" & st$lhs == "SKU"]; round(l, 3)
th <- 1 - l^2
rhoC <- sum(l)^2 / (sum(l)^2 + sum(th))
round(c(suma_ladunkow = sum(l), suma_wariancji_bledu = sum(th), rho_C = rhoC, AVE = mean(l^2)), 3)
# To samo z pakietu semTools (omega dla modelu CFA) i alfa Cronbacha dla porównania
unlist(compRelSEM(fit))
round(psych::alpha(dane[, 1:6])$total$raw_alpha, 3)

# 2. Co się stanie po usunięciu najsłabszej pozycji (sk6)?
fit5 <- cfa('SKU =~ sk1 + sk2 + sk3 + sk4 + sk5', data = dane)
unlist(compRelSEM(fit5))

# 3. Ten sam konstrukt w PLS-SEM (seminr): rho_C liczone z ładunków PLS oraz rho_A
mm <- constructs(reflective("SKU", multi_items("sk", 1:6)), reflective("ZAA", multi_items("za", 1:3)))
sm <- relationships(paths(from = "SKU", to = "ZAA"))
pls <- estimate_pls(data = dane, measurement_model = mm, structural_model = sm)
s <- summary(pls)
round(s$loadings[paste0("sk", 1:6), "SKU"], 3)
round(s$reliability, 3)
Wynik w R
[1] 0.792 0.777 0.687 0.616 0.529 0.509
       suma_ladunkow suma_wariancji_bledu                rho_C
               3.911                3.377                0.819
                 AVE
               0.437
      SKU       ZAA
0.8205583 0.7538175
[1] 0.814
      SKU
0.8165813
Generating the seminr model
All 250 observations are valid.
  sk1   sk2   sk3   sk4   sk5   sk6
0.721 0.863 0.714 0.575 0.412 0.577
    alpha  rhoA  rhoC   AVE
SKU 0.814 0.842 0.815 0.435
ZAA 0.754 0.782 0.756 0.516

Alpha, rhoA, and rhoC should exceed 0.7 while AVE should exceed 0.5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Liczenie ρC dla skali wielowymiarowej jak dla jednego czynnika. Najpierw sprawdź strukturę (CFA), potem licz rzetelność dla każdego wymiaru albo odpowiednią odmianę omegi.
- Pomijanie kowariancji reszt w mianowniku, gdy są w modelu – rzetelność wychodzi zawyżona.
- Wnioskowanie o jakości pozycji z samej ρC. W przykładzie ρC = .82 współistnieje z AVE = .44; sprawdź też ładunki.
- Używanie ρC dla konstruktów formatywnych. Wzór zakłada model refleksyjny (zob. refleksyjna zmienna latentna); dla wskaźników formatywnych rzetelność w tym sensie nie ma zastosowania.
- Mylenie ρC z CB-SEM i z PLS-SEM. To ten sam wzór na innych ładunkach – podaj, z którego modelu pochodzi wynik.
- Dokładanie niemal identycznych pozycji, by podnieść ρC. Rzetelność rośnie, ale zawężasz treść konstruktu i ryzykujesz skorelowane błędy (zob. wpis budowa i walidacja skali).
Najczęstsze pytania
Jak policzyć rzetelność kompozytową ręcznie?
Zsumuj ładunki standaryzowane pozycji i podnieś sumę do kwadratu. Zsumuj wariancje błędu, czyli 1 − λ² dla każdej pozycji. ρC to kwadrat sumy ładunków podzielony przez ten kwadrat plus sumę wariancji błędu. W przykładzie: 3.911² = 15.30 i 15.30 / (15.30 + 3.377) = .819.
Czym rzetelność kompozytowa różni się od alfy Cronbacha?
Alfa zakłada, że wszystkie pozycje mają jednakowe ładunki (model tau-równoważny), a ρC korzysta z ładunków oszacowanych osobno dla każdej pozycji. Przy różnych ładunkach alfa zwykle nieco zaniża rzetelność; Raykov (1997) pokazał, że estymator oparty na modelu nie ma tej skłonności.
Czy rzetelność kompozytowa to to samo co omega McDonalda?
W jednoczynnikowym modelu CFA z nieskorelowanymi błędami – tak, to ten sam współczynnik pod różnymi nazwami: w SEM mówi się o rzetelności kompozytowej, w psychometrii o omedze. Przy modelach wielowymiarowych istnieje kilka odmian omegi, które odpowiadają na różne pytania.
Dlaczego rzetelność kompozytowa jest wysoka, a AVE niskie?
ρC opisuje rzetelność sumy wszystkich pozycji, a AVE – przeciętną pozycję. Wiele pozycji o umiarkowanych ładunkach daje razem rzetelny wynik, choć każda osobno wyjaśnia mniej niż połowę swojej wariancji. Taki wynik oznacza skalę użyteczną jako całość, ale z pozycjami wartymi poprawy.
Którą rzetelność podać w PLS-SEM: ρC czy ρA?
Podaj obie razem z alfą Cronbacha. Henseler i in. (2016) wskazują, że ρC i alfa odnoszą się do sum pozycji, a ρA to jedyna spójna miara rzetelności wyników konstruktów oszacowanych w PLS. Dla każdej wartością minimalną zwykle jest .70.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Alfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikKalkulator AVE, CR i HTMT
AVE, rzetelność złożona i tabela Fornella–Larckera z ładunków oraz HTMT i HTMT2 z wklejonej macierzy korelacji. Zgodny z R i semTools.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: Updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Jöreskog, K. G. (1971). Statistical analysis of sets of congeneric tests. Psychometrika, 36(2), 109–133. https://doi.org/10.1007/bf02291393
- Raykov, T. (1997). Estimation of composite reliability for congeneric measures. Applied Psychological Measurement, 21(2), 173–184. https://doi.org/10.1177/01466216970212006
Cytowania BibTeX
@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: Updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{joreskog1971statistical, author={Jöreskog, Karl G.}, title={{Statistical analysis of sets of congeneric tests}}, journal={Psychometrika}, year={1971}, volume={36}, number={2}, pages={109--133}, doi={10.1007/bf02291393}}@article{raykov1997estimation, author={Raykov, Tenko}, title={{Estimation of composite reliability for congeneric measures}}, journal={Applied Psychological Measurement}, year={1997}, volume={21}, number={2}, pages={173--184}, doi={10.1177/01466216970212006}}