constructs(), strukturalny – relationships(), szacujesz go estimate_pls(), a przedziały ufności wyznaczasz bootstrap_model(). Oceń kolejno ładunki, rzetelność, AVE i HTMT, potem VIF, ścieżki, R², f², efekty pośrednie i PLSpredict. W cSEM konstrukty zapisane przez =~ są domyślnie szacowane metodą PLSc, dlatego wyniki obu pakietów różnią się, dopóki nie wyłączysz korekty.Przykład: wsparcie, stres, poczucie skuteczności i zaangażowanie w naukę
Ten wpis to kompletna analiza PLS-SEM w R – od pliku z danymi do opisu wyników w artykule. Pracujemy na jednym modelu i wykonujemy go w dwóch pakietach: seminr (składnia zbliżona do podręcznika Haira i in., 2021, który w całości opiera się na tym pakiecie i jest dostępny w otwartym dostępie) oraz cSEM (składnia w stylu lavaan, consistent PLS i testy dopasowania). Jeśli dopiero zaczynasz, najpierw przeczytaj przewodnik PLS-SEM, w którym omawiamy logikę metody i progi oceny. Tutaj skupiamy się na kodzie, wydruku i interpretacji.
Dane są symulowane. 250 studentów odpowiedziało na skali 1–5 na pozycje czterech skal:
- WS – wsparcie społeczne (ws1–ws3),
- ST – stres akademicki (st1–st3),
- PS – poczucie skuteczności akademickiej (ps1–ps4),
- ZN – zaangażowanie w naukę (zn1–zn4).
Hipotezy: wsparcie zwiększa, a stres obniża poczucie skuteczności; poczucie skuteczności zwiększa zaangażowanie; wsparcie i stres wpływają na zaangażowanie także bezpośrednio. Najciekawsze pytanie dotyczy mediacji: czy wsparcie działa na zaangażowanie przez poczucie skuteczności? Wszystkie skale traktujemy jako refleksyjne. Gdybyś miał(a) konstrukt formatywny, zmienisz jedną linijkę kodu – pokazujemy to niżej.
Plik do pobrania: pls-sem-w-r-dane.csv (250 wierszy, 14 kolumn, 7 KB). Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z kodu z sekcji Przykład w R.
Przygotowanie danych i pakietów
- Jeden wiersz to jedna osoba, jedna kolumna to jeden wskaźnik. Nazwy kolumn z prefiksem i numerem (ws1, ws2…) pozwalają w seminr użyć skrótu
multi_items("ws", 1:3). - Pozycje odwrócone przekoduj przed analizą. W modelu refleksyjnym wszystkie wskaźniki konstruktu powinny korelować dodatnio.
- Braki danych rozwiąż świadomie. Funkcja
estimate_pls()domyślnie zastępuje braki średnią (missing = mean_replacement), co przy więcej niż kilku procentach braków zaniża wariancję i korelacje. Lepiej wcześniej zastosować imputację wielokrotną albo inną metodę opisaną w poradniku o brakach danych i imputacji w R. - Zapisz wersje pakietów. Wyniki bootstrapu i PLSpredict zależą od ziarna losowania i implementacji. W przykładzie użyliśmy R 4.5.3, seminr 2.5.0 i cSEM 0.6.1. Skrypt, dane i informacje o sesji warto dołączyć do pakietu replikacyjnego artykułu.
Specyfikacja modelu w seminr
Model PLS-SEM ma dwie części, które w seminr zapisujesz osobno. Model pomiarowy tworzy funkcja constructs(). Każdy konstrukt opisujesz funkcją composite() z wagami mode_A (domyślnie; odpowiednik wskaźników refleksyjnych w klasycznym PLS) albo mode_B (kompozyt formatywny). Funkcja reflective() oznacza konstrukt czynnikowy, potrzebny m.in. w CFA i CB-SEM w tym samym pakiecie. Model strukturalny to relationships() z listą ścieżek paths(from, to). Winieta pakietu (Ray i Danks, 2026) opisuje też konstrukty wyższego rzędu i interakcje.
W przykładzie wszystkie cztery konstrukty to kompozyty Mode A. Gdyby stres był indeksem złożonym z różnych źródeł obciążenia (egzaminy, finanse, praca), zapisałbyś go jako composite("ST", multi_items("st", 1:3), weights = mode_B). Różnicę między trybami wag opisujemy w haśle Model A i Model B w PLS-PM, a sposób rysowania takiego modelu – w haśle wykres ścieżkowy. Estymację uruchamia estimate_pls(). Algorytm zbiegł po 5 iteracjach.
Krok 1: model pomiarowy – ładunki, rzetelność, trafność
Hair i in. (2019) zalecają oceniać model refleksyjny w czterech krokach: ładunki zewnętrzne (zalecane co najmniej .708, bo wtedy konstrukt wyjaśnia ponad połowę wariancji wskaźnika), rzetelność spójności wewnętrznej (od .70 do .90; wartości powyżej .95 sugerują niemal identyczne pozycje), trafność zbieżna (AVE ≥ .50) i trafność różnicowa (HTMT). Tabela 1 zbiera wyniki.
| Konstrukt | Ładunki | α | ρA | ρC | AVE |
|---|---|---|---|---|---|
| Wsparcie społeczne (WS) | .800–.868 | .787 | .794 | .876 | .701 |
| Stres akademicki (ST) | .828–.868 | .797 | .801 | .881 | .711 |
| Poczucie skuteczności (PS) | .695–.821 | .776 | .787 | .856 | .598 |
| Zaangażowanie w naukę (ZN) | .806–.876 | .857 | .857 | .903 | .701 |
Ładunki. Tylko jeden wskaźnik, ps4, miał ładunek nieco poniżej .708: .695, 95% CI [.610, .762]. Nie usuwaj go automatycznie. Ładunki między .40 a .708 usuwa się zwykle tylko wtedy, gdy poprawia to rzetelność lub AVE ponad próg, a tu oba kryteria są już spełnione (ρC = .856, AVE = .598). Usunięcie zmieniłoby treść skali bez potrzeby.
Rzetelność. Wszystkie trzy miary przekroczyły .70; ρC zaangażowania (.903) jest nieco powyżej .90, ale daleko od .95, przy którym pozycje stają się powtórzeniami. ρA leży między alfą a rzetelnością kompozytową ρC, co jest typowe: alfa zakłada równe ładunki, a ρC w klasycznym PLS jest liczona z ładunków kompozytów, które zawyżają wynik.
Trafność różnicowa. Henseler i in. (2015) pokazali w symulacji, że kryterium Fornella–Larckera i ładunki krzyżowe słabo wykrywają brak trafności różnicowej, i zaproponowali HTMT. Najwyższe HTMT w przykładzie dotyczyło pary PS–ZN: .601, 95% CI [.489, .703]. Górne granice wszystkich przedziałów leżały wyraźnie poniżej progów .85 i .90, więc trafność różnicowa nie budzi zastrzeżeń. Kryterium Fornella–Larckera możesz podać pomocniczo: pierwiastki z AVE (.774–.843) przewyższały korelacje konstruktów (najwyższa: .493 między PS i ZN).
Krok 2: bootstrap – ustawienia, które trzeba podać
PLS nie zakłada rozkładu normalnego, więc błędy standardowe i przedziały ufności wyznacza bootstrap. Funkcja bootstrap_model() losuje z danych próby z powtórzeniami i dla każdej szacuje model od nowa. W raporcie podaj trzy ustawienia:
- Liczbę prób. W przykładzie 5000; mniejsza liczba (np. 500) wystarcza do szybkiego sprawdzenia, ale nie do raportu.
- Rodzaj przedziału. seminr podaje przedziały percentylowe (kolumny
2.5% CIi97.5% CI). - Ziarno losowania (
seed = 2021). Przy obliczeniach równoległych wynik może się nieznacznie różnić między komputerami, dlatego w przykładzie ustawiamycores = 1.
Statystyka t w wydruku to oszacowanie podzielone przez błąd standardowy z bootstrapu. Do wnioskowania używaj jednak przedziałów ufności: efekt jest istotny na poziomie .05, gdy 95% CI nie obejmuje zera.
Krok 3: model strukturalny – współliniowość, ścieżki, R² i f²
Zanim zinterpretujesz ścieżki, sprawdź współliniowość predyktorów każdego konstruktu endogenicznego. Hair i in. (2019) traktują VIF powyżej 5 jako krytyczny, a za wartości pożądane uznają te poniżej około 3. W przykładzie VIF wynosiły od 1.05 do 1.29.
| Ścieżka | β | 95% CI | t | f² |
|---|---|---|---|---|
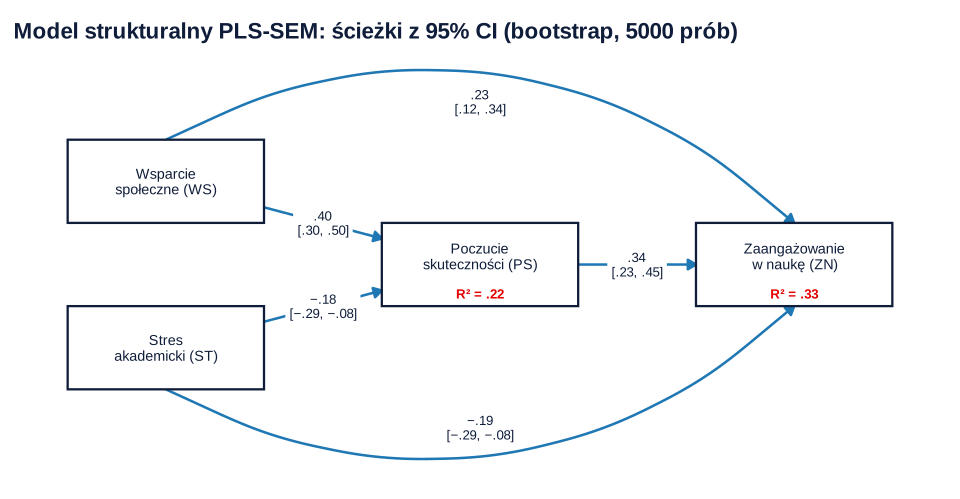
| WS → PS | 0.397 | [0.296, 0.502] | 7.48 | .193 |
| ST → PS | −0.185 | [−0.293, −0.078] | −3.32 | .042 |
| WS → ZN | 0.235 | [0.123, 0.342] | 4.13 | .065 |
| ST → ZN | −0.189 | [−0.292, −0.084] | −3.60 | .049 |
| PS → ZN | 0.339 | [0.228, 0.449] | 5.95 | .132 |
Wszystkie pięć ścieżek miało kierunek zgodny z hipotezami, a żaden przedział nie obejmował zera. Model wyjaśniał 22.4% wariancji poczucia skuteczności (R² = .224) i 33.0% wariancji zaangażowania (R² = .330). Wielkość efektu f² mówi, o ile spadłoby R² po usunięciu danego predyktora. Według progów Cohena przywoływanych przez Haira i in. (2019) – .02, .15 i .35 dla efektów małych, średnich i dużych – wsparcie miało średni wpływ na poczucie skuteczności (.193), a pozostałe efekty były małe (.042–.132). Rysunek 1 pokazuje cały model.
Krok 4: efekt pośredni i typ mediacji
Funkcja specific_effect_significance() zwraca konkretny efekt pośredni z przedziałem bootstrapowym. Efekt WS → PS → ZN wyniósł 0.135, 95% CI [0.083, 0.196], czyli był istotny. Efekt całkowity wsparcia na zaangażowanie wyniósł 0.369 [0.263, 0.470], a bezpośredni – 0.235 [0.123, 0.342].
Jak nazwać ten wynik? Zhao i in. (2010) zwrócili uwagę, że do stwierdzenia mediacji wystarczy istotny efekt pośredni, a wymóg istotnego efektu całkowitego z podejścia Barona i Kenny’ego jest zbędny. Zaproponowali też klasyfikację typów mediacji, którą Nitzl i in. (2016) przenieśli do PLS-SEM w postaci drzewa decyzyjnego. Ponieważ istotne są oba efekty – pośredni i bezpośredni – a mają ten sam znak, mamy do czynienia z mediacją komplementarną, czyli częściową. Efekt pośredni stanowi wyraźną, ale nie dominującą część efektu całkowitego. Ogólne zasady analizy mediacji opisuje poradnik analiza mediacji krok po kroku.
Krok 5: PLSpredict – czy model przewiduje nowe osoby?
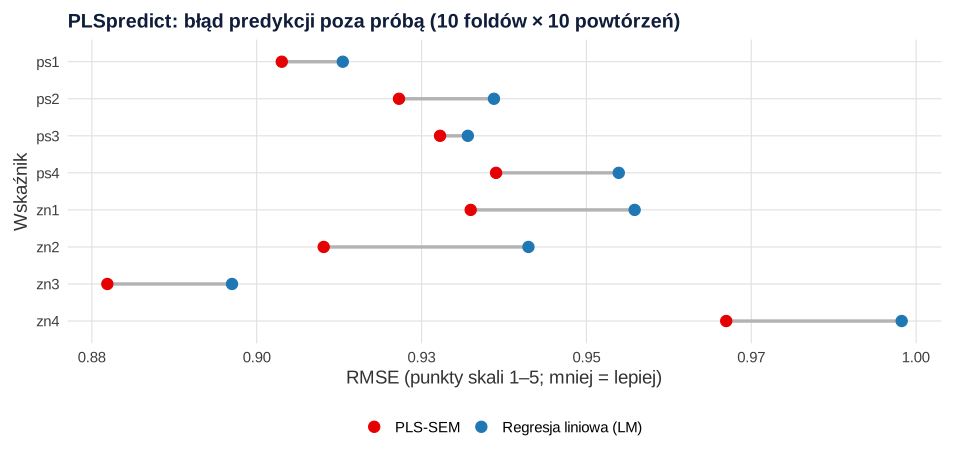
R² mówi, jak dobrze model wyjaśnia dane, na których go oszacowano. Shmueli i in. (2019) zwracają uwagę, że to nie to samo co trafność predykcyjna, i zalecają rutynowo stosować PLSpredict. Procedura dzieli próbę na k części, szacuje model na k − 1 z nich i przewiduje wartości wskaźników w części pominiętej. Błąd predykcji (RMSE lub MAE) porównuje się z prostym modelem liniowym (LM), który przewiduje każdy wskaźnik bezpośrednio ze wskaźników konstruktów egzogenicznych. Zgodnie z procedurą Shmueliego i in. (2019) moc predykcyjną ocenia się według tego, dla ilu wskaźników kluczowego konstruktu PLS-SEM ma mniejszy błąd niż LM.
W przykładzie użyliśmy 10 części i 10 powtórzeń (noFolds = 10, reps = 10). PLS-SEM miał mniejszy RMSE niż LM dla wszystkich ośmiu wskaźników PS i ZN: różnice wynosiły od −0.004 (ps3) do −0.031 (zn2) punktu skali. Rysunek 2 pokazuje obie wartości dla każdego wskaźnika. Dodatkowo w cSEM policzyliśmy Q²predict – porównanie z naiwną prognozą średnią z części uczącej. Średnio z 10 powtórzeń wyniósł od .078 do .171, a więc był dodatni dla wszystkich wskaźników. To wartości umiarkowane: model przewiduje lepiej niż średnia i lepiej niż LM, ale błąd predykcji jest wciąż bliski jednemu punktowi skali 1–5. Więcej o tej mierze w haśle Q² Stone’a-Geissera.
Gdy w modelu jest konstrukt formatywny
Kod zmienia się w jednym miejscu – weights = mode_B w definicji konstruktu – ale ocena modelu pomiarowego wygląda zupełnie inaczej. Wskaźniki formatywne nie muszą ze sobą korelować, więc alfa, ρC, AVE i HTMT nie mają dla nich sensu. Zamiast nich sprawdź:
- współliniowość wskaźników – VIF z
summary(pls)$validity$vif_items; wysoki VIF utrudnia interpretację wag; - wagi zewnętrzne z przedziałami bootstrapowymi –
summary(boot)$bootstrapped_weights; nieistotna waga nie jest automatycznie powodem do usunięcia wskaźnika, jeśli jego ładunek jest wyraźny, a treść potrzebna do pełnej definicji konstruktu; - trafność zbieżną przez analizę redundancji – osobny model, w którym kompozyt formatywny przewiduje globalną miarę tego samego konstruktu (np. jedną pozycję ogólną); wymaga to zaplanowania takiej pozycji już w kwestionariuszu.
Przykład z konstruktem formatywnym i analizą redundancji pokazujemy w przewodniku PLS-SEM, a kryteria wyboru między pomiarem refleksyjnym i formatywnym – we wpisie model refleksyjny czy formatywny. W cSEM konstrukt formatywny zapisujesz operatorem <~; korekta PLSc go nie obejmuje, bo kompozyt z definicji nie zawiera błędu pomiaru.
Ten sam model w cSEM: PLSc i test dopasowania
cSEM przyjmuje składnię lavaan: =~ oznacza konstrukt czynnikowy, <~ – kompozyt, a ~ – ścieżkę strukturalną. Uwaga na ustawienie domyślne: csem() dla konstruktów zapisanych przez =~ stosuje korektę consistent PLS (.disattenuate = TRUE). Aby odtworzyć wynik seminr, trzeba ją wyłączyć. Bez korekty oba pakiety dały identyczne ścieżki (np. WS → PS: 0.397).
PLSc. Consistent PLS (Dijkstra i Henseler, 2015) koryguje korelacje konstruktów na niepełną rzetelność kompozytów. Jeśli skale są refleksyjne, a interesują Cię parametry modelu czynnikowego, PLSc jest właściwszy niż klasyczny PLS. Ścieżki po korekcie były wyższe: WS → PS 0.497, 95% CI [0.351, 0.630], PS → ZN 0.400 [0.232, 0.570], a efekt pośredni WS → PS → ZN 0.199 [0.105, 0.314]. Ścieżki ST → PS (−0.206), WS → ZN (0.238) i ST → ZN (−0.199) zmieniły się mniej. Wzrosło też R²: do .345 dla PS i .443 dla ZN. Przedziały są szersze, bo korekta zwiększa zmienność oszacowań.
Rzetelność po korekcie. W PLSc ładunki szacuje się jak w modelu czynnikowym, więc ρC spadła z .856 do .778, a AVE poczucia skuteczności – z .598 do .470, poniżej .50. To nie błąd, tylko inna definicja: klasyczny PLS zawyża ładunki, bo kompozyt zawiera wariancję swoistą wskaźników. Jeśli raportujesz PLSc, oceniaj model pomiarowy na podstawie oszacowań PLSc i napisz o tym wprost. Tu AVE poniżej .50 przy ρC = .78 wynika głównie ze słabszego wskaźnika ps4.
Test dopasowania. Schuberth i in. (2023) pokazują, że globalne dopasowanie modeli szacowanych PLS można i trzeba oceniać – testem statystycznym i wskaźnikami znanymi z SEM. Funkcja testOMF() porównuje rozbieżność między macierzą z danych a macierzą odtworzoną przez model z rozkładem tej rozbieżności z bootstrapu (999 prób, 991 dopuszczalnych). Żadna miara nie przekroczyła wartości krytycznej: SRMR = .031 (wartość krytyczna .042), dG = 0.073 (0.111), dULS = 0.101 (0.189; w wydruku oznaczona jako dL). Model nie jest więc niezgodny z danymi. Dokumentacja cSEM (Rademaker, 2026) przypomina, że dla modeli kompozytowych nie zaproponowano dotąd wartości odcięcia wskaźników dopasowania i że decyzja nie powinna opierać się na porównaniu jednego wskaźnika z arbitralnym progiem. Więcej o tych miarach w haśle dULS i dG.
Dlaczego seminr i cSEM mogą dać różne liczby?
- Inny model domyślny.
composite()w seminr to klasyczny PLS, a=~w cSEM – domyślnie PLSc. Najczęstsza „rozbieżność” między pakietami to po prostu porównanie dwóch różnych estymatorów. - Inne próby bootstrapowe. Nawet przy tym samym ziarnie pakiety losują inaczej, więc granice przedziałów różnią się w trzecim miejscu po przecinku.
- Rozwiązania niedopuszczalne. cSEM domyślnie odrzuca próby bootstrapowe z niedopuszczalnym wynikiem (np. ładunkiem powyżej 1) – w teście dopasowania odrzucił 8 z 999 prób. Podaj tę liczbę w raporcie.
- Inne definicje tej samej miary. Rzetelność i AVE liczone z ładunków PLS i PLSc nie są tą samą wielkością. Zawsze pisz, z którego estymatora pochodzą.
- Inny benchmark w PLSpredict. Model LM i sposób podziału na części zależą od implementacji, dlatego porównania z LM i Q²predict raportuj z jednego pakietu.
Kiedy wybrać klasyczny PLS, kiedy PLSc, a kiedy w ogóle CB-SEM, rozważamy we wpisie PLS-SEM czy CB-SEM. Analogiczny kompletny przykład w podejściu kowariancyjnym pokazuje wpis CB-SEM w R z pakietem lavaan.
Jak opisać wyniki PLS-SEM w artykule (APA)
W raporcie podaj: oprogramowanie z wersjami, tryb wag i schemat ważenia wewnętrznego, ustawienia bootstrapu, pełną ocenę modelu pomiarowego (tabela), ścieżki z przedziałami, R² i f², efekty pośrednie, wynik PLSpredict oraz – przy PLSc – test dopasowania. Poniższe akapity możesz dostosować do własnego modelu.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Możesz pominąć przepis 0 i od razu pobrać plik pls-sem-w-r-dane.csv – zapisz go w katalogu roboczym R. Bootstrap z 5000 prób w seminr, PLSpredict i test dopasowania w cSEM trwają łącznie kilka minut.
0. Symulacja danych
R
# PLS-SEM w R – przepis 0: dane symulowane do przykładu (250 studentów, odpowiedzi 1–5)
# Konstrukty: wsparcie społeczne (ws1–ws3), poczucie skuteczności akademickiej (ps1–ps4),
# stres akademicki (st1–st3), zaangażowanie w naukę (zn1–zn4).
# Model populacyjny: WS -> PS (.45), ST -> PS (−.20), PS -> ZN (.40), WS -> ZN (.15), ST -> ZN (−.25).
suppressPackageStartupMessages(library(MASS))
set.seed(3108)
n <- 250
WS <- rnorm(n); ST <- -.25 * WS + rnorm(n, sd = sqrt(1 - .25^2))
PS <- .45 * WS - .20 * ST; PS <- PS + rnorm(n, sd = sqrt(1 - var(PS)))
ZN <- .40 * PS + .15 * WS - .25 * ST; ZN <- ZN + rnorm(n, sd = sqrt(1 - var(ZN)))
wskazniki <- function(eta, lam, pref) {
  X <- sapply(lam, function(l) l * eta + rnorm(n, sd = sqrt(1 - l^2)))
  X <- apply(X, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf))))
  colnames(X) <- paste0(pref, seq_along(lam)); X
}
dane <- data.frame(wskazniki(WS, c(.82, .78, .74), "ws"), wskazniki(PS, c(.80, .76, .72, .58), "ps"),
                   wskazniki(ST, c(.84, .80, .70), "st"), wskazniki(ZN, c(.83, .79, .75, .70), "zn"))
write.csv(dane, "pls-sem-w-r-dane.csv", row.names = FALSE)
str(dane)
round(colMeans(dane), 2)
Wynik w R
'data.frame':	250 obs. of  14 variables:
 $ ws1: int  5 1 3 4 3 3 2 4 4 3 ...
 $ ws2: int  4 2 3 4 1 1 3 3 4 3 ...
 $ ws3: int  5 2 2 5 3 2 2 2 3 3 ...
 $ ps1: int  5 3 3 5 3 2 3 3 3 3 ...
 $ ps2: int  3 1 3 5 4 3 3 2 4 3 ...
 $ ps3: int  3 1 2 4 3 2 3 2 4 3 ...
 $ ps4: int  4 1 3 4 3 2 3 3 4 4 ...
 $ st1: int  3 3 1 4 3 3 4 4 2 4 ...
 $ st2: int  4 5 1 3 3 3 2 4 3 3 ...
 $ st3: int  4 4 3 4 3 4 4 4 4 3 ...
 $ zn1: int  4 1 4 5 4 3 3 2 4 2 ...
 $ zn2: int  4 1 4 5 3 2 3 2 5 2 ...
 $ zn3: int  5 1 4 5 4 2 3 2 4 2 ...
 $ zn4: int  4 1 3 5 4 2 3 2 4 1 ...
 ws1  ws2  ws3  ps1  ps2  ps3  ps4  st1  st2  st3  zn1  zn2  zn3  zn4
3.03 3.02 3.04 3.06 2.98 3.02 3.04 3.03 3.00 3.05 2.95 2.98 2.98 3.09
1. Pełna analiza w seminr
R
# PLS-SEM w R – przepis 1: pełna analiza w pakiecie seminr
library(seminr)
dane <- read.csv("pls-sem-w-r-dane.csv")      # plik do pobrania: pls-sem-w-r-dane.csv

# 1. Model pomiarowy: kompozyty Mode A (klasyczny PLS-SEM dla wskaźników refleksyjnych)
mm <- constructs(
  composite("WS", multi_items("ws", 1:3)),
  composite("PS", multi_items("ps", 1:4)),
  composite("ST", multi_items("st", 1:3)),
  composite("ZN", multi_items("zn", 1:4))
)
# 2. Model strukturalny
sm <- relationships(
  paths(from = c("WS", "ST"), to = "PS"),
  paths(from = c("WS", "ST", "PS"), to = "ZN")
)
# 3. Estymacja
pls <- estimate_pls(data = dane, measurement_model = mm, structural_model = sm)
s <- summary(pls)
s$iterations                       # liczba iteracji algorytmu

# 4. Model pomiarowy: ładunki, rzetelność, trafność różnicowa
round(s$loadings, 3)
round(s$reliability, 3)            # alpha, rhoC, AVE, rhoA
round(s$validity$htmt, 3)
round(s$validity$fl_criteria, 3)

# 5. Bootstrap (5000 prób) – przedziały ufności ładunków, HTMT, ścieżek i efektów
boot <- bootstrap_model(pls, nboot = 5000, cores = 1, seed = 2021)
sb <- summary(boot, alpha = 0.05)
round(sb$bootstrapped_loadings[, c("Original Est.", "2.5% CI", "97.5% CI")], 3)
round(sb$bootstrapped_HTMT[, c("Original Est.", "2.5% CI", "97.5% CI")], 3)
round(sb$bootstrapped_paths[, c("Original Est.", "Bootstrap SD", "T Stat.", "2.5% CI", "97.5% CI")], 3)

# 6. Efekt pośredni WS -> PS -> ZN i efekt całkowity
round(specific_effect_significance(boot, from = "WS", through = "PS", to = "ZN", alpha = 0.05), 3)
round(sb$bootstrapped_total_paths[, c("Original Est.", "2.5% CI", "97.5% CI")], 3)

# 7. Model strukturalny: współliniowość, R², f²
round(unlist(s$vif_antecedents), 3)
round(s$paths, 3)                  # współczynniki ścieżek, R² i skorygowane R²
round(s$fSquare, 3)

# 8. PLSpredict: 10-krotna walidacja krzyżowa powtórzona 10 razy, porównanie z regresją liniową (LM)
set.seed(2021)
pred <- predict_pls(model = pls, technique = predict_DA, noFolds = 10, reps = 10)
sp <- summary(pred)
oos <- rbind(PLS_RMSE = sp$PLS_out_of_sample["RMSE", ], LM_RMSE = sp$LM_out_of_sample["RMSE", ],
             PLS_MAE = sp$PLS_out_of_sample["MAE", ], LM_MAE = sp$LM_out_of_sample["MAE", ])
round(oos, 3)
round(oos["PLS_RMSE", ] - oos["LM_RMSE", ], 3)        # wartość ujemna = PLS przewiduje lepiej niż LM
round(sp$construct_error, 4)
Wynik w R
Generating the seminr model
All 250 observations are valid.
[1] 5
        WS     ST     PS     ZN
ws1  0.868 -0.000  0.000  0.000
ws2  0.800 -0.000  0.000  0.000
ws3  0.844 -0.000  0.000  0.000
ps1  0.000 -0.000  0.793  0.000
ps2  0.000 -0.000  0.821  0.000
ps3  0.000 -0.000  0.779  0.000
ps4  0.000 -0.000  0.695  0.000
st1 -0.000  0.868 -0.000 -0.000
st2 -0.000  0.828 -0.000 -0.000
st3 -0.000  0.833 -0.000 -0.000
zn1  0.000 -0.000  0.000  0.876
zn2  0.000 -0.000  0.000  0.838
zn3  0.000 -0.000  0.000  0.827
zn4  0.000 -0.000  0.000  0.806
   alpha  rhoA  rhoC   AVE
WS 0.787 0.794 0.876 0.701
ST 0.797 0.801 0.881 0.711
PS 0.776 0.787 0.856 0.598
ZN 0.857 0.857 0.903 0.701

Alpha, rhoA, and rhoC should exceed 0.7 while AVE should exceed 0.5
      WS    ST    PS ZN
WS     .     .     .  .
ST 0.276     .     .  .
PS 0.553 0.343     .  .
ZN 0.513 0.402 0.601  .
       WS     ST    PS    ZN
WS  0.838      .     .     .
ST -0.220  0.843     .     .
PS  0.437 -0.272 0.774     .
ZN  0.425 -0.333 0.493 0.837

FL Criteria table reports square root of AVE on the diagonal and construct correlations on the lower triangle.
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
            Original Est. 2.5% CI 97.5% CI
ws1  ->  WS         0.868   0.827    0.897
ws2  ->  WS         0.800   0.736    0.847
ws3  ->  WS         0.844   0.789    0.884
ps1  ->  PS         0.793   0.733    0.840
ps2  ->  PS         0.821   0.768    0.860
ps3  ->  PS         0.779   0.715    0.828
ps4  ->  PS         0.695   0.610    0.762
st1  ->  ST         0.868   0.820    0.905
st2  ->  ST         0.828   0.757    0.876
st3  ->  ST         0.833   0.769    0.880
zn1  ->  ZN         0.876   0.838    0.905
zn2  ->  ZN         0.838   0.789    0.874
zn3  ->  ZN         0.827   0.776    0.866
zn4  ->  ZN         0.806   0.751    0.848
           Original Est. 2.5% CI 97.5% CI
WS  ->  ST         0.276   0.143    0.415
WS  ->  PS         0.553   0.425    0.674
WS  ->  ZN         0.513   0.390    0.623
ST  ->  PS         0.343   0.204    0.475
ST  ->  ZN         0.402   0.268    0.522
PS  ->  ZN         0.601   0.489    0.703
           Original Est. Bootstrap SD T Stat. 2.5% CI 97.5% CI
WS  ->  PS         0.397        0.053   7.483   0.296    0.502
WS  ->  ZN         0.235        0.057   4.129   0.123    0.342
ST  ->  PS        -0.185        0.056  -3.322  -0.293   -0.078
ST  ->  ZN        -0.189        0.053  -3.598  -0.292   -0.084
PS  ->  ZN         0.339        0.057   5.950   0.228    0.449
           Original Est. Bootstrap Mean Bootstrap SD T Stat. 2.5% CI 97.5% CI
WS->PS->ZN         0.135          0.136        0.029   4.639   0.083    0.196
           Bootstrap P Val
WS->PS->ZN           0.000
           Original Est. 2.5% CI 97.5% CI
WS  ->  PS         0.397   0.296    0.502
WS  ->  ZN         0.369   0.263    0.470
ST  ->  PS        -0.185  -0.293   -0.078
ST  ->  ZN        -0.252  -0.354   -0.145
PS  ->  ZN         0.339   0.228    0.449
PS.WS PS.ST ZN.WS ZN.ST ZN.PS
1.051 1.051 1.254 1.095 1.288
           PS     ZN
R^2     0.224  0.330
AdjR^2  0.218  0.322
WS      0.397  0.235
ST     -0.185 -0.189
PS          .  0.339
      WS    ST    PS    ZN
WS 0.000 0.000 0.193 0.065
ST 0.000 0.000 0.042 0.049
PS 0.000 0.000 0.000 0.132
ZN 0.000 0.000 0.000 0.000
           ps1   ps2   ps3   ps4   zn1   zn2   zn3   zn4
PLS_RMSE 0.904 0.922 0.928 0.936 0.932 0.910 0.877 0.971
LM_RMSE  0.913 0.936 0.932 0.955 0.957 0.941 0.896 0.998
PLS_MAE  0.724 0.743 0.743 0.748 0.761 0.749 0.719 0.764
LM_MAE   0.739 0.752 0.749 0.764 0.775 0.777 0.732 0.784
   ps1    ps2    ps3    ps4    zn1    zn2    zn3    zn4
-0.009 -0.014 -0.004 -0.019 -0.025 -0.031 -0.019 -0.027
            PS     ZN
IS_MSE  0.7716 0.6653
IS_MAE  0.7027 0.6651
OOS_MSE 0.7873 0.6887
OOS_MAE 0.7098 0.6780
overfit 0.0204 0.0352
2. Ten sam model w cSEM: PLS, PLSc, ocena i test dopasowania
R
# PLS-SEM w R – przepis 2: ten sam model w pakiecie cSEM – PLS, PLSc, ocena dopasowania i Q²predict
suppressPackageStartupMessages(library(cSEM))
dane <- read.csv("pls-sem-w-r-dane.csv")
model <- '
  # model strukturalny
  PS ~ WS + ST
  ZN ~ WS + ST + PS
  # model pomiarowy: <~ = kompozyt (Mode B), =~ = konstrukt refleksyjny (wagi Mode A)
  WS =~ ws1 + ws2 + ws3
  PS =~ ps1 + ps2 + ps3 + ps4
  ST =~ st1 + st2 + st3
  ZN =~ zn1 + zn2 + zn3 + zn4
'
# Klasyczny PLS (jak w seminr) i PLSc (korekta na rzetelność – estymuje model czynnika wspólnego)
pls  <- csem(dane, model, .disattenuate = FALSE)
plsc <- csem(dane, model, .disattenuate = TRUE, .resample_method = "bootstrap", .R = 2000, .seed = 2021)
verify(plsc)                                  # dopuszczalność rozwiązania
sciezki <- function(f) { s <- summarize(f)$Estimates$Path_estimates; setNames(s$Estimate, s$Name) }
round(cbind(PLS = sciezki(pls), PLSc = sciezki(plsc)), 3)
# Ścieżki PLSc z przedziałami bootstrapowymi (percentylowe)
sp <- summarize(plsc)$Estimates$Path_estimates
sp[, c("Name", "Estimate", "Std_err", "CI_percentile.95%L", "CI_percentile.95%U")] |>
  transform(Estimate = round(Estimate, 3), Std_err = round(Std_err, 3),
            `CI_percentile.95%L` = round(`CI_percentile.95%L`, 3), `CI_percentile.95%U` = round(`CI_percentile.95%U`, 3), check.names = FALSE)
# Efekt pośredni WS -> PS -> ZN w PLSc
ie <- summarize(plsc)$Estimates$Effect_estimates$Indirect_effect
ie[, c("Name", "Estimate", "CI_percentile.95%L", "CI_percentile.95%U")] |>
  transform(Estimate = round(Estimate, 3), `CI_percentile.95%L` = round(`CI_percentile.95%L`, 3),
            `CI_percentile.95%U` = round(`CI_percentile.95%U`, 3), check.names = FALSE)

# Ocena modelu: rzetelność, HTMT, HTMT2, R², f², SRMR
a <- assess(plsc, .quality_criterion = c("rho_C", "rho_T", "ave", "htmt", "htmt2", "r2", "f2", "srmr"))
round(rbind(rho_T_alfa = a$RhoT, rho_C = a$RhoC, AVE = a$AVE, rho_A = plsc$Estimates$Reliabilities), 3)
round(a$HTMT$htmts, 3); round(a$HTMT2$htmts, 3)
round(a$R2, 3); round(a$F2, 3); round(a$SRMR, 3)

# Test dopasowania modelu (bootstrap Beran–Srivastava): d_G, SRMR, d_ULS
set.seed(2021)
testOMF(plsc, .R = 999, .seed = 2021)

# PLSpredict w cSEM: Q²predict (10 foldów) – 10 powtórzeń z ustalonym ziarnem każdego podziału, potem średnia
# (w cSEM 0.6.1 argument .seed działa tylko przy .r = 1, dlatego powtórzenia wykonujemy w pętli)
pr <- lapply(1:10, function(i) suppressWarnings(
  predict(pls, .benchmark = "lm", .cv_folds = 10, .r = 1, .seed = 2020 + i))$Prediction_metrics)
m <- data.frame(Name = pr[[1]]$Name,
                sapply(c("MAE_target", "RMSE_target", "Q2_predict"), function(k) rowMeans(sapply(pr, `[[`, k))))
m[, -1] <- round(m[, -1], 3); m
Wynik w R
________________________________________________________________________________

Verify admissibility:

	 admissible

Details:

  Code   Status    Description
  1      ok        Convergence achieved
  2      ok        All absolute standardized loading estimates <= 1
  3      ok        Construct VCV is positive semi-definite
  4      ok        All reliability estimates <= 1
  5      ok        Model-implied indicator VCV is positive semi-definite
________________________________________________________________________________
           PLS   PLSc
PS ~ WS  0.397  0.497
PS ~ ST -0.185 -0.206
ZN ~ WS  0.235  0.238
ZN ~ ST -0.189 -0.199
ZN ~ PS  0.339  0.400
     Name Estimate Std_err CI_percentile.95%L CI_percentile.95%U
1 PS ~ WS    0.497   0.071              0.351              0.630
2 PS ~ ST   -0.206   0.074             -0.350             -0.063
3 ZN ~ WS    0.238   0.083              0.072              0.389
4 ZN ~ ST   -0.199   0.069             -0.333             -0.064
5 ZN ~ PS    0.400   0.087              0.232              0.570
     Name Estimate CI_percentile.95%L CI_percentile.95%U
1 ZN ~ WS    0.199              0.105              0.314
2 ZN ~ ST   -0.082             -0.159             -0.023
              WS    ST    PS    ZN
rho_T_alfa 0.787 0.797 0.776 0.857
rho_C      0.789 0.798 0.778 0.856
AVE        0.556 0.569 0.470 0.599
rho_A      0.794 0.801 0.787 0.857
      WS    ST    PS ZN
WS 1.000 0.000 0.000  0
ST 0.276 1.000 0.000  0
PS 0.553 0.343 1.000  0
ZN 0.513 0.402 0.601  1
      WS    ST    PS ZN
WS 1.000 0.000 0.000  0
ST 0.269 1.000 0.000  0
PS 0.543 0.339 1.000  0
ZN 0.510 0.399 0.599  1
   PS    ZN
0.345 0.443
      WS    ST    PS ZN
PS 0.348 0.060 0.000  0
ZN 0.070 0.062 0.188  0
[1] 0.031
________________________________________________________________________________
--------- Test for overall model fit based on Beran & Srivastava (1985) --------

Null hypothesis:

       ┌──────────────────────────────────────────────────────────────────┐
       │                                                                  │
       │   H0: The model-implied indicator covariance matrix equals the   │
       │   population indicator covariance matrix.                        │
       │                                                                  │
       └──────────────────────────────────────────────────────────────────┘

Test statistic and critical value:

	                                  	Critical value
	Distance measure    Test statistic	  95%
	dG                      0.0725    	0.1106
	SRMR                    0.0310    	0.0424
	dL                      0.1009    	0.1890
	dML                     0.3635    	0.5797


Decision:

	                    	Significance level
	Distance measure    	     95%
	dG                  	Do not reject
	SRMR                	Do not reject
	dL                  	Do not reject
	dML                 	Do not reject

Additional information:

	Out of 999 bootstrap replications 991 are admissible.
	See ?verify() for what constitutes an inadmissible result.

	The seed used was: 2021
________________________________________________________________________________
  Name MAE_target RMSE_target Q2_predict
1  ps1      0.725       0.904      0.146
2  ps2      0.743       0.921      0.171
3  ps3      0.742       0.925      0.100
4  ps4      0.749       0.937      0.078
5  zn1      0.778       0.960      0.138
6  zn2      0.765       0.936      0.165
7  zn3      0.734       0.917      0.156
8  zn4      0.775       0.993      0.167
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- cSEM (wersja 0.6.1): Rademaker, M. E., & Schuberth, F. (2020). cSEM: Composite-based structural equation modeling (Version 0.6.1) [R package]. https://floschuberth.github.io/cSEM/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie PLS-SEM w R
- Porównywanie seminr z cSEM bez wyłączenia PLSc. Różne liczby nie świadczą o błędzie pakietu, tylko o innym estymatorze.
- Bootstrap z kilkuset prób i bez ziarna losowania. Wynik nie jest powtarzalny, a granice przedziałów są niestabilne.
- Interpretacja t > 1.96 zamiast przedziałów ufności, zwłaszcza dla efektów pośrednich, których rozkład bywa skośny.
- Usuwanie wskaźników z ładunkiem poniżej .708 bez sprawdzenia rzetelności, AVE i treści.
- Ocena konstruktów formatywnych kryteriami refleksyjnymi (ładunki, AVE, alfa). Dla Mode B sprawdź VIF wskaźników i istotność wag.
- Domyślne zastępowanie braków średnią przy więcej niż kilku procentach braków.
- Raport bez PLSpredict w badaniu, które deklaruje cel predykcyjny.
- Brak informacji o wersjach pakietów i ustawieniach – bez nich recenzent nie odtworzy wyniku.
Jeśli przygotowujesz artykuł z modelem PLS-SEM i chcesz, by ktoś sprawdził specyfikację, wykonał analizę albo przygotował tabele do raportu, zajrzyj do oferty analiz statystycznych dla badaczy.
Najczęstsze pytania
Jak zrobić PLS-SEM w R krok po kroku?
Wczytaj dane, zapisz model pomiarowy funkcją constructs() i strukturalny funkcją relationships() z pakietu seminr, a następnie oszacuj model estimate_pls() i uruchom bootstrap_model() z co najmniej kilkoma tysiącami prób. Wyniki odczytasz z summary(): ładunki, rzetelność, HTMT, ścieżki, R², f² i VIF. Predykcję poza próbą sprawdzisz funkcją predict_pls().
Czym różni się seminr od cSEM?
Oba pakiety szacują PLS-SEM, ale mają inną składnię i ustawienia domyślne. seminr używa funkcji constructs() i relationships() oraz domyślnie klasycznego PLS; cSEM przyjmuje składnię lavaan, a konstrukty zapisane przez =~ szacuje domyślnie metodą consistent PLS. cSEM ma też wbudowany test dopasowania testOMF().
Ile prób bootstrapowych ustawić w PLS-SEM?
Do raportu użyj kilku tysięcy prób (np. 5000) i ustal ziarno losowania, aby wynik był powtarzalny. Kilkaset prób wystarczy do szybkiego sprawdzenia modelu, ale granice przedziałów ufności będą wtedy niestabilne. W raporcie podaj liczbę prób, rodzaj przedziału i liczbę prób odrzuconych jako niedopuszczalne.
Jak sprawdzić efekt pośredni w seminr?
Po bootstrapie użyj funkcji specific_effect_significance(boot, from, through, to), która zwraca oszacowanie efektu pośredniego z bootstrapowym przedziałem ufności. Efekt jest istotny, gdy przedział nie obejmuje zera. Typ mediacji (komplementarna, konkurencyjna, tylko pośrednia) określ, porównując efekt pośredni z bezpośrednim.
Jak odczytać wynik predict_pls w seminr?
Porównaj błędy predykcji (RMSE albo MAE) modelu PLS-SEM z błędami prostego modelu liniowego dla wskaźników kluczowego konstruktu endogenicznego. Im więcej wskaźników ma mniejszy błąd w PLS-SEM, tym wyższa moc predykcyjna modelu; dodatnie Q²predict oznacza, że model przewiduje lepiej niż sama średnia.
Powiązane hasła
Przeczytaj też
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →Masz model PLS-SEM do artykułu?
Sprawdzimy specyfikację, wykonamy analizę w R z pełną oceną modelu i przygotujemy tabele oraz opis wyników, które obronią się w recenzji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Hair, J. F., Jr., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7 ● Otwarty dostęp
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Nitzl, C., Roldán, J. L., & Cepeda, G. (2016). Mediation analysis in partial least squares path modeling: Helping researchers discuss more sophisticated models. Industrial Management & Data Systems, 116(9), 1849–1864. https://doi.org/10.1108/imds-07-2015-0302 ● Otwarty dostęp: pełny tekst
- Rademaker, M. E. (2026). Postestimation: Assessing a model. cSEM: Composite-based structural equation modeling (dokumentacja pakietu). https://floschuberth.github.io/cSEM/articles/Using-assess.html ● Otwarty dostęp
- Ray, S., & Danks, N. (2026). SEMinR [winieta pakietu seminr]. CRAN. https://cran.r-project.org/web/packages/seminr/vignettes/SEMinR.html ● Otwarty dostęp
- Schuberth, F., Rademaker, M. E., & Henseler, J. (2023). Assessing the overall fit of composite models estimated by partial least squares path modeling. European Journal of Marketing, 57(6), 1678–1702. https://doi.org/10.1108/ejm-08-2020-0586 ● Otwarty dostęp
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
- Zhao, X., Lynch, J. G., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257 ● Otwarty dostęp
Cytowania BibTeX
@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@book{hair2021pls, author={Hair, Joseph F., Jr. and Hult, G. Tomas M. and Ringle, Christian M. and Sarstedt, Marko and Danks, Nicholas P. and Ray, Soumya}, title={{Partial least squares structural equation modeling (PLS-SEM) using R: A workbook}}, year={2021}, publisher={Springer}, doi={10.1007/978-3-030-80519-7}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{nitzl2016mediation, author={Nitzl, Christian and Roldán, José L. and Cepeda, Gabriel}, title={{Mediation analysis in partial least squares path modeling: Helping researchers discuss more sophisticated models}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={9}, pages={1849--1864}, doi={10.1108/imds-07-2015-0302}}@misc{rademaker2026assess, author={Rademaker, Manuel E.}, title={{Postestimation: Assessing a model}}, howpublished={cSEM: Composite-based structural equation modeling (dokumentacja pakietu)}, year={2026}, url={https://floschuberth.github.io/cSEM/articles/Using-assess.html}}@misc{ray2026seminr, author={Ray, Soumya and Danks, Nicholas}, title={{SEMinR [winieta pakietu seminr]}}, howpublished={CRAN}, year={2026}, url={https://cran.r-project.org/web/packages/seminr/vignettes/SEMinR.html}}@article{schuberth2023assessing, author={Schuberth, Florian and Rademaker, Manuel E. and Henseler, Jörg}, title={{Assessing the overall fit of composite models estimated by partial least squares path modeling}}, journal={European Journal of Marketing}, year={2023}, volume={57}, number={6}, pages={1678--1702}, doi={10.1108/ejm-08-2020-0586}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}@article{zhao2010reconsidering, author={Zhao, Xinshu and Lynch, John G. and Chen, Qimei}, title={{Reconsidering Baron and Kenny: Myths and truths about mediation analysis}}, journal={Journal of Consumer Research}, year={2010}, volume={37}, number={2}, pages={197--206}, doi={10.1086/651257}}