Co to jest Confirmatory Composite Analysis (CCA)?
Konfirmacyjna analiza kompozytów (CCA, ang. confirmatory composite analysis) to technika z rodziny modeli równań strukturalnych, która sprawdza, czy dane są zgodne z modelem kompozytowym. W takim modelu konstrukty nie są czynnikami wywołującymi odpowiedzi, tylko powstają jako kombinacje liniowe wskaźników. Schuberth i in. (2018) wprowadzili CCA jako odpowiednik CFA dla takich konstruktów. Ma te same cztery etapy: specyfikację, identyfikację, estymację i ocenę dopasowania.
Konstrukty kompozytowe nazywa się też zmiennymi wyłaniającymi się (ang. emergent variables) albo artefaktami. Przykłady z psychologii i nauk o zdrowiu to styl życia złożony z higieny snu, aktywności i diety, status socjoekonomiczny złożony z wykształcenia, dochodu i zawodu czy indeks zasobów studenta. Wskaźniki nie muszą tu ze sobą korelować, a usunięcie jednego zmienia znaczenie konstruktu. Szerzej opisuje to hasło modele refleksyjne i formatywne.
Kiedy model kompozytowy, a kiedy czynnikowy?
Wybór nie zależy od programu, tylko od natury konstruktu. Zadaj trzy pytania:
- Czy wskaźniki są wymienne? Jeśli każda pozycja skali lęku jest innym przejawem tej samej cechy, wybierz model czynnikowy (CFA, konstrukt refleksyjny). Jeśli każdy wskaźnik wnosi coś innego, a razem tworzą całość, jak sen, ruch i dieta w stylu życia – kompozyt.
- Czy wskaźniki powinny korelować? W modelu czynnikowym tak, i to wyraźnie. W kompozytowym korelacje mogą być niskie, a i tak żaden wskaźnik nie jest zbędny.
- Czy konstrukt został zaprojektowany? Indeksy, programy interwencji czy narzędzia oceny złożone z części dobranych przez badacza to typowe artefakty.
Złe przypisanie ma konsekwencje. Kompozyt potraktowany jak czynnik wypadnie słabo w CFA (niskie ładunki, złe dopasowanie). Czynnik potraktowany jak kompozyt da zawyżone ładunki i obciążone ścieżki – dlatego dla konstruktów refleksyjnych w PLS stosuje się korektę PLSc.
Uwaga: dwa różne znaczenia „CCA”
W literaturze o PLS-SEM ten sam skrót oznacza dwie różne procedury:
| Cecha | CCA według Schubertha i in. (2018) | „CCA” według Haira i in. (2020) |
|---|---|---|
| Czym jest | test modelu kompozytowego, analogiczny do CFA | seria kroków oceny modelu pomiarowego w PLS-SEM |
| Konstrukty | kompozyty (zmienne wyłaniające się) | konstrukty refleksyjne i formatywne |
| Kluczowa ocena | dopasowanie całego modelu: bootstrapowy test rozbieżności (dG, dL, SRMR) | ładunki, rzetelność, AVE, HTMT, wagi, VIF |
| Wynik | model odrzucony lub nie | potwierdzenie jakości miar |
Hair i in. (2020) przedstawili „CCA” jako alternatywę dla CFA przy potwierdzaniu refleksyjnych i formatywnych modeli pomiarowych w PLS-SEM. Henseler i Schuberth (2020) odpowiedzieli, że autorzy ci pomylili CCA z etapem oceny modelu pomiarowego, i ponownie opisali procedurę w pierwotnym znaczeniu. W pracy zawsze zaznacz, o którą procedurę chodzi. Hasło dotyczy CCA w pierwotnym znaczeniu. Etapy oceny modelu pomiarowego PLS-SEM opisują hasła o AVE, HTMT i rzetelności kompozytowej.
Etapy CCA
1. Specyfikacja. Określ, które wskaźniki tworzą który kompozyt i jakie związki łączą kompozyty. W modelu kompozytowym wskaźniki z różnych bloków są powiązane wyłącznie przez swoje kompozyty. Korelacje wewnątrz bloku są natomiast dowolne. Tego ograniczenia CCA nie zakłada „na wiarę”, tylko je testuje.
2. Identyfikacja. Wagi każdego kompozytu normuje się tak, by jego wariancja wynosiła 1. Żaden kompozyt nie może być izolowany: musi być powiązany z co najmniej jednym innym kompozytem lub zmienną. Schuberth i in. (2018) podają wzór na stopnie swobody. Od liczby korelacji między wskaźnikami (bez przekątnej) odejmuje się swobodne korelacje kompozytów, korelacje wewnątrz bloków i wagi, a potem dodaje liczbę bloków. W przykładzie niżej 9 wskaźników daje 36 korelacji, a model ma 3 korelacje kompozytów, 9 korelacji wewnątrzblokowych i 9 wag, więc df = 36 − 3 − 9 − 9 + 3 = 18.
3. Estymacja. Wagi szacuje się np. uogólnioną analizą korelacji kanonicznej (MAXVAR) albo algorytmem PLS-PM z kompozytami w trybie B (zob. Model A i Model B).
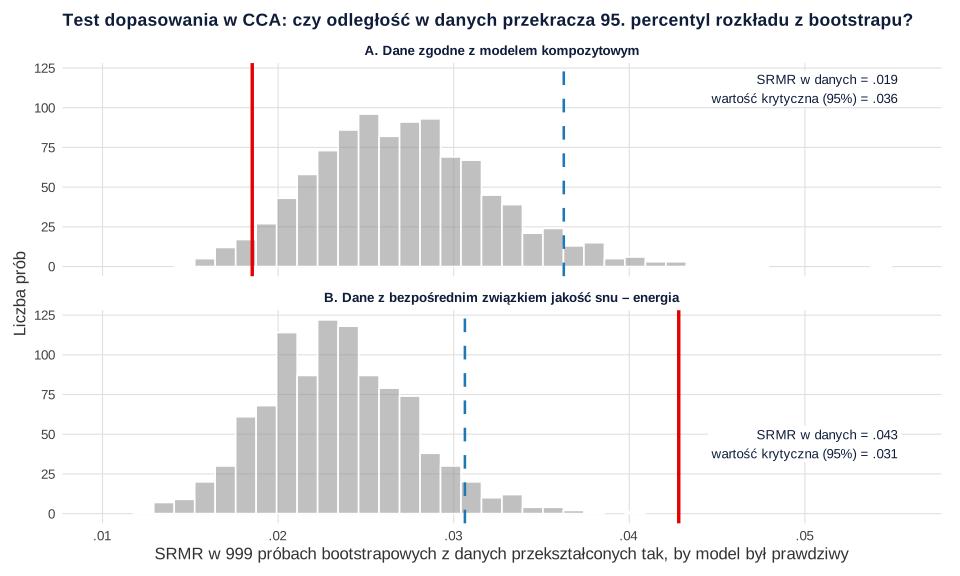
4. Ocena. Porównuje się macierz korelacji z próby z macierzą odtworzoną przez model. Rozbieżność mierzą kwadrat odległości euklidesowej dL, odległość geodezyjna dG i SRMR. O tym, czy rozbieżność jest „za duża”, rozstrzyga bootstrap: dane przekształca się tak, by model był w nich prawdziwy (procedura zaproponowana dla SEM przez Bollena i Stine’a; Bollen i Stine, 1992), losuje z nich wiele prób (w przykładzie 999) i sprawdza, czy odległość w danych przekracza 95. percentyl odległości bootstrapowych.
Przykład: trzy kompozyty stylu życia studentów
Trzystu studentów (dane symulowane) podało po trzy informacje o śnie (czas, regularność, jakość), ruchu (dni aktywności, minuty wysiłku, kroki) i samopoczuciu (energia, nastrój, koncentracja). Każdy blok tworzy kompozyt, a trzy kompozyty korelują ze sobą. Wagi oszacowane w PLS-PM wyniosły od .12 (koncentracja) do .65 (energia). Korelacje kompozytów to .24 (sen–ruch), .46 (sen–samopoczucie) i .32 (ruch–samopoczucie).
Rozbieżność modelu jest mała: SRMR = .019, dG = .007, dL = .015. Wszystkie odległości są niższe niż 95. percentyl rozkładu bootstrapowego (dla SRMR .036), a bootstrapowe p wynosi od .920 do .966. Brak więc podstaw do odrzucenia modelu kompozytowego.
Aby sprawdzić, czy test wykrywa błędy, ten sam model dopasowano do drugiego zbioru danych. W nim jakość snu wiąże się z energią także bezpośrednio, z pominięciem kompozytów. Wówczas SRMR = .043 przy wartości krytycznej .031, dG = .035 przy .019 i dL = .083 przy .042, a wszystkie bootstrapowe p < .001 (rysunek 1). Jeden pominięty związek między blokami wystarczył do odrzucenia modelu.
Jak opisać CCA w pracy (APA)
Napisz, że stosujesz CCA w rozumieniu Schubertha i in. (2018). Podaj specyfikację modelu, sposób estymacji wag, stopnie swobody, wartości dL, dG i SRMR z wartościami krytycznymi (95. percentyl) lub bootstrapowymi p oraz liczbę prób bootstrapowych. Dodaj wagi i korelacje kompozytów.
CCA w R (cSEM)
Kod buduje populacyjną macierz zgodną z modelem kompozytowym (oraz wariant z jednym dodatkowym związkiem między blokami), losuje dwa zbiory danych, szacuje wagi i korelacje kompozytów w cSEM, liczy SRMR, dG i dL oraz przeprowadza bootstrapowy test dopasowania testOMF(). cSEM opisuje go jako test Berana i Srivastavy (1985) – to ta sama idea przekształcenia danych, którą w SEM spopularyzowali Bollen i Stine. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Test modelu kompozytowego dla danych zgodnych i niezgodnych z modelem
R
suppressPackageStartupMessages(library(cSEM))

# Dane symulowane: 300 studentów. Trzy zmienne wyłaniające się (kompozyty), każda tworzona przez 3 wskaźniki:
# SEN (czas snu, regularność, jakość), RUCH (dni aktywności, minuty wysiłku, kroki)
# i SAMOPOCZUCIE (energia, nastrój, koncentracja). W modelu kompozytowym wskaźniki z różnych bloków
# są powiązane wyłącznie przez kompozyty.
set.seed(105)
blok <- function(r12, r13, r23) matrix(c(1, r12, r13, r12, 1, r23, r13, r23, 1), 3)
S_bl <- list(SEN = blok(.40, .35, .45), RUCH = blok(.50, .30, .40), SAMO = blok(.45, .40, .35))
W <- list(SEN = c(.50, .30, .40), RUCH = c(.40, .45, .30), SAMO = c(.45, .35, .40))
for (k in names(W)) W[[k]] <- W[[k]] / sqrt(drop(t(W[[k]]) %*% S_bl[[k]] %*% W[[k]]))   # wariancja kompozytu = 1
rho <- matrix(c(1, .30, .45, .30, 1, .35, .45, .35, 1), 3, dimnames = list(names(W), names(W)))
Sigma <- matrix(0, 9, 9); idx <- list(SEN = 1:3, RUCH = 4:6, SAMO = 7:9)
for (i in names(W)) for (j in names(W)) {
  Sigma[idx[[i]], idx[[j]]] <- if (i == j) S_bl[[i]] else rho[i, j] * (S_bl[[i]] %*% W[[i]]) %*% t(S_bl[[j]] %*% W[[j]])
}
nazwy <- c("sen_czas", "sen_regularnosc", "sen_jakosc", "ruch_dni", "ruch_minuty", "ruch_kroki",
           "samo_energia", "samo_nastroj", "samo_koncentracja")
dimnames(Sigma) <- list(nazwy, nazwy)
# Wariant z błędem: jakość snu wiąże się z energią także bezpośrednio, poza kompozytami
Sigma_bl <- Sigma; Sigma_bl["sen_jakosc", "samo_energia"] <- Sigma_bl["samo_energia", "sen_jakosc"] <- Sigma["sen_jakosc", "samo_energia"] + .30
c(min_wart_wlasna = min(eigen(Sigma_bl)$values))
dane    <- as.data.frame(MASS::mvrnorm(300, rep(0, 9), Sigma))
dane_bl <- as.data.frame(MASS::mvrnorm(300, rep(0, 9), Sigma_bl))

model <- '
  SEN  <~ sen_czas + sen_regularnosc + sen_jakosc
  RUCH <~ ruch_dni + ruch_minuty + ruch_kroki
  SAMO <~ samo_energia + samo_nastroj + samo_koncentracja
  SEN ~~ RUCH
  SEN ~~ SAMO
  RUCH ~~ SAMO
'
# 1. Estymacja wag (PLS-PM, kompozyty w trybie B, schemat wewnętrzny „factorial”) i dopuszczalność rozwiązania
cca <- csem(dane, model, .approach_weights = "PLS-PM", .PLS_weight_scheme_inner = "factorial")
verify(cca)
round(cca$Estimates$Weight_estimates[cca$Estimates$Weight_estimates != 0], 3)
round(cca$Estimates$Construct_VCV, 3)

# 2. Dopasowanie modelu kompozytowego: SRMR, dG (odległość geodezyjna) i dL (kwadrat odległości euklidesowej)
round(unlist(assess(cca, .quality_criterion = c("srmr", "dg", "dl"))[c("SRMR", "DG", "DL")]), 4)

# 3. Test dopasowania z bootstrapem (procedura Bollena–Stine'a, 999 prób)
test_ok <- testOMF(cca, .R = 999, .seed = 2105)
test_ok

# 4. Ten sam model dla danych z bezpośrednim związkiem jakość snu – energia
cca_bl <- csem(dane_bl, model, .approach_weights = "PLS-PM", .PLS_weight_scheme_inner = "factorial")
test_bl <- testOMF(cca_bl, .R = 999, .seed = 3105)
test_bl

# 5. Wartości p z bootstrapu: odsetek prób, w których odległość była co najmniej taka jak w danych
p_boot <- function(t) {
  b <- do.call(rbind, t$Information$Bootstrap_values)
  sapply(names(t$Test_statistic), function(m) mean(b[, m] >= t$Test_statistic[[m]]))
}
round(rbind(model_poprawny = p_boot(test_ok), model_z_bledem = p_boot(test_bl)), 3)
Wynik w R
min_wart_wlasna
      0.3257246
________________________________________________________________________________

Verify admissibility:

	 admissible

Details:

  Code   Status    Description
  1      ok        Convergence achieved
  2      ok        All absolute standardized loading estimates <= 1
  3      ok        Construct VCV is positive semi-definite
  4      ok        All reliability estimates <= 1
  5      ok        Model-implied indicator VCV is positive semi-definite
________________________________________________________________________________
[1] 0.627 0.364 0.360 0.553 0.363 0.415 0.645 0.452 0.116
       SEN  RUCH  SAMO
SEN  1.000 0.236 0.464
RUCH 0.236 1.000 0.317
SAMO 0.464 0.317 1.000
  SRMR     DG     DL
0.0185 0.0066 0.0154
________________________________________________________________________________
--------- Test for overall model fit based on Beran & Srivastava (1985) --------

Null hypothesis:

       ┌──────────────────────────────────────────────────────────────────┐
       │                                                                  │
       │   H0: The model-implied indicator covariance matrix equals the   │
       │   population indicator covariance matrix.                        │
       │                                                                  │
       └──────────────────────────────────────────────────────────────────┘

Test statistic and critical value:

	                                  	Critical value
	Distance measure    Test statistic	  95%
	dG                      0.0066    	0.0198
	SRMR                    0.0185    	0.0363
	dL                      0.0154    	0.0592
	dML                     0.0348    	0.1032


Decision:

	                    	Significance level
	Distance measure    	     95%
	dG                  	Do not reject
	SRMR                	Do not reject
	dL                  	Do not reject
	dML                 	Do not reject

Additional information:

	Out of 999 bootstrap replications 999 are admissible.
	See ?verify() for what constitutes an inadmissible result.

	The seed used was: 2105
________________________________________________________________________________
________________________________________________________________________________
--------- Test for overall model fit based on Beran & Srivastava (1985) --------

Null hypothesis:

       ┌──────────────────────────────────────────────────────────────────┐
       │                                                                  │
       │   H0: The model-implied indicator covariance matrix equals the   │
       │   population indicator covariance matrix.                        │
       │                                                                  │
       └──────────────────────────────────────────────────────────────────┘

Test statistic and critical value:

	                                  	Critical value
	Distance measure    Test statistic	  95%
	dG                      0.0346    	0.0186
	SRMR                    0.0428    	0.0306
	dL                      0.0825    	0.0422
	dML                     0.1778    	0.0974


Decision:

	                    	Significance level
	Distance measure    	  95%
	dG                  	reject
	SRMR                	reject
	dL                  	reject
	dML                 	reject

Additional information:

	Out of 999 bootstrap replications 999 are admissible.
	See ?verify() for what constitutes an inadmissible result.

	The seed used was: 3105
________________________________________________________________________________
                 dG  SRMR    dL   dML
model_poprawny 0.92 0.966 0.966 0.923
model_z_bledem 0.00 0.000 0.000 0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cSEM (wersja 0.6.1): Rademaker, M. E., & Schuberth, F. (2020). cSEM: Composite-based structural equation modeling [R package]. https://floschuberth.github.io/cSEM/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie CCA oceny modelu pomiarowego w PLS-SEM bez zaznaczenia, że chodzi o procedurę Haira i in. (2020), a nie o test modelu kompozytowego.
- Ocena dopasowania bez testu. Sam SRMR poniżej .08 nie zastępuje porównania z rozkładem bootstrapowym.
- Kompozyt izolowany w modelu. Kompozyt bez związków z innymi konstruktami nie jest identyfikowany.
- Traktowanie konstruktów refleksyjnych jako kompozytów (lub odwrotnie) bez uzasadnienia teoretycznego.
- Interpretacja wag jak ładunków. Waga mówi o udziale wskaźnika w kompozycie przy kontroli pozostałych, więc niska waga (jak .12 dla koncentracji) nie oznacza „złego” wskaźnika.
Przy porównaniu grup potrzebna jest inwariancja kompozytów – zob. MICOM. Tło opisują wpisy model refleksyjny czy formatywny i PLS-SEM w R: seminr i cSEM.
Najczęstsze pytania
Czym różni się CCA od CFA?
CFA zakłada, że wspólny czynnik powoduje odpowiedzi na wskaźniki, więc korelacje między wskaźnikami wynikają z czynnika. CCA zakłada, że konstrukt powstaje z wskaźników jako ich ważona suma, a korelacje wewnątrz bloku są dowolne. Etapy (specyfikacja, identyfikacja, estymacja, ocena) są w obu metodach te same.
Czy CCA to to samo co ocena modelu pomiarowego w PLS-SEM?
Nie zawsze. W pierwotnym znaczeniu (Schuberth i in., 2018) CCA to test dopasowania modelu kompozytowego. Hair i in. (2020) nazwali tak serię kroków oceny ładunków, rzetelności i trafności w PLS-SEM, co Henseler i Schuberth (2020) uznali za pomylenie pojęć. W pracy napisz, której procedury użyłeś.
Jak interpretować dG, dL i SRMR w teście CCA?
To miary rozbieżności między macierzą korelacji z próby a macierzą odtworzoną przez model; 0 oznacza dopasowanie idealne. Model odrzuca się, gdy wartość w danych przekracza 95. percentyl rozkładu z bootstrapu (wartość krytyczną), czyli gdy bootstrapowe p < .05.
W jakim programie wykonać CCA?
W R służy do tego pakiet cSEM: funkcja csem() szacuje model z kompozytami (<~), assess() liczy SRMR, dG i dL, a testOMF() wykonuje bootstrapowy test dopasowania. Pakiet cSEM wspiera też analizy pokrewne, np. MICOM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model refleksyjny czy formatywny? Jak poprawnie określić konstrukt
Kierunek pomiaru zmienia znaczenie modelu, diagnostykę i interpretację. Zobacz kryteria wyboru modelu refleksyjnego, formatywnego i kompozytowego.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →PoradnikPLS-SEM czy CB-SEM? Porównanie metod i praktyczna decyzja
Neutralne porównanie PLS-SEM i CB-SEM: cel, rodzaj konstruktu, estymacja, dopasowanie, predykcja, próba i raportowanie bez popularnych mitów.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Stine, R. A. (1992). Bootstrapping goodness-of-fit measures in structural equation models. Sociological Methods & Research, 21(2), 205–229. https://doi.org/10.1177/0049124192021002004
- Hair, J. F., Howard, M. C., & Nitzl, C. (2020). Assessing measurement model quality in PLS-SEM using confirmatory composite analysis. Journal of Business Research, 109, 101–110. https://doi.org/10.1016/j.jbusres.2019.11.069
- Henseler, J., & Schuberth, F. (2020). Using confirmatory composite analysis to assess emergent variables in business research. Journal of Business Research, 120, 147–156. https://doi.org/10.1016/j.jbusres.2020.07.026 ● Otwarty dostęp
- Schuberth, F., Henseler, J., & Dijkstra, T. K. (2018). Confirmatory composite analysis. Frontiers in Psychology, 9, Article 2541. https://doi.org/10.3389/fpsyg.2018.02541 ● Otwarty dostęp
Cytowania BibTeX
@article{bollen1992bootstrapping, author={Bollen, Kenneth A. and Stine, Robert A.}, title={{Bootstrapping goodness-of-fit measures in structural equation models}}, journal={Sociological Methods \& Research}, year={1992}, volume={21}, number={2}, pages={205--229}, doi={10.1177/0049124192021002004}}@article{hair2020assessing, author={Hair, Joe F. and Howard, Matt C. and Nitzl, Christian}, title={{Assessing measurement model quality in PLS-SEM using confirmatory composite analysis}}, journal={Journal of Business Research}, year={2020}, volume={109}, pages={101--110}, doi={10.1016/j.jbusres.2019.11.069}}@article{henseler2020using, author={Henseler, Jörg and Schuberth, Florian}, title={{Using confirmatory composite analysis to assess emergent variables in business research}}, journal={Journal of Business Research}, year={2020}, volume={120}, pages={147--156}, doi={10.1016/j.jbusres.2020.07.026}}@article{schuberth2018confirmatory, author={Schuberth, Florian and Henseler, Jörg and Dijkstra, Theo K.}, title={{Confirmatory composite analysis}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={2541}, doi={10.3389/fpsyg.2018.02541}}