Co to są dULS i dG?
dULS i dG to dwie miary globalnego dopasowania modelu w PLS-SEM. Obie mierzą odległość między macierzą korelacji wskaźników z próby (S) a macierzą odtworzoną przez model (Σ̂). Nazwy pochodzą od sposobu liczenia odległości. dULS (ang. unweighted least squares discrepancy) to kwadrat odległości euklidesowej, taki jak w nieważonej metodzie najmniejszych kwadratów. dG (ang. geodesic discrepancy) to odległość geodezyjna, oparta na wartościach własnych.
Klasyczny PLS długo nie miał testu dopasowania podobnego do χ² w CB-SEM. Dijkstra i Henseler (2015) pokazali, że w zgodnej wersji PLS można ocenić globalne dopasowanie modelu. Henseler i in. (2016) opisują testy dokładnego dopasowania jako warunek konfirmacyjnego użycia PLS. Schuberth i in. (2023) podkreślają, że ocena dopasowania jest dla modeli kompozytowych tak samo ważna jak dla czynnikowych. Pokazują też, że można ją przeprowadzić testem statystycznym i wskaźnikami znanymi z SEM. Ma to znaczenie, bo – jak argumentują Henseler i in. (2014) – PLS jest właściwym estymatorem modeli kompozytowych, więc warto sprawdzać, czy model kompozytowy rzeczywiście pasuje do danych.
Wzory
W macierzy korelacji przekątna jest zgodna z definicji, więc dULS to po prostu suma kwadratów reszt korelacyjnych w dolnym trójkącie macierzy. Stąd prosty związek z SRMR, który jest pierwiastkiem ze średniej tych samych kwadratów: SRMR = √(dULS / [p(p + 1)/2]). dULS rośnie więc z liczbą wskaźników. Te same przeciętne reszty dają w modelu z 20 wskaźnikami kilka razy większe dULS niż w modelu z 9.
dG porównuje macierze „w proporcjach”, przez wartości własne S−1Σ̂. Gdy model jest idealny, wszystkie φk = 1, a ln φk = 0. Jest pokrewna rozbieżności największej wiarygodności (FML), która też zależy od tych wartości własnych. Obie miary ważą więc rozbieżności inaczej: dULS sumuje surowe kwadraty reszt, a dG mierzy rozbieżność w metryce wartości własnych. Mogą zatem prowadzić do różnych decyzji.
Jak się ocenia dULS i dG: test bootstrapowy
Obie miary nie mają znanego rozkładu ani uniwersalnych progów, więc ocenia się je testem bootstrapowym:
- Dane przekształca się tak, aby ich macierz korelacji była dokładnie równa Σ̂, czyli aby model był prawdziwy (transformacja Bollena–Stine’a albo Berana–Srivastavy).
- Z przekształconych danych losuje się kilkaset lub kilka tysięcy prób bootstrapowych. W każdej szacuje się model i liczy dULS i dG.
- Z uzyskanego rozkładu odczytuje się kwantyle 95% (HI95) i 99% (HI99).
- Jeśli wartość z próby przekracza HI95, odrzucamy hipotezę, że model jest prawdziwy (α = .05).
To test dokładnego dopasowania, podobnie jak χ² w CB-SEM. W bardzo dużych próbach wykryje więc nawet drobne rozbieżności. Wynik nieistotny nie dowodzi poprawności modelu, a tylko świadczy o braku dowodów przeciw niemu.
Przykład: model z brakującą ścieżką
Dwustu pięćdziesięciu studentów (dane symulowane) wypełniło po trzy pozycje mierzące motywację, zaangażowanie i satysfakcję ze studiów. W populacji motywacja wpływa na satysfakcję i bezpośrednio, i przez zaangażowanie. Model A pomija efekt bezpośredni, a model B go zawiera. Oba oszacowano w pakiecie cSEM. Konstrukty refleksyjne szacowano metodą PLSc, a test oparto na 499 próbach bootstrapowych.
| Miara | Model A | HI95 / HI99 (A) | Model B | HI95 / HI99 (B) |
|---|---|---|---|---|
| dULS | 0.344 | 0.131 / 0.225 | 0.034 | 0.061 / 0.081 |
| dG (cSEM, log10) | 0.063 | 0.119 / 0.156 | 0.029 | 0.087 / 0.111 |
| SRMR | .087 | .054 / .071 | .028 | .037 / .042 |
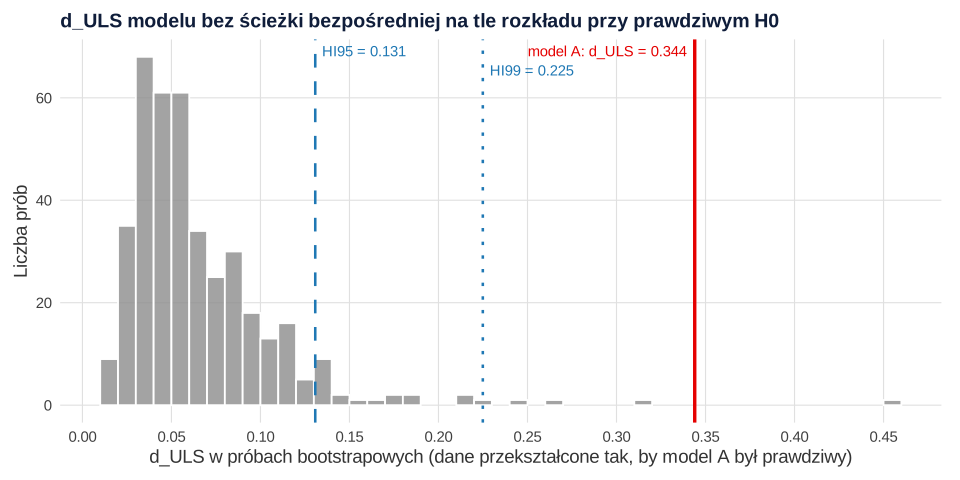
Model B mieści się poniżej HI95 we wszystkich miarach. W modelu A dULS = 0.344 przekracza nawet HI99, więc model odrzucamy. Rysunek 1 pokazuje, że tylko 1 z 399 dopuszczalnych prób bootstrapowych (0.25%) miała dULS co najmniej tak duże. dG modelu A (0.063) nie przekracza natomiast HI95. Bez ścieżki bezpośredniej model odtwarza korelacje między pozycjami motywacji i satysfakcji jako zbyt słabe. Te reszty, podniesione do kwadratu i zsumowane, wyraźnie podnoszą dULS, a w metryce dG okazały się za małe, by przekroczyć kwantyl. Dlatego w pracy podaje się obie miary, a model uznaje się za pasujący tylko wtedy, gdy żadna nie przekracza kwantyla. Związek z SRMR łatwo sprawdzić: √(0.3439/45) = .087.
Uwaga na wersje dG. cSEM liczy dG z logarytmem dziesiętnym (0.0634), a ze wzoru z logarytmem naturalnym ta sama odległość wynosi 0.3363. Decyzja testu się nie zmienia, bo kwantyle liczone są tą samą formułą. Nie porównuj jednak wartości dG z różnych programów ani z wartościami z artykułów bez sprawdzenia definicji. Podobnie programy podają czasem dopasowanie modelu „nasyconego” (tylko część pomiarowa) i „oszacowanego” (z modelem strukturalnym). W pracy napisz, której wersji dotyczy wynik.
Jak opisać dULS i dG w pracy (APA)
Podaj program, metodę estymacji, liczbę prób bootstrapowych, wartości dULS, dG i SRMR oraz odpowiadające im kwantyle HI95 (lub HI99). Dodaj decyzję: przekracza albo nie przekracza.
dULS i dG w R (cSEM)
Kod tworzy dane z przykładu, szacuje oba modele i wypisuje dG, dULS i SRMR. Liczy też obie odległości „ręcznie” z macierzy S i Σ̂ (z logarytmem naturalnym i dziesiętnym) i przeprowadza test bootstrapowy z kwantylami 95% i 99%. W wyniku testu dULS ma oznaczenie dL, a dML to odległość oparta na funkcji ML. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Odległości dULS i dG z testem bootstrapowym
R
suppressPackageStartupMessages({library(cSEM); library(lavaan)})   # PLS (PLSc) i symulacja danych

# Dane symulowane: 250 studentów; motywacja (m1–m3), zaangażowanie (z1–z3) i satysfakcja (s1–s3).
# W populacji motywacja wpływa na satysfakcję także bezpośrednio (0.30) – model A tej ścieżki nie ma.
set.seed(5)
populacja <- '
  M =~ 0.80*m1 + 0.75*m2 + 0.70*m3
  Z =~ 0.80*z1 + 0.75*z2 + 0.75*z3
  S =~ 0.80*s1 + 0.70*s2 + 0.75*s3
  Z ~ 0.50*M
  S ~ 0.40*Z + 0.30*M'
dane <- simulateData(populacja, sample.nobs = 250, standardized = TRUE)

model_A <- 'M =~ m1 + m2 + m3
            Z =~ z1 + z2 + z3
            S =~ s1 + s2 + s3
            Z ~ M
            S ~ Z'                         # mediacja całkowita
model_B <- paste(model_A, '\n S ~ M')      # + ścieżka bezpośrednia
fit_A <- csem(dane, model_A)               # konstrukty refleksyjne: PLSc (domyślnie)
fit_B <- csem(dane, model_B)

# 1. Odległości d_G, d_ULS (w cSEM: dL) i SRMR obu modeli
miary <- function(f) unlist(assess(f, .quality_criterion = c("dg", "dl", "srmr"))[c("DG", "DL", "SRMR")])
round(rbind(model_A = miary(fit_A), model_B = miary(fit_B)), 4)

# 2. d_ULS i d_G „ręcznie” dla modelu A
S     <- fit_A$Estimates$Indicator_VCV          # macierz korelacji z próby
Sigma <- cSEM::fit(fit_A)                       # macierz odtworzona przez model
d_uls <- 0.5 * sum((S - Sigma)^2)               # = suma kwadratów różnic poza przekątną (i < j)
phi   <- eigen(solve(S) %*% Sigma, only.values = TRUE)$values
round(c(d_ULS = d_uls, liczba_par = sum(lower.tri(S)),
        d_G_ln = 0.5 * sum(log(Re(phi))^2),          # definicja z logarytmem naturalnym
        d_G_log10 = 0.5 * sum(log10(Re(phi))^2)),    # tak liczy cSEM
      4)

# 3. Test dokładnego dopasowania (bootstrap Beran–Srivastava, 499 prób) – kwantyle HI95 i HI99
test_A <- testOMF(fit_A, .R = 499, .alpha = c(0.05, 0.01), .seed = 146)
test_A
test_B <- testOMF(fit_B, .R = 499, .alpha = c(0.05, 0.01), .seed = 146)
test_B
Wynik w R
            DG     DL   SRMR
model_A 0.0634 0.3439 0.0874
model_B 0.0291 0.0339 0.0275
     d_ULS liczba_par     d_G_ln  d_G_log10
    0.3439    36.0000     0.3363     0.0634
________________________________________________________________________________
--------- Test for overall model fit based on Beran & Srivastava (1985) --------

Null hypothesis:

       ┌──────────────────────────────────────────────────────────────────┐
       │                                                                  │
       │   H0: The model-implied indicator covariance matrix equals the   │
       │   population indicator covariance matrix.                        │
       │                                                                  │
       └──────────────────────────────────────────────────────────────────┘

Test statistic and critical value:

	                                  	 Critical value
	Distance measure    Test statistic	  99% 	  95%
	dG                      0.0634    	0.1562	0.1191
	SRMR                    0.0874    	0.0707	0.0539
	dL                      0.3439    	0.2249	0.1308
	dML                     0.3408    	0.9519	0.6746


Decision:

	                    	      Significance level
	Distance measure    	     99%     	     95%
	dG                  	Do not reject	Do not reject
	SRMR                	    reject   	    reject
	dL                  	    reject   	    reject
	dML                 	Do not reject	Do not reject

Additional information:

	Out of 499 bootstrap replications 399 are admissible.
	See ?verify() for what constitutes an inadmissible result.

	The seed used was: 146
________________________________________________________________________________
________________________________________________________________________________
--------- Test for overall model fit based on Beran & Srivastava (1985) --------

Null hypothesis:

       ┌──────────────────────────────────────────────────────────────────┐
       │                                                                  │
       │   H0: The model-implied indicator covariance matrix equals the   │
       │   population indicator covariance matrix.                        │
       │                                                                  │
       └──────────────────────────────────────────────────────────────────┘

Test statistic and critical value:

	                                  	 Critical value
	Distance measure    Test statistic	  99% 	  95%
	dG                      0.0291    	0.1114	0.0867
	SRMR                    0.0275    	0.0423	0.0367
	dL                      0.0339    	0.0806	0.0607
	dML                     0.1536    	0.6270	0.4640


Decision:

	                    	      Significance level
	Distance measure    	     99%     	     95%
	dG                  	Do not reject	Do not reject
	SRMR                	Do not reject	Do not reject
	dL                  	Do not reject	Do not reject
	dML                 	Do not reject	Do not reject

Additional information:

	Out of 499 bootstrap replications 438 are admissible.
	See ?verify() for what constitutes an inadmissible result.

	The seed used was: 146
________________________________________________________________________________
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cSEM (wersja 0.6.1): Rademaker, M. E., & Schuberth, F. (2020). cSEM: Composite-based structural equation modeling [R package]. https://floschuberth.github.io/cSEM/
- lavaan (wersja 0.7.2, symulacja danych): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Stosowanie stałych progów (np. „dULS < 0.5”). dULS rośnie z liczbą wskaźników, a dG zależy od definicji w programie. Rozstrzyga porównanie z kwantylem bootstrapowym.
- Podawanie samej wartości bez HI95/HI99. Bez kwantyla czytelnik nie wie, czy model odrzucono.
- Raportowanie tylko tej miary, która „wyszła”. Gdy dULS przekracza kwantyl, a dG nie, model nie pasuje dokładnie. Opisz obie.
- Brak informacji o liczbie dopuszczalnych prób. W przykładzie dopuszczalnych było 399 z 499 prób dla modelu A. Duży odsetek prób odrzuconych jako niedopuszczalne warto opisać.
- Traktowanie dopasowania jako dowodu trafności modelu. Także modele z inną strukturą przyczynową mogą odtwarzać dane równie dobrze. Wybór modelu musi wynikać z teorii (zob. modele refleksyjne i formatywne, konfirmacyjna analiza kompozytów).
Miejsce testu dopasowania w całej ocenie modelu pokazuje poradnik PLS-SEM krok po kroku. Kod z cSEM i seminr znajdziesz w PLS-SEM w R, a różnice w podejściu do dopasowania w obu nurtach SEM – w PLS-SEM czy CB-SEM.
Najczęstsze pytania
Jakie wartości d_ULS i d_G są dobre?
Nie ma uniwersalnych progów: dULS rośnie z liczbą wskaźników, a wartość dG zależy od definicji w programie. Model uznaje się za pasujący, gdy obie wartości są niższe od kwantyla HI95 (ostrożniej: HI99) rozkładu bootstrapowego, który program wylicza przy założeniu, że model jest prawdziwy.
Co oznaczają HI95 i HI99 w PLS-SEM?
To 95. i 99. percentyl rozkładu dULS, dG lub SRMR w próbach bootstrapowych z danych przekształconych tak, by model był dokładnie prawdziwy. Wartość z próby powyżej HI95 oznacza odrzucenie hipotezy o dokładnym dopasowaniu na poziomie α = .05, a powyżej HI99 – na poziomie α = .01.
Jaki jest związek d_ULS z SRMR?
Dla macierzy korelacji dULS to suma kwadratów reszt w dolnym trójkącie macierzy, a SRMR – pierwiastek ze średniej tych samych kwadratów: SRMR = √(dULS / [p(p + 1)/2]). SRMR jest więc „uśrednionym” dULS, łatwiejszym do porównywania między modelami różnej wielkości.
Dlaczego d_G w cSEM różni się od wartości z artykułu?
Programy mogą liczyć dG z różną podstawą logarytmu: cSEM używa logarytmu dziesiętnego, a wzór Dijkstry i Henselera – naturalnego, co zmienia wartość mniej więcej pięciokrotnie. Decyzja testu się nie zmienia, ale samych liczb z różnych programów nie porównuj.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →PoradnikPLS-SEM czy CB-SEM? Porównanie metod i praktyczna decyzja
Neutralne porównanie PLS-SEM i CB-SEM: cel, rodzaj konstruktu, estymacja, dopasowanie, predykcja, próba i raportowanie bez popularnych mitów.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dijkstra, T. K., & Henseler, J. (2015). Consistent and asymptotically normal PLS estimators for linear structural equations. Computational Statistics & Data Analysis, 81, 10–23. https://doi.org/10.1016/j.csda.2014.07.008 ● Otwarty dostęp
- Henseler, J., Dijkstra, T. K., Sarstedt, M., Ringle, C. M., Diamantopoulos, A., Straub, D. W., Ketchen, D. J., Hair, J. F., Hult, G. T. M., & Calantone, R. J. (2014). Common beliefs and reality about PLS: Comments on Rönkkö and Evermann (2013). Organizational Research Methods, 17(2), 182–209. https://doi.org/10.1177/1094428114526928 ● Otwarty dostęp
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: Updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Schuberth, F., Rademaker, M. E., & Henseler, J. (2023). Assessing the overall fit of composite models estimated by partial least squares path modeling. European Journal of Marketing, 57(6), 1678–1702. https://doi.org/10.1108/ejm-08-2020-0586 ● Otwarty dostęp
Cytowania BibTeX
@article{dijkstra2015asymptotically, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent and asymptotically normal PLS estimators for linear structural equations}}, journal={Computational Statistics \& Data Analysis}, year={2015}, volume={81}, pages={10--23}, doi={10.1016/j.csda.2014.07.008}}@article{henseler2014common, author={Henseler, Jörg and Dijkstra, Theo K. and Sarstedt, Marko and Ringle, Christian M. and Diamantopoulos, Adamantios and Straub, Detmar W. and Ketchen, David J. and Hair, Joseph F. and Hult, G. Tomas M. and Calantone, Roger J.}, title={{Common beliefs and reality about PLS: Comments on Rönkkö and Evermann (2013)}}, journal={Organizational Research Methods}, year={2014}, volume={17}, number={2}, pages={182--209}, doi={10.1177/1094428114526928}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: Updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{schuberth2023assessing, author={Schuberth, Florian and Rademaker, Manuel E. and Henseler, Jörg}, title={{Assessing the overall fit of composite models estimated by partial least squares path modeling}}, journal={European Journal of Marketing}, year={2023}, volume={57}, number={6}, pages={1678--1702}, doi={10.1108/ejm-08-2020-0586}}