Co to jest macierz ładunków i ładunków krzyżowych?
Macierz ładunków i ładunków krzyżowych (ang. loadings and cross-loadings matrix) to tabela, w której wiersze są wskaźnikami (pozycjami kwestionariusza), a kolumny – konstruktami modelu. W każdej komórce stoi siła związku wskaźnika z danym konstruktem. Na przecięciu wskaźnika z „jego” konstruktem jest ładunek własny, a w pozostałych kolumnach – ładunki krzyżowe. Macierz pokazuje, czy każda pozycja wiąże się najsilniej z tym, co ma mierzyć, i czy nie jest równie blisko innego konstruktu.
Termin występuje w dwóch tradycjach i w każdej znaczy coś nieco innego:
- PLS-SEM: ładunek to korelacja wskaźnika z wynikiem kompozytu (ładunek zewnętrzny), a ładunek krzyżowy – korelacja tego samego wskaźnika z wynikami pozostałych kompozytów. Macierz liczy się po oszacowaniu modelu i służy do oceny trafności różnicowej.
- Analiza czynnikowa: w EFA z rotacją ukośną macierz wzorca zawiera współczynniki regresji pozycji na czynniki, a macierz struktury – korelacje pozycji z czynnikami. Ładunek krzyżowy to tu ładunek pozycji na czynniku, do którego nie została przypisana (zob. ładunek czynnikowy). W CFA ładunki krzyżowe są zwykle ustalone na zero, więc ich obecność ujawnia się dopiero w resztach i indeksach modyfikacji.
Dalej skupiamy się na PLS-SEM, bo tam macierz ładunków krzyżowych jest rutynowym elementem raportu.
Jak ocenia się macierz w PLS-SEM
Klasyczna reguła mówi, że ładunek własny każdego wskaźnika powinien być wyższy niż wszystkie jego ładunki krzyżowe. Druga popularna reguła, kryterium Fornella–Larckera, porównuje pierwiastek z AVE konstruktu z jego korelacjami z innymi konstruktami. Fornell i Larcker (1981) zaproponowali ocenę modelu opartą na wariancji wspólnej w części pomiarowej i strukturalnej.
Obie reguły mają poważną wadę. Henseler i in. (2015) pokazali w symulacjach, że ani porównanie ładunków krzyżowych, ani kryterium Fornella–Larckera nie wykrywają wiarygodnie braku trafności różnicowej w typowych sytuacjach badawczych. W zamian zaproponowali wskaźnik HTMT. Hair i in. (2019) zebrali aktualne kryteria i reguły kciuka oceny modelu pomiarowego w PLS-SEM – ładunki krzyżowe nie są wśród nich jedynym ani głównym sprawdzianem. Rönkkö i Cho (2022) idą dalej i zalecają ocenę korelacji konstruktów z przedziałem ufności, a nie tylko porównywanie liczb z progiem.
Macierz ładunków krzyżowych nie jest więc testem trafności różnicowej, lecz narzędziem diagnozy pojedynczych pozycji. Pokazuje, która pozycja „ciągnie” w stronę innego konstruktu. Powód słabości reguły „własny ładunek najwyższy” jest prosty: w PLS wynik kompozytu zawiera sam wskaźnik, więc korelacja wskaźnika z własnym kompozytem jest częściowo korelacją części z całością. Ma przez to wbudowaną przewagę nad ładunkami krzyżowymi.
Przykład: pozycja, która należy do dwóch konstruktów
Trzystu studentów pierwszego roku (dane symulowane) odpowiedziało na pozycje mierzące wsparcie rówieśników (WR1–WR4), poczucie przynależności do grupy (PP1–PP4) i satysfakcję ze studiów (SS1–SS3), na skali 1–7. Pozycja PP4 brzmi: „Mam na roku osoby, na które mogę liczyć”. Treściowo opisuje ona bardziej wsparcie niż przynależność. W populacji, z której pochodzą dane, PP4 ma nawet nieco silniejszy związek ze wsparciem (.45) niż z przynależnością (.40). Model PLS przypisał ją jednak do przynależności.
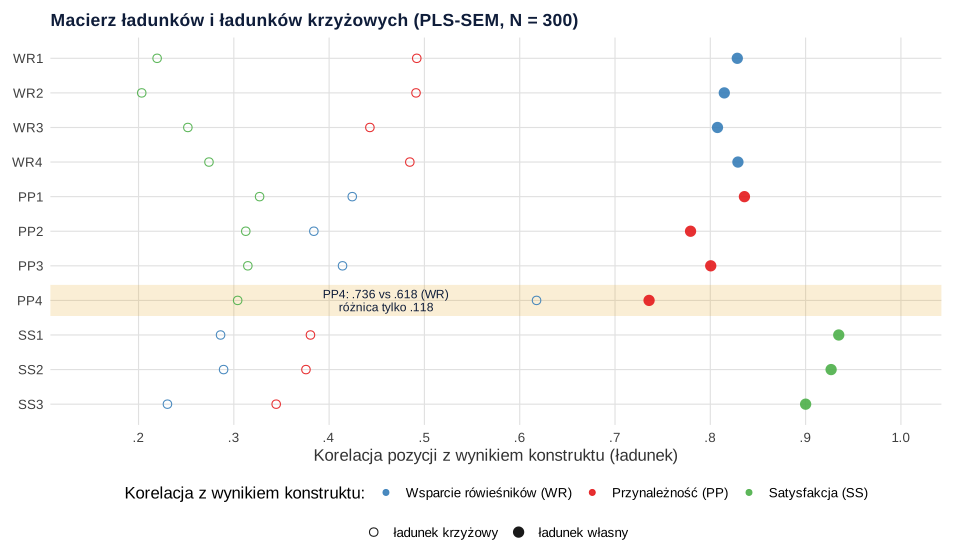
Wszystkie standardowe kryteria wypadają „poprawnie”:
- każda pozycja ma najwyższy ładunek na własnym konstrukcie; dla PP4 to .736 wobec .618 na wsparciu;
- pierwiastek z AVE przynależności (.789) przekracza jej korelację ze wsparciem (.581), więc kryterium Fornella–Larckera jest spełnione;
- HTMT dla pary wsparcie–przynależność wynosi .716, z bootstrapowym 95% CI [.627, .799], czyli poniżej progu .85.
Mimo to PP4 jest problematyczna. U pozostałych pozycji różnica między ładunkiem własnym a najwyższym krzyżowym wynosi od .32 do .56, a u PP4 tylko .118. Po usunięciu PP4 HTMT spada do .604. Zmienia się też wynik części strukturalnej: ścieżka od wsparcia do satysfakcji rośnie z .092 do .140, a od przynależności maleje z .345 do .313. Pozycja z wyraźnym ładunkiem krzyżowym przenosi część wariancji wsparcia do kompozytu przynależności i zniekształca porównanie predyktorów.
Jak czytać macierz w praktyce
- Policz różnicę dla każdej pozycji: ładunek własny minus najwyższy ładunek krzyżowy. Pozycje z najmniejszą różnicą sprawdź jako pierwsze, nawet jeśli spełniają regułę „własny najwyższy”.
- Przeczytaj treść pozycji. Mała różnica jest sygnałem, a decyzję podejmuje się na podstawie treści: czy pozycja nie opisuje innego konstruktu, nie jest dwuznaczna albo nie łączy dwóch treści naraz.
- Zestaw macierz z HTMT i jego przedziałem ufności. HTMT ocenia parę konstruktów, a macierz wskazuje, która pozycja odpowiada za ich podobieństwo.
- Sprawdź znaki. Ujemny ładunek własny zwykle oznacza nieprzekodowaną pozycję odwróconą.
- Przy kompozytach formatywnych (Mode B) oceniaj przede wszystkim wagi zewnętrzne i współliniowość. Ładunki krzyżowe mają tam mniejsze znaczenie (zob. Mode A i Mode B).
Co zrobić z pozycją o wysokim ładunku krzyżowym
Wykrycie pozycji niejednoznacznej to dopiero początek. Dalsze postępowanie zależy od celu badania i od tego, czy skala jest już opublikowanym narzędziem, czy dopiero powstaje.
| Decyzja | Kiedy ma sens | O czym pamiętać |
|---|---|---|
| Pozostawienie pozycji | Skala standardowa, której nie wolno zmieniać; różnica ładunków umiarkowana | Opisz problem w ograniczeniach badania |
| Usunięcie pozycji | Treść pozycji wyraźnie dotyczy innego konstruktu; konstrukt zachowuje zakres treści | Podaj wyniki przed i po zmianie; przy skali standardowej wyniki przestają być porównywalne z normami |
| Przeformułowanie w kolejnej wersji narzędzia | Budowa lub adaptacja skali | Sprawdź nową wersję w osobnej próbie, np. w wywiadzie poznawczym i w nowej analizie |
| Dopuszczenie ładunku krzyżowego w CFA | Teoria przewiduje, że pozycja odzwierciedla dwie cechy | To zmiana modelu pomiarowego – uzasadnij ją przed analizą albo oznacz jako eksploracyjną |
We wszystkich wariantach obowiązuje ta sama zasada: decyzja wynika z treści pozycji i celu pomiaru, a nie z samego przekroczenia progu.
Jak opisać wynik w pracy
Pełną macierz ładunków krzyżowych umieść w aneksie albo w tabeli pomocniczej. W tekście podaj kryteria trafności różnicowej (przede wszystkim HTMT z przedziałem ufności) i opisz pozycje, które budziły wątpliwości, oraz decyzję w ich sprawie.
Ładunki krzyżowe w R (seminr)
Kod symuluje dane z przykładu, szacuje model PLS z trzema kompozytami, wypisuje macierz ładunków i ładunków krzyżowych, liczy dla każdej pozycji różnicę między ładunkiem własnym a najwyższym krzyżowym, a następnie podaje kryterium Fornella–Larckera, HTMT z bootstrapowym przedziałem ufności i wynik modelu bez pozycji PP4. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Macierz ładunków krzyżowych, Fornell–Larcker i HTMT
R
# R119 – macierz ładunków i ładunków krzyżowych w PLS-SEM (pakiet seminr)
# Dane symulowane: 300 studentów pierwszego roku, pozycje 1–7.
# Wsparcie rówieśników (WR1–WR4), poczucie przynależności (PP1–PP4), satysfakcja ze studiów (SS1–SS3).
# Pozycja PP4 („mam na roku osoby, na które mogę liczyć”) mierzy w populacji także wsparcie.
suppressPackageStartupMessages({library(lavaan); library(seminr)})
set.seed(119)
populacja <- '
  WR =~ 0.80*WR1 + 0.78*WR2 + 0.75*WR3 + 0.72*WR4
  PP =~ 0.80*PP1 + 0.76*PP2 + 0.74*PP3 + 0.40*PP4
  SS =~ 0.82*SS1 + 0.78*SS2 + 0.74*SS3
  WR =~ 0.45*PP4
  WR ~~ 0.50*PP
  SS ~ 0.20*WR + 0.40*PP
'
z <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4.6 + 1.2 * x), 1), 7)))

pomiar <- constructs(
  composite("WR", multi_items("WR", 1:4)),
  composite("PP", multi_items("PP", 1:4)),
  composite("SS", multi_items("SS", 1:3)))
struktura <- relationships(paths(from = c("WR", "PP"), to = "SS"))
pls <- estimate_pls(data = dane, measurement_model = pomiar, structural_model = struktura)
s <- summary(pls)

# 1. Macierz ładunków i ładunków krzyżowych: korelacje każdej pozycji z wynikami każdego konstruktu
round(s$validity$cross_loadings, 3)

# 2. Dla każdej pozycji: ładunek własny, najwyższy ładunek krzyżowy i różnica
kl <- s$validity$cross_loadings
wlasny <- sub("[0-9]+$", "", rownames(kl))
tab <- data.frame(pozycja = rownames(kl),
                  wlasny = round(kl[cbind(rownames(kl), wlasny)], 3),
                  max_krzyzowy = round(sapply(seq_len(nrow(kl)), function(i) max(kl[i, colnames(kl) != wlasny[i]])), 3))
tab$roznica <- round(tab$wlasny - tab$max_krzyzowy, 3)
tab

# 3. Kryterium Fornella–Larckera i HTMT
round(s$validity$fl_criteria, 3)
round(s$validity$htmt, 3)

# 4. Przedział bootstrapowy HTMT dla pary WR–PP
set.seed(1190)
boot <- bootstrap_model(pls, nboot = 2000, cores = 1)
sb <- summary(boot, alpha = 0.05)
round(sb$bootstrapped_HTMT, 3)

# 5. Model bez PP4
pomiar2 <- constructs(
  composite("WR", multi_items("WR", 1:4)),
  composite("PP", multi_items("PP", 1:3)),
  composite("SS", multi_items("SS", 1:3)))
s2 <- summary(estimate_pls(data = dane, measurement_model = pomiar2, structural_model = struktura))
round(s2$validity$htmt, 3)
round(s$paths, 3)
round(s2$paths, 3)
Wynik w R
Generating the seminr model
All 300 observations are valid.
       WR    PP    SS
WR1 0.828 0.492 0.220
WR2 0.815 0.491 0.203
WR3 0.808 0.443 0.252
WR4 0.829 0.485 0.274
PP1 0.424 0.836 0.327
PP2 0.384 0.779 0.313
PP3 0.414 0.800 0.315
PP4 0.618 0.736 0.304
SS1 0.286 0.380 0.935
SS2 0.289 0.376 0.927
SS3 0.230 0.344 0.900
   pozycja wlasny max_krzyzowy roznica
1      WR1  0.828        0.492   0.336
2      WR2  0.815        0.491   0.324
3      WR3  0.808        0.443   0.365
4      WR4  0.829        0.485   0.344
5      PP1  0.836        0.424   0.412
6      PP2  0.779        0.384   0.395
7      PP3  0.800        0.414   0.386
8      PP4  0.736        0.618   0.118
9      SS1  0.935        0.380   0.555
10     SS2  0.927        0.376   0.551
11     SS3  0.900        0.344   0.556
      WR    PP    SS
WR 0.820     .     .
PP 0.581 0.789     .
SS 0.293 0.399 0.921

FL Criteria table reports square root of AVE on the diagonal and construct correlations on the lower triangle.
      WR    PP SS
WR     .     .  .
PP 0.716     .  .
SS 0.329 0.468  .
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
           Original Est. Bootstrap Mean Bootstrap SD T Stat. 2.5% CI 97.5% CI
WR  ->  PP         0.716          0.716        0.044   6.405   0.627    0.799
WR  ->  SS         0.329          0.329        0.057  11.747   0.214    0.436
PP  ->  SS         0.468          0.469        0.056   9.538   0.358    0.575
           Bootstrap P Val
WR  ->  PP           0.000
WR  ->  SS           0.000
PP  ->  SS           0.000
Generating the seminr model
All 300 observations are valid.
      WR    PP SS
WR     .     .  .
PP 0.604     .  .
SS 0.329 0.452  .
          SS
R^2    0.165
AdjR^2 0.159
WR     0.092
PP     0.345
          SS
R^2    0.161
AdjR^2 0.155
WR     0.140
PP     0.313
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane wygenerowano funkcją simulateData() z pakietu lavaan); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N. P., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Uznanie reguły „własny ładunek najwyższy” za dowód trafności różnicowej. W przykładzie była spełniona, choć pozycja PP4 w populacji wiązała się silniej z innym konstruktem.
- Ocena samych progów bez różnic. Ładunek .74 wygląda dobrze, dopóki nie zobaczysz ładunku krzyżowego .62.
- Usuwanie pozycji wyłącznie na podstawie liczb. Wskaźnik z dużym ładunkiem krzyżowym może być ważny dla trafności treściowej. Każde usunięcie uzasadnij treścią pozycji i pokaż, jak zmieniły się wyniki.
- Mylenie macierzy wzorca i macierzy struktury w EFA. W rotacji ukośnej ładunki krzyżowe w macierzy struktury są zawyżone przez korelację czynników (zob. rotacja ukośna).
- Raport bez bootstrapowego CI dla HTMT – sama wartość punktowa nie mówi, jak blisko progu może leżeć wartość populacyjna.
Cały proces oceny modelu pomiarowego – ładunki, rzetelność, AVE, HTMT i ładunki krzyżowe – omawia przewodnik PLS-SEM krok po kroku. Pełny kod z pakietami seminr i cSEM znajdziesz we wpisie PLS-SEM w R.
Najczęstsze pytania
Jaki ładunek krzyżowy jest za wysoki?
Nie ma jednego uzgodnionego progu. Praktyczniej jest patrzeć na różnicę między ładunkiem własnym a najwyższym ładunkiem krzyżowym: różnica rzędu .10–.20 wskazuje pozycję, którą trzeba przejrzeć pod kątem treści. W przykładzie z tego hasła pozycja PP4 miała ładunki .74 i .62, a pozostałe pozycje – różnice od .32 do .56.
Czy ładunki krzyżowe wystarczą do oceny trafności różnicowej w PLS-SEM?
Nie. Symulacje Henselera i in. (2015) pokazały, że analiza ładunków krzyżowych i kryterium Fornella–Larckera często nie wykrywają braku trafności różnicowej. Podstawą oceny powinno być HTMT z bootstrapowym przedziałem ufności, a macierz ładunków krzyżowych pomaga ustalić, która pozycja odpowiada za problem.
Dlaczego w PLS ładunek własny prawie zawsze jest najwyższy?
Bo wynik kompozytu jest ważoną sumą jego wskaźników, w tym tego samego wskaźnika. Korelacja pozycji z własnym kompozytem zawiera więc element korelacji części z całością i ma wbudowaną przewagę nad korelacjami z innymi kompozytami.
Co zrobić z pozycją o wysokim ładunku krzyżowym?
Najpierw przeczytaj jej treść i sprawdź, czy nie opisuje innego konstruktu albo dwóch treści naraz. Jeśli usuwasz pozycję, uzasadnij to merytorycznie, pokaż, jak zmieniły się HTMT i ścieżki, i rozważ, czy jej brak nie zubaża zakresu konstruktu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa na wykresie
Osypisko z analizą równoległą, mapa ładunków, varimax vs oblimin, korelacje czynników i h² – pięć rysunków z kodem R i symulacją Monte Carlo.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fornell, C., & Larcker, D. F. (1981). Evaluating Structural Equation Models with Unobservable Variables and Measurement Error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.2307/3151312
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Rönkkö, M., & Cho, E. (2022). An Updated Guideline for Assessing Discriminant Validity. Organizational Research Methods, 25(1), 6–14. https://doi.org/10.1177/1094428120968614 ● Otwarty dostęp
Cytowania BibTeX
@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating Structural Equation Models with Unobservable Variables and Measurement Error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.2307/3151312}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{ronkko2022updated, author={Rönkkö, Mikko and Cho, Eunseong}, title={{An Updated Guideline for Assessing Discriminant Validity}}, journal={Organizational Research Methods}, year={2022}, volume={25}, number={1}, pages={6--14}, doi={10.1177/1094428120968614}}