Co to jest macierz reszt standaryzowanych?
Macierz reszt standaryzowanych (ang. standardized residual matrix) zestawia, dla każdej pary zmiennych obserwowalnych, różnicę między kowariancją z danych a kowariancją odtworzoną przez model SEM, podzieloną przez błąd standardowy tej różnicy. Każdy element macierzy to więc statystyka z: mówi, o ile błędów standardowych model „rozmija się” z danymi w jednym konkretnym miejscu.
Globalne miary dopasowania – χ² (CMIN), CFI, RMSEA – streszczają całe niedopasowanie jedną liczbą. Macierz reszt robi rzecz odwrotną: rozkłada je na pojedyncze pary pozycji. Dlatego jest podstawowym narzędziem diagnostyki lokalnej w konfirmacyjnej analizie czynnikowej i w pełnych modelach SEM. McDonald i Ho (2002) zalecają, by obok indeksów dopasowania udostępniać czytelnikom macierz korelacji i rozbieżności, bo dopiero one pozwalają samodzielnie ocenić model.
Trzy rodzaje reszt – nie myl ich
Programy podają reszty w kilku postaciach, a nazwy bywają mylące. Zanim zinterpretujesz liczbę, sprawdź, którą z nich masz przed sobą.
| Rodzaj reszty | Jak powstaje | Jak czytać |
|---|---|---|
| Surowa (kowariancyjna) | sij − σ̂ij, w jednostkach zmiennych | Zależy od skali pozycji – trudno porównywać pary |
| Korelacyjna | korelacja obserwowana minus korelacja odtworzona | Wielkość efektu niedopasowania; |rres| powyżej ok. .10 zwykle zasługuje na uwagę |
| Standaryzowana (z) | reszta surowa podzielona przez swój błąd standardowy | Test lokalny: |z| > 1.96 (α = .05) lub > 2.58 (α = .01); rośnie z N |
Reszta standaryzowana i reszta korelacyjna odpowiadają na różne pytania. Pierwsza mówi, czy rozbieżność da się odróżnić od przypadku, druga – czy jest duża. W próbie liczącej kilka tysięcy osób nawet nieistotna praktycznie różnica .02 da |z| > 3. Maydeu-Olivares i Shi (2017) traktują reszty korelacyjne i standaryzowane reszty kowariancji jako miary wielkości efektu niedopasowania. Pokazali też, że przedziały ufności dla nich są trafne już przy N = 100, a do wykrywania błędów specyfikacji działają niemal tak samo jak indeksy modyfikacji. Średnią z kwadratów reszt korelacyjnych podsumowuje SRMR. Macierz pokazuje jednak, gdzie jest problem, a SRMR – tylko, ile go jest łącznie.
Przykład: dobre indeksy, wyraźna reszta
Czterystu studentów (dane symulowane) wypełniło 8-pozycyjną skalę wypalenia studenckiego (1–7). Cztery pozycje mierzą wyczerpanie (W1–W4), a cztery – cynizm (C1–C4). Pozycje W3 („Rano czuję się zmęczony na myśl o zajęciach”) i W4 („Przed zajęciami czuję zmęczenie”) mają prawie identyczne sformułowanie. W populacji ich błędy pomiaru są więc skorelowane, ale model badacza tego nie zakłada.
Dwuczynnikowa CFA (estymacja ML) ma globalnie przyzwoite dopasowanie: χ²(19) = 41.97, p = .002, CFI = .979, RMSEA = .055, SRMR = .039. Według popularnych progów można by na tym skończyć. Macierz reszt standaryzowanych (rysunek 1, lewy panel) pokazuje jednak cztery pary z |z| > 2.58. Największa reszta dotyczy pary W3–W4: z = 4.33.
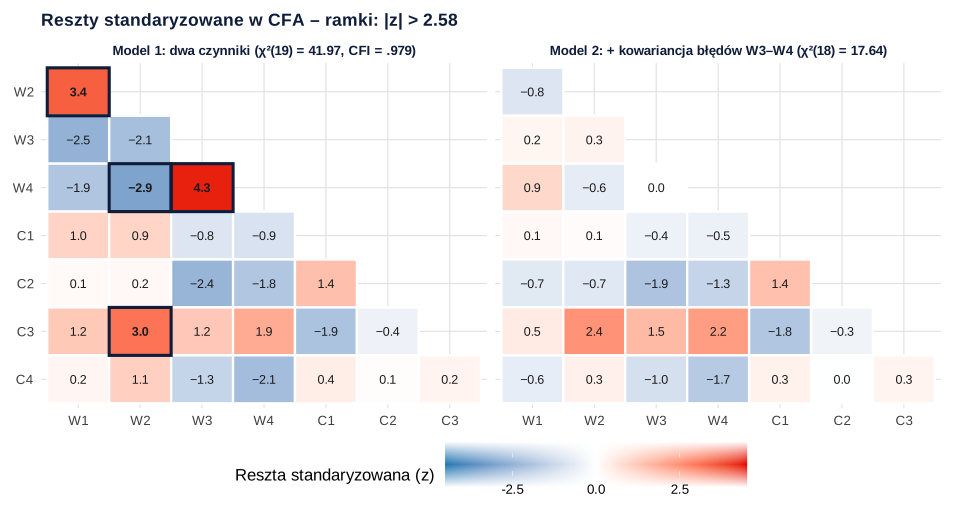
Najciekawszy jest wzór reszt, a nie sama największa liczba. Dodatnia reszta W3–W4 sąsiaduje z ujemnymi resztami W3 i W4 z pozostałymi pozycjami wyczerpania (od −1.86 do −2.95). Model próbuje wyjaśnić nadwyżkę wspólnej wariancji W3 i W4 przez czynnik. Zawyża więc ich ładunki, a przez to przeszacowuje ich związki z W1 i W2. Dlatego reszta korelacyjna W3–W4 wynosi tylko .044 – niedopasowanie „rozlało się” po całym czynniku.
Para W2–C3 ma z kolei największą resztę korelacyjną (.109, z = 3.04), choć w populacji nie ma tam żadnego dodatkowego związku. To przypadkowe odchylenie, jakich w macierzy 28 reszt można się spodziewać. Saris i in. (2009) ostrzegają przed oceną modelu wyłącznie na podstawie globalnych indeksów. Z tego przykładu wynika też druga lekcja: nie każdą dużą resztę trzeba „naprawiać”.
Treść pozycji uzasadnia kowariancję błędów W3–W4, więc model ją dodano (zob. kowariancja reszt w SEM). Dopasowanie wyraźnie się poprawiło: χ²(18) = 17.64, p = .480, CFI = 1.000, a test różnicy chi-kwadrat dał Δχ²(1) = 24.34, p < .001. Oszacowana korelacja błędów wyniosła .36. Największa reszta spadła do |z| = 2.41, a reszta W2–C3 nie wymagała już osobnej decyzji.
Jak czytać macierz reszt krok po kroku
- Najpierw dopuszczalność rozwiązania. Ujemne wariancje (przypadek Heywooda) i brak zbieżności unieważniają diagnostykę reszt.
- Szukaj skupisk, nie pojedynczych liczb. Kilka dużych reszt jednej pozycji z pozycjami innego czynnika sugeruje ładunek krzyżowy. Jedna dodatnia reszta między pozycjami o podobnej treści sugeruje skorelowane błędy. Wiele reszt między dwoma blokami pozycji może oznaczać, że korelacja czynników jest źle określona albo brakuje czynnika.
- Zestaw z z resztą korelacyjną. Duże z przy reszcie korelacyjnej .02 to w dużej próbie zwykle sprawa kosmetyczna. Reszta korelacyjna powyżej .10 bywa ważna nawet przy umiarkowanym z.
- Pamiętaj o liczbie testów. W skali z 20 pozycjami jest 190 reszt, więc przy α = .05 kilka „istotnych” pojawi się przypadkiem (zob. problem wielokrotnych porównań).
- Zmieniaj model tylko z uzasadnieniem merytorycznym i opisz każdą zmianę. Model poprawiany pod dane wymaga potwierdzenia w nowej próbie.
Reszty zależą też od sposobu estymacji. Przy pozycjach porządkowych szacowanych estymatorem WLSMV reszty korelacyjne dotyczą korelacji polichorycznych, a nie korelacji Pearsona. Przy danych nienormalnych i estymatorze MLR wartości z powinny opierać się na odpornych błędach standardowych. W opisie wyników zaznacz więc, z jakiego modelu i jakiej estymacji pochodzą reszty.
Jak opisać reszty w pracy (APA)
W rozdziale wyników podaj globalne dopasowanie, a potem jednym–dwoma zdaniami diagnostykę lokalną: jakiego rodzaju reszty sprawdzono, jaki przyjęto próg, które pary go przekroczyły i co z tym zrobiono. Pełną macierz reszt korelacyjnych możesz umieścić w aneksie. Indeksy zestaw według wzoru z hasła tabela dopasowania modelu CFA w APA. Przy progach CFI i SRMR powołuj się ostrożnie na Hu i Bentlera (1999) – ich wartości odcięcia dotyczą określonych warunków symulacji.
Macierz reszt w R (lavaan)
Kod symuluje dane z przykładu, dopasowuje dwuczynnikową CFA, wypisuje reszty korelacyjne i standaryzowane, wybiera pary z |z| > 2.58 i porównuje model wyjściowy z modelem z kowariancją błędów W3–W4. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Reszty korelacyjne i standaryzowane w CFA
R
# R118 – macierz reszt standaryzowanych w CFA (pakiet lavaan)
# Dane symulowane: 400 studentów, skala wypalenia studenckiego, 8 pozycji (1–7):
# wyczerpanie W1–W4 i cynizm C1–C4. W populacji W3 i W4 mają wspólny błąd
# (podobne sformułowanie: „zmęczenie rano” / „zmęczenie przed zajęciami”).
suppressPackageStartupMessages(library(lavaan))
set.seed(118)
populacja <- '
  wycz =~ 0.80*W1 + 0.75*W2 + 0.70*W3 + 0.70*W4
  cyn  =~ 0.75*C1 + 0.70*C2 + 0.70*C3 + 0.65*C4
  wycz ~~ 0.45*cyn
  W3 ~~ 0.22*W4
'
z <- simulateData(populacja, sample.nobs = 400, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.3 * x), 1), 7)))

# 1. Model zgodny z teorią: dwa skorelowane czynniki, bez kowariancji błędów
model <- '
  wycz =~ W1 + W2 + W3 + W4
  cyn  =~ C1 + C2 + C3 + C4
'
fit <- cfa(model, data = dane)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)

# 2. Reszty korelacyjne: obserwowana minus odtworzona korelacja
r_kor <- lavResiduals(fit, type = "cor.bollen")
round(r_kor$cov, 2)

# 3. Reszty standaryzowane (z): reszta kowariancji podzielona przez jej błąd standardowy
r_z <- lavResiduals(fit, type = "raw")$cov.z
round(r_z, 2)

# 4. Największe reszty (|z| > 2.58)
ind <- which(abs(r_z) > 2.58 & lower.tri(r_z), arr.ind = TRUE)
data.frame(para = paste(rownames(r_z)[ind[, 1]], colnames(r_z)[ind[, 2]], sep = "–"),
           z = round(r_z[ind], 2), r_reszta = round(r_kor$cov[ind], 3))

# 5. Podsumowanie reszt (m.in. SRMR i rozkład reszt z)
round(lavResiduals(fit, type = "cor.bentler")$summary, 3)
round(quantile(r_z[lower.tri(r_z)], c(0, .5, 1)), 2)

# 6. Treść W3 i W4 uzasadnia wspólny błąd: model poprawiony
fit2 <- cfa(paste(model, "W3 ~~ W4"), data = dane)
round(fitMeasures(fit2, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
r_z2 <- lavResiduals(fit2, type = "raw")$cov.z
round(max(abs(r_z2[lower.tri(r_z2)])), 2)
anova(fit, fit2)
round(standardizedSolution(fit2)[standardizedSolution(fit2)$op == "~~" & standardizedSolution(fit2)$lhs == "W3" & standardizedSolution(fit2)$rhs == "W4", c("est.std", "pvalue")], 3)
Wynik w R
 chisq     df pvalue    cfi  rmsea   srmr
41.973 19.000  0.002  0.979  0.055  0.039
      W1    W2    W3    W4    C1    C2    C3    C4
W1  0.00
W2  0.06  0.00
W3 -0.03 -0.02  0.00
W4 -0.02 -0.04  0.04  0.00
C1  0.03  0.03 -0.03 -0.03  0.00
C2  0.00  0.01 -0.08 -0.06  0.03  0.00
C3  0.04  0.11  0.04  0.06 -0.03 -0.01  0.00
C4  0.01  0.04 -0.05 -0.07  0.01  0.00  0.00  0.00
      W1    W2    W3    W4    C1    C2    C3    C4
W1  0.00
W2  3.44  0.00
W3 -2.48 -2.06  0.00
W4 -1.86 -2.95  4.33  0.00
C1  0.96  0.94 -0.82 -0.90  0.00
C2  0.13  0.15 -2.38 -1.82  1.44  0.00
C3  1.22  3.04  1.24  1.87 -1.93 -0.40  0.00
C4  0.20  1.06 -1.34 -2.10  0.38  0.05  0.25  0.00
   para     z r_reszta
1 W2–W1  3.44    0.064
2 W4–W2 -2.95   -0.036
3 C3–W2  3.04    0.109
4 W4–W3  4.33    0.044
                           cov
srmr                     0.039
srmr.se                  0.005
srmr.exactfit.z          2.750
srmr.exactfit.pvalue     0.003
usrmr                    0.030
usrmr.se                 0.009
usrmr.ci.lower           0.015
usrmr.ci.upper           0.045
usrmr.closefit.h0.value  0.050
usrmr.closefit.z        -2.200
usrmr.closefit.pvalue    0.986
   0%   50%  100%
-2.95  0.14  4.33
 chisq     df pvalue    cfi  rmsea   srmr
17.636 18.000  0.480  1.000  0.000  0.029
[1] 2.41

Chi-Squared Difference Test

     Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit2 18 9828.0 9899.9 17.636
fit  19 9850.4 9918.2 41.973     24.337 0.24154       1  8.087e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  est.std pvalue
9   0.357      0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raport bez diagnostyki lokalnej. CFI = .979 i SRMR = .039 nie wykluczają wyraźnego błędu specyfikacji w jednym miejscu modelu.
- Mylenie rodzajów reszt. Program może nazwać „standaryzowanymi” reszty korelacyjne albo wartości z. Próg 2.58 dotyczy tylko z, a próg .10 – tylko reszt korelacyjnych.
- Uwalnianie parametrów jeden po drugim, aż wszystkie reszty znikną. To dopasowywanie modelu do przypadkowych cech próby. Więcej o tym w przewodniku CB-SEM krok po kroku.
- Ignorowanie wzoru reszt. Dodatnia reszta otoczona ujemnymi w obrębie tego samego czynnika to typowy ślad skorelowanych błędów. Rozproszone reszty w jednym wierszu macierzy wskazują raczej na problematyczną pozycję.
- Ocena reszt w bardzo dużej próbie wyłącznie po z. Gdy N liczy tysiące, sprawdzaj przede wszystkim wielkość reszt korelacyjnych.
Pełny przykład CFA z diagnostyką reszt, indeksami modyfikacji i raportem znajdziesz we wpisie CB-SEM w R w pakiecie lavaan, a ogólne zasady wyboru między EFA a CFA – w poradniku analiza czynnikowa EFA i CFA.
Najczęstsze pytania
Jaka reszta standaryzowana w CFA jest za duża?
Wartości |z| powyżej 1.96 przekraczają próg α = .05, a powyżej 2.58 – próg α = .01. Przy wielu parach zmiennych część przekroczeń pojawia się jednak przypadkiem, a w dużej próbie istotne bywają drobne rozbieżności. Dlatego sprawdzaj też resztę korelacyjną: wartości powyżej ok. .10 zwykle zasługują na uwagę.
Czym różni się reszta standaryzowana od reszty korelacyjnej?
Reszta korelacyjna to różnica między korelacją obserwowaną a odtworzoną przez model – mówi, jak duża jest rozbieżność. Reszta standaryzowana dzieli różnicę kowariancji przez jej błąd standardowy – mówi, czy rozbieżność da się odróżnić od przypadku. Pierwsza nie zależy od liczebności próby, druga rośnie razem z nią.
Czy dobry CFI i SRMR wystarczą, żeby nie sprawdzać reszt?
Nie. Globalne indeksy uśredniają niedopasowanie, więc jeden wyraźny błąd specyfikacji może się w nich nie ujawnić. W przykładzie z tego hasła CFI wynosił .979, a SRMR .039, mimo że para pozycji o niemal identycznym brzmieniu miała resztę z = 4.33.
Jak uzyskać macierz reszt w lavaan?
Użyj funkcji lavResiduals(fit, type = "raw")$cov.z – to reszty standaryzowane (z), a lavResiduals(fit, type = "cor.bollen")$cov – reszty korelacyjne. W AMOS włącz opcję „Residual moments” w ustawieniach wyników analizy.
Co zrobić z dużą resztą między dwiema pozycjami?
Najpierw przeczytaj treść obu pozycji i sprawdź, czy rozbieżność ma sens merytoryczny, np. podobne sformułowanie albo wspólny aspekt treści. Dopiero wtedy rozważ kowariancję błędów lub ładunek krzyżowy, opisz zmianę w pracy i potraktuj poprawiony model jako eksploracyjny, wymagający potwierdzenia w nowej próbie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Maydeu-Olivares, A., & Shi, D. (2017). Effect sizes of model misfit in structural equation models. Methodology, 13(Supplement 1), 23–30. https://doi.org/10.1027/1614-2241/a000129 ● Otwarty dostęp
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Saris, W. E., Satorra, A., & van der Veld, W. M. (2009). Testing structural equation models or detection of misspecifications? Structural Equation Modeling: A Multidisciplinary Journal, 16(4), 561–582. https://doi.org/10.1080/10705510903203433 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{maydeuolivares2017effect, author={Maydeu-Olivares, Alberto and Shi, Dexin}, title={{Effect sizes of model misfit in structural equation models}}, journal={Methodology}, year={2017}, volume={13}, number={Supplement 1}, pages={23--30}, doi={10.1027/1614-2241/a000129}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{saris2009testing, author={Saris, Willem E. and Satorra, Albert and van der Veld, William M.}, title={{Testing structural equation models or detection of misspecifications?}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={4}, pages={561--582}, doi={10.1080/10705510903203433}}