Co to jest przypadek Heywooda?
Przypadek Heywooda (ang. Heywood case) to rozwiązanie modelu czynnikowego lub SEM, w którym oszacowana wariancja błędu (reszty) wskaźnika jest ujemna, a w konsekwencji jego ładunek standaryzowany przekracza 1. Wariancja nie może być ujemna, więc takie rozwiązanie jest niedopuszczalne (ang. improper solution) – nawet jeśli program je wypisał i dopasowanie wygląda dobrze. Nazwa pochodzi od nazwiska H. B. Heywooda, który w latach 30. XX wieku opisał to zjawisko w analizie czynnikowej.
W psychologii przypadki Heywooda zdarzają się najczęściej w CFA krótkich skal i podskal mierzonych dwiema–trzema pozycjami, w małych próbach i przy pozycjach, które niemal powtarzają tę samą treść. Pojęcie bywa używane szerzej – także dla ujemnych wariancji czynników albo korelacji czynników większych niż 1 – ale klasycznie dotyczy wariancji błędu wskaźnika.
Skąd się bierze ujemna wariancja?
W modelu refleksyjnym wariancja wskaźnika dzieli się na część wspólną (λ²) i błąd (θ). Program dobiera ładunki tak, by odtworzyć obserwowane kowariancje. Jeśli dane „żądają” ładunku tak dużego, że λ² przekracza wariancję wskaźnika, błąd musi wyjść ujemny. Prowadzą do tego różne mechanizmy:
| Przyczyna | Typowy sygnał | Co zrobić |
|---|---|---|
| Błąd losowy przy małej próbie | Ujemna wariancja bliska zera, przedział ufności obejmuje 0 | Ograniczenie do wartości nieujemnych, większa próba |
| Za mało wskaźników na czynnik (zwłaszcza 2) | Problem dotyczy czynnika z dwoma wskaźnikami | Dodanie pozycji, ograniczenia równości ładunków (gdy uzasadnione) |
| Błędna specyfikacja modelu | Wyraźnie ujemna wariancja, przedział nie obejmuje 0, złe dopasowanie lub duże indeksy modyfikacji | Poprawa modelu (pominięty czynnik, ładunek krzyżowy, kowariancja reszt) |
| Wartości odstające, braki danych, niemal identyczne pozycje | Ekstremalne korelacje w macierzy wejściowej | Kontrola danych przed analizą |
Anderson i Gerbing (1984) w badaniu Monte Carlo stwierdzili, że rozwiązania niezbieżne i niedopuszczalne występowały częściej przy mniejszych próbach i mniejszej liczbie wskaźników na czynnik. Kolenikov i Bollen (2012) pokazali natomiast, że błędna specyfikacja strukturalna może dawać ujemną wariancję nawet w populacji – wtedy żadna liczebność próby jej nie usunie. Dlatego kluczowe pytanie brzmi: czy ujemna wariancja jest zgodna z wahaniem losowym wokół zera, czy wyraźnie od zera odstaje?
Zanim zmienisz model, sprawdź dane:
- czy w macierzy korelacji nie ma wartości bliskich 1 (dwie pozycje o niemal identycznej treści albo zdublowana kolumna);
- czy pozycje odwrócone zostały przekodowane (zob. pozycja odwrócona);
- jak obsłużono braki danych – analiza par dostępnych przypadków może dać macierz, której nie odtworzy żaden poprawny model;
- czy kilka skrajnych obserwacji nie zawyża jednej korelacji.
Przykład: lęk przed egzaminem w małej próbie
Krótki kwestionariusz lęku przed egzaminem (skala 1–5) wypełniło 90 studentów (dane symulowane). Model CFA ma trzy czynniki: zamartwianie (3 pozycje), napięcie (3 pozycje) i objawy somatyczne mierzone tylko dwiema pozycjami (som1, som2). W populacji model jest poprawny, a wszystkie wariancje błędu są dodatnie.
- Sygnał. lavaan wypisuje ostrzeżenie
some estimated ov variances are negative, alavInspect(fit, "post.check")zwracaFALSE. - Lokalizacja. Wariancja reszty som1 wynosi −0.051, a ładunek standaryzowany som1 – 1.029. Druga pozycja czynnika, som2, ma ładunek .550.
- Diagnoza. Błąd standardowy jest duży (SE = 0.255), z = −0.20, p = .842, a 95% przedział ufności [−0.550, 0.448] obejmuje zero i wartości dodatnie. Dopasowanie modelu jest bardzo dobre: χ²(17) = 10.36, p = .888, CFI = 1.000, RMSEA = .000, SRMR = .047. Wszystko wskazuje na błąd losowy przy małej próbie i czynniku z dwoma wskaźnikami, a nie na błędną specyfikację.
- Rozwiązanie 1 – ograniczenie nierównościowe. Po ograniczeniu wariancji reszty som1 do wartości dodatnich estymator zatrzymuje się na granicy (oszacowanie 0), a dopasowanie praktycznie się nie zmienia: χ²(17) = 10.41.
- Rozwiązanie 2 – równe ładunki som1 i som2. To rozwiązanie jest dopuszczalne (wariancje reszt 0.307 i 0.411), ale ograniczenie istotnie pogarsza dopasowanie: test różnicy χ² dał Δχ²(1) = 6.45, p = .011. Nie ma więc podstaw, by zakładać równe ładunki – to rozwiązanie odrzucamy.
Taka kolejność postępowania odpowiada wnioskom Dillona i in. (1987): gdy przypadek Heywooda wynika z wahań losowych, ustawienie wariancji na zero działa zadowalająco, a gdy wynika z braku dopasowania i błędnej specyfikacji, gotowych rozwiązań technicznych nie ma – trzeba poprawić model. Chen i in. (2001) dodają, że oszacowania w próbach z rozwiązaniami niedopuszczalnymi były bardziej obciążone, a ograniczenia nierównościowe pomagały osiągnąć zbieżność. W raporcie opisz więc problem i zastosowane ograniczenie zamiast je ukrywać.
Jak często zdarza się w poprawnym modelu?
Rysunek 1 pokazuje symulację: model trzech czynników jest w populacji dokładnie prawdziwy (ładunki .60–.80), a mimo to ujemne wariancje pojawiają się regularnie. Przy dwóch wskaźnikach na czynnik i N = 50 przypadek Heywooda wystąpił w 45.0% prób (a w kolejnych 14.3% estymacja nie osiągnęła zbieżności), przy N = 100 – w 28.0%, przy N = 400 – w 3.2%. Trzy wskaźniki na czynnik obniżają ten odsetek do 13.8% przy N = 50 i 1.2% przy N = 100.
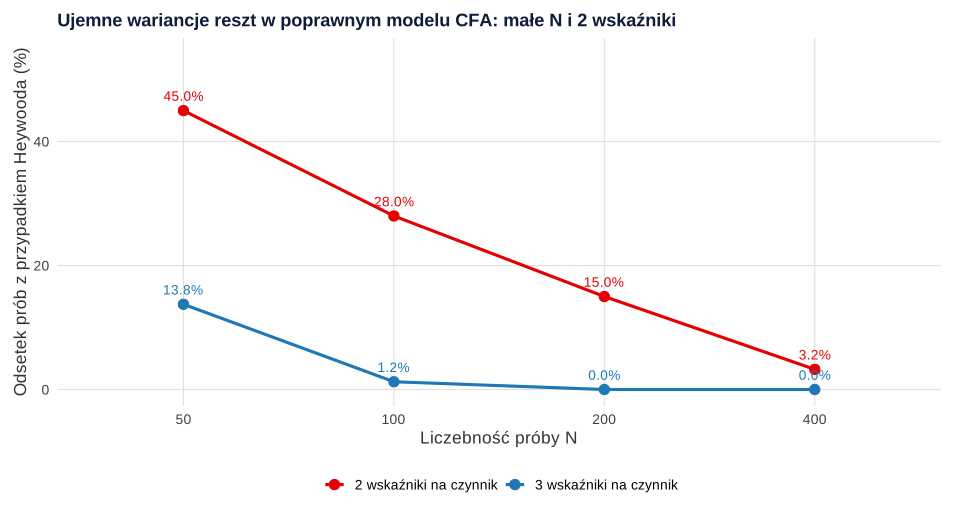
Praktyczny wniosek dla planowania badania: nie projektuj podskal z dwiema pozycjami, jeśli zamierzasz analizować je w CFA, i licz się z tym, że przy N poniżej 100–200 rozwiązania niedopuszczalne będą częste. Więcej o planowaniu liczebności – w poradniku dobór liczebności próby, a o konstrukcji skal – we wpisie budowa i walidacja skali psychometrycznej.
Jak opisać przypadek Heywooda w pracy
Recenzenci oczekują informacji, że problem wystąpił, jaka była jego prawdopodobna przyczyna i co z nim zrobiono. Wzór dla przykładu:
Przypadek Heywooda w R (lavaan)
Kod tworzy dane z przykładu, wykrywa ujemną wariancję, sprawdza jej przedział ufności i porównuje dwa sposoby postępowania. Liczby w tekście pochodzą z tego kodu, a rysunek 1 – z osobnej symulacji (400 prób w każdym z ośmiu wariantów).
Wykrycie, diagnoza i dwa rozwiązania
R
# Dane symulowane: 90 studentów, krótki kwestionariusz lęku przed egzaminem (1–5):
# zamartwianie (zam1–zam3), napięcie (nap1–nap3) i objawy somatyczne mierzone tylko 2 pozycjami (som1, som2)
suppressPackageStartupMessages(library(lavaan))
set.seed(8)
n <- 90
R <- matrix(c(1, .55, .45, .55, 1, .50, .45, .50, 1), 3)
F <- MASS::mvrnorm(n, rep(0, 3), R)
poz <- function(f, l) round(pmin(pmax(2.8 + 0.9 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 5), 1)
dane <- data.frame(zam1 = poz(F[, 1], .75), zam2 = poz(F[, 1], .70), zam3 = poz(F[, 1], .65),
                   nap1 = poz(F[, 2], .75), nap2 = poz(F[, 2], .70), nap3 = poz(F[, 2], .60),
                   som1 = poz(F[, 3], .90), som2 = poz(F[, 3], .65))
model <- '
  ZAM =~ zam1 + zam2 + zam3
  NAP =~ nap1 + nap2 + nap3
  SOM =~ som1 + som2
'
# lavaan ostrzega o ujemnej wariancji – wypisujemy treść ostrzeżenia
fit <- withCallingHandlers(cfa(model, data = dane), warning = function(w) {
  message("Ostrzeżenie: ", conditionMessage(w)); invokeRestart("muffleWarning") })
suppressWarnings(lavInspect(fit, "post.check"))   # FALSE = rozwiązanie niedopuszczalne

# Wariancja reszty som1 z 95% CI i standaryzowany ładunek som1
pe <- parameterEstimates(fit)
round(pe[pe$lhs == "som1" & pe$op == "~~", c("est", "se", "z", "pvalue", "ci.lower", "ci.upper")], 3)
st <- standardizedSolution(fit)
round(st[st$op == "=~" & st$lhs == "SOM", "est.std"], 3)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)

# Rozwiązanie 1: ograniczenie wariancji reszty do wartości nieujemnych (gdy przyczyną jest błąd losowy)
model_ogr <- paste(model, 'som1 ~~ t1 * som1
  t1 > 0')
fit_ogr <- cfa(model_ogr, data = dane)
pe2 <- parameterEstimates(fit_ogr)
round(pe2[pe2$lhs == "som1" & pe2$op == "~~", "est"], 3)
round(fitMeasures(fit_ogr, c("chisq", "df", "cfi", "rmsea")), 3)

# Rozwiązanie 2: równe ładunki niestandaryzowane dwóch wskaźników czynnika SOM
fit_row <- cfa('ZAM =~ zam1 + zam2 + zam3
                NAP =~ nap1 + nap2 + nap3
                SOM =~ a * som1 + a * som2', data = dane)
lavInspect(fit_row, "post.check")
round(diag(lavInspect(fit_row, "est")$theta)[c("som1", "som2")], 3)
round(fitMeasures(fit_row, c("chisq", "df", "cfi", "rmsea")), 3)
lavTestLRT(fit, fit_row)          # czy ograniczenie równości istotnie pogarsza dopasowanie?
Wynik w R
Ostrzeżenie: lavaan->lav_object_post_check():
   some estimated ov variances are negative
[1] FALSE
      est    se    z pvalue ci.lower ci.upper
15 -0.051 0.255 -0.2  0.842    -0.55    0.448
[1] 1.029 0.550
 chisq     df pvalue    cfi  rmsea   srmr
10.363 17.000  0.888  1.000  0.000  0.047
[1] 0
 chisq     df    cfi  rmsea
10.407 17.000  1.000  0.000
[1] TRUE
 som1  som2
0.307 0.411
 chisq     df    cfi  rmsea
16.812 18.000  1.000  0.000

Chi-Squared Difference Test

        Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit     17 1706.4 1753.9 10.363
fit_row 18 1710.8 1755.8 16.812      6.449 0.24606       1     0.0111 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretowanie wyników mimo ostrzeżenia. Ładunek 1.03 nie oznacza „bardzo dobrej pozycji”, tylko rozwiązanie niedopuszczalne.
- Automatyczne ustawianie wariancji na zero bez sprawdzenia przedziału ufności i dopasowania. Gdy ujemna wariancja wynika z błędnej specyfikacji, ograniczenie tylko ukrywa problem.
- Nakładanie ograniczeń równości bez testu. W przykładzie równe ładunki usuwały problem, ale istotnie pogarszały dopasowanie.
- Usuwanie pozycji „sprawiającej kłopot” z czynnika, który ma już tylko dwie pozycje – czynnik przestaje być identyfikowany (zob. identyfikacja modelu SEM).
- Pomijanie problemu w raporcie. Opisz, co się stało i jak to rozwiązano; ukrycie przypadku Heywooda uniemożliwia ocenę wyników.
- Za mała próba i dwa wskaźniki na czynnik już na etapie planowania – najprostsza profilaktyka to co najmniej trzy dobre pozycje na czynnik i liczebność dobrana do złożoności modelu.
Najczęstsze pytania
Co oznacza ostrzeżenie „some estimated ov variances are negative” w lavaan?
To komunikat lavaan o przypadku Heywooda: co najmniej jedna zmienna jawna ma ujemną oszacowaną wariancję błędu. Rozwiązanie jest niedopuszczalne – nie interpretuj go, dopóki nie sprawdzisz, której pozycji dotyczy problem, jaki ma przedział ufności i czy model jest poprawnie określony.
Czy ładunek standaryzowany może być większy niż 1?
Jeśli pozycja ładuje tylko jeden czynnik, ładunek standaryzowany powyżej 1 oznacza, że jej wariancja błędu jest ujemna, czyli rozwiązanie jest niedopuszczalne. Nie jest to więc „bardzo dobra pozycja”, tylko sygnał problemu z modelem lub danymi. Wyjątkiem mogą być modele z ładunkami krzyżowymi, gdzie ładunki standaryzowane nie muszą być ograniczone do 1.
Czy można po prostu ustawić ujemną wariancję na zero?
Tak, ale tylko wtedy, gdy ujemna wartość jest zgodna z błędem losowym: jest bliska zera, jej przedział ufności obejmuje zero, a model jest dobrze dopasowany. Dillon i in. (1987) wykazali, że w takiej sytuacji to rozwiązanie działa zadowalająco. Gdy przyczyną jest błędna specyfikacja, ograniczenie tylko maskuje problem.
Jak uniknąć przypadku Heywooda w badaniu?
Planuj co najmniej trzy dobre pozycje na każdy czynnik, odpowiednio dużą próbę i usuń z danych błędy oraz skrajne obserwacje przed analizą. W symulacji na tej stronie przy dwóch wskaźnikach na czynnik i 100 osobach ujemna wariancja pojawiła się w 28.0% prób, a przy trzech wskaźnikach – w 1.2%.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1984). The effect of sampling error on convergence, improper solutions, and goodness-of-fit indices for maximum likelihood confirmatory factor analysis. Psychometrika, 49(2), 155–173. https://doi.org/10.1007/bf02294170
- Chen, F., Bollen, K. A., Paxton, P., Curran, P. J., & Kirby, J. B. (2001). Improper solutions in structural equation models. Sociological Methods & Research, 29(4), 468–508. https://doi.org/10.1177/0049124101029004003
- Dillon, W. R., Kumar, A., & Mulani, N. (1987). Offending estimates in covariance structure analysis: Comments on the causes of and solutions to Heywood cases. Psychological Bulletin, 101(1), 126–135. https://doi.org/10.1037/0033-2909.101.1.126
- Kolenikov, S., & Bollen, K. A. (2012). Testing negative error variances. Sociological Methods & Research, 41(1), 124–167. https://doi.org/10.1177/0049124112442138
Cytowania BibTeX
@article{anderson1984effect, author={Anderson, James C. and Gerbing, David W.}, title={{The effect of sampling error on convergence, improper solutions, and goodness-of-fit indices for maximum likelihood confirmatory factor analysis}}, journal={Psychometrika}, year={1984}, volume={49}, number={2}, pages={155--173}, doi={10.1007/bf02294170}}@article{chen2001improper, author={Chen, Feinian and Bollen, Kenneth A. and Paxton, Pamela and Curran, Patrick J. and Kirby, James B.}, title={{Improper solutions in structural equation models}}, journal={Sociological Methods \& Research}, year={2001}, volume={29}, number={4}, pages={468--508}, doi={10.1177/0049124101029004003}}@article{dillon1987offending, author={Dillon, William R. and Kumar, Ajith and Mulani, Narendra}, title={{Offending estimates in covariance structure analysis: Comments on the causes of and solutions to Heywood cases}}, journal={Psychological Bulletin}, year={1987}, volume={101}, number={1}, pages={126--135}, doi={10.1037/0033-2909.101.1.126}}@article{kolenikov2012testing, author={Kolenikov, Stanislav and Bollen, Kenneth A.}, title={{Testing negative error variances}}, journal={Sociological Methods \& Research}, year={2012}, volume={41}, number={1}, pages={124--167}, doi={10.1177/0049124112442138}}