Co to są AIC i BIC w SEM?
AIC (ang. Akaike information criterion, kryterium informacyjne Akaikego) i BIC (ang. Bayesian information criterion, bayesowskie kryterium informacyjne, nazywane też kryterium Schwarza) to liczby, które pozwalają wybrać jeden z kilku modeli dopasowanych do tych samych danych. Oba łączą dwie informacje: jak dobrze model odtwarza dane (log-wiarygodność) i ile ma swobodnych parametrów. Lepszy jest model o mniejszej wartości kryterium.
W modelowaniu równań strukturalnych AIC i BIC służą przede wszystkim do porównywania modeli konkurencyjnych: jedno-, dwu- i trzyczynnikowej struktury kwestionariusza w CFA, modeli ścieżkowych z różnym układem związków albo modeli mieszanin z różną liczbą klas. Same w sobie nie mówią, czy model dobrze pasuje do danych – tę ocenę dają CMIN oraz indeksy dopasowania, np. CFI i RMSEA. Wartość AIC = 8413 nie jest ani dobra, ani zła; znaczenie mają wyłącznie różnice między modelami.
Wzory: kara za każdy parametr
Akaike (1974) zaproponował, by zamiast serii testów istotności wybierać model o najmniejszej wartości
gdzie ln L to maksymalna log-wiarygodność modelu (z estymacji metodą największej wiarygodności), a k – liczba swobodnych parametrów. Schwarz (1978) wyprowadził kryterium z przybliżenia rozwiązania bayesowskiego; kara za parametr rośnie w nim z liczebnością próby:
Już przy N = 8 ln N przekracza 2, więc w każdej realnej próbie BIC karze za parametry mocniej niż AIC. Przy N = 300 jeden dodatkowy parametr kosztuje 2 punkty AIC, ale 5.70 punktu BIC. Programy podają też SABIC (BIC skorygowane o liczebność próby), w którym zamiast N wstawia się (N + 2)/24. Kara SABIC jest więc łagodna: przy 100 osobach mniejsza niż w AIC.
Programy różnią się stałą w definicji. lavaan i Mplus liczą AIC z log-wiarygodności, a AMOS jako CMIN + 2q. Bezwzględne wartości z dwóch programów nie są więc porównywalne. Różnice między modelami policzone w jednym programie są natomiast takie same, co pokazuje przykład niżej.
Jak czytać różnice ΔAIC i ΔBIC
Najpierw policz różnicę względem najlepszego modelu: Δi = AICi − AICmin. Model najlepszy ma Δ = 0. Przy AIC często przelicza się różnice na wagi Akaikego:
Wagi sumują się do 1 i opisują względne wsparcie modeli w porównywanym zbiorze. Burnham i Anderson (2004) wykorzystują je we wnioskowaniu wielomodelowym, w tym w uśrednianiu modeli. Przy BIC różnice odnosi się zwykle do skali siły świadectw. Raftery (1995) pokazuje, że BIC przybliża bayesowskie porównanie modeli, także niezagnieżdżonych (zob. czynnik Bayesa). Mała różnica, rzędu 1–2 punktów, oznacza, że dane słabo odróżniają modele. Wtedy decyduj na podstawie teorii, prostoty modelu i lokalnego dopasowania.
Przykład: ile czynników ma kwestionariusz wypalenia?
Trzystu studentów (dane symulowane) wypełniło 9 pozycji kwestionariusza wypalenia, po trzy na wyczerpanie, cynizm i obniżoną skuteczność. W populacji są trzy czynniki, ale wyczerpanie i cynizm korelują bardzo silnie. Porównano trzy modele CFA: jednoczynnikowy (M1), dwuczynnikowy z połączonym wyczerpaniem i cynizmem (M2) oraz trzyczynnikowy (M3).
| Model | k | χ²(df) | AIC | ΔAIC | Waga AIC | BIC | ΔBIC |
|---|---|---|---|---|---|---|---|
| M1: jeden czynnik | 18 | 140.08 (27) | 8516.92 | 103.55 | .00 | 8583.59 | 96.82 |
| M2: dwa czynniki | 19 | 37.55 (26) | 8416.39 | 3.03 | .18 | 8486.76 | 0.00 |
| M3: trzy czynniki | 21 | 30.53 (24) | 8413.36 | 0.00 | .82 | 8491.14 | 4.38 |
Oba kryteria jednoznacznie odrzucają model jednoczynnikowy. Między M2 a M3 wskazują jednak różne modele. M3 ma dwa parametry więcej (dwie dodatkowe korelacje czynników), a jego −2 ln L jest niższe o 7.03. To wystarcza, by pokonać karę AIC (2 × 2 = 4), ale nie karę BIC (2 × ln 300 = 11.41). Stąd ΔAIC = 7.03 − 4 = 3.03 na korzyść M3, a ΔBIC = 11.41 − 7.03 = 4.38 na korzyść M2. Ponieważ M2 jest zagnieżdżony w M3, można też wykonać test różnicy chi-kwadrat: Δχ²(2) = 7.03, p = .030. Wynik testu zgadza się z AIC.
Korelacja wyczerpania i cynizmu w M3 wynosi .91. Rozstrzygnięcie nie jest więc czysto statystyczne. Jeśli teoria przewiduje dwa odrębne wymiary, a mają one różnie korelować z innymi zmiennymi, zostań przy M3 i omów problem trafności różnicowej. Jeśli chcesz najprostszego opisu danych, BIC wskazuje M2. W raporcie pokaż oba kryteria i uzasadnij wybór.
AIC czy BIC? Wpływ liczebności próby
Rysunek 1 pokazuje, jak często każde kryterium wybierało prawdziwy model trzyczynnikowy zamiast prostszego dwuczynnikowego. Dane pochodziły z tej samej populacji, po 200 prób dla każdej liczebności.
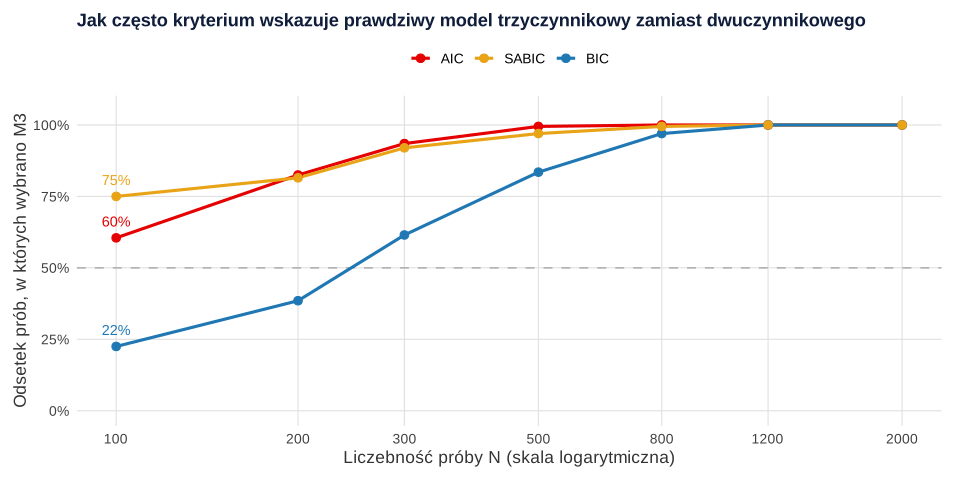
Przy 100 osobach BIC wybrał model trzyczynnikowy tylko w 22.5% prób, AIC w 60.5%, a SABIC w 75%. Przy 300 osobach odsetki wyniosły 61.5%, 93.5% i 92%, a od 1200 osób wszystkie kryteria wskazywały M3 zawsze. Ilustruje to różnicę opisaną przez Vrieze’a (2012). BIC jest zgodny: gdy prawdziwy model jest wśród kandydatów, przy rosnącej próbie wybiera go z prawdopodobieństwem dążącym do 1. AIC jest efektywny: gdy prawdziwego modelu w zbiorze nie ma, wybiera model o najmniejszym błędzie predykcji. Burnham i Anderson (2004) podkreślają, że wybór między kryteriami zależy od założeń o rzeczywistości i od celu analizy, a nie od sporu „bayesowskie kontra częstościowe”.
W praktyce przyjmij prostą regułę. Gdy testujesz teorię i chcesz uniknąć nadmiarowych parametrów, mocniej opieraj się na BIC. Gdy zależy ci na trafnej predykcji albo próba jest mała, a mniej oszczędny model jest teoretycznie uzasadniony, AIC jest mniej restrykcyjny. Przy wyborze liczby klas w modelach mieszanin, np. w analizie profili latentnych albo w FIMIX-PLS, BIC i jego odmiany uzupełnia się innymi kryteriami.
Jak opisać porównanie modeli w pracy (APA)
Napisz, jakie modele porównano i dlaczego. Podaj dla każdego modelu χ² z liczbą stopni swobody, wybrane indeksy dopasowania, AIC, BIC oraz różnice względem najlepszego modelu. Dodaj zdanie o tym, który model wybrano i na jakiej podstawie. Pełną tabelę dopasowania przygotujesz według wzoru tabeli dopasowania modelu CFA w APA.
AIC i BIC w R (lavaan)
Kod tworzy dane z przykładu, dopasowuje trzy modele CFA i zestawia log-wiarygodność, liczbę parametrów, AIC, BIC i SABIC. Liczy też różnice, wagi Akaikego, kary za parametry, AIC w konwencji AMOS i test różnicy chi-kwadrat. Liczby w tabeli i w opisie APA pochodzą z tego kodu. Rysunek 1 powstał z osobnej symulacji (skrypt rysunki-r98.R w folderze strony).
Porównanie modeli jedno-, dwu- i trzyczynnikowego
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 300 studentów, 9 pozycji kwestionariusza wypalenia studenckiego (skala 1–7).
# W populacji są trzy czynniki: wyczerpanie (w1–w3), cynizm (c1–c3) i obniżona skuteczność (s1–s3);
# wyczerpanie i cynizm korelują bardzo wysoko (.88).
set.seed(98)
pop <- '
  wyczerpanie =~ 0.75*w1 + 0.70*w2 + 0.70*w3
  cynizm      =~ 0.70*c1 + 0.65*c2 + 0.70*c3
  skutecznosc =~ 0.65*s1 + 0.60*s2 + 0.70*s3
  wyczerpanie ~~ 0.88*cynizm
  wyczerpanie ~~ 0.40*skutecznosc
  cynizm      ~~ 0.45*skutecznosc
'
z <- simulateData(pop, sample.nobs = 300, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.3 * x), 1), 7)))

# Trzy konkurencyjne modele dla tych samych dziewięciu pozycji
m1 <- 'wypalenie =~ w1 + w2 + w3 + c1 + c2 + c3 + s1 + s2 + s3'
m2 <- 'wyczerpanie_cynizm =~ w1 + w2 + w3 + c1 + c2 + c3
       skutecznosc        =~ s1 + s2 + s3'
m3 <- 'wyczerpanie =~ w1 + w2 + w3
       cynizm      =~ c1 + c2 + c3
       skutecznosc =~ s1 + s2 + s3'
fity <- list(M1_jeden = cfa(m1, dane), M2_dwa = cfa(m2, dane), M3_trzy = cfa(m3, dane))

# 1. Log-wiarygodność, liczba parametrów i kryteria informacyjne (lavaan: AIC = −2logL + 2k, BIC = −2logL + k·ln N)
tab <- t(sapply(fity, fitMeasures, c("logl", "npar", "chisq", "df", "aic", "bic", "bic2")))
round(tab, 2)

# 2. Różnice względem najlepszego modelu i wagi Akaikego
d_aic <- tab[, "aic"] - min(tab[, "aic"])
d_bic <- tab[, "bic"] - min(tab[, "bic"])
w_aic <- exp(-d_aic / 2) / sum(exp(-d_aic / 2))
round(cbind(dAIC = d_aic, dBIC = d_bic, waga_AIC = w_aic), 3)

# 3. Ręczne sprawdzenie dla M3: kara za parametry
k <- tab["M3_trzy", "npar"]; N <- nobs(fity$M3_trzy)
c(AIC_recznie = -2 * tab["M3_trzy", "logl"] + 2 * k, BIC_recznie = -2 * tab["M3_trzy", "logl"] + k * log(N),
  kara_AIC = 2 * k, kara_BIC = k * log(N))

# 4. AIC w stylu AMOS (CMIN + 2q) różni się od lavaan o stałą, ale różnice między modelami są te same
aic_amos <- tab[, "chisq"] + 2 * tab[, "npar"]
round(rbind(AIC_lavaan = tab[, "aic"] - tab["M3_trzy", "aic"], AIC_amos = aic_amos - aic_amos["M3_trzy"]), 2)

# 5. Dla porównania: test różnicy chi-kwadrat dla modeli zagnieżdżonych M2 i M3
anova(fity$M2_dwa, fity$M3_trzy)
lavInspect(fity$M3_trzy, "cor.lv")
Wynik w R
             logl npar  chisq df     aic     bic    bic2
M1_jeden -4240.46   18 140.08 27 8516.92 8583.59 8526.50
M2_dwa   -4189.20   19  37.55 26 8416.39 8486.76 8426.51
M3_trzy  -4185.68   21  30.53 24 8413.36 8491.14 8424.54
            dAIC   dBIC waga_AIC
M1_jeden 103.554 96.824     0.00
M2_dwa     3.026  0.000     0.18
M3_trzy    0.000  4.381     0.82
AIC_recznie BIC_recznie    kara_AIC    kara_BIC
  8413.3642   8491.1437     42.0000    119.7794
           M1_jeden M2_dwa M3_trzy
AIC_lavaan   103.55   3.03       0
AIC_amos     103.55   3.03       0

Chi-Squared Difference Test

             Df    AIC    BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
fity$M3_trzy 24 8413.4 8491.1 30.527
fity$M2_dwa  26 8416.4 8486.8 37.554     7.0263 0.091527       2     0.0298 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            wyczrp cynizm sktczn
wyczerpanie  1.000
cynizm       0.905  1.000
skutecznosc  0.367  0.325  1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie modeli dopasowanych do różnych danych. AIC i BIC można porównywać tylko dla tych samych obserwacji i tych samych zmiennych. Usunięcie pozycji z modelu albo inna liczba osób po wykluczeniu braków danych przekreśla porównanie.
- Interpretowanie pojedynczej wartości. AIC = 8413 nic nie mówi o jakości modelu. Liczą się tylko różnice, a do oceny dopasowania potrzebujesz χ², CFI, RMSEA i SRMR.
- Mieszanie programów. AIC z AMOS i z lavaan różnią się o stałą, więc nie zestawiaj wartości z dwóch narzędzi w jednej tabeli.
- Wybór „najmniejszego AIC” bez teorii. Różnica 2–3 punktów to słabe rozstrzygnięcie. Dopasowanie wielu wariantów i raportowanie najlepszego to eksploracja, którą trzeba tak nazwać.
- Brak informacji, którego kryterium użyto. AIC i BIC mogą wskazać różne modele (jak w przykładzie), dlatego podawaj oba i uzasadnij decyzję.
- Porównywanie modeli z różnymi estymatorami. AIC i BIC wymagają log-wiarygodności. Przy estymatorach takich jak WLSMV nie są dostępne.
Pełny przebieg analizy, od specyfikacji do raportu, znajdziesz w poradnikach CB-SEM krok po kroku i analiza czynnikowa EFA i CFA.
Najczęstsze pytania
Czy niższe AIC zawsze oznacza lepszy model SEM?
Niższe AIC oznacza lepszy kompromis między dopasowaniem a liczbą parametrów, ale tylko w porównaniu z innymi modelami dopasowanymi do tych samych danych. Różnica 1–3 punktów to słabe rozstrzygnięcie, a najlepszy model w zbiorze może nadal źle pasować do danych – sprawdź χ², CFI, RMSEA i SRMR.
Dlaczego AIC i BIC wskazują różne modele?
BIC karze każdy parametr kwotą ln N, a AIC kwotą 2, więc przy N = 300 dodatkowy parametr kosztuje w BIC prawie trzy razy więcej. Gdy bogatszy model poprawia dopasowanie umiarkowanie, AIC go wybierze, a BIC odrzuci. Podaj oba kryteria i rozstrzygnij na podstawie teorii i celu analizy.
Czy AIC i BIC nadają się do porównania modeli niezagnieżdżonych?
Tak – to ich główna przewaga nad testem różnicy chi-kwadrat, który wymaga modeli zagnieżdżonych. Warunek jest jeden: oba modele muszą być dopasowane do tych samych obserwacji i tych samych zmiennych, tą samą metodą estymacji opartą na wiarygodności.
Czym jest SABIC w wynikach lavaan i Mplus?
SABIC to BIC skorygowane o liczebność próby: zamiast ln N stosuje karę ln((N + 2)/24). Kara jest więc dużo łagodniejsza niż w BIC, a przy małych próbach nawet łagodniejsza niż w AIC. W lavaan SABIC występuje jako bic2.
Jak policzyć wagi Akaikego?
Dla każdego modelu oblicz ΔAIC względem najlepszego modelu, a następnie exp(−ΔAIC/2) i podziel przez sumę tych wartości dla wszystkich modeli. Wagi sumują się do 1 i opisują względne wsparcie modeli w porównywanym zbiorze, np. .82 dla modelu trzyczynnikowego i .18 dla dwuczynnikowego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/tac.1974.1100705 ● Otwarty dostęp: pełny tekst
- Burnham, K. P., & Anderson, D. R. (2004). Multimodel inference: Understanding AIC and BIC in model selection. Sociological Methods & Research, 33(2), 261–304. https://doi.org/10.1177/0049124104268644
- Raftery, A. E. (1995). Bayesian model selection in social research. Sociological Methodology, 25, 111. https://doi.org/10.2307/271063
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136 ● Otwarty dostęp
- Vrieze, S. I. (2012). Model selection and psychological theory: A discussion of the differences between the Akaike information criterion (AIC) and the Bayesian information criterion (BIC). Psychological Methods, 17(2), 228–243. https://doi.org/10.1037/a0027127 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{akaike1974new, author={Akaike, H.}, title={{A new look at the statistical model identification}}, journal={IEEE Transactions on Automatic Control}, year={1974}, volume={19}, number={6}, pages={716--723}, doi={10.1109/tac.1974.1100705}}@article{burnham2004multimodel, author={Burnham, Kenneth P. and Anderson, David R.}, title={{Multimodel inference: Understanding AIC and BIC in model selection}}, journal={Sociological Methods \& Research}, year={2004}, volume={33}, number={2}, pages={261--304}, doi={10.1177/0049124104268644}}@article{raftery1995bayesian, author={Raftery, Adrian E.}, title={{Bayesian model selection in social research}}, journal={Sociological Methodology}, year={1995}, volume={25}, pages={111}, doi={10.2307/271063}}@article{schwarz1978estimating, author={Schwarz, Gideon}, title={{Estimating the dimension of a model}}, journal={The Annals of Statistics}, year={1978}, volume={6}, number={2}, pages={461--464}, doi={10.1214/aos/1176344136}}@article{vrieze2012model, author={Vrieze, Scott I.}, title={{Model selection and psychological theory: A discussion of the differences between the Akaike information criterion (AIC) and the Bayesian information criterion (BIC)}}, journal={Psychological Methods}, year={2012}, volume={17}, number={2}, pages={228--243}, doi={10.1037/a0027127}}