Co to jest kowariancja reszt w SEM?
Kowariancja reszt (skorelowane błędy, ang. correlated residuals, correlated errors) to parametr modelu SEM, który dopuszcza związek między częściami dwóch zmiennych niewyjaśnionymi przez model. W modelu pomiarowym chodzi o reszty dwóch wskaźników: tę część odpowiedzi na pozycję, której nie wyjaśnia czynnik. W części strukturalnej chodzi o zakłócenia dwóch zmiennych endogenicznych. Standardowy model CFA zakłada, że reszty są nieskorelowane: wszystko, co łączy pozycje, przechodzi przez czynniki. Kowariancja reszt mówi, że dwie pozycje mają jeszcze inne wspólne źródło – na przykład wspólne sformułowanie, kierunek kodowania albo ten sam pomiar powtórzony w czasie.
W składni lavaan zapisuje się ją operatorem ~~ (Rosseel, 2012), np. n1 ~~ n2. Na wykresie ścieżkowym to dwustronna strzałka łącząca reszty dwóch wskaźników.
Kiedy kowariancja reszt jest uzasadniona?
Cole i in. (2007) zauważają, że skorelowane reszty bywają traktowane jak „sztuczka” albo wręcz oszustwo. Badacze dopuszczają ich więc tylko tyle, ile trzeba do dobrego dopasowania. Autorzy pokazują, że to prowadzi do pomijania korelacji uzasadnionych teorią pomiaru i schematem badania. Ich brak może niewiele pogorszyć dopasowanie, a mimo to zmienić znaczenie zmiennych latentnych. Uzasadnione sytuacje to:
- ta sama pozycja w kolejnych pomiarach – specyfika pozycji powraca u tych samych osób (zob. inwariancja pomiaru w CB-SEM);
- wspólna metoda – pozycje odwrócone, ten sam informator (np. rodzic ocenia kilka cech dziecka), ten sam format odpowiedzi (zob. wspólna wariancja metody);
- pozycje o niemal identycznej treści albo pozycje zależne logicznie (odpowiedź na jedną ogranicza drugą);
- zakłócenia w modelu strukturalnym, gdy dwie zmienne zależne mają wspólną przyczynę, której nie ma w modelu.
Nieuzasadnione są kowariancje dodawane tylko dlatego, że indeks modyfikacji jest wysoki. MacCallum i in. (1992) pokazali, że modyfikacje oparte na danych często nie powtarzają się w innych próbach. Najlepiej, gdy lista kowariancji reszt powstaje przed analizą, na podstawie budowy narzędzia i schematu badania.
Kowariancja zakłóceń w części strukturalnej
W części strukturalnej modelu SEM kowariancja dotyczy zakłóceń dwóch zmiennych endogenicznych, np. lęku i obniżonego nastroju przewidywanych przez stres. Model bez niej zakłada, że po uwzględnieniu predyktorów obie zmienne nie mają już nic wspólnego. To założenie rzadko jest prawdziwe, bo zwykle istnieje zmienna zakłócająca spoza modelu. Kowariancja zakłóceń przyznaje więc, że model nie zawiera wszystkich przyczyn. W modelach podłużnych standardem są kowariancje zakłóceń zmiennych mierzonych w tym samym czasie, np. w modelach cross-lagged. Uwaga: kowariancja zakłóceń dwóch zmiennych, między którymi jest też ścieżka, może sprawić, że model stanie się nierekurencyjny i trudniejszy do zidentyfikowania.
Przykład: pozycje odwrócone w skali samooceny
500 osób (dane symulowane) wypełniło 10-pozycyjną skalę samooceny (1–4). Pięć pozycji jest sformułowanych pozytywnie (p1–p5), a pięć negatywnie (n1–n5, przekodowanych przed analizą). W populacji jest jeden czynnik samooceny, ale pozycje negatywne dzielą dodatkowo efekt metody, np. trudność z podwójnym przeczeniem. Marsh (1996) opisał właśnie taki wzór w skali samooceny Rosenberga. Odpowiedzi lepiej opisywał jeden czynnik z efektami metody dla pozycji negatywnych niż dwa odrębne czynniki samooceny pozytywnej i negatywnej.
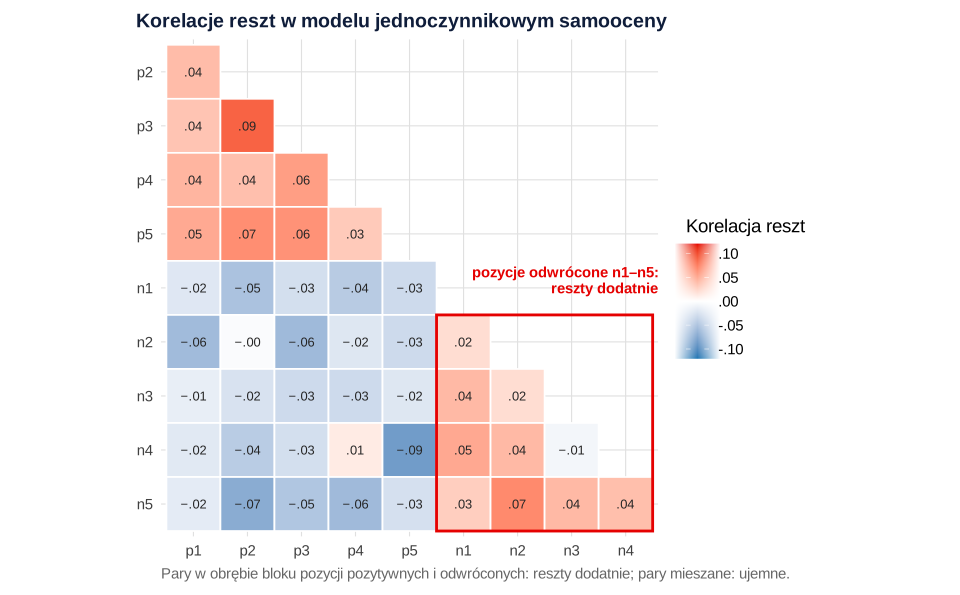
Model jednoczynnikowy bez kowariancji reszt jest dopasowany przeciętnie: χ²(35) = 102.75, p < .001, CFI = .960, RMSEA = .062. Reszty układają się w wyraźny wzór (rysunek 1). Pary w obrębie pozycji negatywnych i w obrębie pozytywnych mają reszty dodatnie (średnio .035 i .052), a pary mieszane – ujemne (średnio −.034). Jeden czynnik jest więc kompromisem między dwoma blokami.
Porównano cztery modele:
| Model | χ²(df) | CFI | RMSEA | SRMR | BIC |
|---|---|---|---|---|---|
| (a) Jeden czynnik | 102.75 (35) | .960 | .062 | .040 | 10022.16 |
| (b) Jeden czynnik + 10 kowariancji reszt pozycji n1–n5 | 21.63 (25) | 1.000 | .000 | .016 | 10003.18 |
| (c) Jeden czynnik + ortogonalny czynnik metody (n1–n5) | 26.47 (30) | 1.000 | .000 | .018 | 9976.94 |
| (d) Dwa czynniki: pozytywna i negatywna samoocena | 29.04 (34) | 1.000 | .000 | .019 | 9954.66 |
Dodanie dziesięciu kowariancji reszt istotnie poprawiło model, Δχ²(10) = 81.13, p < .001. Korelacje reszt wyniosły od .14 do .30. Najważniejsze są jednak zmiany w pozostałych parametrach:
- Ładunki pozycji negatywnych spadły z .64–.69 w modelu (a) do .55–.60 w modelu (b). W modelu (a) czynnik „samooceny” wchłaniał część wariancji metody.
- Rzetelność wyniku ogólnego była zawyżona. Omega wyniosła .876 w modelu (a), ale .781 w modelu (b) i .806 w modelu (c), które oddzielają wariancję metody od samooceny.
- Dwa czynniki to inna interpretacja tych samych danych. Model (d) jest dobrze dopasowany i ma najniższy BIC, a czynniki korelują .83. Dopasowanie nie rozstrzyga, czy mamy „dwie samooceny”, czy jedną z efektem metody. Decyduje teoria i to, czy czynniki różnie łączą się z innymi zmiennymi (Marsh, 1996).
Kowariancje reszt (model b) i czynnik metody (model c) opisują to samo zjawisko na dwa sposoby. Kowariancje są elastyczniejsze, bo każda para ma własną wartość, ale kosztują więcej stopni swobody. Czynnik metody jest oszczędniejszy i daje wprost wielkość efektu metody.
Jak opisać kowariancje reszt w pracy (APA)
Napisz, które reszty skorelowano, z jakiego powodu i czy decyzję podjęto przed analizą. Podaj zakres oszacowań i wpływ na dopasowanie. Wzór:
Szerszy kontekst – jak włączyć takie decyzje w ocenę modelu pomiarowego – daje poradnik CB-SEM krok po kroku. O tym, jak pozycje odwrócone wpływają na rzetelność, piszemy we wpisie alfa Cronbacha: jak oceniać rzetelność skali.
Przykład w R
Kod tworzy dane z przykładu i szacuje cztery modele. Wypisuje korelacje reszt modelu jednoczynnikowego, oszacowania kowariancji reszt, zmiany ładunków, korelację czynników w modelu dwuczynnikowym i omegę w trzech modelach.
Kowariancje reszt i czynnik metody w lavaan
R
# Kowariancja reszt w SEM: efekt pozycji odwróconych w skali samooceny (lavaan)
library(lavaan)

# Dane symulowane: 500 osób, 10 pozycji (1–4): p1–p5 sformułowane pozytywnie, n1–n5 negatywnie
# (już przekodowane). Pozycje negatywne dzielą wspólny efekt metody – źródło skorelowanych reszt.
set.seed(115)
n <- 500
samoocena <- rnorm(n); metoda <- rnorm(n)
lp <- c(.75, .70, .72, .68, .70); ln <- c(.65, .62, .66, .60, .63); lm_ <- c(.40, .45, .38, .42, .40)
P <- sapply(lp, function(l) l * samoocena + sqrt(1 - l^2) * rnorm(n))
N <- sapply(seq_along(ln), function(j) ln[j] * samoocena + lm_[j] * metoda + sqrt(1 - ln[j]^2 - lm_[j]^2) * rnorm(n))
dane <- as.data.frame(pmin(pmax(round(2.9 + 0.75 * cbind(P, N)), 1), 4))
names(dane) <- c(paste0("p", 1:5), paste0("n", 1:5))

poz <- "p1 + p2 + p3 + p4 + p5"; neg <- "n1 + n2 + n3 + n4 + n5"
m_a <- paste("S =~", poz, "+", neg)
# (b) jeden czynnik + kowariancje reszt wszystkich par pozycji negatywnych (10 par)
pary <- combn(paste0("n", 1:5), 2)
m_b <- paste(m_a, paste(pary[1, ], "~~", pary[2, ], collapse = "\n"), sep = "\n")
# (c) jeden czynnik + ortogonalny czynnik metody dla pozycji negatywnych
m_c <- paste(m_a, paste("M =~", neg), "S ~~ 0*M", sep = "\n")
# (d) dwa czynniki: "pozytywna" i "negatywna" samoocena
m_d <- paste("POZ =~", poz, "\nNEG =~", neg)

fa <- cfa(m_a, data = dane); fb <- cfa(m_b, data = dane); fc <- cfa(m_c, data = dane); fd <- cfa(m_d, data = dane)
miary <- c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr", "bic")
round(rbind(a_jeden = fitMeasures(fa, miary), b_kow_reszt = fitMeasures(fb, miary),
            c_metoda = fitMeasures(fc, miary), d_dwa = fitMeasures(fd, miary)), 3)
lavTestLRT(fb, fa)

# Korelacje reszt w modelu (a): blok pozycji negatywnych
R <- lavResiduals(fa, type = "cor")$cov
round(R[6:10, 6:10], 2)
round(c(srednia_reszta_neg = mean(R[6:10, 6:10][lower.tri(diag(5))]),
        srednia_reszta_poz = mean(R[1:5, 1:5][lower.tri(diag(5))]),
        srednia_reszta_poz_neg = mean(R[6:10, 1:5])), 3)
saveRDS(R, "reszty-model-a.rds")

# Standaryzowane kowariancje (korelacje) reszt w modelu (b)
sb <- standardizedSolution(fb)
kr <- sb[sb$op == "~~" & sb$lhs != sb$rhs, c("lhs", "rhs", "est.std")]
round(range(kr$est.std), 2)
# Ładunki pozycji negatywnych: model (a) vs (b); korelacja czynników w modelu (d)
la <- standardizedSolution(fa); lb <- sb
round(cbind(a = la$est.std[la$op == "=~"][6:10], b = lb$est.std[lb$op == "=~"][6:10]), 2)
sd_ <- standardizedSolution(fd); round(sd_[sd_$lhs == "POZ" & sd_$rhs == "NEG", "est.std"], 2)
# Rzetelność omega wyniku ogólnego: model (a) traktuje wariancję metody jako wariancję samooceny
omega <- function(f, czynnik = "S") {
  e <- lavInspect(f, "std"); l <- e$lambda[, czynnik]; Th <- e$theta
  sum(l)^2 / (sum(l)^2 + sum(Th) + if (ncol(e$lambda) > 1) sum(e$lambda[, -which(colnames(e$lambda) == czynnik)])^2 else 0)
}
round(c(omega_model_a = omega(fa), omega_model_b = omega(fb), omega_model_c = omega(fc)), 3)
Wynik w R
              chisq df pvalue  cfi   tli rmsea  srmr       bic
a_jeden     102.753 35  0.000 0.96 0.949 0.062 0.040 10022.157
b_kow_reszt  21.625 25  0.657 1.00 1.004 0.000 0.016 10003.175
c_metoda     26.466 30  0.651 1.00 1.003 0.000 0.018  9976.943
d_dwa        29.041 34  0.709 1.00 1.004 0.000 0.019  9954.659

Chi-Squared Difference Test

   Df    AIC   BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fb 25 9876.7 10003  21.625
fa 35 9937.9 10022 102.753     81.129 0.11927      10  3.016e-13 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
     n1   n2    n3    n4   n5
n1 0.00 0.02  0.04  0.05 0.03
n2 0.02 0.00  0.02  0.04 0.07
n3 0.04 0.02  0.00 -0.01 0.04
n4 0.05 0.04 -0.01  0.00 0.04
n5 0.03 0.07  0.04  0.04 0.00
    srednia_reszta_neg     srednia_reszta_poz srednia_reszta_poz_neg
                 0.035                  0.052                 -0.034
[1] 0.14 0.30
        a    b
[1,] 0.66 0.57
[2,] 0.69 0.59
[3,] 0.68 0.60
[4,] 0.64 0.55
[5,] 0.68 0.57
[1] 0.83
omega_model_a omega_model_b omega_model_c
        0.876         0.781         0.806
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Dodawanie kowariancji reszt po kolei według indeksów modyfikacji, aż CFI przekroczy .95. Model staje się dopasowany do próby, a nie do teorii.
- Pomijanie kowariancji wynikających ze schematu badania, np. tej samej pozycji w kolejnych pomiarach. Cole i in. (2007) pokazują, że ich brak zmienia znaczenie czynników, nawet gdy dopasowanie jest dobre.
- Kowariancje reszt między pozycjami różnych czynników bez uzasadnienia. Taka kowariancja może maskować ładunek krzyżowy albo brak trafności różnicowej.
- Brak informacji w raporcie. Czytelnik musi wiedzieć, które reszty skorelowano i dlaczego. Bez tego nie oceni, czy model jest konfirmacyjny.
- Zbyt wiele kowariancji przy małej liczbie wskaźników. Każda zabiera stopień swobody i może zagrozić identyfikacji modelu.
- Ignorowanie wpływu na rzetelność. Gdy reszty są skorelowane, omega z modelu bez tych kowariancji przeszacowuje rzetelność (w przykładzie .876 zamiast .781).
Najczęstsze pytania
Kiedy można skorelować reszty w modelu CFA?
Gdy masz uzasadnienie niezależne od danych: ta sama pozycja w kolejnych pomiarach, wspólna metoda (pozycje odwrócone, ten sam informator), niemal identyczne sformułowanie albo logiczna zależność odpowiedzi. Najlepiej zaplanuj takie kowariancje przed analizą i opisz je w części metodologicznej.
Jak zapisać kowariancję reszt w lavaan?
Operatorem ~~ między dwiema zmiennymi obserwowalnymi, np. n1 ~~ n2, dodanym do składni modelu. Dla wielu par możesz zbudować linie automatycznie, np. funkcją combn(). Wynik standaryzowany (korelację reszt) odczytasz z standardizedSolution().
Czy kowariancja reszt to oszustwo w SEM?
Nie, jeśli wynika z budowy narzędzia lub schematu badania – wtedy jej pominięcie jest błędem specyfikacji, który zmienia znaczenie czynników. Problemem są kowariancje dodawane wyłącznie po to, by poprawić wskaźniki dopasowania, bo zwykle nie powtarzają się w innych próbach.
Co lepsze przy pozycjach odwróconych: kowariancje reszt czy czynnik metody?
Oba sposoby opisują efekt metody. Kowariancje reszt są elastyczniejsze, bo każda para ma własną wartość, ale zużywają więcej stopni swobody (10 dla pięciu pozycji). Czynnik metody jest oszczędniejszy i pozwala wprost oszacować wielkość efektu metody. W przykładzie na tej stronie oba modele były dobrze dopasowane.
Jak kowariancje reszt wpływają na rzetelność skali?
Jeśli reszty są skorelowane, a model tego nie uwzględnia, wspólna wariancja metody jest liczona jako wariancja konstruktu i rzetelność wychodzi zawyżona. W przykładzie na tej stronie omega wyniku ogólnego wynosi .876 bez kowariancji reszt, a .781 po ich uwzględnieniu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cole, D. A., Ciesla, J. A., & Steiger, J. H. (2007). The insidious effects of failing to include design-driven correlated residuals in latent-variable covariance structure analysis. Psychological Methods, 12(4), 381–398. https://doi.org/10.1037/1082-989x.12.4.381
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
- Marsh, H. W. (1996). Positive and negative global self-esteem: A substantively meaningful distinction or artifactors? Journal of Personality and Social Psychology, 70(4), 810–819. https://doi.org/10.1037/0022-3514.70.4.810
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
Cytowania BibTeX
@article{cole2007insidious, author={Cole, David A. and Ciesla, Jeffrey A. and Steiger, James H.}, title={{The insidious effects of failing to include design-driven correlated residuals in latent-variable covariance structure analysis}}, journal={Psychological Methods}, year={2007}, volume={12}, number={4}, pages={381--398}, doi={10.1037/1082-989x.12.4.381}}@article{maccallum1992model, author={MacCallum, Robert C. and Roznowski, Mary and Necowitz, Lawrence B.}, title={{Model modifications in covariance structure analysis: The problem of capitalization on chance}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={3}, pages={490--504}, doi={10.1037/0033-2909.111.3.490}}@article{marsh1996positive, author={Marsh, Herbert W.}, title={{Positive and negative global self-esteem: A substantively meaningful distinction or artifactors?}}, journal={Journal of Personality and Social Psychology}, year={1996}, volume={70}, number={4}, pages={810--819}, doi={10.1037/0022-3514.70.4.810}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}