cfa(), MLR, missing = "fiml"), ocena globalnego i lokalnego dopasowania z udokumentowanymi modyfikacjami, model strukturalny z etykietami i parametrami := oraz bootstrapowy przedział efektu pośredniego. W przykładzie (N = 420) efekt pośredni samowspółczucia przez ruminację wyniósł −0.203, 95% CI [−0.299, −0.126], a ścieżka bezpośrednia była nieistotna. W lavaan 0.7 klasyczny GFI to gfi_lisrel.Przykład: samowspółczucie, ruminacja i objawy depresyjne
Ten poradnik prowadzi przez kompletną analizę CB-SEM w pakiecie lavaan (Rosseel, 2012) w wersji 0.7: od wczytania danych, przez model pomiarowy i strukturalny, po efekt pośredni z bootstrapem i tabelę w stylu APA. Decyzje, które tu podejmujemy (estymator, ocena dopasowania, modyfikacje), uzasadniamy szerzej w przewodniku CB-SEM – założenia i interpretacja. Jeśli dopiero poznajesz tę rodzinę metod, zacznij od tekstu modelowanie równań strukturalnych (SEM).
Przykład (dane symulowane): 420 studentów wypełniło trzy kwestionariusze z odpowiedziami na skali 1–5: samowspółczucie (SW, 4 pozycje), ruminację (RU, 4 pozycje) i objawy depresyjne (DE, 5 pozycji). Hipoteza zakłada, że wyższe samowspółczucie wiąże się z mniejszą skłonnością do ruminacji, a ruminacja – z większym nasileniem objawów depresyjnych. Interesuje nas więc efekt pośredni samowspółczucia przez ruminację, a także ścieżka bezpośrednia. Dane możesz pobrać i powtórzyć wszystkie obliczenia: cb-sem-w-r-lavaan-dane.csv (420 wierszy, 13 kolumn, braki zapisane jako puste komórki).
Przed modelem obejrzyj dane. Średnie pozycji wynosiły od 2.97 do 3.19, skośność od −0.17 do 0.05, a kurtoza od −0.89 do −0.60, więc rozkłady są w przybliżeniu symetryczne, ale – jak zawsze przy pięciu kategoriach – nieciągłe. Braki stanowiły 4.0% wszystkich odpowiedzi, ale kompletne dane miało tylko 249 z 420 osób. Usunięcie pozostałych (tzw. listwise deletion) oznaczałoby utratę 41% próby. Dlatego użyjemy pełnej informacji największej wiarygodności (FIML), która w symulacjach Endersa i Bandalosa (2001) dawała przy brakach MCAR i MAR nieobciążone i efektywniejsze oszacowania niż usuwanie przypadków. O mechanizmach braków przeczytasz w haśle braki danych MCAR, MAR i MNAR.
Składnia lavaan w pięciu operatorach
Model w lavaan zapisujesz jako tekst. Wystarczy pięć operatorów:
| Operator | Znaczenie | Przykład |
|---|---|---|
=~ | zmienna ukryta jest mierzona przez wskaźniki | SW =~ sw1 + sw2 + sw3 + sw4 |
~ | regresja (ścieżka strukturalna) | DE ~ RU + SW |
~~ | wariancja lub kowariancja (także reszt) | ru3 ~~ ru4 |
a* | etykieta parametru | RU ~ a*SW |
:= | nowy parametr zdefiniowany przez etykiety | posredni := a*b |
Domyślnie cfa() i sem() ustalają ładunek pierwszego wskaźnika każdego czynnika na 1 (skalowanie czynnika), korelują czynniki egzogeniczne i szacują wariancje reszt. Przy missing = "fiml" model obejmuje też średnie, dlatego liczba informacji to 13 średnich plus 91 wariancji i kowariancji, czyli 104. Jak liczy się takie bilanse, wyjaśnia hasło identyfikacja modelu SEM.
Krok 1. Model pomiarowy (CFA)
Zgodnie z podejściem dwuetapowym najpierw sprawdzamy, czy pozycje mierzą trzy konstrukty, a dopiero potem dodajemy ścieżki. Model pomiarowy to konfirmacyjna analiza czynnikowa z trzema skorelowanymi czynnikami. Używamy estymatora MLR: przy pięciu kategoriach odpowiedzi i w przybliżeniu symetrycznych rozkładach odporny ML dobrze odtwarza strukturę (Rhemtulla i in., 2012), a w lavaan łączy się z FIML. Przy pozycjach z dwiema–czterema kategoriami wybierz WLSMV.
Pierwsze dwie linie wyniku (TRUE, TRUE) potwierdzają, że model się zbiegł i rozwiązanie jest dopuszczalne – nie ma ujemnych wariancji ani korelacji większych od 1. Zawsze sprawdzaj to przed czytaniem indeksów. Wyjściowy model pomiarowy miał 42 parametry i 62 stopnie swobody:
- przeskalowany test χ²(62) = 111.19, p < .001 – model nie odtwarza danych dokładnie;
- CFI = .975, TLI = .969, RMSEA = .045, 90% CI [.031, .059], SRMR = .034 – indeksy przybliżonego dopasowania w zakresach uznawanych za dobre.
Nie kończ jednak na indeksach. Istotny χ² to sygnał, by poszukać źródła niedopasowania. Największy indeks modyfikacji dotyczył kowariancji reszt pozycji ru3 i ru4 (MI = 43.16, standaryzowana oczekiwana zmiana parametru .50), a największa reszta korelacyjna (.099) – tej samej pary. Saris i in. (2009) zalecają oceniać MI razem z oczekiwaną zmianą parametru, bo sam MI rośnie z liczebnością próby. Tu oba wskaźniki są duże, a treść pozycji daje uzasadnienie: obie dotyczą rozmyślania przed snem, więc mają wspólne źródło wariancji niezwiązane z ruminacją jako cechą. Cole i in. (2007) pokazują, że pomijanie kowariancji reszt wynikających z budowy narzędzia zmienia znaczenie zmiennych ukrytych, nawet gdy dopasowanie pogarsza się niewiele.
Po dodaniu ru3 ~~ ru4 model był dobrze dopasowany: χ²(61) = 71.29, p = .173, CFI = .995, TLI = .994, RMSEA = .020, 90% CI [.000, .039], SRMR = .030. Przeskalowany test różnicy, liczony przez lavTestLRT() metodą Satorry–Bentlera, potwierdził poprawę: Δχ²(1) = 44.67, p < .001. Drugi w kolejności MI (ru1 i ru2, MI = 25.25) nie miał podobnego uzasadnienia treściowego, więc go nie uwolniliśmy. Modyfikacja oparta na danych musi znaleźć się w raporcie razem z modelem wyjściowym; więcej o zasadach w haśle kowariancja reszt w SEM.
Uwaga o GFI w lavaan 0.7. W wyniku widzisz dwa indeksy: gfi = .982 i gfi_lisrel = .994 (w modelu wyjściowym). Klasyczny GFI znany z AMOS i LISREL to w tej wersji gfi_lisrel. Nowy gfi realizuje propozycję Maydeu-Olivaresa i in. (2024), którzy traktują GFI jak odsetek wyjaśnionej wariancji – podobnie do R² w regresji – szacują go z przedziałem ufności i zalecają używać go do oceny użyteczności modelu, a nie do odróżniania modeli dobrze i źle dopasowanych. Jeśli recenzent prosi o GFI, podaj, którą wersję raportujesz (zob. hasło GFI).
Krok 2. Ładunki, rzetelność i trafność
Dopasowanie to dopiero połowa oceny modelu pomiarowego. Druga połowa to wielkość ładunków, rzetelność i trafność różnicowa. Standaryzowane wyniki uzyskasz funkcją standardizedSolution(), omegę – funkcją compRelSEM(), a AVE – funkcją AVE() z pakietu semTools.
| Skala | Ładunki standaryzowane | Omega | AVE |
|---|---|---|---|
| Samowspółczucie (SW) | .58–.72 | .749 | .429 |
| Ruminacja (RU) | .64–.85 | .805 | .565 |
| Objawy depresyjne (DE) | .70–.83 | .866 | .563 |
Wszystkie ładunki przekraczają .50, a omega mieści się między .749 a .866. AVE samowspółczucia (.429) jest jednak niższa od często cytowanego progu .50. Cheung i in. (2024) krytykują mechaniczne stosowanie tego progu, bo AVE ignoruje błąd próbkowania, i zalecają ocenę rzetelności oraz trafności zbieżnej i różnicowej kilkoma kryteriami, z przedziałami ufności. W raporcie podaj AVE, ale opieraj wniosek na całości: ładunkach z przedziałami ufności (najniższy, sw4: .58, 95% CI [.50, .66]), omedze i treści pozycji.
Korelacje czynników wynosiły: SW–RU −.41, 95% CI [−.51, −.30], SW–DE −.29, 95% CI [−.40, −.19], i RU–DE .50, 95% CI [.41, .59]. Żaden przedział nie zbliża się do 1, więc konstrukty są wyraźnie rozróżnialne (zob. trafność różnicowa i wskaźnik HTMT).
Krok 3. Model strukturalny i efekt pośredni
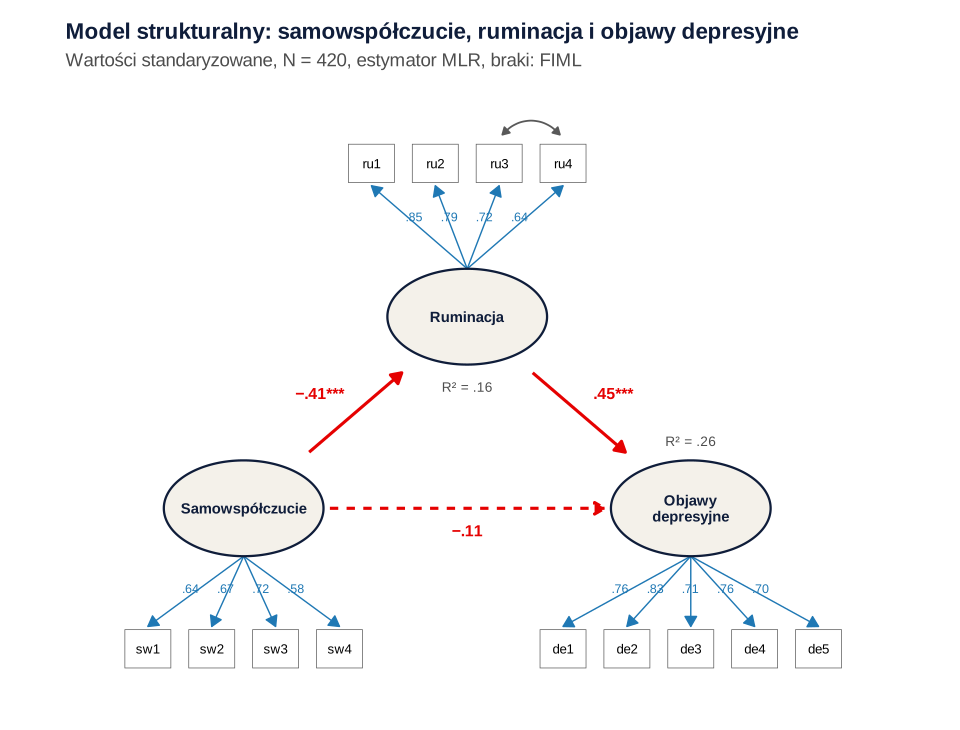
Model strukturalny powstaje z pomiarowego przez zastąpienie korelacji czynników ścieżkami. Ścieżkom nadajemy etykiety a, b i c, a efekt pośredni i całkowity definiujemy operatorem :=. Ponieważ część strukturalna jest nasycona (trzy ścieżki zastępują trzy korelacje), dopasowanie jest identyczne jak w modelu pomiarowym po modyfikacji: χ²(61) = 71.29, CFI = .995, RMSEA = .020.
Wyniki ścieżek (estymator MLR):
- a: samowspółczucie → ruminacja: b = −0.532, SE = 0.088, p < .001, β = −.41. Samowspółczucie wyjaśnia 16.5% wariancji ruminacji.
- b: ruminacja → objawy depresyjne: b = 0.382, SE = 0.056, p < .001, β = .45.
- c′: ścieżka bezpośrednia: b = −0.117, SE = 0.068, p = .085, β = −.11. Model wyjaśnia 25.7% wariancji objawów depresyjnych.
- Efekt pośredni ab: −0.203, SE = 0.044 (metoda delta), 95% CI [−0.289, −0.117]; standaryzowany −.185.
Czy ścieżkę bezpośrednią można usunąć? Model bez niej nie był istotnie gorszy, Δχ²(1) = 3.16, p = .075, ale kryteria informacyjne nie wskazały jednoznacznie zwycięzcy: AIC był minimalnie niższy dla modelu pełnego (14159.6 wobec 14160.4), a BIC – dla modelu bez ścieżki (14330.1 wobec 14333.3). W takiej sytuacji zostaw model zgodny z hipotezą i nie ogłaszaj „mediacji całkowitej”: brak istotności ścieżki c′ nie dowodzi, że jest zerowa, a przedział dla niej obejmuje zarówno zero, jak i umiarkowane wartości ujemne. Terminologię wyjaśniają hasła mediacja częściowa i mediacja całkowita, a porównywanie modeli – AIC i BIC w SEM.
Krok 4. Bootstrapowy przedział efektu pośredniego
Błąd standardowy efektu pośredniego z metody delta zakłada, że rozkład iloczynu a × b jest normalny. MacKinnon i in. (2004) pokazali w symulacji, że przedziały oparte na rozkładzie normalnym są dla efektu pośredniego niezrównoważone, a najdokładniejsze są metody resamplingu. Shrout i Bolger (2002) zalecają bootstrap szczególnie w małych i średnich próbach, a Preacher i Hayes (2008) omawiają metody resamplingu, w tym bootstrap, jako sposób oceny i porównywania efektów pośrednich, także w modelach z wieloma mediatorami. Hayes i Scharkow (2013) uznają przedział percentylowy za dobry kompromis między mocą a kontrolą błędu I rodzaju.
W lavaan bootstrap uruchamiasz argumentami se = "bootstrap" i bootstrap = 2000. Używamy estymatora ML (z FIML), bo przy bootstrapie odporne błędy standardowe MLR nie są potrzebne – niepewność oszacowań odtwarzają same próby bootstrapowe. Przedział percentylowy dostajesz przez parameterEstimates(..., boot.ci.type = "perc"). Ustaw ziarno losowania (set.seed()), by wynik był powtarzalny. Wszystkie 2000 prób zakończyło się powodzeniem.
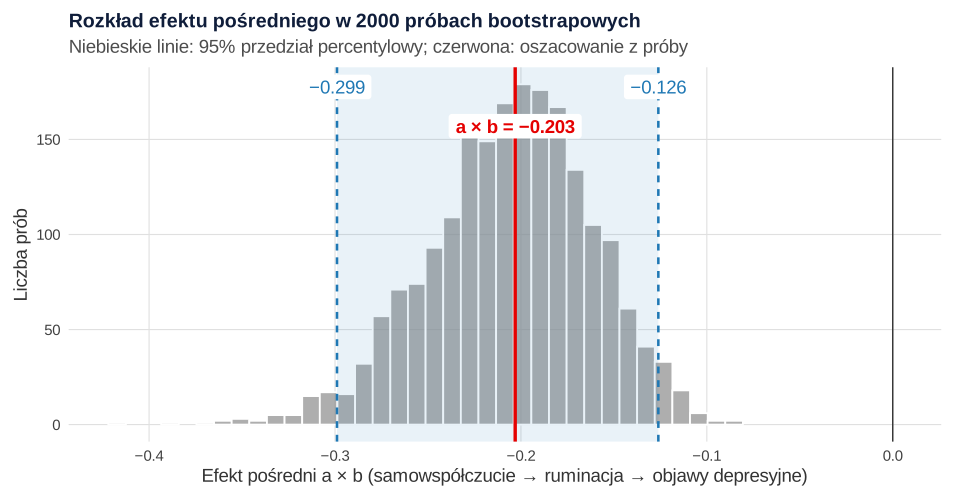
Efekt pośredni wyniósł −0.203, 95% CI [−0.299, −0.126]. Przedział nie obejmuje zera, a wszystkie próby bootstrapowe dały wartość ujemną. Rozkład jest lekko skośny (skośność −0.39), dlatego przedział percentylowy nie jest symetryczny wokół oszacowania i różni się od przedziału z metody delta ([−0.289, −0.117]). Efekt całkowity wyniósł −0.320, 95% CI [−0.463, −0.193], a bezpośredni −0.117, 95% CI [−0.255, 0.022]. Więcej o bootstrapie w modelach ze zmiennymi ukrytymi przeczytasz w haśle bootstrap w SEM, a o samej analizie mediacji – w poradniku analiza mediacji krok po kroku.
Krok 5. Tabela i opis w stylu APA
McDonald i Ho (2002) zalecają, by raport SEM zawierał pełny zestaw parametrów z błędami standardowymi, opis postępowania z brakami danych i nienormalnością, a często także macierz korelacji. Ścieżki strukturalne najwygodniej pokazać w tabeli, a dopasowanie i model pomiarowy – w tekście lub w osobnej tabeli (wzór: tabela dopasowania modelu w APA).
Tabela 1
Ścieżki modelu strukturalnego: samowspółczucie, ruminacja i objawy depresyjne
| Efekt | b | SE | 95% CI | β | |
|---|---|---|---|---|---|
| LL | UL | ||||
| a: samowspółczucie → ruminacja | −0.532 | 0.087 | −0.720 | −0.378 | −.41 |
| b: ruminacja → objawy depresyjne | 0.382 | 0.056 | 0.274 | 0.496 | .45 |
| c′: samowspółczucie → objawy depresyjne | −0.117 | 0.069 | −0.255 | 0.022 | −.11 |
| ab: efekt pośredni | −0.203 | 0.044 | −0.299 | −0.126 | −.18 |
| c: efekt całkowity | −0.320 | 0.070 | −0.463 | −0.193 | −.29 |
Uwaga. N = 420. b – współczynniki niestandaryzowane; β – współczynniki w pełni standaryzowane. Błędy standardowe i percentylowe 95% przedziały ufności z 2000 prób bootstrapowych (estymator ML, braki danych: FIML). R² = .16 dla ruminacji i R² = .26 dla objawów depresyjnych. Dopasowanie modelu (MLR): χ²(61) = 71.29, p = .173, CFI = .995, TLI = .994, RMSEA = .020, 90% CI [.000, .039], SRMR = .030. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Wzór opisu w sekcji wyników:
Gdy przygotowujesz tekst dla czasopisma, sprawdź jeszcze listę elementów raportu w przewodniku CB-SEM – założenia i interpretacja, a dane i kod dołącz jako pakiet replikacyjny.
Ostrzeżenia lavaan i co z nimi zrobić
Na własnych danych rzadko obejdzie się bez komunikatów. Trzy najczęstsze i pierwsze kroki, które warto wtedy zrobić:
| Komunikat (fragment) | Co zwykle oznacza | Co sprawdzić |
|---|---|---|
the optimizer warns that a solution has NOT been found | brak zbieżności: model jest źle zidentyfikowany empirycznie albo dane nie pasują do jego struktury | czy każdy czynnik ma co najmniej trzy dobre wskaźniki; czy pozycje odwrócone zostały przekodowane; czy korelacje czynników nie są bliskie zera przy dwóch wskaźnikach |
some estimated ov variances are negative | rozwiązanie niedopuszczalne (przypadek Heywooda) | wielkość ujemnej wariancji i jej przedział ufności; mała próba, pozycja z ładunkiem bliskim 1, błąd specyfikacji |
| informacje o niemożności policzenia błędów standardowych | macierz informacji nie daje się odwrócić – zwykle problem z identyfikacją | liczbę parametrów względem informacji, skalowanie czynników, zmienne o bardzo różnych wariancjach |
Nie usuwaj ostrzeżenia przez „sztuczki” (np. ustalenie ujemnej wariancji na zero) bez zrozumienia przyczyny i bez opisania tej decyzji w raporcie.
Jak dostosować kod do własnych danych
- Nazwy zmiennych. W składni modelu wpisz nazwy kolumn dokładnie tak, jak są w pliku (wielkość liter ma znaczenie). Pozycje odwrócone przekoduj przed analizą, np.
6 - xdla skali 1–5. - Pozycje porządkowe z 2–4 kategoriami. Dodaj argument
ordered = TRUE(albo listę nazw pozycji) i użyj estymatora WLSMV; indeksy odczytuj wtedy w wersjach.scaledlub.robustzgodnie z dokumentacją. FIML nie jest dostępny dla WLSMV, więc braki danych opisz osobno. - Kilka grup. Jeśli chcesz porównać ścieżki między grupami (np. kobiety i mężczyźni), najpierw sprawdź inwariancję pomiaru – procedurę opisuje poradnik inwariancja pomiaru krok po kroku.
- Dane zagnieżdżone. Uczniowie w klasach albo pracownicy w zespołach łamią założenie niezależności obserwacji; rozważ model wielopoziomowy.
- Więcej mediatorów. Dodaj kolejne ścieżki z etykietami i zdefiniuj każdy efekt pośredni osobno (np.
ind1 := a1*b1,ind2 := a2*b2), a ich różnicę jakoroznica := ind1 - ind2.
Lista kontrolna przed wysłaniem wyników
- Czy sprawdziłeś zbieżność i dopuszczalność rozwiązania (
lavInspect(fit, "converged")i"post.check")? - Czy estymator pasuje do danych (MLR przy 5+ kategoriach i skośnych rozkładach, WLSMV przy 2–4 kategoriach)?
- Czy braki danych obsłużyłeś przez FIML i podałeś ich odsetek?
- Czy raportujesz przeskalowany χ² z df i p oraz odporne wersje CFI, TLI i RMSEA (
cfi.robust,rmsea.robust)? - Czy oceniłeś lokalne dopasowanie (reszty, MI z EPC) i opisałeś każdą modyfikację?
- Czy podałeś ładunki, rzetelność (omega) i korelacje czynników z przedziałami ufności?
- Czy efekt pośredni ma przedział bootstrapowy, a liczba prób i ziarno losowania są w raporcie?
- Czy unikasz języka przyczynowego, skoro dane pochodzą z jednego pomiaru?
Najczęstsze błędy w analizach lavaan
- Czytanie
cfizamiastcfi.robust. Przy estymatorze MLRfitMeasures()zwraca kilka wersji indeksów. Do raportu wybierz wersje odporne (.robust) i przeskalowany χ² (chisq.scaled). - Odejmowanie przeskalowanych χ² ręcznie. Różnicę modeli MLR licz funkcją
lavTestLRT(), która stosuje właściwą poprawkę. - Bootstrap bez ziarna i bez informacji o liczbie udanych prób. Wynik jest wtedy niepowtarzalny, a nieudane próby mogą zniekształcać przedział.
- Mylenie GFI. W lavaan 0.7 klasyczny GFI to
gfi_lisrel;gfito nowa wersja z przedziałem ufności. - Modyfikacje bez uzasadnienia. Uwalnianie kolejnych kowariancji reszt według MI prowadzi do modelu dopasowanego do tej jednej próby.
- Interpretacja wyników standaryzowanych bez niestandaryzowanych. W tabeli podawaj oba, a przedziały ufności – dla b.
- „Mediacja całkowita” po nieistotnej ścieżce c′. Brak istotności nie dowodzi braku efektu bezpośredniego.
Jeśli przygotowujesz artykuł lub projekt grantowy i chcesz, by ktoś sprawdził kod, dobór estymatora albo opis wyników przed wysłaniem do recenzji, zajrzyj do oferty analiz dla badaczy. Jak wygląda analogiczna analiza w podejściu wariancyjnym, pokazuje poradnik PLS-SEM w R.
Przykład w R
Kod odtwarza wszystkie liczby, tabelę i opis z tego poradnika. Uruchom przepisy po kolei w katalogu, w którym chcesz zapisać plik z danymi: przepis 1 tworzy plik CSV, a kolejne go wczytują (możesz też od razu pobrać plik z danymi i zacząć od przepisu 2). Bootstrap w przepisie 4 trwa od kilku do kilkunastu minut.
1. Dane: symulacja i przegląd pozycji
R
# P4, przepis 1: dane do przykładu (dane symulowane) – samowspółczucie, ruminacja i objawy depresyjne
# 420 studentów; pozycje na skali 1–5; ok. 4% losowych braków odpowiedzi
library(lavaan)
set.seed(2610)
populacja <- '
  SW =~ 0.75*sw1 + 0.70*sw2 + 0.80*sw3 + 0.65*sw4
  RU =~ 0.80*ru1 + 0.75*ru2 + 0.70*ru3 + 0.60*ru4
  DE =~ 0.70*de1 + 0.75*de2 + 0.65*de3 + 0.70*de4 + 0.60*de5
  RU ~ -0.45*SW
  DE ~ 0.50*RU + -0.15*SW
  ru3 ~~ 0.20*ru4
'
ciagle <- simulateData(populacja, sample.nobs = 420, standardized = TRUE)
progi <- c(-Inf, -1.3, -0.45, 0.35, 1.2, Inf)            # pięć kategorii odpowiedzi
dane <- as.data.frame(lapply(ciagle, function(x) as.integer(cut(x, progi))))
braki <- matrix(runif(nrow(dane) * ncol(dane)) < 0.04, nrow(dane))
dane[braki] <- NA
dane <- dane[, c(paste0("sw", 1:4), paste0("ru", 1:4), paste0("de", 1:5))]
write.csv(dane, "cb-sem-w-r-lavaan-dane.csv", row.names = FALSE, na = "")

# Szybki przegląd: liczebność, braki, rozkład pozycji
dim(dane)
round(100 * mean(is.na(dane)), 1)                              # % braków w całej tabeli
sum(complete.cases(dane))                                      # osoby bez żadnego braku
opis <- psych::describe(dane)
round(opis[, c("n", "mean", "sd", "skew", "kurtosis")], 2)
Wynik w R
[1] 420  13
[1] 4
[1] 249
      n mean   sd  skew kurtosis
sw1 400 3.13 1.15 -0.05    -0.80
sw2 398 3.13 1.12 -0.13    -0.76
sw3 403 3.14 1.09 -0.17    -0.64
sw4 401 3.19 1.09 -0.03    -0.70
ru1 409 2.97 1.14  0.05    -0.70
ru2 407 2.97 1.20 -0.02    -0.89
ru3 399 3.01 1.16 -0.02    -0.82
ru4 403 2.97 1.17  0.00    -0.87
de1 402 3.04 1.08 -0.08    -0.70
de2 403 3.00 1.13 -0.07    -0.80
de3 402 3.00 1.12  0.02    -0.70
de4 402 3.01 1.12  0.00    -0.75
de5 412 3.08 1.08 -0.12    -0.60
2. Model pomiarowy: CFA z MLR i FIML
R
# P4, przepis 2: model pomiarowy (CFA) – estymator MLR, braki danych: FIML
library(lavaan)
dane <- read.csv("cb-sem-w-r-lavaan-dane.csv")
model_pomiarowy <- '
  SW =~ sw1 + sw2 + sw3 + sw4     # samowspółczucie
  RU =~ ru1 + ru2 + ru3 + ru4     # ruminacja
  DE =~ de1 + de2 + de3 + de4 + de5   # objawy depresyjne
'
cfa1 <- cfa(model_pomiarowy, data = dane, estimator = "MLR", missing = "fiml")
lavInspect(cfa1, "converged"); lavInspect(cfa1, "post.check")      # zbieżność i dopuszczalność rozwiązania
indeksy <- c("npar", "chisq.scaled", "df.scaled", "pvalue.scaled", "chisq.scaling.factor",
             "cfi.robust", "tli.robust", "rmsea.robust", "rmsea.ci.lower.robust",
             "rmsea.ci.upper.robust", "srmr", "gfi", "gfi_lisrel")
round(fitMeasures(cfa1, indeksy), 3)

# Lokalne niedopasowanie: największe indeksy modyfikacji i reszty korelacyjne
mi <- modindices(cfa1, sort. = TRUE, maximum.number = 5)
mi[, c("lhs", "op", "rhs", "mi", "epc", "sepc.all")]
reszty <- lavResiduals(cfa1, type = "cor")$cov
round(max(abs(reszty[lower.tri(reszty)])), 3)
which(abs(reszty) == max(abs(reszty[lower.tri(reszty)])), arr.ind = TRUE)[1, ]

# Model z kowariancją reszt ru3 i ru4 (obie pozycje dotyczą rozmyślania przed snem)
cfa2 <- cfa(paste(model_pomiarowy, "ru3 ~~ ru4"), data = dane, estimator = "MLR", missing = "fiml")
round(fitMeasures(cfa2, indeksy), 3)
lavTestLRT(cfa2, cfa1)                          # przeskalowany test różnicy chi-kwadrat

# Ładunki standaryzowane, korelacje czynników, rzetelność (omega) i AVE
std <- standardizedSolution(cfa2)
ladunki <- std[std$op == "=~", c("lhs", "rhs", "est.std", "se", "ci.lower", "ci.upper")]
ladunki[, 3:6] <- round(ladunki[, 3:6], 3); ladunki
korelacje <- std[std$op == "~~" & std$lhs != std$rhs & std$lhs %in% c("SW", "RU", "DE"), c("lhs", "rhs", "est.std", "ci.lower", "ci.upper")]
korelacje[, 3:5] <- round(korelacje[, 3:5], 3); korelacje
round(unlist(semTools::compRelSEM(cfa2)), 3)          # omega (rzetelność złożona)
round(unlist(semTools::AVE(cfa2)), 3)
Wynik w R
[1] TRUE
[1] TRUE
                 npar          chisq.scaled             df.scaled
               42.000               111.188                62.000
        pvalue.scaled  chisq.scaling.factor            cfi.robust
                0.000                 1.007                 0.975
           tli.robust          rmsea.robust rmsea.ci.lower.robust
                0.969                 0.045                 0.031
rmsea.ci.upper.robust                  srmr                   gfi
                0.059                 0.034                 0.982
           gfi_lisrel
                0.994
    lhs op rhs     mi    epc sepc.all
132 ru3 ~~ ru4 43.155  0.288    0.496
117 ru1 ~~ ru2 25.246  0.233    0.456
118 ru1 ~~ ru3 13.070 -0.166   -0.346
119 ru1 ~~ ru4 10.100 -0.139   -0.253
144 de1 ~~ de3  8.641 -0.109   -0.195
[1] 0.099
row col
  8   7
                 npar          chisq.scaled             df.scaled
               43.000                71.291                61.000
        pvalue.scaled  chisq.scaling.factor            cfi.robust
                0.173                 1.009                 0.995
           tli.robust          rmsea.robust rmsea.ci.lower.robust
                0.994                 0.020                 0.000
rmsea.ci.upper.robust                  srmr                   gfi
                0.039                 0.030                 0.996
           gfi_lisrel
                0.996

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

     Df   AIC   BIC   Chisq Chisq diff Df diff Pr(>Chisq)
cfa2 61 14160 14333  71.917
cfa1 62 14198 14367 111.962     44.669       1  2.334e-11 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   lhs rhs est.std    se ci.lower ci.upper
1   SW sw1   0.645 0.044    0.558    0.731
2   SW sw2   0.670 0.039    0.593    0.746
3   SW sw3   0.718 0.034    0.650    0.785
4   SW sw4   0.582 0.041    0.501    0.663
5   RU ru1   0.851 0.024    0.804    0.899
6   RU ru2   0.790 0.024    0.744    0.837
7   RU ru3   0.716 0.032    0.654    0.778
8   RU ru4   0.635 0.034    0.568    0.702
9   DE de1   0.757 0.025    0.708    0.807
10  DE de2   0.826 0.024    0.778    0.873
11  DE de3   0.705 0.028    0.651    0.759
12  DE de4   0.755 0.027    0.703    0.808
13  DE de5   0.696 0.030    0.638    0.755
   lhs rhs est.std ci.lower ci.upper
31  SW  RU  -0.406   -0.507   -0.304
32  SW  DE  -0.291   -0.395   -0.186
33  RU  DE   0.498    0.405    0.591
   SW    RU    DE
0.749 0.805 0.866
   SW    RU    DE
0.429 0.565 0.563
3. Model strukturalny z efektem pośrednim
R
# P4, przepis 3: model strukturalny z efektem pośrednim (MLR + FIML)
library(lavaan)
dane <- read.csv("cb-sem-w-r-lavaan-dane.csv")
model_sem <- '
  SW =~ sw1 + sw2 + sw3 + sw4
  RU =~ ru1 + ru2 + ru3 + ru4
  DE =~ de1 + de2 + de3 + de4 + de5
  ru3 ~~ ru4
  RU ~ a*SW
  DE ~ b*RU + c*SW
  posredni  := a*b
  calkowity := c + a*b
'
sem1 <- sem(model_sem, data = dane, estimator = "MLR", missing = "fiml")
round(fitMeasures(sem1, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                          "rmsea.robust", "srmr")), 3)
pe <- parameterEstimates(sem1, standardized = TRUE)
sciezki <- pe[pe$op %in% c("~", ":="), c("lhs", "op", "rhs", "label", "est", "se", "z", "pvalue", "ci.lower", "ci.upper", "std.all")]
sciezki[, 5:11] <- round(sciezki[, 5:11], 3); sciezki
round(lavInspect(sem1, "r2")[c("RU", "DE")], 3)

# Model alternatywny bez ścieżki bezpośredniej SW -> DE (mediacja całkowita)
sem0 <- sem(sub("DE ~ b\\*RU \\+ c\\*SW", "DE ~ b*RU", sub("  calkowity := c \\+ a\\*b\n", "", model_sem)),
            data = dane, estimator = "MLR", missing = "fiml")
lavTestLRT(sem1, sem0)
round(c(AIC_pelny = AIC(sem1), AIC_bez_c = AIC(sem0), BIC_pelny = BIC(sem1), BIC_bez_c = BIC(sem0)), 1)
Wynik w R
 chisq.scaled     df.scaled pvalue.scaled    cfi.robust    tli.robust
       71.291        61.000         0.173         0.995         0.994
 rmsea.robust          srmr
        0.020         0.030
         lhs op   rhs     label    est    se      z pvalue ci.lower ci.upper
15        RU  ~    SW         a -0.532 0.088 -6.066  0.000   -0.703   -0.360
16        DE  ~    RU         b  0.382 0.056  6.858  0.000    0.273    0.491
17        DE  ~    SW         c -0.117 0.068 -1.721  0.085   -0.249    0.016
50  posredni :=   a*b  posredni -0.203 0.044 -4.609  0.000   -0.289   -0.117
51 calkowity := c+a*b calkowity -0.320 0.069 -4.640  0.000   -0.455   -0.185
   std.all
15  -0.406
16   0.455
17  -0.106
50  -0.185
51  -0.291
   RU    DE
0.165 0.257

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

     Df   AIC   BIC  Chisq Chisq diff Df diff Pr(>Chisq)
sem1 61 14160 14333 71.917
sem0 62 14160 14330 74.774     3.1633       1    0.07531 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
AIC_pelny AIC_bez_c BIC_pelny BIC_bez_c
  14159.6   14160.4   14333.3   14330.1
4. Bootstrap efektu pośredniego
R
# P4, przepis 4: bootstrapowy przedział ufności efektu pośredniego (ML + FIML, 2000 prób)
library(lavaan)
dane <- read.csv("cb-sem-w-r-lavaan-dane.csv")
model_sem <- '
  SW =~ sw1 + sw2 + sw3 + sw4
  RU =~ ru1 + ru2 + ru3 + ru4
  DE =~ de1 + de2 + de3 + de4 + de5
  ru3 ~~ ru4
  RU ~ a*SW
  DE ~ b*RU + c*SW
  posredni  := a*b
  calkowity := c + a*b
'
set.seed(4242)
sem_boot <- sem(model_sem, data = dane, estimator = "ML", missing = "fiml",
                se = "bootstrap", bootstrap = 2000)
pe <- parameterEstimates(sem_boot, boot.ci.type = "perc", level = 0.95)
w <- pe[pe$label %in% c("a", "b", "c", "posredni", "calkowity"), c("label", "est", "se", "ci.lower", "ci.upper")]
w[, 2:5] <- round(w[, 2:5], 3); w
# Standaryzowany efekt pośredni (punktowo)
std <- standardizedSolution(sem_boot)
round(std[std$label %in% c("posredni", "calkowity"), c("label", "est.std")][, 2], 3)
# Ile prób bootstrapowych zakończyło się sukcesem i rozkład efektu pośredniego
boot <- lavInspect(sem_boot, "boot")
nrow(boot)
ind <- boot[, "a"] * boot[, "b"]
round(c(srednia = mean(ind), skosnosc = psych::skew(ind), odsetek_ponizej_0 = mean(ind < 0)), 3)
saveRDS(ind, "kod/p4-bootstrap-efekt-posredni.rds")
Wynik w R
       label    est    se ci.lower ci.upper
15         a -0.532 0.087   -0.720   -0.378
16         b  0.382 0.056    0.274    0.496
17         c -0.117 0.069   -0.255    0.022
50  posredni -0.203 0.044   -0.299   -0.126
51 calkowity -0.320 0.070   -0.463   -0.193
[1] -0.185 -0.291
[1] 2000
          srednia          skosnosc odsetek_ponizej_0
           -0.206            -0.389             1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan, semTools (omega i AVE) i psych (statystyki opisowe); rysunki przygotowano w pakietach ggplot2 i ggforce. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggforce (wersja 0.5.0): Pedersen, T. L. (2025). ggforce: Accelerating ggplot2 (R package version 0.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.ggforce
Najczęstsze pytania
Jak policzyć efekt pośredni z bootstrapem w lavaan?
Nadaj ścieżkom etykiety (np. RU ~ a*SW, DE ~ b*RU + c*SW), zdefiniuj efekt posredni := a*b i oszacuj model z argumentami se = "bootstrap" i bootstrap = 2000. Przedział percentylowy odczytasz z parameterEstimates(fit, boot.ci.type = "perc"). Przed analizą ustaw set.seed(), a w raporcie podaj liczbę prób i rodzaj przedziału.
Które indeksy dopasowania z lavaan raportować przy estymatorze MLR?
Przy MLR raportuj przeskalowany test χ² (chisq.scaled, df.scaled, pvalue.scaled) oraz odporne wersje indeksów: cfi.robust, tli.robust i rmsea.robust z przedziałem ufności, a także srmr. Zwykłe cfi i rmsea w tym samym wydruku dotyczą statystyki ML i nie uwzględniają nienormalności.
Czym różni się gfi od gfi_lisrel w lavaan 0.7?
W lavaan 0.7 gfi_lisrel to klasyczny indeks GFI znany z programów LISREL i AMOS. Indeks gfi to nowa wersja oparta na propozycji Maydeu-Olivaresa i in. (2024), interpretowana jak odsetek wyjaśnionej wariancji i podawana z przedziałem ufności. Jeśli raportujesz GFI, napisz, której wersji użyłeś.
Jak uwzględnić braki danych w modelu SEM w R?
W funkcjach cfa() i sem() dodaj missing = "fiml", a przy danych nienormalnych połącz to z estimator = "MLR". FIML wykorzystuje wszystkie dostępne odpowiedzi i przy brakach MCAR lub MAR daje nieobciążone oszacowania. Nie usuwaj osób z brakami – w naszym przykładzie oznaczałoby to utratę 41% próby.
Jak policzyć omegę i AVE dla modelu CFA w lavaan?
Po oszacowaniu modelu użyj funkcji compRelSEM() (omega, czyli rzetelność złożona) i AVE() z pakietu semTools, podając obiekt z wynikiem cfa(). Funkcje uwzględniają ładunki i wariancje reszt z modelu, także kowariancje reszt. AVE poniżej .50 nie dyskwalifikuje skali automatycznie – oceniaj ją razem z ładunkami, omegą i treścią pozycji.
Powiązane hasła
Przeczytaj też
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →Analizujesz model SEM do artykułu lub doktoratu?
Sprawdzimy specyfikację i kod lavaan, przeprowadzimy analizę z bootstrapem i przygotujemy tabele oraz opis wyników zgodne z wymaganiami czasopisma.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745–783. https://doi.org/10.1007/s10490-023-09871-y ● Otwarty dostęp
- Cole, D. A., Ciesla, J. A., & Steiger, J. H. (2007). The insidious effects of failing to include design-driven correlated residuals in latent-variable covariance structure analysis. Psychological Methods, 12(4), 381–398. https://doi.org/10.1037/1082-989x.12.4.381
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Hayes, A. F., & Scharkow, M. (2013). The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter? Psychological Science, 24(10), 1918–1927. https://doi.org/10.1177/0956797613480187
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4 ● Otwarty dostęp
- Maydeu-Olivares, A., Ximénez, C., & Revuelta, J. (2024). Percentage of variance accounted for in structural equation models: The rediscovery of the goodness of fit index. Psychological Methods. https://doi.org/10.1037/met0000680 ● Otwarty dostęp
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Saris, W. E., Satorra, A., & van der Veld, W. M. (2009). Testing structural equation models or detection of misspecifications? Structural Equation Modeling: A Multidisciplinary Journal, 16(4), 561–582. https://doi.org/10.1080/10705510903203433 ● Otwarty dostęp: pełny tekst
- Shrout, P. E., & Bolger, N. (2002). Mediation in experimental and nonexperimental studies: New procedures and recommendations. Psychological Methods, 7(4), 422–445. https://doi.org/10.1037/1082-989x.7.4.422
Cytowania BibTeX
@article{cheung2024reporting, author={Cheung, Gordon W. and Cooper-Thomas, Helena D. and Lau, Rebecca S. and Wang, Linda C.}, title={{Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations}}, journal={Asia Pacific Journal of Management}, year={2024}, volume={41}, number={2}, pages={745--783}, doi={10.1007/s10490-023-09871-y}}@article{cole2007insidious, author={Cole, David A. and Ciesla, Jeffrey A. and Steiger, James H.}, title={{The insidious effects of failing to include design-driven correlated residuals in latent-variable covariance structure analysis}}, journal={Psychological Methods}, year={2007}, volume={12}, number={4}, pages={381--398}, doi={10.1037/1082-989x.12.4.381}}@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{hayes2013relative, author={Hayes, Andrew F. and Scharkow, Michael}, title={{The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter?}}, journal={Psychological Science}, year={2013}, volume={24}, number={10}, pages={1918--1927}, doi={10.1177/0956797613480187}}@article{mackinnon2004confidence, author={MacKinnon, David P. and Lockwood, Chondra M. and Williams, Jason}, title={{Confidence limits for the indirect effect: Distribution of the product and resampling methods}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={1}, pages={99--128}, doi={10.1207/s15327906mbr3901_4}}@article{maydeu2024percentage, author={Maydeu-Olivares, Alberto and Ximénez, Carmen and Revuelta, Javier}, title={{Percentage of variance accounted for in structural equation models: The rediscovery of the goodness of fit index}}, journal={Psychological Methods}, year={2024}, doi={10.1037/met0000680}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{saris2009testing, author={Saris, Willem E. and Satorra, Albert and van der Veld, William M.}, title={{Testing structural equation models or detection of misspecifications?}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={4}, pages={561--582}, doi={10.1080/10705510903203433}}@article{shrout2002mediation, author={Shrout, Patrick E. and Bolger, Niall}, title={{Mediation in experimental and nonexperimental studies: New procedures and recommendations}}, journal={Psychological Methods}, year={2002}, volume={7}, number={4}, pages={422--445}, doi={10.1037/1082-989x.7.4.422}}