Co to jest model MIMIC?
Model MIMIC (ang. multiple indicators, multiple causes – wiele wskaźników, wiele przyczyn) to model równań strukturalnych, w którym jedna zmienna latentna ma jednocześnie kilka wskaźników (jak w CFA) i kilka obserwowanych przyczyn albo kowariantów, które na nią wpływają. Formalnie opisali go Jöreskog i Goldberger (1975). Pokazali, że model implikuje dwa rodzaje ograniczeń: regresja wskaźników na przyczyny ma macierz współczynników rzędu 1, a kowariancje reszt mają strukturę jednoczynnikową.
W praktyce psychologicznej MIMIC służy do dwóch celów:
- porównania grup na poziomie cechy ukrytej – efekt płci, wieku czy warunku eksperymentalnego na czynnik, bez sumowania punktów i z uwzględnieniem błędu pomiaru;
- wykrywania zróżnicowanego funkcjonowania pozycji (DIF, ang. differential item functioning) – sprawdzenia, czy osoby z różnych grup o tym samym poziomie cechy odpowiadają na daną pozycję inaczej.
Równania i elementy modelu
Model składa się z części pomiarowej i strukturalnej oraz z opcjonalnych efektów bezpośrednich:
yj to wskaźniki (pozycje), η – cecha ukryta, λj – ładunki, a x – obserwowane przyczyny, np. płeć i wiek. Współczynniki γ opisują wpływ przyczyn na cechę, czyli różnice grup na poziomie czynnika. Współczynnik βj to efekt bezpośredni przyczyny na pozycję j, z pominięciem czynnika. W modelu wyjściowym wszystkie βj są równe zeru. Istotny efekt bezpośredni oznacza jednorodny (ang. uniform) DIF: przy tym samym poziomie η pozycja ma w jednej grupie systematycznie wyższy albo niższy wynik.
Jak każdy model z cechą ukrytą, MIMIC wymaga ustalenia skali czynnika (zob. identyfikacja modelu SEM). Zwykle ustala się na 1 ładunek pierwszej pozycji – wtedy γ wyraża różnicę w jednostkach tej pozycji. Można też ustalić na 1 wariancję reszty czynnika. Efekty bezpośrednie są identyfikowane tylko wtedy, gdy nie uwalnia się ich dla wszystkich pozycji naraz. Część pozycji musi pozostać „kotwicami” wolnymi od DIF.
MIMIC różni się od modelu z formatywną zmienną latentną. Tam wskaźniki tworzą konstrukt, a tu przyczyny tylko na niego wpływają, a cecha ukryta pozostaje zdefiniowana przez swoje wskaźniki refleksyjne. Od wielogrupowej analizy inwariancji pomiaru MIMIC różni się tym, że przyjmuje równe ładunki i wariancje błędów we wszystkich grupach. Testuje tylko różnice wyrazów wolnych, ale za to może uwzględniać zmienne ciągłe, takie jak wiek.
Przykład: płeć, wiek i płaczliwość
Pięciuset dorosłych (dane symulowane, 55% kobiet, wiek 18–65 lat) wypełniło sześciopozycyjną skalę objawów depresyjnych (1–5): smutek, anhedonia, zmęczenie, bezsenność, płaczliwość i poczucie winy. Pytamy, czy kobiety i osoby młodsze mają wyższy poziom depresyjności. W populacji, z której pochodzą dane, kobiety przy tym samym nasileniu depresji częściej zgłaszają płaczliwość (D5). To typowy kandydat na DIF.
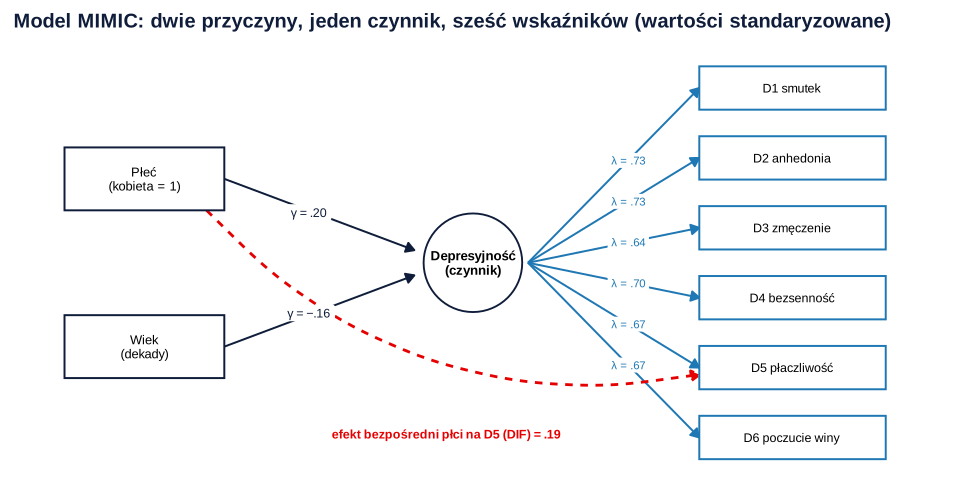
Krok 1 – model bez efektów bezpośrednich. Dopasowanie było umiarkowane: χ²(19) = 65.24, p < .001, CFI = .959, RMSEA = .070, SRMR = .038. Efekt płci na czynnik wyniósł γ = 0.39 (standaryzowany .25), a wieku (w dekadach) γ = −0.09 (standaryzowany −.16).
Krok 2 – szukanie DIF. Indeksy modyfikacji dla 12 możliwych efektów bezpośrednich (6 pozycji × 2 przyczyny) wskazały jednoznacznie ścieżkę płeć → D5: MI = 29.65, oczekiwana zmiana parametru 0.43. Drugi w kolejności był D1 (MI = 8.69, z ujemnym znakiem). To częściowo „odbicie” DIF w D5: model zawyża różnicę na czynniku, więc w pozostałych pozycjach przeszacowuje różnicę płci.
Krok 3 – model z efektem bezpośrednim płeć → D5. Dopasowanie poprawiło się wyraźnie: test różnicy chi-kwadrat Δχ²(1) = 29.91, p < .001; χ²(18) = 35.33, CFI = .985, RMSEA = .044. Efekt bezpośredni wyniósł 0.42 punktu skali, 95% CI [0.27, 0.57], co w wartościach standaryzowanych daje .19. Po jego uwzględnieniu różnica płci na czynniku zmalała z 0.39 do 0.32, 95% CI [0.17, 0.47]. Część pozornej różnicy w depresyjności wynikała więc z jednej pozycji. Rysunek 1 pokazuje model końcowy.
Po dodaniu efektu bezpośredniego warto ponownie sprawdzić indeksy modyfikacji. Największy z pozostałych 11 wynosił 5.01 (D6). Przy korekcie Bonferroniego dla 11 testów próg wynosi χ²(1) = 8.05, więc nie było podstaw do kolejnych zmian (zob. korekta Bonferroniego). Na poziomie sumy punktów kobiety miały średnio 16.42, a mężczyźni 14.32. Ta prosta różnica miesza prawdziwą różnicę w depresyjności z DIF w D5.
Założenia i ograniczenia
- Równe ładunki w grupach. MIMIC wykrywa przesunięcie wyrazu wolnego pozycji, ale nie różnice ładunków (DIF niejednorodny). Woods i Grimm (2011) zaproponowali do tego rozszerzenie o interakcję zmiennej ukrytej z kowariantem. Przy estymacji tej interakcji metodą LMS błąd I rodzaju był jednak silnie zawyżony.
- Równe wariancje czynnika i błędów w grupach. Gdy tego nie da się założyć, lepsza jest wielogrupowa CFA (zob. inwariancja pomiaru krok po kroku).
- Wybór pozycji „kotwiczących”. Testowanie DIF przez indeksy modyfikacji zakłada, że większość pozycji jest wolna od DIF. Gdy DIF dotyczy wielu pozycji, wyniki bywają zniekształcone.
- Liczebność. Woods (2009) pokazała, że przy małej grupie ogniskowej testy jednorodnego DIF w MIMIC były dokładniejsze niż dwugrupowa analiza IRT, zarówno dla pozycji dwukategorialnych, jak i pięciokategorialnych.
- Pozycje porządkowe. Przy 4–5 kategoriach rozważ estymator WLSMV i parametryzację progów zamiast traktowania odpowiedzi jako ciągłych.
Jak opisać model MIMIC w pracy
Opisz przyczyny, sposób testowania DIF (indeksy modyfikacji, korekta na liczbę testów), końcowy model z efektami bezpośrednimi i to, jak zmieniły one efekty na czynnik.
Model MIMIC w R (lavaan)
Kod generuje dane z przykładu, dopasowuje model MIMIC bez efektów bezpośrednich, liczy indeksy modyfikacji dla wszystkich ścieżek pozycja ← przyczyna (dodanych jako ustalone na zero), szacuje model z efektem bezpośrednim płci na D5, porównuje modele testem różnicy χ² i ponownie sprawdza indeksy modyfikacji z progiem Bonferroniego. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
MIMIC i test jednorodnego DIF
R
# R123 – model MIMIC: czynnik depresyjności, dwie przyczyny obserwowane i test DIF (pakiet lavaan)
# Dane symulowane: 500 dorosłych; sześć pozycji objawów (1–5): D1 smutek, D2 anhedonia, D3 zmęczenie,
# D4 bezsenność, D5 płaczliwość, D6 poczucie winy; przyczyny: płeć (kobieta = 1) i wiek (lata).
# W populacji kobiety przy tym samym poziomie depresyjności częściej zgłaszają płaczliwość (DIF w D5).
suppressPackageStartupMessages(library(lavaan))
set.seed(123)
n <- 500
kobieta <- rbinom(n, 1, 0.55)
wiek <- round(runif(n, 18, 65))
dep <- 0.30 * kobieta - 0.010 * (wiek - 40) + rnorm(n, sd = 0.95)
lam <- c(0.80, 0.75, 0.65, 0.60, 0.70, 0.65)
Y <- sapply(lam, function(l) l * dep + rnorm(n, sd = 0.65))
Y[, 5] <- Y[, 5] + 0.45 * kobieta                                  # DIF jednorodny w pozycji D5
dane <- data.frame(apply(Y, 2, function(y) pmin(pmax(round(2.4 + 1.1 * y), 1), 5)), kobieta, wiek)
names(dane)[1:6] <- paste0("D", 1:6)
dane$wiek10 <- (dane$wiek - 40) / 10                               # wiek w dekadach, wyśrodkowany na 40 lat

# 1. Model MIMIC bez efektów bezpośrednich
mimic0 <- '
  dep =~ D1 + D2 + D3 + D4 + D5 + D6
  dep ~ kobieta + wiek10
'
f0 <- sem(mimic0, data = dane)
round(fitMeasures(f0, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
pe0 <- parameterEstimates(f0, standardized = TRUE)
pe0[pe0$op == "~", c("lhs", "rhs", "est", "se", "pvalue", "std.all")]

# 2. Indeksy modyfikacji dla efektów bezpośrednich przyczyn na pozycje:
#    ścieżki pozycja ~ przyczyna dodajemy jako ustalone na 0 (model ten sam, df te same)
mimic0_mi <- paste(mimic0, "D1 + D2 + D3 + D4 + D5 + D6 ~ 0*kobieta + 0*wiek10", sep = "\n")
f0_mi <- sem(mimic0_mi, data = dane)
round(fitMeasures(f0_mi, c("chisq", "df")), 3)
mi <- modindices(f0_mi)
mi <- mi[mi$op == "~" & mi$rhs %in% c("kobieta", "wiek10"), c("lhs", "op", "rhs", "mi", "epc")]
head(mi[order(-mi$mi), ], 4)

# 3. Model z efektem bezpośrednim płci na D5 (DIF jednorodny)
mimic1 <- paste(mimic0, "D5 ~ kobieta", sep = "\n")
f1 <- sem(mimic1, data = dane)
round(fitMeasures(f1, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
pe1 <- parameterEstimates(f1, standardized = TRUE)
pe1[pe1$op == "~", c("lhs", "rhs", "est", "se", "pvalue", "ci.lower", "ci.upper", "std.all")]
anova(f0, f1)
# Czy po uwolnieniu D5 ~ kobieta zostają inne duże indeksy modyfikacji?
f1_mi <- sem(paste(mimic1, "D1 + D2 + D3 + D4 + D6 ~ 0*kobieta", "D1 + D2 + D3 + D4 + D5 + D6 ~ 0*wiek10", sep = "\n"), data = dane)
mi1 <- modindices(f1_mi)
mi1 <- mi1[mi1$op == "~" & mi1$rhs %in% c("kobieta", "wiek10"), c("lhs", "op", "rhs", "mi", "epc")]
head(mi1[order(-mi1$mi), ], 3)
round(qchisq(1 - 0.05 / 11, df = 1), 2)   # próg MI po korekcie Bonferroniego dla 11 sprawdzanych ścieżek

# 4. Różnica średnich surowych w D5 i w sumie punktów vs różnica na poziomie czynnika
round(c(D5_K = mean(dane$D5[dane$kobieta == 1]), D5_M = mean(dane$D5[dane$kobieta == 0]),
        suma_K = mean(rowSums(dane[dane$kobieta == 1, 1:6])), suma_M = mean(rowSums(dane[dane$kobieta == 0, 1:6]))), 2)
round(lavInspect(f1, "rsquare"), 3)
Wynik w R
 chisq     df pvalue    cfi  rmsea   srmr
65.238 19.000  0.000  0.959  0.070  0.038
  lhs     rhs    est    se pvalue std.all
7 dep kobieta  0.392 0.076  0.000   0.247
8 dep  wiek10 -0.093 0.027  0.001  -0.162
 chisq     df
65.238 19.000
   lhs op     rhs     mi    epc
17  D5  ~ kobieta 29.645  0.431
9   D1  ~ kobieta  8.691 -0.232
13  D3  ~ kobieta  4.125 -0.150
15  D4  ~ kobieta  2.438 -0.111
 chisq     df pvalue    cfi  rmsea   srmr
35.325 18.000  0.009  0.985  0.044  0.026
  lhs     rhs    est    se pvalue ci.lower ci.upper std.all
7 dep kobieta  0.317 0.078  0.000    0.165    0.470   0.198
8 dep  wiek10 -0.095 0.028  0.001   -0.149   -0.041  -0.164
9  D5 kobieta  0.422 0.076  0.000    0.274    0.570   0.191

Chi-Squared Difference Test

   Df    AIC    BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
f1 18 7589.0 7652.2 35.325
f0 19 7616.9 7675.9 65.238     29.913 0.24047       1   4.52e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   lhs op     rhs    mi    epc
14  D6  ~ kobieta 5.009  0.163
10  D1  ~ kobieta 3.043 -0.138
19  D5  ~  wiek10 1.856 -0.037
[1] 8.05
  D5_K   D5_M suma_K suma_M
  3.10   2.39  16.42  14.32
   D1    D2    D3    D4    D5    D6   dep
0.530 0.527 0.414 0.485 0.539 0.451 0.065
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; schemat na rysunku 1 przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie grup na sumie punktów, gdy jedna pozycja ma DIF. W przykładzie różnica w sumie mieszała prawdziwą różnicę w depresyjności z efektem jednej pozycji.
- Dodawanie efektów bezpośrednich bez korekty na liczbę testów. Przy 12 możliwych ścieżkach sam przypadek łatwo daje MI powyżej 3.84.
- Interpretacja MIMIC jako testu pełnej inwariancji. Model nie sprawdza równości ładunków ani wariancji błędów.
- Mylenie przyczyn z wskaźnikami formatywnymi. Płeć i wiek nie definiują depresyjności – tylko się z nią wiążą.
- Przyczynowy język przy danych przekrojowych. „Przyczyny” w nazwie modelu to termin techniczny. Efekt wieku w badaniu przekrojowym może odzwierciedlać różnice pokoleniowe.
Rysowanie i opis takich modeli omawiają hasło wykres ścieżkowy i wpis CB-SEM w R w pakiecie lavaan.
Najczęstsze pytania
Do czego służy model MIMIC?
Do sprawdzania, jak obserwowane zmienne (płeć, wiek, warunek eksperymentalny) wiążą się z cechą ukrytą mierzoną kilkoma pozycjami, oraz do wykrywania pozycji, które działają różnie w różnych grupach (DIF). W odróżnieniu od porównywania sum punktów uwzględnia błąd pomiaru.
Czym różni się MIMIC od wielogrupowej CFA?
Wielogrupowa CFA szacuje model osobno w każdej grupie i pozwala testować równość ładunków, wyrazów wolnych i wariancji błędów. MIMIC jest prostszy: zakłada równe ładunki i wariancje we wszystkich grupach i testuje tylko przesunięcia wyrazów wolnych. Za to może uwzględniać zmienne ciągłe, np. wiek, i działa przy mniejszych grupach.
Jak wykryć DIF w modelu MIMIC?
Dodaj do modelu ścieżki od przyczyny do każdej pozycji ustalone na zero i sprawdź ich indeksy modyfikacji z korektą na liczbę testów, np. Bonferroniego. Pozycję z istotnym efektem bezpośrednim uwolnij, porównaj modele testem różnicy χ² i ponownie sprawdź pozostałe indeksy.
Czy w modelu MIMIC płeć jest przyczyną cechy?
W sensie technicznym tak ją nazywamy – strzałka biegnie od płci do czynnika. Przy danych korelacyjnych to jednak tylko kierunek zapisu modelu: współczynnik γ opisuje różnicę grup na poziomie cechy ukrytej, a nie dowodzi mechanizmu przyczynowego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Inwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM)
Model pomiarowy i strukturalny, rodzaje modeli SEM, CB-SEM czy PLS-SEM, symulacja w R i etapy analizy od teorii do raportu.
Czytaj →PoradnikJak zaprojektować pomiar latentny
Definicja konstruktu, wskaźniki refleksyjne i formatywne, pozycja globalna i MIMIC, lista kontrolna kwestionariusza oraz symulacja w lavaan i seminr.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jöreskog, K. G., & Goldberger, A. S. (1975). Estimation of a Model with Multiple Indicators and Multiple Causes of a Single Latent Variable. Journal of the American Statistical Association, 70(351a), 631–639. https://doi.org/10.1080/01621459.1975.10482485
- Woods, C. M. (2009). Evaluation of MIMIC-Model Methods for DIF Testing With Comparison to Two-Group Analysis. Multivariate Behavioral Research, 44(1), 1–27. https://doi.org/10.1080/00273170802620121
- Woods, C. M., & Grimm, K. J. (2011). Testing for Nonuniform Differential Item Functioning With Multiple Indicator Multiple Cause Models. Applied Psychological Measurement, 35(5), 339–361. https://doi.org/10.1177/0146621611405984
Cytowania BibTeX
@article{joreskog1975estimation, author={Jöreskog, Karl G. and Goldberger, Arthur S.}, title={{Estimation of a Model with Multiple Indicators and Multiple Causes of a Single Latent Variable}}, journal={Journal of the American Statistical Association}, year={1975}, volume={70}, number={351a}, pages={631--639}, doi={10.1080/01621459.1975.10482485}}@article{woods2009evaluation, author={Woods, Carol M.}, title={{Evaluation of MIMIC-Model Methods for DIF Testing With Comparison to Two-Group Analysis}}, journal={Multivariate Behavioral Research}, year={2009}, volume={44}, number={1}, pages={1--27}, doi={10.1080/00273170802620121}}@article{woods2011testing, author={Woods, Carol M. and Grimm, Kevin J.}, title={{Testing for Nonuniform Differential Item Functioning With Multiple Indicator Multiple Cause Models}}, journal={Applied Psychological Measurement}, year={2011}, volume={35}, number={5}, pages={339--361}, doi={10.1177/0146621611405984}}