Co to jest zmienna ukryta?
Zmienna ukryta (latentna, ang. latent variable) to cecha, której nie mierzy się bezpośrednio. Wnioskuje się o niej z tego, co wspólne dla kilku zmiennych jawnych. W psychologii zmiennymi ukrytymi są prawie wszystkie konstrukty: lęk, samotność, inteligencja, satysfakcja z życia. Nikt nie „widzi” lęku społecznego. Widzimy odpowiedzi na pozycje w rodzaju „Unikam sytuacji, w których jestem w centrum uwagi” i zakładamy, że ich współzmienność wynika z jednej wspólnej przyczyny. Na wykresie ścieżkowym zmienną ukrytą rysuje się jako owal.
Bollen (2002) zestawia kilka definicji zmiennej ukrytej. Według pierwszej jest to zmienna, po której kontroli wskaźniki przestają ze sobą korelować (lokalna niezależność). Według drugiej to wynik prawdziwy, czyli wartość oczekiwana odpowiedzi. Według trzeciej to każda zmienna, której wartości nie da się dokładnie wyliczyć z danych. Borsboom i in. (2003) dodają ważne zastrzeżenie interpretacyjne. Model zmiennej ukrytej opisuje różnice między osobami, więc nie mówi wprost, jak cecha działa w głowie pojedynczego człowieka.
W praktyce modelowanie zmiennej ukrytej daje trzy korzyści. Po pierwsze, oddziela wariancję wspólną wskaźników od błędu pomiaru, więc związki między konstruktami nie są osłabione. Po drugie, pozwala sprawdzić, czy pozycje rzeczywiście mierzą jedną cechę – model z jednym czynnikiem może po prostu nie pasować. Po trzecie, umożliwia porównania grup na poziomie cechy, a nie surowych sum, pod warunkiem że pomiar działa w grupach tak samo (zob. inwariancja pomiaru).
Rodzaje zmiennych ukrytych
- Ciągła, refleksyjna – klasyczny czynnik z CFA i SEM. Cecha wpływa na odpowiedzi, a ładunki mówią, jak silnie (zob. refleksyjna zmienna latentna).
- Formatywna – wskaźniki tworzą konstrukt, np. status społeczno-ekonomiczny z dochodu, wykształcenia i zawodu (zob. formatywna zmienna latentna). Edwards i Bagozzi (2000) pokazują, że kierunek relacji konstruktu i miar trzeba ustalić teoretycznie przed analizą.
- Wyższego rzędu – czynnik wyjaśniający korelacje innych czynników, np. ogólna psychopatologia nad lękiem i depresją (zob. konstrukt wyższego rzędu).
- Kategorialna – nieobserwowana przynależność do grupy (klasy, profilu), np. w analizie profili latentnych.
Skala zmiennej ukrytej i identyfikacja
Zmienna ukryta nie ma własnych jednostek, więc trzeba jej je nadać. Robi się to na jeden z dwóch sposobów:
- wskaźnik referencyjny (marker) – ładunek jednej pozycji ustala się na 1, więc zmienna ukryta ma jednostki tej pozycji (domyślnie w lavaan, AMOS i Mplus);
- standaryzacja zmiennej ukrytej – jej wariancję ustala się na 1, a wszystkie ładunki są szacowane (w lavaan
std.lv = TRUE).
Obie metody dają ten sam model, z tym samym dopasowaniem i tym samym rozwiązaniem standaryzowanym. Różnią się tylko surowe liczby. Bez jednego z tych ograniczeń model nie jest identyfikowalny (zob. identyfikacja modelu SEM). Do tego potrzeba też wystarczającej liczby wskaźników – zwykle co najmniej trzech na czynnik.
Przykład: lęk społeczny i samotność
Czterystu studentów (dane symulowane) wypełniło po 4 pozycje skal lęku społecznego i samotności (1–5). Pozycje mierzą konstrukty z umiarkowaną precyzją (standaryzowane ładunki lęku od .464 do .630). Dwuczynnikowa CFA pasowała dobrze: χ²(19) = 24.93, p = .163, CFI = .990, RMSEA = .028, SRMR = .034. Wynik jest identyczny przy obu sposobach nadania skali. Przy wskaźniku referencyjnym ładunki lęku wynoszą 1.000, 1.004, 0.933 i 0.714, a wariancja lęku – 0.397. Przy std.lv = TRUE ładunki wynoszą 0.630, 0.633, 0.588 i 0.450, a wariancja – 1. To ta sama informacja w innych jednostkach (0.630² ≈ 0.397).
Teraz najważniejsze. Korelacja zmiennych ukrytych lęku i samotności wynosi .605, a korelacja Pearsona sum tych samych pozycji – tylko .440. Różnica wynika z błędu pomiaru, który zawiera każda suma: rzetelność sum (omega) wynosi .667 dla lęku i .706 dla samotności. Klasyczna korekta na osłabienie, .440 / √(.667 × .706) = .642, przybliża wynik do korelacji zmiennych ukrytych, choć jej nie odtwarza dokładnie. Suma waży bowiem wszystkie pozycje jednakowo, a model – według ładunków.
Wyniki czynnikowe (oszacowania wartości zmiennej ukrytej dla każdej osoby, w lavaan lavPredict()) korelowały ze sobą na poziomie .738, czyli wyżej niż same zmienne ukryte. Wynik czynnikowy lęku korelował z sumą pozycji lęku na poziomie .971. Wynik czynnikowy nie jest zmienną ukrytą, tylko jej niedoskonałym oszacowaniem, i w dalszych analizach może zniekształcać związki w obie strony. Jeśli chcesz analizować związki konstruktów, umieść je jako zmienne ukryte w jednym modelu SEM.
Dlaczego zmienne ukryte „odzyskują” siłę związku
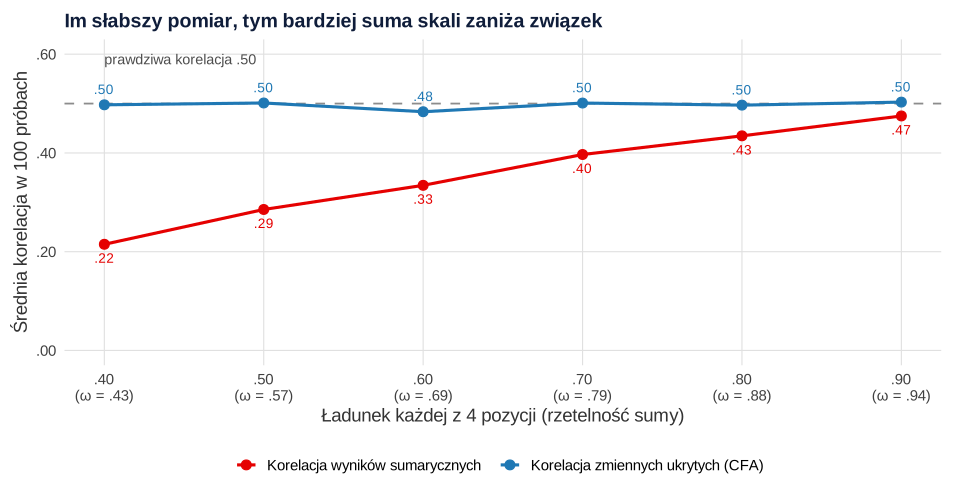
Gdy pozycje mają ładunki .40, a rzetelność sumy wynosi tylko .43, korelacja sum to przeciętnie .22 – mniej niż połowa prawdziwej wartości. Korelacja zmiennych ukrytych pozostaje w okolicy .50 przy każdej jakości pomiaru. Przy ładunkach .90 (rzetelność .94) obie metody dają podobny wynik (.47 i .50). Model zmiennych ukrytych nie naprawia jednak złego pomiaru za darmo. Przy słabych wskaźnikach oszacowanie jest mniej precyzyjne, a w małej próbie model może się nie zbiegać.
Jak opisać zmienne ukryte w pracy (APA)
Napisz, jakie zmienne ukryte zdefiniowano, ile wskaźników ma każda z nich i jak nadano im skalę. Podaj dopasowanie modelu pomiarowego, standaryzowane ładunki i korelacje zmiennych ukrytych, a dla porównania – rzetelność skal. Wzory tabel znajdziesz w haśle tabela analizy czynnikowej w APA.
Zmienne ukryte w R (lavaan)
Kod tworzy dane z przykładu i dopasowuje model z dwoma sposobami nadania skali. Porównuje korelację zmiennych ukrytych z korelacją sum, liczy omegę i korektę na osłabienie oraz sprawdza wyniki czynnikowe. Liczby w tekście pochodzą z tego kodu, a rysunek 1 – z osobnej symulacji (100 prób dla każdego poziomu ładunków).
Skala zmiennej ukrytej, korelacje i korekta na osłabienie
R
suppressPackageStartupMessages(library(lavaan))   # CFA ze zmiennymi ukrytymi

# Dane symulowane: 400 studentów; lęk społeczny (ls1–ls4) i samotność (sa1–sa4), odpowiedzi 1–5.
# W populacji korelacja obu zmiennych ukrytych wynosi .55, a pozycje mierzą je z umiarkowaną precyzją.
set.seed(145)
populacja <- '
  lek  =~ 0.70*ls1 + 0.65*ls2 + 0.60*ls3 + 0.55*ls4
  samo =~ 0.75*sa1 + 0.65*sa2 + 0.60*sa3 + 0.55*sa4
  lek ~~ 0.55*samo
'
z <- simulateData(populacja, sample.nobs = 400, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(3 + 1.0 * x), 1), 5)))

model <- 'lek  =~ ls1 + ls2 + ls3 + ls4
          samo =~ sa1 + sa2 + sa3 + sa4'

# 1. Dwa sposoby nadania skali zmiennej ukrytej: ładunek wskaźnika referencyjnego = 1 albo wariancja = 1
fit_marker <- cfa(model, data = dane)                  # domyślnie: pierwszy ładunek = 1
fit_std    <- cfa(model, data = dane, std.lv = TRUE)   # wariancja zmiennej ukrytej = 1
round(rbind(marker = fitMeasures(fit_marker, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")),
            std_lv = fitMeasures(fit_std,    c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))), 3)
pe_m <- parameterEstimates(fit_marker); pe_s <- parameterEstimates(fit_std)
round(cbind(marker = pe_m$est[1:4], std_lv = pe_s$est[1:4],
            standaryzowane = standardizedSolution(fit_std)$est.std[1:4]), 3)   # ładunki lęku
round(c(wariancja_lek_marker = pe_m$est[pe_m$lhs == "lek" & pe_m$rhs == "lek"]), 3)

# 2. Korelacja zmiennych ukrytych a korelacja wyników sumarycznych
ss <- standardizedSolution(fit_std)
r_ukryta <- ss$est.std[ss$lhs == "lek" & ss$op == "~~" & ss$rhs == "samo"]
suma_lek <- rowSums(dane[, 1:4]); suma_samo <- rowSums(dane[, 5:8])
r_suma <- cor(suma_lek, suma_samo)

# 3. Rzetelność sum (omega z ładunków) i korekta na osłabienie: r_suma / √(ω1 × ω2)
omega <- function(lhs) {
  l <- ss$est.std[ss$lhs == lhs & ss$op == "=~"]
  sum(l)^2 / (sum(l)^2 + sum(1 - l^2))
}
w_lek <- omega("lek"); w_samo <- omega("samo")
round(c(r_ukryta = r_ukryta, r_suma = r_suma, omega_lek = w_lek, omega_samo = w_samo,
        r_skorygowana = r_suma / sqrt(w_lek * w_samo)), 3)

# 4. Wyniki czynnikowe (oszacowania wartości zmiennej ukrytej dla osób) – to nadal nie jest sama zmienna ukryta
fs <- lavPredict(fit_std)
round(c(r_wyniki_czynnikowe = cor(fs[, "lek"], fs[, "samo"]), r_suma_z_wynikiem_czynnikowym = cor(suma_lek, fs[, "lek"])), 3)
Wynik w R
        chisq df pvalue  cfi rmsea  srmr
marker 24.931 19  0.163 0.99 0.028 0.034
std_lv 24.931 19  0.163 0.99 0.028 0.034
     marker std_lv standaryzowane
[1,]  1.000  0.630          0.627
[2,]  1.004  0.633          0.630
[3,]  0.933  0.588          0.583
[4,]  0.714  0.450          0.464
wariancja_lek_marker
               0.397
     r_ukryta        r_suma     omega_lek    omega_samo r_skorygowana
        0.605         0.440         0.667         0.706         0.642
          r_wyniki_czynnikowe r_suma_z_wynikiem_czynnikowym
                        0.738                         0.971
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Utożsamianie zmiennej ukrytej z sumą pozycji. Suma to zmienna jawna z błędem pomiaru, nawet jeśli skala ma dobrą rzetelność. Jej korelacje są zwykle słabsze (w przykładzie .44 zamiast .61).
- Traktowanie wyników czynnikowych jak „prawdziwych” wartości cechy. To oszacowania. W dalszych analizach mogą zawyżać lub zaniżać związki.
- Reifikacja – przekonanie, że skoro model z czynnikiem „lęk” pasuje, to istnieje jedna, dobrze zdefiniowana cecha. Dobre dopasowanie jest warunkiem koniecznym, a nie dowodem.
- Zmienna ukryta z jednym lub dwoma wskaźnikami bez dodatkowych ograniczeń. Model nie jest wtedy identyfikowalny albo jest niestabilny.
- Interpretowanie surowych ładunków bez informacji, jak nadano skalę. Ładunek 1.004 i ładunek 0.633 mogą opisywać ten sam wskaźnik.
- Wnioski o pojedynczych osobach z modelu różnic międzyosobniczych – przed tym przestrzegają Borsboom i in. (2003).
Budowę i weryfikację modelu ze zmiennymi ukrytymi opisuje poradnik analiza czynnikowa EFA i CFA. Rzetelność sum w porównaniu z omegą wyjaśnia alfa Cronbacha bez uproszczeń, a pełny model strukturalny – modelowanie równań strukturalnych (SEM).
Najczęstsze pytania
Jaki jest przykład zmiennej ukrytej w psychologii?
Lęk społeczny, samotność, inteligencja, neurotyczność czy satysfakcja z życia – żadnej z tych cech nie mierzysz bezpośrednio. Wnioskujesz o nich z odpowiedzi na kilka pozycji kwestionariusza lub zadań testu, które są zmiennymi jawnymi.
Dlaczego korelacja zmiennych ukrytych jest wyższa niż korelacja sum skal?
Bo suma pozycji zawiera błąd pomiaru, który osłabia korelacje, a model ze zmiennymi ukrytymi oddziela ten błąd od cechy. Im niższa rzetelność skal, tym większa różnica; w przybliżeniu korelacja sum równa się korelacji zmiennych ukrytych pomnożonej przez pierwiastek z iloczynu rzetelności obu skal.
Jak nadać skalę zmiennej ukrytej?
Albo ustal na 1 ładunek jednego wskaźnika (wskaźnik referencyjny – domyślnie w większości programów), albo ustal na 1 wariancję zmiennej ukrytej (w lavaan std.lv = TRUE). Oba sposoby dają to samo dopasowanie i to samo rozwiązanie standaryzowane.
Czy wyniki czynnikowe to wartości zmiennej ukrytej?
Nie – to oszacowania wartości zmiennej ukrytej dla poszczególnych osób, obciążone niepewnością. Ich korelacje mogą być wyższe albo niższe niż korelacje samych zmiennych ukrytych, dlatego związki między konstruktami najlepiej szacować w jednym modelu SEM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikModelowanie równań strukturalnych (SEM): od teorii do raportu
SEM bez skrótów myślowych: model pomiarowy i strukturalny, CB-SEM a PLS-SEM, dopasowanie, założenia oraz raportowanie wyników.
Czytaj →PoradnikAlfa Cronbacha: jak oceniać rzetelność skali bez uproszczeń
Alfa Cronbacha krok po kroku: wzór, założenia, interpretacja, ograniczenia i sytuacje, w których lepiej raportować współczynnik omega.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A. (2002). Latent variables in psychology and the social sciences. Annual Review of Psychology, 53(1), 605–634. https://doi.org/10.1146/annurev.psych.53.100901.135239
- Borsboom, D., Mellenbergh, G. J., & van Heerden, J. (2003). The theoretical status of latent variables. Psychological Review, 110(2), 203–219. https://doi.org/10.1037/0033-295x.110.2.203
- Edwards, J. R., & Bagozzi, R. P. (2000). On the nature and direction of relationships between constructs and measures. Psychological Methods, 5(2), 155–174. https://doi.org/10.1037/1082-989x.5.2.155
Cytowania BibTeX
@article{bollen2002latent, author={Bollen, Kenneth A.}, title={{Latent variables in psychology and the social sciences}}, journal={Annual Review of Psychology}, year={2002}, volume={53}, number={1}, pages={605--634}, doi={10.1146/annurev.psych.53.100901.135239}}@article{borsboom2003theoretical, author={Borsboom, Denny and Mellenbergh, Gideon J. and van Heerden, Jaap}, title={{The theoretical status of latent variables}}, journal={Psychological Review}, year={2003}, volume={110}, number={2}, pages={203--219}, doi={10.1037/0033-295x.110.2.203}}@article{edwards2000nature, author={Edwards, Jeffrey R. and Bagozzi, Richard P.}, title={{On the nature and direction of relationships between constructs and measures}}, journal={Psychological Methods}, year={2000}, volume={5}, number={2}, pages={155--174}, doi={10.1037/1082-989x.5.2.155}}