Co właściwie szacuje PLS-SEM
PLS-SEM (partial least squares structural equation modeling, modelowanie ścieżkowe metodą cząstkowych najmniejszych kwadratów) to odmiana modelowania równań strukturalnych, w której każdy konstrukt jest kompozytem – ważoną sumą swoich wskaźników. Algorytm działa iteracyjnie i na przemian wykonuje dwa kroki:
- estymację zewnętrzną – wylicza wyniki konstruktów jako ważone sumy wskaźników;
- estymację wewnętrzną – na podstawie związków między sąsiednimi konstruktami w modelu poprawia wagi.
Gdy wagi przestają się zmieniać, na wynikach kompozytów szacuje się ścieżki zwykłą regresją (OLS). Wagi można wyznaczać na dwa sposoby. W trybie Mode A waga wskaźnika jest proporcjonalna do jego korelacji z konstruktem; tak zwykle szacuje się konstrukty refleksyjne. W trybie Mode B wagi pochodzą z regresji wielorakiej, czyli uwzględniają korelacje między wskaźnikami; tak szacuje się konstrukty formatywne. Szczegóły opisuje hasło Model A i Model B w PLS-PM.
Z tej konstrukcji wynikają dwie konsekwencje, które warto znać przed interpretacją wyników:
- Kompozyt zawiera błąd pomiaru. Jeśli dane pochodzą z modelu czynnika wspólnego (typowa skala psychologiczna), klasyczny PLS zawyża ładunki i zaniża ścieżki między konstruktami. Sarstedt i in. (2016) pokazali, że obciążenie pojawia się wtedy, gdy model estymacji nie pasuje do modelu, który wygenerował dane. Dlatego Dijkstra i Henseler (2015) zaproponowali consistent PLS (PLSc), który koryguje korelacje konstruktów na ich niepełną rzetelność.
- Wynikiem są konkretne wartości konstruktów dla każdej osoby. To ułatwia predykcję i dalsze analizy, ale oznacza też, że wyniki zależą od wag oszacowanych w danej próbie.
Kiedy wybrać PLS-SEM, a kiedy CB-SEM, omawiamy osobno we wpisie PLS-SEM czy CB-SEM, razem z symulacją obciążeń obu metod. Ten przewodnik zakłada, że decyzja już zapadła, i prowadzi przez ocenę modelu: najpierw pomiarowego, potem strukturalnego. Kod krok po kroku w pakietach seminr i cSEM pokazujemy we wpisie PLS-SEM w R.
Założenia PLS-SEM, o których się zapomina
PLS-SEM bywa przedstawiany jako metoda „bez założeń”. To nieprawda – założenia są po prostu inne niż w CB-SEM.
- Model wynika z teorii. Algorytm wymaga, by każdy konstrukt był połączony z innymi, a kierunki ścieżek były określone z góry. PLS nie odkryje struktury modelu za Ciebie.
- Rodzaj pomiaru jest określony przed analizą. Dla każdego konstruktu zdecyduj, czy wskaźniki są refleksyjne, czy formatywne. Petter i in. (2007) wykazali, że w części opublikowanych badań konstrukty formatywne błędnie określano jako refleksyjne, co zwiększa ryzyko błędów I i II rodzaju. Kryteria decyzji omawia wpis model refleksyjny czy formatywny.
- Związki są liniowe i addytywne, chyba że jawnie dodasz interakcje lub składniki nieliniowe.
- Obserwacje są niezależne. Dane zagnieżdżone (np. uczniowie w klasach) wymagają innego podejścia.
- Próba odpowiada złożoności modelu. Brak założenia o normalności nie znosi wymagań dotyczących mocy. Liczebność planuj tak jak przy regresji z największą liczbą predyktorów jednego konstruktu – zob. poradnik o doborze liczebności próby.
- Wnioskowanie opiera się na bootstrapie. Przedziały ufności dla ładunków, wag, ścieżek i efektów pośrednich wyznacza się z kilku tysięcy prób bootstrapowych.
Przykład: stresory akademickie, wyczerpanie i zamiar rezygnacji ze studiów
Wszystkie liczby w tym przewodniku pochodzą z jednego modelu oszacowanego w R na danych symulowanych (300 studentów, odpowiedzi na skali 1–7). Model zawiera cztery konstrukty:
- STR – stresory akademickie, konstrukt formatywny złożony z czterech źródeł obciążenia: egzaminy, finanse, praca zarobkowa i relacje. Te źródła nie muszą ze sobą korelować – student może mieć problemy finansowe bez kłopotów z egzaminami – a razem tworzą ogólne obciążenie. W ankiecie była też jedna pozycja globalna („Ogólnie studia są dla mnie obciążające”), potrzebna do oceny trafności zbieżnej;
- WSP – wsparcie bliskich (refleksyjny, 3 wskaźniki);
- WYC – wyczerpanie studiami (refleksyjny, 4 wskaźniki);
- REZ – zamiar rezygnacji ze studiów (refleksyjny, 3 wskaźniki).
Hipotezy: stresory zwiększają wyczerpanie, wsparcie je zmniejsza, a wyczerpanie zwiększa zamiar rezygnacji. Wsparcie może też bezpośrednio zmniejszać ten zamiar. Model oszacowaliśmy w pakiecie seminr (wagi Mode A dla konstruktów refleksyjnych, Mode B dla STR), a przedziały ufności wyznaczyliśmy bootstrapem z 5000 prób. Szczegółowy, praktyczny opis takiego toku pracy w R zawiera podręcznik Haira i in. (2021), dostępny w otwartym dostępie.
Krok 1: ocena modelu pomiarowego – konstrukty refleksyjne
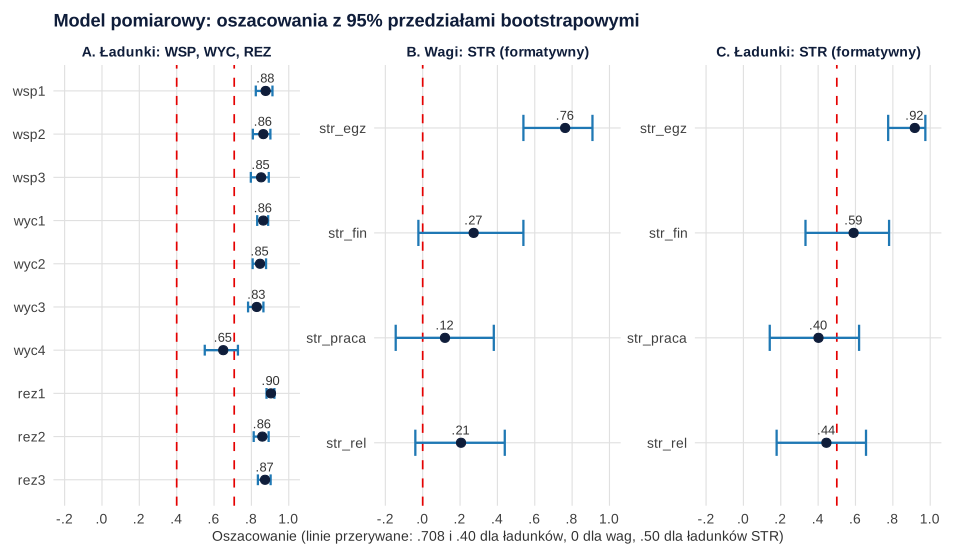
Ładunki wskaźników. Ładunek zewnętrzny to korelacja wskaźnika z kompozytem. Hair i in. (2019) zalecają, by wynosił co najmniej .708 – wtedy konstrukt wyjaśnia co najmniej połowę wariancji wskaźnika (.708² ≈ .50). W przykładzie dziewięć z dziesięciu ładunków przekroczyło ten próg (od .829 do .905). Wyjątkiem był wskaźnik wyc4 z ładunkiem .649, 95% CI [.550, .728] (rysunek 1, panel A).
Co zrobić z takim wskaźnikiem? Ładunki między .40 a .708 to strefa decyzji, a nie automatycznego usuwania. Wskaźnik usuwa się zwykle wtedy, gdy jego pominięcie podnosi rzetelność lub AVE ponad próg albo gdy jest wątpliwy treściowo. Sprawdziliśmy oba warianty. Bez wyc4 AVE wyczerpania wzrosło z .643 do .746, a ρC z .877 do .898, ale oba kryteria były spełnione już z wyc4. Ścieżki prawie się nie zmieniły (STR → WYC: .393 z wyc4 i .387 bez niego). Jeśli wyc4 obejmuje aspekt wyczerpania, którego nie mają pozostałe pozycje, warto go zostawić.
Rzetelność. W PLS-SEM podaje się zwykle trzy miary: alfę Cronbacha, ρA i rzetelność kompozytową ρC. Alfa zakłada równe ładunki i zwykle zaniża rzetelność, a ρC liczona z ładunków PLS ją zawyża. ρA leży zwykle pomiędzy nimi. Hair i in. (2019) uznają za zadowalające wartości od .70 do .90, a wartości powyżej .95 – za sygnał, że pozycje są niemal identyczne. W przykładzie: WSP α = .831, ρA = .833, ρC = .898; WYC .812, .835 i .877; REZ .854, .870 i .911.
Trafność zbieżna. Średnia wariancja wyodrębniona (AVE) to średnia kwadratów ładunków. Miarę wprowadzili Fornell i Larcker (1981) w ramach oceny modeli z błędem pomiaru. Cheung i in. (2024) przypominają, że zgodnie z tą tradycją AVE nie powinna być niższa niż .50, ale krytykują traktowanie AVE jako reguły kciuka bez uwzględnienia błędu próbkowania. W przykładzie AVE wyniosła .747 (WSP), .643 (WYC) i .773 (REZ).
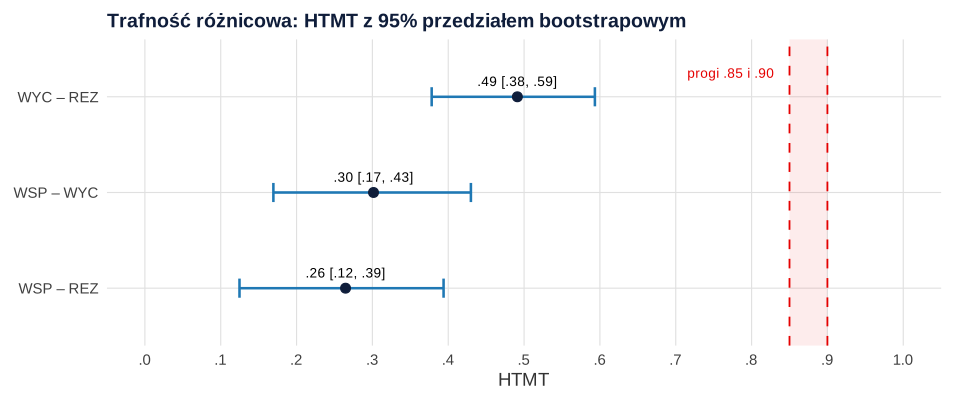
Trafność różnicowa. Henseler i in. (2015) pokazali w symulacji, że kryterium Fornella–Larckera i ładunki krzyżowe słabo wykrywają brak trafności różnicowej w typowych sytuacjach PLS-SEM. Zaproponowali w zamian HTMT z progiem .85 dla konstruktów wyraźnie różnych i .90 dla konstruktów pojęciowo bliskich. Lepiej niż samą wartość punktową oceniać jej przedział ufności. Najwyższe HTMT wystąpiło między wyczerpaniem a zamiarem rezygnacji: .491, 95% CI [.378, .593]. HTMT nie dotyczy konstruktów formatywnych, dlatego pomijamy pary z STR.
Krok 2: ocena modelu pomiarowego – konstrukt formatywny
Wskaźniki konstruktu formatywnego nie muszą korelować, więc alfa, ρC, AVE i HTMT nie mają tu zastosowania. Ocena obejmuje trzy inne kryteria.
Trafność zbieżna – analiza redundancji. Kompozyt formatywny powinien silnie korelować z alternatywną miarą tego samego konstruktu, np. pozycją globalną. W tym celu szacuje się osobny model, w którym STR przewiduje pozycję globalną. W przykładzie ścieżka wyniosła .771 (R² = .595). Zwykle oczekuje się co najmniej .70, więc cztery źródła stresu dobrze odpowiadają ogólnemu poczuciu obciążenia. Tę analizę trzeba zaplanować przed badaniem – po zebraniu danych nie dodasz już pozycji globalnej.
Współliniowość wskaźników. Wagi to współczynniki regresji wielorakiej, więc silnie skorelowane wskaźniki dają niestabilne wagi. Hair i in. (2019) uznają VIF od 5 wzwyż za krytyczny, a wartości poniżej około 3 za pożądane. W przykładzie VIF wynosiły od 1.084 do 1.230.
Wagi i ładunki. Waga mówi o względnym wkładzie wskaźnika przy kontroli pozostałych, a ładunek – o jego bezwzględnym wkładzie, czyli korelacji z kompozytem. Cenfetelli i Bassellier (2009) podkreślają, że te dwie informacje trzeba interpretować razem. Istotna była tylko waga egzaminów: .763, 95% CI [.539, .909]. Przedziały dla finansów (.273 [−.023, .539]), pracy (.119 [−.144, .381]) i relacji (.205 [−.039, .439]) obejmowały zero (rysunek 1, panele B i C). Nieistotna waga nie jest jednak powodem do usunięcia wskaźnika:
- finanse mają wyraźny ładunek, .590 [.332, .780], powyżej .50 – wskaźnik zostaje;
- praca (.402 [.141, .619]) i relacje (.444 [.178, .656]) mają ładunki poniżej .50, ale istotne. Hair i in. (2019) zostawiają decyzję treści: jeśli bez tych źródeł definicja stresorów akademickich byłaby niepełna, wskaźniki zostają.
Usunięcie wskaźnika formatywnego zmienia definicję konstruktu, a nie tylko „poprawia statystyki”. Jeśli bez pracy zarobkowej indeks przestaje opisywać obciążenie studentów pracujących, zostaw ją i opisz niską wagę w dyskusji.
Krok 3: ocena modelu strukturalnego
Współliniowość predyktorów. Każdy konstrukt endogeniczny to w PLS równanie regresji, więc VIF sprawdza się także tutaj. W przykładzie VIF wynosiły 1.011 (predyktory WYC) i 1.068 (predyktory REZ).
Ścieżki. Wszystkie cztery ścieżki miały przedziały ufności niezawierające zera:
| Ścieżka | β | 95% CI | f² |
|---|---|---|---|
| Stresory → wyczerpanie | 0.393 | [0.310, 0.490] | .195 |
| Wsparcie → wyczerpanie | −0.211 | [−0.306, −0.114] | .056 |
| Wyczerpanie → zamiar rezygnacji | 0.386 | [0.287, 0.481] | .172 |
| Wsparcie → zamiar rezygnacji | −0.130 | [−0.239, −0.016] | .020 |
Wyjaśniona wariancja. R² wyniosło .216 dla wyczerpania i .191 dla zamiaru rezygnacji. Nie oceniaj go według uniwersalnych progów. W badaniach intencji i zachowań studentów, które mają wiele przyczyn, wyjaśnienie jednej piątej wariancji kilkoma predyktorami jest wynikiem realistycznym. Porównuj R² z wcześniejszymi badaniami tego samego zjawiska.
Wielkość efektu f². Mówi, o ile spada R² po usunięciu predyktora. Hair i in. (2019) przywołują progi .02, .15 i .35 dla efektów małych, średnich i dużych. Stresory i wyczerpanie miały efekty średnie (.195 i .172), a wsparcie – małe (.056 i .020).
Efekty pośrednie. W modelu są dwie ścieżki pośrednie przez wyczerpanie: stresory → zamiar rezygnacji, 0.152 [0.106, 0.212], oraz wsparcie → zamiar rezygnacji, −0.081 [−0.126, −0.042]. Dla wsparcia istotny jest więc zarówno efekt bezpośredni, jak i pośredni o tym samym znaku – to mediacja częściowa (komplementarna). Ogólne zasady opisuje poradnik analiza mediacji krok po kroku, a wartość efektu pośredniego – hasło efekt pośredni.
Trafność predykcyjna. R² opisuje dopasowanie w tej samej próbie. Shmueli i in. (2019) zalecają rutynowo sprawdzać, jak model przewiduje nowe osoby, procedurą PLSpredict: walidacją krzyżową, w której błędy predykcji PLS-SEM porównuje się z prostym modelem liniowym. W przykładzie (10 części, 10 powtórzeń) PLS-SEM miał mniejszy RMSE niż model liniowy dla wszystkich siedmiu wskaźników wyczerpania i zamiaru rezygnacji (różnice od −0.007 do −0.028 punktu skali), co wskazuje na dobrą moc predykcyjną.
Co dalej: mediacja, moderacja, grupy i heterogeniczność
Po ocenie modelu podstawowego zwykle pojawiają się pytania dodatkowe. Każde z nich ma w PLS-SEM własne narzędzie:
- Mediacja – efekt pośredni to iloczyn ścieżek, a jego przedział ufności wyznacza bootstrap, tak jak w przykładzie powyżej. Nie stosuj testu Sobela ani warunków Barona i Kenny’ego.
- Moderacja – najczęściej w podejściu dwuetapowym: najpierw wyniki kompozytów, potem ich iloczyn jako dodatkowy predyktor. Interpretację interakcji opisuje poradnik analiza moderacji krok po kroku.
- Porównanie grup (np. studentów studiów stacjonarnych i niestacjonarnych) – zanim porównasz ścieżki, sprawdź, czy kompozyty znaczą to samo w obu grupach. Służy do tego procedura MICOM, odpowiednik inwariancji pomiaru z CB-SEM.
- Ukryte podgrupy – jeśli podejrzewasz, że w próbie są osoby o różnych zależnościach, których nie wyznacza żadna zmierzona zmienna, użyj FIMIX-PLS do wykrycia niejawnej heterogeniczności.
- Wnioski praktyczne – mapa ważności i wykonania (IPMA) zestawia całkowity wpływ konstruktu z jego średnim poziomem. Pokazuje, na którym czynniku interwencja może dać najwięcej – np. czy uczelnia powinna najpierw zmniejszać stresory, czy wzmacniać wsparcie.
Rozszerzenia nie zastępują oceny podstawowej. Każdy z tych kroków zakłada, że model pomiarowy i strukturalny przeszły już kontrolę opisaną w krokach 1–3.
Progi oceny modelu PLS-SEM i ich źródła
Poniższa tabela zbiera reguły z tego przewodnika. Traktuj je jako punkty orientacyjne, nie jako testy zaliczone–niezaliczone. Każde przekroczenie progu wymaga interpretacji z uwzględnieniem treści konstruktu i przedziału ufności.
| Kryterium | Wartość orientacyjna | Źródło | Uwagi |
|---|---|---|---|
| Ładunek wskaźnika refleksyjnego | ≥ .708 | Hair i in. (2019) | .40–.708: decyzja według rzetelności, AVE i treści |
| Rzetelność (ρA, ρC, α) | .70–.90; > .95 problematyczne | Hair i in. (2019) | alfa zaniża, ρC w PLS zawyża |
| AVE | ≥ .50 | Fornell i Larcker (1981); Cheung i in. (2024) | raportuj z przedziałem ufności |
| HTMT | < .85 (konstrukty różne), < .90 (bliskie) | Henseler i in. (2015) | oceniaj górną granicę 95% CI |
| VIF (wskaźniki formatywne, predyktory) | < 3 pożądane; ≥ 5 krytyczne | Hair i in. (2019) | wysoki VIF – niestabilne wagi i ścieżki |
| Waga wskaźnika formatywnego | istotna; jeśli nie – ładunek ≥ .50 | Hair i in. (2019); Cenfetelli i Bassellier (2009) | usunięcie zmienia definicję konstruktu |
| Analiza redundancji | ścieżka ≥ .70 (zwyczajowo) | – | wymaga pozycji globalnej w kwestionariuszu |
| f² | .02 / .15 / .35 | Hair i in. (2019) | małe / średnie / duże |
| PLSpredict | RMSE (MAE) PLS-SEM < LM dla większości wskaźników | Shmueli i in. (2019) | oceniaj wskaźniki kluczowego konstruktu |
W tabeli celowo brakuje „dobroci dopasowania” w stylu CB-SEM. Klasyczny PLS nie minimalizuje rozbieżności między macierzą z danych a macierzą odtworzoną przez model, więc wskaźniki takie jak CFI nie mają tu tego samego znaczenia. Przy PLSc i w konfirmacyjnej analizie kompozytów stosuje się testy oparte na dULS i dG oraz SRMR – pokazujemy je we wpisie PLS-SEM w R.
Minimalny raport PLS-SEM
- Uzasadnienie metody: rodzaj konstruktów i cel analizy, a nie „mała próba”.
- Specyfikacja: rodzaj pomiaru każdego konstruktu, tryb wag, schemat ważenia wewnętrznego, oprogramowanie z wersją.
- Ustawienia bootstrapu: liczba prób, rodzaj przedziału, ziarno losowania.
- Model pomiarowy refleksyjny: tabela ładunków, α, ρA, ρC, AVE i HTMT z przedziałami.
- Model pomiarowy formatywny: analiza redundancji, VIF, wagi i ładunki z przedziałami.
- Model strukturalny: VIF, ścieżki z 95% CI, R², f², efekty pośrednie, wynik PLSpredict.
- Decyzje o usunięciu wskaźników wraz z uzasadnieniem i analizą wrażliwości.
Układ tabel wyników i ogólne zasady opisu modeli równań strukturalnych omawiamy we wpisie modelowanie równań strukturalnych (SEM).
Przykład w R
Kod tworzy dane symulowane, szacuje model w pakiecie seminr i odtwarza wszystkie liczby z tekstu i tabel. Bootstrap z 5000 prób i PLSpredict trwają razem około dwóch minut. Wersję krok po kroku, z drugim pakietem (cSEM), consistent PLS i testem dopasowania, znajdziesz we wpisie PLS-SEM w R.
Ocena modelu pomiarowego i strukturalnego w seminr
R
# PLS-SEM – przewodnik: ocena modelu pomiarowego (refleksyjnego i formatywnego) i strukturalnego
# Dane symulowane: 300 studentów. Konstrukty:
#   STR – stresory akademickie, konstrukt formatywny (kompozyt Mode B): egzaminy, finanse, praca zarobkowa, relacje;
#         dodatkowo jedna pozycja globalna stres_glob („Ogólnie studia są dla mnie obciążające”) do analizy redundancji;
#   WSP – wsparcie bliskich (refleksyjny, 3 wskaźniki), WYC – wyczerpanie studiami (refleksyjny, 4),
#   REZ – zamiar rezygnacji ze studiów (refleksyjny, 3). Odpowiedzi na skali 1–7.
suppressPackageStartupMessages(library(seminr))
set.seed(707)
n <- 300
Rx <- matrix(c(1, .35, .25, .20,
               .35, 1, .40, .15,
               .25, .40, 1, .20,
               .20, .15, .20, 1), 4)
X <- MASS::mvrnorm(n, rep(0, 4), Rx)
w <- c(.50, .35, .30, .08)
STR <- drop(X %*% w); STR <- STR / sd(STR)
WSP <- -.20 * STR + rnorm(n, sd = sqrt(1 - .04))
WYC <- .45 * STR - .30 * WSP; WYC <- WYC + rnorm(n, sd = sqrt(1 - var(WYC)))
REZ <- .40 * WYC - .20 * WSP; REZ <- REZ + rnorm(n, sd = sqrt(1 - var(REZ)))
likert7 <- function(x) as.integer(cut(x, c(-Inf, -1.8, -1.0, -0.35, 0.35, 1.0, 1.8, Inf)))
refl <- function(eta, lam, pref) {
  M <- sapply(lam, function(l) likert7(l * eta + rnorm(n, sd = sqrt(1 - l^2)))); colnames(M) <- paste0(pref, seq_along(lam)); M
}
dane <- data.frame(apply(X, 2, likert7), stres_glob = likert7(.80 * STR + rnorm(n, sd = .6)),
                   refl(WSP, c(.85, .80, .78), "wsp"), refl(WYC, c(.82, .80, .76, .52), "wyc"), refl(REZ, c(.86, .82, .77), "rez"))
names(dane)[1:4] <- c("str_egz", "str_fin", "str_praca", "str_rel")

mm <- constructs(
  composite("STR", c("str_egz", "str_fin", "str_praca", "str_rel"), weights = mode_B),
  composite("WSP", multi_items("wsp", 1:3)),
  composite("WYC", multi_items("wyc", 1:4)),
  composite("REZ", multi_items("rez", 1:3))
)
sm <- relationships(paths(from = c("STR", "WSP"), to = "WYC"), paths(from = c("WYC", "WSP"), to = "REZ"))
pls <- estimate_pls(dane, mm, sm)
s <- summary(pls)
boot <- bootstrap_model(pls, nboot = 5000, cores = 1, seed = 708)
sb <- summary(boot)
kol <- c("Original Est.", "2.5% CI", "97.5% CI")

cat("\n== 1. Model refleksyjny: ładunki z 95% CI\n")
L <- sb$bootstrapped_loadings; round(L[!grepl("^str_", rownames(L)), kol], 3)
cat("\n== 2. Rzetelność i AVE\n"); round(s$reliability[c("WSP", "WYC", "REZ"), ], 3)
cat("\n== 3. HTMT z 95% CI (bootstrap percentylowy)\n"); round(sb$bootstrapped_HTMT[, kol], 3)
# Model bez słabego wskaźnika wyc4 – czy usunięcie coś zmienia?
mm2 <- constructs(composite("STR", c("str_egz", "str_fin", "str_praca", "str_rel"), weights = mode_B),
                  composite("WSP", multi_items("wsp", 1:3)), composite("WYC", multi_items("wyc", 1:3)),
                  composite("REZ", multi_items("rez", 1:3)))
s2 <- summary(estimate_pls(dane, mm2, sm))
cat("\n== 4. WYC bez wyc4: rzetelność i ścieżki\n"); round(s2$reliability["WYC", ], 3); round(s2$paths, 3)

cat("\n== 5. Model formatywny: VIF wskaźników, wagi i ładunki z 95% CI\n")
round(s$validity$vif_items$STR, 3)
W <- sb$bootstrapped_weights; round(W[grepl("^str_", rownames(W)), c(kol, "Bootstrap P Val")], 3)
round(L[grepl("^str_", rownames(L)), kol], 3)
# Analiza redundancji: kompozyt STR -> pozycja globalna (konstrukt jednowskaźnikowy)
mm_r <- constructs(composite("STR", c("str_egz", "str_fin", "str_praca", "str_rel"), weights = mode_B),
                   composite("GLOB", single_item("stres_glob")))
red <- summary(estimate_pls(dane, mm_r, relationships(paths(from = "STR", to = "GLOB"))))
cat("\n== 6. Redundancja: ścieżka STR -> GLOB\n"); round(red$paths, 3)

cat("\n== 7. Model strukturalny: VIF, ścieżki z 95% CI, R², f²\n")
round(unlist(s$vif_antecedents), 3)
round(sb$bootstrapped_paths[, c(kol, "T Stat.")], 3)
round(s$paths, 3)
round(s$fSquare, 3)
round(sb$bootstrapped_total_indirect_paths[, kol], 3)

cat("\n== 8. PLSpredict (REZ i WYC): RMSE PLS minus RMSE LM (ujemne = PLS lepszy)\n")
set.seed(709)
sp <- summary(predict_pls(pls, technique = predict_DA, noFolds = 10, reps = 10))
round(sp$PLS_out_of_sample["RMSE", ] - sp$LM_out_of_sample["RMSE", ], 3)
Wynik w R
Generating the seminr model
All 300 observations are valid.
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped

== 1. Model refleksyjny: ładunki z 95% CI
              Original Est. 2.5% CI 97.5% CI
wsp1  ->  WSP         0.876   0.824    0.913
wsp2  ->  WSP         0.864   0.808    0.902
wsp3  ->  WSP         0.852   0.797    0.893
wyc1  ->  WYC         0.864   0.831    0.890
wyc2  ->  WYC         0.846   0.807    0.878
wyc3  ->  WYC         0.829   0.782    0.864
wyc4  ->  WYC         0.649   0.550    0.728
rez1  ->  REZ         0.905   0.881    0.923
rez2  ->  REZ         0.858   0.812    0.892
rez3  ->  REZ         0.873   0.835    0.903

== 2. Rzetelność i AVE
    alpha  rhoA  rhoC   AVE
WSP 0.831 0.833 0.898 0.747
WYC 0.812 0.835 0.877 0.643
REZ 0.854 0.870 0.911 0.773

== 3. HTMT z 95% CI (bootstrap percentylowy)
             Original Est. 2.5% CI 97.5% CI
STR  ->  WSP         0.151   0.088    0.307
STR  ->  WYC         0.543   0.421    0.672
STR  ->  REZ         0.183   0.111    0.339
WSP  ->  WYC         0.301   0.169    0.430
WSP  ->  REZ         0.265   0.125    0.394
WYC  ->  REZ         0.491   0.378    0.593
Generating the seminr model
All 300 observations are valid.

== 4. WYC bez wyc4: rzetelność i ścieżki
alpha  rhoA  rhoC   AVE
0.830 0.830 0.898 0.746
          WYC    REZ
R^2     0.212  0.193
AdjR^2  0.207  0.188
STR     0.387      .
WSP    -0.212 -0.128
WYC         .  0.389

== 5. Model formatywny: VIF wskaźników, wagi i ładunki z 95% CI
  str_egz   str_fin str_praca   str_rel
    1.153     1.230     1.167     1.084
                   Original Est. 2.5% CI 97.5% CI Bootstrap P Val
str_egz  ->  STR           0.763   0.539    0.909           0.000
str_fin  ->  STR           0.273  -0.023    0.539           0.067
str_praca  ->  STR         0.119  -0.144    0.381           0.384
str_rel  ->  STR           0.205  -0.039    0.439           0.104
                   Original Est. 2.5% CI 97.5% CI
str_egz  ->  STR           0.918   0.775    0.974
str_fin  ->  STR           0.590   0.332    0.780
str_praca  ->  STR         0.402   0.141    0.619
str_rel  ->  STR           0.444   0.178    0.656
Generating the seminr model
All 300 observations are valid.

== 6. Redundancja: ścieżka STR -> GLOB
        GLOB
R^2    0.595
AdjR^2 0.593
STR    0.771

== 7. Model strukturalny: VIF, ścieżki z 95% CI, R², f²
WYC.STR WYC.WSP REZ.WYC REZ.WSP
  1.011   1.011   1.068   1.068
             Original Est. 2.5% CI 97.5% CI T Stat.
STR  ->  WYC         0.393   0.310    0.490   8.655
WSP  ->  WYC        -0.211  -0.306   -0.114  -4.264
WSP  ->  REZ        -0.130  -0.239   -0.016  -2.321
WYC  ->  REZ         0.386   0.287    0.481   7.782
          WYC    REZ
R^2     0.216  0.191
AdjR^2  0.211  0.185
STR     0.393      .
WSP    -0.211 -0.130
WYC         .  0.386
      STR   WSP   WYC   REZ
STR 0.000 0.000 0.195 0.000
WSP 0.000 0.000 0.056 0.020
WYC 0.000 0.000 0.000 0.172
REZ 0.000 0.000 0.000 0.000
             Original Est. 2.5% CI 97.5% CI
STR  ->  REZ         0.152   0.106    0.212
WSP  ->  REZ        -0.081  -0.126   -0.042

== 8. PLSpredict (REZ i WYC): RMSE PLS minus RMSE LM (ujemne = PLS lepszy)
  wyc1   wyc2   wyc3   wyc4   rez1   rez2   rez3
-0.017 -0.011 -0.014 -0.007 -0.022 -0.026 -0.028
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w PLS-SEM
- Wybór PLS „bo próba jest mała”. Mała próba obniża moc każdej metody; uzasadnieniem PLS są kompozyty i cel predykcyjny.
- Ocena konstruktu formatywnego kryteriami refleksyjnymi. Alfa i AVE dla indeksu stresorów nic nie znaczą; sprawdź redundancję, VIF, wagi i ładunki.
- Mechaniczne usuwanie wskaźników z ładunkiem poniżej .708 albo z nieistotną wagą.
- Kryterium Fornella–Larckera jako jedyny test trafności różnicowej. Raportuj HTMT z przedziałem ufności (Henseler i in., 2015).
- Ścieżki z klasycznego PLS interpretowane jak parametry modelu czynnikowego. Przy skalach refleksyjnych rozważ PLSc.
- Samo R² jako dowód „mocy predykcyjnej”. Predykcję poza próbą oceń PLSpredict.
- Brak ustawień bootstrapu i wersji oprogramowania w raporcie.
Jeśli planujesz artykuł z modelem PLS-SEM i chcesz, by ktoś sprawdził specyfikację, ocenił model pomiarowy albo wykonał całą analizę z raportem, zajrzyj do oferty analiz statystycznych dla badaczy.
Najczęstsze pytania
Jakie założenia ma PLS-SEM?
PLS-SEM nie wymaga normalności rozkładu, ale ma inne założenia: model musi wynikać z teorii, rodzaj pomiaru każdego konstruktu (refleksyjny czy formatywny) trzeba określić z góry, związki są liniowe, a obserwacje niezależne. Próba musi też wystarczać do oszacowania najbardziej złożonego równania w modelu, a wnioskowanie opiera się na bootstrapie.
Jaki ładunek jest wystarczający w PLS-SEM?
Zalecany próg to .708, bo przy takim ładunku konstrukt wyjaśnia co najmniej połowę wariancji wskaźnika. Ładunki między .40 a .708 to strefa decyzji: wskaźnik usuwa się zwykle tylko wtedy, gdy poprawia to rzetelność lub AVE ponad próg albo gdy jest wątpliwy treściowo. Wskaźniki poniżej .40 zwykle się usuwa.
Jak ocenić konstrukt formatywny w PLS-SEM?
Nie używaj alfy, AVE ani HTMT. Sprawdź trafność zbieżną analizą redundancji (ścieżka do pozycji globalnej, zwykle co najmniej .70), współliniowość wskaźników (VIF, najlepiej poniżej 3) oraz wagi i ładunki z przedziałami bootstrapowymi. Wskaźnik z nieistotną wagą, ale wyraźnym ładunkiem, zwykle zostaje w modelu.
Jaki próg HTMT przyjąć w PLS-SEM?
Dla konstruktów wyraźnie różnych pojęciowo przyjmuje się .85, a dla konstruktów bliskich – .90 (Henseler i in., 2015). Lepiej niż wartość punktową oceniać górną granicę bootstrapowego przedziału ufności. HTMT dotyczy tylko konstruktów refleksyjnych.
Jak interpretować f kwadrat w PLS-SEM?
f² mówi, o ile spada R² konstruktu endogenicznego po usunięciu danego predyktora. Najczęściej przywołuje się progi .02, .15 i .35 dla efektów małych, średnich i dużych, ale wielkość efektu najlepiej porównać z wcześniejszymi badaniami tego samego zjawiska.
Powiązane hasła
Przeczytaj też
PLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →PoradnikModel refleksyjny czy formatywny?
Kryteria decyzji Jarvis i in. (2003), symulacja skutków błędnej specyfikacji modelu pomiaru i model MIMIC w lavaan – z opisem do artykułu.
Czytaj →PoradnikSatysfakcja i lojalność w PLS-SEM
Ankieta 450 kursantów szkoły językowej w modelu w stylu ECSI: diagram ścieżek, pomiar, efekty pośrednie, f² i mapa IPMA – pięć rysunków z kodem R.
Czytaj →Oceniasz model PLS-SEM do publikacji?
Sprawdzimy specyfikację konstruktów, przeprowadzimy pełną ocenę modelu pomiarowego i strukturalnego i pomożemy uzasadnić każdą decyzję w raporcie.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cenfetelli, R. T., & Bassellier, G. (2009). Interpretation of formative measurement in information systems research. MIS Quarterly, 33(4), 689–708. https://doi.org/10.2307/20650323
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745–783. https://doi.org/10.1007/s10490-023-09871-y ● Otwarty dostęp
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. https://doi.org/10.1177/002224378101800104
- Hair, J. F., Jr., Hult, G. T. M., Ringle, C. M., Sarstedt, M., Danks, N. P., & Ray, S. (2021). Partial least squares structural equation modeling (PLS-SEM) using R: A workbook. Springer. https://doi.org/10.1007/978-3-030-80519-7 ● Otwarty dostęp
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8 ● Otwarty dostęp
- Petter, S., Straub, D., & Rai, A. (2007). Specifying formative constructs in information systems research. MIS Quarterly, 31(4), 623–656. https://doi.org/10.2307/25148814
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007 ● Otwarty dostęp
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cenfetelli2009interpretation, author={Cenfetelli, Ronald T. and Bassellier, Geneviève}, title={{Interpretation of formative measurement in information systems research}}, journal={MIS Quarterly}, year={2009}, volume={33}, number={4}, pages={689--708}, doi={10.2307/20650323}}@article{cheung2024reporting, author={Cheung, Gordon W. and Cooper-Thomas, Helena D. and Lau, Rebecca S. and Wang, Linda C.}, title={{Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations}}, journal={Asia Pacific Journal of Management}, year={2024}, volume={41}, number={2}, pages={745--783}, doi={10.1007/s10490-023-09871-y}}@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@article{fornell1981evaluating, author={Fornell, Claes and Larcker, David F.}, title={{Evaluating structural equation models with unobservable variables and measurement error}}, journal={Journal of Marketing Research}, year={1981}, volume={18}, number={1}, pages={39--50}, doi={10.1177/002224378101800104}}@book{hair2021pls, author={Hair, Joseph F., Jr. and Hult, G. Tomas M. and Ringle, Christian M. and Sarstedt, Marko and Danks, Nicholas P. and Ray, Soumya}, title={{Partial least squares structural equation modeling (PLS-SEM) using R: A workbook}}, year={2021}, publisher={Springer}, doi={10.1007/978-3-030-80519-7}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2015new, author={Henseler, Jörg and Ringle, Christian M. and Sarstedt, Marko}, title={{A new criterion for assessing discriminant validity in variance-based structural equation modeling}}, journal={Journal of the Academy of Marketing Science}, year={2015}, volume={43}, number={1}, pages={115--135}, doi={10.1007/s11747-014-0403-8}}@article{petter2007specifying, author={Petter, Stacie and Straub, Detmar and Rai, Arun}, title={{Specifying formative constructs in information systems research}}, journal={MIS Quarterly}, year={2007}, volume={31}, number={4}, pages={623--656}, doi={10.2307/25148814}}@article{sarstedt2016estimation, author={Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M. and Thiele, Kai O. and Gudergan, Siegfried P.}, title={{Estimation issues with PLS and CBSEM: Where the bias lies!}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={3998--4010}, doi={10.1016/j.jbusres.2016.06.007}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}