Co to jest bootstrap w SEM?
Bootstrap w SEM to wielokrotne losowanie ze zwracaniem prób o tej samej liczebności z własnych danych, szacowanie modelu w każdej z nich i wykorzystanie rozkładu otrzymanych wyników do wnioskowania. Ogólną metodę opisał Efron (1979): rozkład statystyki z próby można przybliżyć na podstawie samych zaobserwowanych danych, bez założenia o jego kształcie (zob. hasło bootstrap). W modelowaniu równań strukturalnych bootstrap rozwiązuje trzy praktyczne problemy:
- Efekty pośrednie. Iloczyn dwóch ścieżek a × b ma rozkład asymetryczny, więc symetryczny przedział z błędu standardowego bywa niedokładny (zob. efekt pośredni).
- Dane nienormalne. Klasyczne błędy standardowe i test χ² w estymacji ML zakładają wielowymiarową normalność, a skale objawów czy pozycje Likerta często są skośne.
- PLS-SEM. Metoda nie daje analitycznych błędów standardowych, więc istotność ścieżek i ładunków ocenia się prawie wyłącznie bootstrapem.
Trzy zastosowania bootstrapu w SEM
| Rodzaj | Co się losuje | Do czego służy |
|---|---|---|
| Nieparametryczny (zwykły) | osoby z oryginalnych danych | błędy standardowe i przedziały ufności parametrów, w tym efektów pośrednich |
| Bollena–Stine’a | osoby z danych przekształconych tak, by model był w nich prawdziwy | wartość p dla testu dopasowania χ² przy danych nienormalnych |
| Parametryczny | nowe dane z rozkładu normalnego o macierzy odtworzonej przez model | badanie zachowania statystyk przy znanym modelu, np. w symulacjach mocy |
Druga pozycja tabeli wymaga wyjaśnienia. Bollen i Stine (1992) pokazali, że zwykły bootstrap z oryginalnych danych nie nadaje się do testowania dopasowania. Dane te nie spełniają hipotezy zerowej, więc rozkład χ² z takich prób nie jest rozkładem przy prawdziwym modelu. Zaproponowali przekształcenie danych, po którym ich macierz kowariancji równa się macierzy odtworzonej przez model, i dopiero z nich losowanie prób. Wartość p to odsetek prób, w których χ² było co najmniej tak duże jak w oryginalnych danych.
Przedziały bootstrapowe: percentylowy i BCa
Z rozkładu oszacowań w B próbach można zbudować kilka przedziałów:
- percentylowy – 2.5. i 97.5. percentyl rozkładu bootstrapowego. Jest najprostszy i dziedziczy asymetrię rozkładu;
- BCa (ang. bias-corrected and accelerated) – percentyle przesunięte o korektę obciążenia i asymetrii. W lavaan dostępny jest wariant z samą korektą obciążenia (
bca.simple); - normalny – estymator ± 1.96 × bootstrapowy SE. Jest symetryczny, więc przy efektach pośrednich traci główną zaletę bootstrapu.
Preacher i Hayes (2008) omawiają metody oceny efektów pośrednich, w tym bootstrap, dla modeli z wieloma mediatorami. W SEM ze zmiennymi ukrytymi logika jest ta sama, tyle że w każdej próbie szacuje się cały model pomiarowy i strukturalny.
Przykład: mediacja ze zmiennymi ukrytymi przy skośnych danych
Dwieście dwadzieścia osób dorosłych (dane symulowane) wypełniło skale stresu w pracy, ruminacji i objawów bezsenności, po trzy wskaźniki każda. Wskaźniki są prawoskośne (skośność od 1.04 do 2.09). Model zakłada, że stres wpływa na bezsenność przez ruminację. Oszacowano go metodą ML z klasycznymi błędami standardowymi oraz z bootstrapem nieparametrycznym (2000 prób).
| Parametr | b | SE (ML) | 95% CI (metoda delta) | SE (bootstrap) | 95% CI percentylowy | 95% CI BCa (prosty) |
|---|---|---|---|---|---|---|
| a: stres → ruminacja | 0.456 | 0.098 | [0.264, 0.649] | 0.127 | [0.248, 0.743] | [0.245, 0.738] |
| b: ruminacja → bezsenność | 0.448 | 0.089 | [0.273, 0.623] | 0.100 | [0.271, 0.668] | [0.270, 0.665] |
| c′: stres → bezsenność | 0.093 | 0.097 | [−0.096, 0.282] | 0.124 | [−0.163, 0.317] | [−0.153, 0.321] |
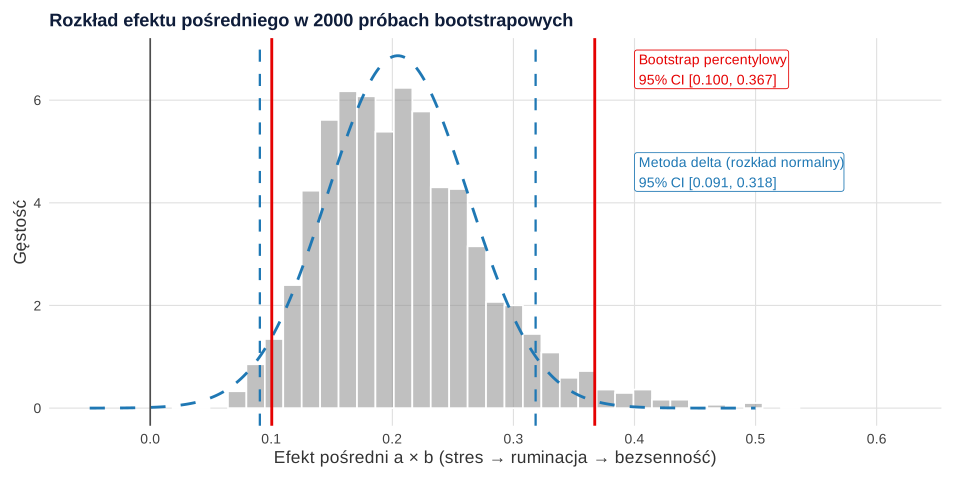
| efekt pośredni a × b | 0.204 | 0.058 | [0.091, 0.318] | 0.068 | [0.100, 0.367] | [0.104, 0.375] |
| efekt całkowity | 0.298 | 0.094 | [0.113, 0.483] | 0.107 | [0.081, 0.503] | [0.073, 0.495] |
Przy skośnych danych bootstrapowe błędy standardowe są wyraźnie większe od klasycznych: dla ścieżki a 0.127 zamiast 0.098, dla efektu pośredniego 0.068 zamiast 0.058. Klasyczne SE z estymacji ML są tu więc prawdopodobnie zbyt optymistyczne. Rozkład 2000 bootstrapowych efektów pośrednich jest prawoskośny (skośność 0.77), dlatego przedział percentylowy [0.100, 0.367] jest przesunięty w prawo względem symetrycznego przedziału z metody delta [0.091, 0.318] (rysunek 1). Oba wykluczają zero, ale górna granica różni się o prawie 0.05.
Bootstrap zmienia też ocenę dopasowania. Zwykły test χ² odrzucił model: χ²(24) = 42.68, p = .011, choć CFI = .976 i RMSEA = .059 były dobre. Bootstrap Bollena–Stine’a (1000 prób) dał p = .114, czyli przy uwzględnieniu skośności brak podstaw do odrzucenia modelu. Nevitt i Hancock (2001) badali, jak takie bootstrapowe wartości p i błędy standardowe sprawdzają się przy różnym stopniu nienormalności, liczebności próby i liczbie prób bootstrapowych. Alternatywą bez losowania jest estymator MLR z korektą statystyki testu.
Ile prób i na co uważać
- Liczba prób: do przedziałów ufności używaj co najmniej kilku tysięcy prób (w przykładzie 2000). Granice przedziału opierają się na skrajnych 2.5% rozkładu, które przy kilkuset próbach są niestabilne. Ustaw ziarno losowania (
iseed), aby wynik dało się odtworzyć. - Rozwiązania niedopuszczalne: w małych próbach część replikacji kończy się ujemną wariancją lub brakiem zbieżności. Sprawdź, ile ich było, i napisz to w raporcie.
- Liczebność: bootstrap nie naprawia zbyt małej próby. Jeśli 220 osób to mało dla danego modelu, losowanie z tych samych 220 osób tego nie zmieni.
- Struktura danych: losuje się całe jednostki niezależne. Przy danych zagnieżdżonych (uczniowie w klasach) zwykły bootstrap osób jest niewłaściwy.
Jak opisać bootstrap w pracy (APA)
Podaj rodzaj bootstrapu, liczbę prób, typ przedziału i ziarno losowania (w materiałach dodatkowych). Efekt pośredni raportuj jako oszacowanie z przedziałem bootstrapowym, a nie z wartością p z testu Sobela. Wzór tabeli znajdziesz w haśle tabela mediacji w APA.
Bootstrap w SEM w R (lavaan)
Kod tworzy skośne dane z przykładu, szacuje model mediacji ze zmiennymi ukrytymi z klasycznymi błędami standardowymi, a potem z bootstrapem nieparametrycznym (2000 prób; przedziały percentylowe i BCa), i liczy bootstrap Bollena–Stine’a dla testu χ². Obliczenia trwają około minuty. Liczby w tekście, tabeli i na rysunku 1 pochodzą z tego kodu.
Bootstrap efektu pośredniego i test Bollena–Stine’a
R
suppressPackageStartupMessages(library(lavaan))

# Dane symulowane: 220 osób dorosłych; stres w pracy (st1–st3) → ruminacja (ru1–ru3) → objawy bezsenności (be1–be3).
# Wskaźniki mają rozkłady prawoskośne (jak typowe skale objawów), więc założenie normalności jest naruszone.
set.seed(101)
pop <- '
  stres      =~ 0.80*st1 + 0.75*st2 + 0.70*st3
  ruminacja  =~ 0.80*ru1 + 0.78*ru2 + 0.72*ru3
  bezsennosc =~ 0.78*be1 + 0.75*be2 + 0.70*be3
  ruminacja  ~ 0.40*stres
  bezsennosc ~ 0.35*ruminacja + 0.15*stres
'
z <- simulateData(pop, sample.nobs = 220, standardized = TRUE, skewness = 1.6, kurtosis = 3.5)
dane <- as.data.frame(lapply(z, function(x) round(10 + 3 * x)))
round(sapply(dane, function(x) c(skosnosc = mean((x - mean(x))^3) / sd(x)^3)), 2)

model <- '
  stres      =~ st1 + st2 + st3
  ruminacja  =~ ru1 + ru2 + ru3
  bezsennosc =~ be1 + be2 + be3
  ruminacja  ~ a * stres
  bezsennosc ~ b * ruminacja + c * stres
  posredni := a * b
  calkowity := c + a * b
'

# 1. Klasyczne błędy standardowe (metoda delta) – przedział symetryczny
fit_ml <- sem(model, data = dane)
pe_ml <- parameterEstimates(fit_ml)
pe_ml[pe_ml$op %in% c("~", ":="), c("label", "est", "se", "z", "pvalue", "ci.lower", "ci.upper")]

# 2. Bootstrap nieparametryczny: 2000 prób z powtórzeniami z tych samych 220 osób
fit_b <- sem(model, data = dane, se = "bootstrap", bootstrap = 2000, iseed = 2101)
pe_perc <- parameterEstimates(fit_b, boot.ci.type = "perc")
pe_bca  <- parameterEstimates(fit_b, boot.ci.type = "bca.simple")
wybor <- pe_perc$op %in% c("~", ":=")
data.frame(param = pe_perc$label[wybor], est = round(pe_perc$est[wybor], 3), se_boot = round(pe_perc$se[wybor], 3),
           perc_low = round(pe_perc$ci.lower[wybor], 3), perc_up = round(pe_perc$ci.upper[wybor], 3),
           bca_low = round(pe_bca$ci.lower[wybor], 3), bca_up = round(pe_bca$ci.upper[wybor], 3))

# Ile prób bootstrapowych się udało i jak wygląda rozkład efektu pośredniego
boot <- lavInspect(fit_b, "boot")
nrow(boot)
ind <- boot[, "a"] * boot[, "b"]
round(c(srednia = mean(ind), sd = sd(ind), q025 = unname(quantile(ind, .025)), q975 = unname(quantile(ind, .975)),
        skosnosc = mean((ind - mean(ind))^3) / sd(ind)^3), 3)

# 3. Test dopasowania: chi-kwadrat ML i bootstrap Bollena–Stine'a (1000 prób)
round(fitMeasures(fit_ml, c("chisq", "df", "pvalue", "cfi", "rmsea")), 3)
bs <- bootstrapLavaan(fit_ml, R = 1000, type = "bollen.stine", FUN = fitMeasures, fit.measures = "chisq", iseed = 3101)
chi_obs <- fitMeasures(fit_ml, "chisq")
c(proby = nrow(bs), p_bollen_stine = round(mean(bs[, "chisq"] >= chi_obs), 3))
Wynik w R
st1.skosnosc st2.skosnosc st3.skosnosc ru1.skosnosc ru2.skosnosc ru3.skosnosc
        1.75         1.59         2.09         1.55         1.04         1.16
be1.skosnosc be2.skosnosc be3.skosnosc
        1.89         1.87         1.64
       label   est    se     z pvalue ci.lower ci.upper
10         a 0.456 0.098 4.644  0.000    0.264    0.649
11         b 0.448 0.089 5.007  0.000    0.273    0.623
12         c 0.093 0.097 0.963  0.335   -0.096    0.282
25  posredni 0.204 0.058 3.518  0.000    0.091    0.318
26 calkowity 0.298 0.094 3.152  0.002    0.113    0.483
      param   est se_boot perc_low perc_up bca_low bca_up
1         a 0.456   0.127    0.248   0.743   0.245  0.738
2         b 0.448   0.100    0.271   0.668   0.270  0.665
3         c 0.093   0.124   -0.163   0.317  -0.153  0.321
4  posredni 0.204   0.068    0.100   0.367   0.104  0.375
5 calkowity 0.298   0.107    0.081   0.503   0.073  0.495
[1] 2000
 srednia       sd     q025     q975 skosnosc
   0.209    0.068    0.100    0.367    0.773
 chisq     df pvalue    cfi  rmsea
42.681 24.000  0.011  0.976  0.059
         proby p_bollen_stine
      1000.000          0.114
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Bootstrap „zwykły” do testu dopasowania. Wartość p dla χ² wymaga bootstrapu Bollena–Stine’a albo korekty statystyki (np. MLR).
- Przedział normalny dla efektu pośredniego – symetryczny przedział z bootstrapowego SE ignoruje asymetrię iloczynu a × b.
- Za mało prób (np. 200–500) przy raportowaniu granic przedziału z dwoma lub trzema miejscami po przecinku.
- Brak informacji o typie przedziału i liczbie prób, przez co wyników nie da się odtworzyć ani porównać.
- Wnioskowanie przyczynowe z samej istotności efektu pośredniego. Bootstrap poprawia precyzję oszacowania, ale nie zastępuje planu badania (zob. mediacja).
Cały przebieg analizy pokazują poradniki analiza mediacji krok po kroku i CB-SEM w R: kompletny przykład w lavaan. Bootstrap w PLS-SEM omawia wpis PLS-SEM krok po kroku.
Najczęstsze pytania
Ile prób bootstrapowych ustawić w SEM?
Do przedziałów ufności efektów pośrednich i ścieżek używaj co najmniej kilku tysięcy prób (np. 2000–5000), bo granice przedziału zależą od skrajnych 2.5% rozkładu. Do wartości p Bollena–Stine’a zwykle wystarcza 1000 prób. Zawsze ustaw ziarno losowania, aby wynik był powtarzalny.
Kiedy użyć bootstrapu Bollena–Stine’a?
Gdy dane są wyraźnie nienormalne, a chcesz ocenić test dopasowania χ² dla modelu oszacowanego metodą ML. Procedura przekształca dane tak, by model był w nich prawdziwy, i dopiero z nich losuje próby; wartość p to odsetek prób z χ² co najmniej takim jak w danych.
Przedział percentylowy czy BCa dla efektu pośredniego?
Oba uwzględniają asymetrię rozkładu efektu pośredniego i zwykle dają podobne wyniki – w przykładzie z hasła [0.100, 0.367] i [0.104, 0.375]. Przedział percentylowy jest prostszy, BCa dodatkowo koryguje obciążenie oszacowania. Wybierz jeden przed analizą i napisz w raporcie, którego użyłeś.
Dlaczego bootstrapowe błędy standardowe są większe niż w zwykłym wyniku SEM?
Klasyczne błędy standardowe w estymacji ML zakładają wielowymiarową normalność. Przy skośnych lub leptokurtycznych danych są często zaniżone, a bootstrap – oparty na rzeczywistym rozkładzie danych – daje wartości większe i bardziej realistyczne. W przykładzie z hasła SE ścieżki a wzrósł z 0.098 do 0.127.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Stine, R. A. (1992). Bootstrapping goodness-of-fit measures in structural equation models. Sociological Methods & Research, 21(2), 205–229. https://doi.org/10.1177/0049124192021002004
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Nevitt, J., & Hancock, G. (2001). Performance of bootstrapping approaches to model test statistics and parameter standard error estimation in structural equation modeling. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 353–377. https://doi.org/10.1207/s15328007sem0803_2
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
Cytowania BibTeX
@article{bollen1992bootstrapping, author={Bollen, Kenneth A. and Stine, Robert A.}, title={{Bootstrapping goodness-of-fit measures in structural equation models}}, journal={Sociological Methods \& Research}, year={1992}, volume={21}, number={2}, pages={205--229}, doi={10.1177/0049124192021002004}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{nevitt2001performance, author={Nevitt, Jonathan and Hancock, Gregory}, title={{Performance of bootstrapping approaches to model test statistics and parameter standard error estimation in structural equation modeling}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={353--377}, doi={10.1207/s15328007sem0803_2}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}