Dwa różne pytania o ten sam konstrukt
Zanim policzysz pierwszą analizę czynnikową, musisz odpowiedzieć na pytanie, które nie ma nic wspólnego ze statystyką: czy to konstrukt wywołuje odpowiedzi na pozycje, czy to zachowania, cechy i zdarzenia opisane w pozycjach tworzą konstrukt? W pierwszym przypadku mówimy o modelu refleksyjnym, w drugim – o formatywnym. Od tej decyzji zależy, jak zapiszesz model w programie, które wskaźniki jakości mają sens i czy współczynniki ścieżek w modelu równań strukturalnych będą opisywać to, co chcesz opisać.
W tym poradniku przechodzimy przez kryteria decyzji zaproponowane przez Jarvis i in. (2003), pokazujemy na symulacji, co się dzieje z wynikami, gdy konstrukt formatywny zostanie potraktowany jak refleksyjny, i omawiamy model MIMIC jako jeden ze sposobów oszacowania konstruktu formatywnego w CB-SEM. Podstawowe definicje obu modeli znajdziesz w haśle modele refleksyjne i formatywne. Konstrukty wielowymiarowe, w których ta sama decyzja zapada na dwóch poziomach, opisuje osobny poradnik o modelowaniu konstruktów wyższego rzędu.
Model refleksyjny i formatywny – czym się różnią
W modelu refleksyjnym zmienna ukryta jest wspólną przyczyną odpowiedzi. Osoba z wysokim lękiem społecznym częściej unika rozmów z nieznajomymi, częściej czerwieni się przy wystąpieniach i dłużej rozpamiętuje swoje wypowiedzi – dlatego te odpowiedzi są ze sobą skorelowane. Każdy wskaźnik ma własny błąd pomiaru, a ładunek czynnikowy mówi, jak silnie konstrukt wpływa na daną pozycję. Szczegóły opisuje hasło refleksyjna zmienna latentna.
W modelu formatywnym strzałki biegną w drugą stronę: wskaźniki składają się na konstrukt. Higiena snu jest wysoka, gdy ktoś zasypia o stałych porach, nie korzysta z telefonu w łóżku i nie pije kawy wieczorem. Te zachowania nie muszą ze sobą korelować – osoba pijąca kawę wieczorem może mieć stałe godziny snu – i nie są wymienne: usunięcie jednego z nich zmienia to, co mierzysz. Bollen i Lennox (1991) pokazali, że tradycyjne reguły pomiaru, m.in. wymóg spójności wewnętrznej wskaźników, nie obowiązują bez jawnego modelu pomiarowego, i przedstawili model wskaźników przyczynowych jako alternatywę dla klasycznego modelu wskaźników efektów.
W literaturze rozróżnia się dwie odmiany pomiaru formatywnego. Bollen i Diamantopoulos (2017) wskazują, że wiele nieporozumień wynika z mylenia wskaźników przyczynowo-formatywnych (wskaźniki są przyczynami zmiennej ukrytej, która ma też własne zakłócenie, czyli część niewyjaśnioną przez wskaźniki) ze wskaźnikami kompozytowo-formatywnymi (konstrukt jest po prostu ważoną sumą wskaźników, bez zakłócenia). W praktyce badań psychologicznych ta druga odmiana odpowiada indeksom: liczbie stresujących zdarzeń, wskaźnikowi statusu społeczno-ekonomicznego czy sumie zachowań prozdrowotnych.
| Cecha | Model refleksyjny | Model formatywny |
|---|---|---|
| Kierunek związku | konstrukt → wskaźniki | wskaźniki → konstrukt |
| Korelacje między wskaźnikami | oczekiwane, wynikają z modelu | dowolne, mogą być bliskie zera albo ujemne |
| Usunięcie wskaźnika | nie zmienia znaczenia konstruktu (przy wielu wskaźnikach) | zmienia zakres konstruktu |
| Błąd | na poziomie każdego wskaźnika | na poziomie konstruktu (zakłócenie) albo brak błędu (kompozyt) |
| Rzetelność | omega, alfa, AVE | nie ma sensu w klasycznej postaci; ważna jest współliniowość i trafność zewnętrzna |
| Typowe przykłady | lęk, depresyjność, samoocena, zaangażowanie | stresory życiowe, status społeczno-ekonomiczny, higiena snu, warunki pracy |
Cztery kryteria decyzji według Jarvis i in. (2003)
Jarvis i in. (2003) przeanalizowali literaturę marketingową i zaproponowali kryteria pojęciowe, które pozwalają zdecydować, czy konstrukt ma wskaźniki refleksyjne, czy formatywne. MacKenzie i in. (2005) przenieśli tę samą listę na grunt badań behawioralnych i organizacyjnych. Kryteria dotyczą treści konstruktu i pozycji, a nie danych – możesz je zastosować przed zebraniem pierwszej odpowiedzi.
| Kryterium | Pytanie, które zadajesz | Odpowiedź wskazująca na model refleksyjny | Odpowiedź wskazująca na model formatywny |
|---|---|---|---|
| 1. Kierunek przyczynowości | Czy zmiana konstruktu wywołuje zmianę wskaźników, czy odwrotnie? | wzrost lęku podnosi odpowiedzi na wszystkie pozycje | zmiana jednego zachowania zmienia poziom konstruktu |
| 2. Wymienność wskaźników | Czy wskaźniki mają wspólną treść i czy usunięcie jednego zmienia definicję konstruktu? | pozycje są parafrazami tej samej treści; jedną można pominąć | każdy wskaźnik pokrywa inny aspekt; usunięcie zawęża konstrukt |
| 3. Współzmienność wskaźników | Czy zmiana jednego wskaźnika powinna iść w parze ze zmianą pozostałych? | tak, wskaźniki powinny korelować | niekoniecznie; korelacje mogą być niskie |
| 4. Sieć nomologiczna wskaźników | Czy wskaźniki mają te same przyczyny i skutki? | tak, bo wszystkie odzwierciedlają ten sam konstrukt | nie, każdy wskaźnik może mieć inne przyczyny i skutki |
Zastosujmy kryteria do dwóch przykładów. Skala lęku społecznego z pozycjami „Denerwuję się, gdy mam zabrać głos na zajęciach” i „Unikam sytuacji, w których jestem oceniany” spełnia wszystkie cztery warunki refleksyjności: pozycje są wymienne, powinny korelować i mają wspólne przyczyny (np. wcześniejsze doświadczenia oceny). Indeks higieny snu ma odpowiedzi przeciwne w każdym punkcie: to zachowania tworzą higienę, nie są wymienne, nie muszą korelować, a kofeina wieczorem ma inne przyczyny (praca zmianowa, nawyki) niż korzystanie z telefonu w łóżku.
Trudniejsze są konstrukty, których nazwa nie przesądza sprawy. „Stres zawodowy” mierzony pozycjami o odczuwanym napięciu jest refleksyjny, a mierzony listą stresorów (przeciążenie, konflikt ról, niepewność zatrudnienia) – formatywny. Edwards i Bagozzi (2000) podkreślają, że kierunek związku między konstruktem a miarą wynika z definicji konstruktu i z treści pozycji, więc ta sama nazwa może kryć dwa różne modele. Dlatego najpierw zapisz definicję konstruktu, a dopiero potem wybierz model pomiaru, jak przy każdej operacjonalizacji.
| Konstrukt i sposób pomiaru | Model | Uzasadnienie |
|---|---|---|
| Objawy depresyjne (smutek, anhedonia, poczucie winy w ostatnich dwóch tygodniach) | zwykle refleksyjny | objawy traktuje się jako przejawy wspólnego stanu; w modelach sieciowych bywa to kwestionowane |
| Status społeczno-ekonomiczny (dochód, wykształcenie, prestiż zawodu) | formatywny | wzrost dochodu podnosi status, a nie odwrotnie; wskaźniki nie są wymienne |
| Satysfakcja z pracy mierzona ogólnymi pozycjami („Ogólnie jestem zadowolony z pracy”) | refleksyjny | pozycje są parafrazami jednej oceny |
| Satysfakcja z pracy jako suma ocen aspektów (płaca, przełożony, rozwój) | formatywny albo konstrukt wyższego rzędu | aspekty są różnymi źródłami zadowolenia; zob. konstrukt wyższego rzędu |
| Doświadczenia niekorzystne w dzieciństwie (lista zdarzeń) | formatywny (kompozyt) | zdarzenia są niezależnymi źródłami obciążenia, ich liczba tworzy indeks |
Czego nie powiedzą Ci dane
Kusi, by o modelu pomiaru zdecydować na podstawie wyników: niska alfa – formatywny, wysoka – refleksyjny. To błąd w obie strony. Wskaźniki formatywne mogą przypadkiem silnie korelować (np. dochód i wykształcenie), a pozycje refleksyjne mogą korelować słabo, gdy skala jest źle napisana. Bollen i Ting (2000) zaproponowali konfirmacyjny test tetrad, który porównuje zanikające tetrady (iloczyny kowariancji) implikowane przez model wskaźników efektów i model wskaźników przyczynowych. Sami autorzy zastrzegają jednak, że jest to narzędzie testowania teorii, a nie jej zastępstwo, i że modele równoważne mogą dawać te same tetrady.
Jeszcze ważniejsze jest to, że dopasowanie modelu nie chroni przed błędnym kierunkiem. Rhemtulla i in. (2020) pokazują, że gdy dane, które nie pochodzą z modelu wspólnego czynnika, mimo to modeluje się jako czynnik, oszacowania związków między konstruktami mogą być silnie obciążone, i to nawet przy idealnym dopasowaniu. W części sytuacji lepiej działały modele kompozytowe. Wniosek autorów jest taki sam jak w kryteriach Jarvis i in. (2003): model pomiaru trzeba uzasadnić merytorycznie, a nie tylko statystycznie. Następna sekcja pokazuje to na liczbach.
Symulacja: co się dzieje, gdy formatywny konstrukt potraktujesz jak refleksyjny
Przykład (dane symulowane): 400 studentów odpowiada, ile razy w ostatnim tygodniu (1) kładło się spać o nieregularnej porze, (2) korzystało z ekranu w ostatniej godzinie przed snem, (3) piło kawę po 16:00 i (4) drzemało w ciągu dnia. Konstrukt „ryzykowne nawyki snu” jest ważoną sumą tych zachowań, z wagami .45, .35, .25 i .15, i wpływa na senność w ciągu dnia, mierzoną trzema pozycjami refleksyjnymi. Prawdziwy standaryzowany współczynnik ścieżki nawyki → senność wynosi β = .50.
W jednej próbie korelacje między czterema zachowaniami wynosiły od .18 do .29, a alfa Cronbacha dla „skali” zachowań – α = .528. Badacz, który traktuje zachowania jako pozycje refleksyjnej skali, szacuje model z czynnikiem nawyków wyznaczonym przez cztery wskaźniki. Model jest dobrze dopasowany: χ²(13) = 16.57, p = .220, CFI = .993, RMSEA = .026, SRMR = .032. Mimo to ścieżka do senności wynosi β = .689, czyli o 38% więcej niż wartość prawdziwa. Model kompozytowy, zgodny z tym, jak dane powstały, daje β = .521.
Równie pouczające są parametry pomiarowe. W modelu refleksyjnym „ładunki” czterech zachowań są do siebie podobne: .46, .54, .42 i .43. Sugerują, że drzemki są tak samo ważne jak nieregularne pory zasypiania. W modelu kompozytowym standaryzowane wagi wynoszą .51, .56, .35 i .07, więc drzemki prawie nic nie wnoszą. Model refleksyjny zmienia więc nie tylko wielkość ścieżki, ale i znaczenie konstruktu: czynnik reprezentuje to, co zachowania mają wspólnego, a nie ich ważoną sumę.
Jedna próba może być przypadkowa, dlatego powtórzyliśmy eksperyment 300 razy dla trzech poziomów korelacji między zachowaniami (.10, .30 i .50). Rysunek 1 pokazuje wyniki.
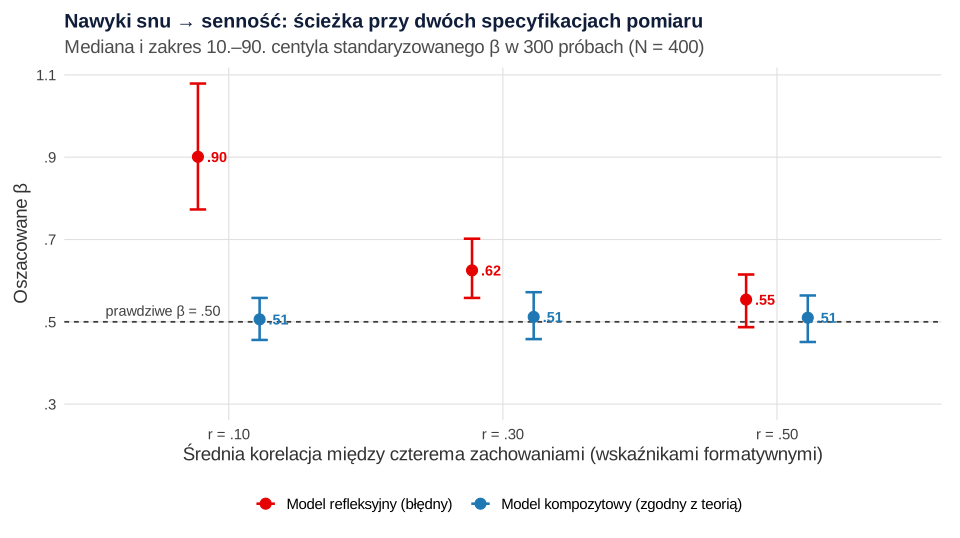
Model kompozytowy dawał we wszystkich warunkach oszacowania skupione wokół wartości prawdziwej (mediany .506–.512). Model refleksyjny zawyżał ścieżkę tym bardziej, im słabiej korelowały zachowania: mediana β wynosiła .901 przy korelacjach .10, .625 przy .30 i .554 przy .50. Przy korelacjach .10 w 21% prób rozwiązanie było niedopuszczalne (np. ujemna wariancja), a w 10% prób oszacowanie β przekraczało 1.079. Najbardziej niepokojące jest jednak to, że błędny model rzadko zdradzał się w dopasowaniu: CFI ≥ .95 osiągnął w 99.7–100% prób, a test χ² odrzucał go tylko w 11.0–25.3% prób. Po samym dopasowaniu nie poznasz, że model pomiaru jest źle dobrany.
Kierunek i wielkość obciążenia zależą od tego, czy błędnie określony konstrukt jest przyczyną, czy skutkiem w modelu, oraz od wag i korelacji wskaźników. W symulacjach MacKenzie i in. (2005) błędna specyfikacja zawyżała niestandaryzowane współczynniki strukturalne nawet o 400% albo zaniżała je nawet o 80% i prowadziła do błędów I lub II rodzaju, zależnie od tego, czy błędnie określono konstrukt egzogeniczny, czy endogeniczny.
Jak oszacować konstrukt formatywny w CB-SEM
Konstrukt formatywny jest trudniejszy do oszacowania niż refleksyjny, bo jego wariancja i zakłócenie nie wynikają z kowariancji samych wskaźników. MacCallum i Browne (1993) pokazali, że obecność wskaźników przyczynowych może powodować problemy z identyfikacją modelu i że modele te często zakładają zerowe korelacje wielu zmiennych obserwowanych. Masz cztery podstawowe możliwości:
- Kompozyt o stałych wagach. Gdy indeks ma ustaloną teoretycznie budowę (np. liczba zdarzeń z listy), policz go jako sumę lub średnią i wprowadź do modelu jako zmienną jawną. To proste i przejrzyste rozwiązanie, ale zakłada, że wagi znasz z góry.
- Kompozyt o wagach szacowanych. W lavaan zapisuje się go operatorem
<~. Wagi są wtedy dobierane tak, by kompozyt najlepiej odtwarzał związki z innymi zmiennymi w modelu, więc ich znaczenie zależy od tych zmiennych. - Wskaźniki przyczynowe z co najmniej dwoma skutkami. Zmienna ukryta ma zakłócenie, a identyfikację zapewniają dwie (lub więcej) ścieżki wychodzące do innych konstruktów lub wskaźników. Szczegóły i przykład opisuje hasło formatywna zmienna latentna.
- Model MIMIC, w którym jedna zmienna ukryta ma jednocześnie przyczyny i wskaźniki refleksyjne (Jöreskog i Goldberger, 1975). To najczęstsze rozwiązanie w psychologii, ale – jak zobaczysz niżej – trzeba go ostrożnie interpretować.
W PLS-SEM konstrukty formatywne szacuje się zwykle w trybie B (zob. Model A i Model B w PLS-PM), a ich wagi opisuje hasło waga zewnętrzna. Kiedy wybrać tę rodzinę metod zamiast CB-SEM, omawiamy w poradniku PLS-SEM czy CB-SEM.
Model MIMIC krok po kroku
Przykład (dane symulowane): 350 studentów podało, ile dni w ostatnim tygodniu (0–7) kładło się spać o stałej porze (h1), korzystało z ekranu w ostatniej godzinie przed snem (h2), piło kawę po 16:00 (h3) i drzemało w dzień (h4). Wypełnili też trzy pozycje o problemach ze snem (skala 1–5): trudność z zasypianiem (p1), wybudzenia w nocy (p2) i niewyspanie rano (p3). Pytanie badawcze brzmi: które zachowania wiążą się z problemami ze snem i w jakim stopniu razem je wyjaśniają? Dane do powtórzenia analizy: model-refleksyjny-czy-formatywny-mimic-dane.csv (350 wierszy, 7 kolumn).
Zachowania prawie ze sobą nie korelowały (r od −.06 do .18), więc jako skala refleksyjna nie miałyby sensu. W modelu MIMIC są przyczynami zmiennej ukrytej „problemy ze snem”, którą wyznaczają trzy wskaźniki refleksyjne. Model oszacowano w lavaan estymatorem MLR, odpowiednim dla pozycji z pięcioma kategoriami odpowiedzi. Dopasowanie było bardzo dobre: χ²(8) = 4.40, p = .820, CFI = 1.000, RMSEA = .000, SRMR = .015.
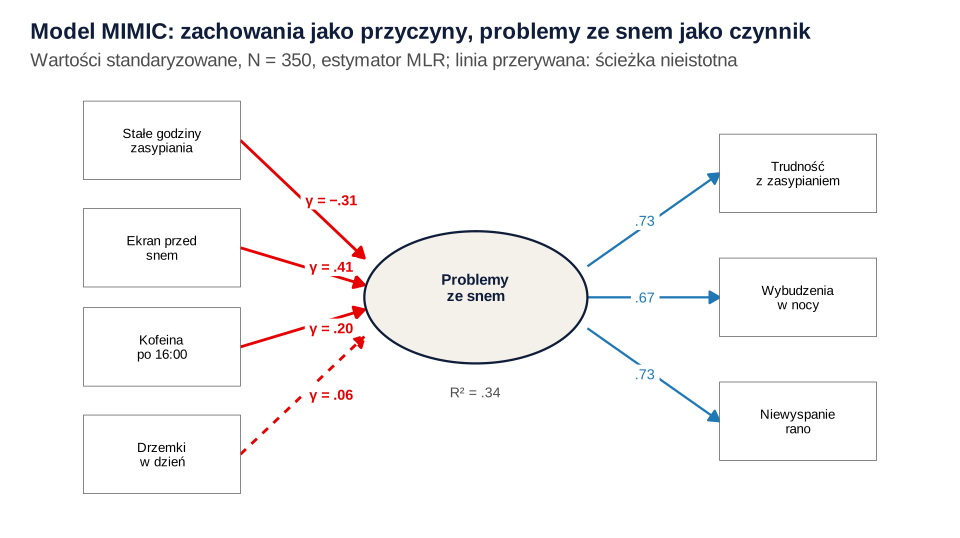
Ładunki wskaźników refleksyjnych wynosiły .73, .67 i .73. Najsilniej z problemami ze snem wiązało się korzystanie z ekranu przed snem (γ = .41, 95% CI [.33, .50]), następnie stałe godziny zasypiania (γ = −.31, 95% CI [−.41, −.21]) i kofeina po 16:00 (γ = .20, 95% CI [.10, .30]). Drzemki nie miały istotnego związku z czynnikiem (γ = .06, 95% CI [−.04, .17], p = .224). Cztery zachowania razem wyjaśniały 33.8% wariancji problemów ze snem; po usunięciu drzemek – 33.4%, a pozostałe współczynniki prawie się nie zmieniły (−.31, .42 i .21).
Jak to czytać? Współczynniki γ mówią, o ile odchyleń standardowych zmienia się poziom problemów ze snem przy zmianie danego zachowania o jedno odchylenie standardowe i stałych pozostałych zachowaniach. To sformułowanie jest celowo ostrożne: dane są przekrojowe, więc model opisuje związki, a nie wykazane skutki zmian zachowań.
MIMIC ma dwa założenia, które łatwo przeoczyć. Po pierwsze, przyczyny wpływają na wskaźniki wyłącznie przez zmienną ukrytą. Jöreskog i Goldberger (1975) pokazali, że model implikuje macierz współczynników regresji wskaźników na przyczyny rzędu 1, czyli proporcjonalne efekty wszystkich przyczyn na wszystkie wskaźniki. Sprawdza się to testem punktowym (score) dla efektów bezpośrednich przyczyn na wskaźniki. W naszym przykładzie żaden z 12 możliwych efektów bezpośrednich nie był istotny – największy dotyczył wpływu stałych godzin zasypiania na wybudzenia w nocy, χ²(1) = 1.83, p = .176. Gdyby któryś efekt był wyraźny, oznaczałoby to, że zachowanie wiąże się z jednym objawem bardziej, niż wynika z jego związku z czynnikiem.
Po drugie, znaczenie zmiennej ukrytej w MIMIC wyznaczają wskaźniki refleksyjne, a nie przyczyny. Nasz czynnik to „problemy ze snem”, a nie „higiena snu”, i dlatego nazwaliśmy go zgodnie z treścią wskaźników. Edwards (2011) argumentuje, że cele pomiaru formatywnego można osiągnąć modelami, w których konstrukty mają wskaźniki refleksyjne, a ich przyczyny modeluje się jawnie – i model MIMIC jest dokładnie taką konstrukcją. Bollen i Diamantopoulos (2017) bronią z kolei wskaźników przyczynowo-formatywnych, gdy teoria wyraźnie określa konstrukt jako wynik przyczyn. Niezależnie od stanowiska nie opisuj czynnika z MIMIC nazwą indeksu przyczyn, jeśli jego wariancja pochodzi z pozycji o objawach.
Jak ocenić jakość pomiaru formatywnego
Kryteriów jakości skali refleksyjnej – ładunków, omegi, AVE, trafności zbieżnej – nie przenoś na indeks formatywny. Diamantopoulos i Winklhofer (2001) opisują w zamian procedurę budowy indeksu i sposoby oceny jakości miar formatywnych, a Cenfetelli i Bassellier (2009) – zasady interpretacji wyników, m.in. współliniowość, liczbę wskaźników, wagi ujemne oraz bezwzględny i względny wkład wskaźnika. Na tej podstawie sprawdź:
- Specyfikacja treści. Indeks musi pokrywać całą definicję konstruktu. Brakujący składnik oznacza inny konstrukt, a nie „krótszą skalę”.
- Współliniowość. Wysokie korelacje wskaźników utrudniają oszacowanie wag; sprawdź współliniowość, np. przez VIF.
- Wagi i ich znaki. Waga nieistotna nie jest automatycznie powodem do usunięcia wskaźnika: Cenfetelli i Bassellier (2009) przypominają, że trzeba rozróżnić bezwzględny wkład wskaźnika (jego związek z konstruktem) od względnego (waga przy kontroli pozostałych). Wagi ujemne przy dodatnich korelacjach zwykle sygnalizują współliniowość.
- Liczba wskaźników. Im więcej wskaźników formatywnych, tym mniejsze i mniej stabilne pojedyncze wagi.
- Trafność zewnętrzna. Indeks powinien wiązać się z miarą globalną tego samego konstruktu (np. jedną pozycją „Ogólnie dbam o higienę snu”) albo z teoretycznie przewidywanymi skutkami.
Jeśli konstrukt okaże się refleksyjny, pracujesz według zwykłej ścieżki: analiza czynnikowa, rzetelność i trafność. Cały proces tworzenia nowego narzędzia opisuje poradnik jak zbudować i zwalidować skalę psychometryczną.
Jak opisać decyzję w artykule
Recenzenci coraz częściej pytają o uzasadnienie modelu pomiaru, zwłaszcza gdy konstrukt ma niską spójność wewnętrzną. W sekcji metody podaj definicję konstruktu, odpowiedzi na kryteria decyzji, sposób oszacowania i wynik sprawdzenia założeń. Wzór dla przykładu MIMIC:
Jeśli sprawdzasz, jak decyzja wpływa na wnioski, opisz to jako analizę wrażliwości: oszacuj model zarówno z indeksem formatywnym, jak i (dla porównania) z czynnikiem refleksyjnym i pokaż, czy zmieniają się wnioski. Ogólne zasady raportowania modeli SEM opisuje przewodnik po modelowaniu równań strukturalnych, a kompletny przykład kodu – poradnik CB-SEM w R.
Najczęstsze błędy
- Decyzja na podstawie alfy. Niska alfa nie dowodzi formatywności, a wysoka – refleksyjności. Rozstrzyga definicja konstruktu i treść wskaźników.
- Usuwanie wskaźników formatywnych o niskich „ładunkach”. W indeksie każdy składnik pokrywa inny aspekt konstruktu; po jego usunięciu mierzysz coś węższego.
- Traktowanie dobrego dopasowania jako dowodu poprawnego kierunku. W naszej symulacji model refleksyjny był dobrze dopasowany, a ścieżka i tak była zawyżona.
- Konstrukt formatywny bez identyfikacji. Zmienna z wskaźnikami przyczynowymi i tylko jednym skutkiem nie jest identyfikowana; potrzebujesz co najmniej dwóch ścieżek wychodzących albo kompozytu.
- Nazwa nieodpowiadająca treści. Czynnik w modelu MIMIC nazywaj według wskaźników refleksyjnych, a przyczyny opisuj jako przyczyny.
- Język przyczynowy w danych przekrojowych. Strzałka w modelu formatywnym to założenie pomiarowe, a nie wynik badania – zob. korelacja a przyczynowość.
Jeśli przygotowujesz artykuł i nie wiesz, jak zapisać konstrukt o niejednoznacznej strukturze, możemy przejrzeć definicję, pozycje i model razem z Tobą w ramach konsultacji dla badaczy, tak by uzasadnienie wytrzymało recenzję.
Przykład w R
Kod odtwarza wszystkie liczby z tego poradnika. Przepis 1 zawiera symulację (kilka minut obliczeń), przepis 2 – model MIMIC; przepis 2 zapisuje też plik CSV z danymi do pobrania.
1. Błędna specyfikacja: konstrukt formatywny jako czynnik refleksyjny
R
# P6, przepis 1: co się dzieje, gdy konstrukt formatywny potraktujesz jak refleksyjny (dane symulowane)
# Ryzykowne nawyki snu = ważona suma czterech zachowań (nieregularne pory, ekran przed snem, kofeina po 16:00, drzemki),
# która wpływa na senność w ciągu dnia (czynnik refleksyjny z trzema pozycjami). Prawdziwe β = .50.
library(lavaan)
wagi <- c(0.45, 0.35, 0.25, 0.15)                 # nierówne wagi składników
generuj <- function(n, rho, beta = 0.50) {
  S <- matrix(rho, 4, 4); diag(S) <- 1
  x <- MASS::mvrnorm(n, rep(0, 4), S)
  C <- as.vector(x %*% wagi); C <- C / sqrt(drop(t(wagi) %*% S %*% wagi))   # nawyki snu (wariancja 1)
  eta <- beta * C + rnorm(n, 0, sqrt(1 - beta^2))                          # senność (wariancja 1)
  y <- sapply(c(0.80, 0.75, 0.70), function(l) l * eta + rnorm(n, 0, sqrt(1 - l^2)))
  d <- data.frame(x, y); names(d) <- c(paste0("h", 1:4), paste0("s", 1:3)); d
}
m_refleksyjny <- '
  NS =~ h1 + h2 + h3 + h4
  SEN =~ s1 + s2 + s3
  SEN ~ NS'
m_kompozyt <- '
  NS <~ 1*h1 + h2 + h3 + h4
  SEN =~ s1 + s2 + s3
  SEN ~ NS'
beta_std <- function(f) { s <- standardizedSolution(f); s$est.std[s$op == "~"] }

# Jedno badanie: N = 400, korelacje zachowań .20
set.seed(606)
d <- generuj(400, 0.20)
r4 <- cor(d[, 1:4]); round(range(r4[upper.tri(r4)]), 2)          # zakres korelacji zachowań
alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
round(alfa(d[, 1:4]), 3)                                   # alfa Cronbacha „skali” zachowań
f_r <- sem(m_refleksyjny, data = d); f_k <- sem(m_kompozyt, data = d)
round(rbind(refleksyjny = fitMeasures(f_r, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")),
            kompozyt    = fitMeasures(f_k, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))), 3)
round(c(beta_refleksyjny = beta_std(f_r), beta_kompozyt = beta_std(f_k)), 3)
s_r <- standardizedSolution(f_r); s_r$est.std <- round(s_r$est.std, 3)
s_r[s_r$op == "=~" & s_r$lhs == "NS", c("rhs", "est.std")]          # „ładunki” w modelu refleksyjnym
s_k <- standardizedSolution(f_k); s_k$est.std <- round(s_k$est.std, 3)
s_k[s_k$op == "<~", c("rhs", "est.std")]                             # wagi w modelu kompozytowym

# Symulacja: korelacje zachowań .10 / .30 / .50, N = 400, 300 powtórzeń w każdym warunku
set.seed(6060)
sym <- do.call(rbind, lapply(c(0.10, 0.30, 0.50), function(rho) {
  w <- t(replicate(300, {
    d <- generuj(400, rho)
    f_r <- suppressWarnings(sem(m_refleksyjny, data = d)); f_k <- suppressWarnings(sem(m_kompozyt, data = d))
    ok_r <- lavInspect(f_r, "converged") && suppressWarnings(lavInspect(f_r, "post.check"))
    c(b_r = if (lavInspect(f_r, "converged")) beta_std(f_r) else NA, ok_r = ok_r,
      p_r = if (lavInspect(f_r, "converged")) unname(fitMeasures(f_r, "pvalue")) else NA,
      cfi_r = if (lavInspect(f_r, "converged")) unname(fitMeasures(f_r, "cfi")) else NA,
      b_k = beta_std(f_k))
  }))
  data.frame(rho = rho,
             beta_refl_mediana = median(w[, "b_r"], na.rm = TRUE),
             beta_refl_p10 = quantile(w[, "b_r"], .10, na.rm = TRUE),
             beta_refl_p90 = quantile(w[, "b_r"], .90, na.rm = TRUE),
             refl_niedopuszczalne = mean(w[, "ok_r"] == 0),
             refl_chi2_odrzuca = mean(w[, "p_r"] < .05, na.rm = TRUE),
             refl_CFI_od_95 = mean(w[, "cfi_r"] >= .95, na.rm = TRUE),
             beta_komp_mediana = median(w[, "b_k"]),
             beta_komp_p10 = quantile(w[, "b_k"], .10),
             beta_komp_p90 = quantile(w[, "b_k"], .90),
             row.names = NULL)
}))
sym[, -1] <- round(sym[, -1], 3)
sym
saveRDS(sym, "kod/p6-symulacja.rds")
Wynik w R
[1] 0.18 0.29
[1] 0.528
             chisq df pvalue   cfi rmsea  srmr
refleksyjny 16.569 13  0.220 0.993 0.026 0.032
kompozyt     2.664  8  0.954 1.000 0.000 0.009
beta_refleksyjny    beta_kompozyt
           0.689            0.521
  rhs est.std
1  h1   0.464
2  h2   0.540
3  h3   0.418
4  h4   0.434
  rhs est.std
1  h1   0.510
2  h2   0.556
3  h3   0.348
4  h4   0.071
  rho beta_refl_mediana beta_refl_p10 beta_refl_p90 refl_niedopuszczalne
1 0.1             0.901         0.773         1.079                 0.21
2 0.3             0.625         0.558         0.702                 0.00
3 0.5             0.554         0.487         0.615                 0.00
  refl_chi2_odrzuca refl_CFI_od_95 beta_komp_mediana beta_komp_p10
1             0.110          0.997             0.506         0.456
2             0.253          1.000             0.512         0.458
3             0.180          1.000             0.510         0.451
  beta_komp_p90
1         0.558
2         0.572
3         0.564
2. Model MIMIC: zachowania jako przyczyny problemów ze snem
R
# P6, przepis 2: model MIMIC – zachowania związane ze snem jako przyczyny, problemy ze snem jako czynnik refleksyjny
# Dane symulowane: 350 studentów. Przyczyny (liczba dni w ostatnim tygodniu, 0–7):
# h1 stałe godziny zasypiania, h2 ekran w ostatniej godzinie przed snem, h3 kofeina po 16:00, h4 drzemki w dzień.
# Wskaźniki (1–5): p1 trudność z zasypianiem, p2 wybudzenia w nocy, p3 niewyspanie rano.
library(lavaan)
set.seed(6262)
n <- 350
dni <- function(p) rbinom(n, 7, p)
h1 <- dni(0.55); h2 <- dni(0.65); h3 <- dni(0.35); h4 <- dni(0.25)
z <- function(x) (x - mean(x)) / sd(x)
eta <- -0.35 * z(h1) + 0.30 * z(h2) + 0.25 * z(h3) + 0.05 * z(h4) + rnorm(n, 0, 0.82)
skala <- function(l) as.integer(cut(l * z(eta) + rnorm(n, 0, sqrt(1 - l^2)), c(-Inf, -1.2, -0.4, 0.4, 1.2, Inf)))
dane <- data.frame(h1, h2, h3, h4, p1 = skala(0.80), p2 = skala(0.70), p3 = skala(0.75))
round(sapply(dane, mean), 2)
round(cor(dane[, 1:4]), 2)[upper.tri(diag(4))]                 # przyczyny prawie nie korelują

mimic <- '
  PS =~ p1 + p2 + p3                 # problemy ze snem (wskaźniki refleksyjne)
  PS ~ h1 + h2 + h3 + h4             # przyczyny (zachowania)
'
f <- sem(mimic, data = dane, estimator = "MLR")
round(fitMeasures(f, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "rmsea.robust", "srmr")), 3)
s <- standardizedSolution(f)
w <- s[s$op %in% c("=~", "~"), c("lhs", "op", "rhs", "est.std", "pvalue", "ci.lower", "ci.upper")]
w[, 4:7] <- round(w[, 4:7], 3); w
round(lavInspect(f, "r2")["PS"], 3)
# MIMIC zakłada, że przyczyny działają na wskaźniki tylko przez czynnik – sprawdź efekty bezpośrednie
bezposrednie <- paste0("p", rep(1:3, each = 4), " ~ h", rep(1:4, 3), collapse = "\n")
st <- lavTestScore(f, add = bezposrednie, univariate = TRUE, cumulative = FALSE)$uni
st <- st[order(-st$X2), c("lhs", "op", "rhs", "X2", "p.value")]
st$X2 <- round(st$X2, 2); st$p.value <- round(st$p.value, 3); head(st, 3)
# Ten sam model bez h4 (drzemki): czy zmienia się znaczenie czynnika? Porównaj γ pozostałych przyczyn
f2 <- sem(sub("\\+ h4", "", mimic), data = dane, estimator = "MLR")
s2 <- standardizedSolution(f2); round(s2$est.std[s2$op == "~"], 3)
round(lavInspect(f2, "r2")["PS"], 3)
write.csv(dane, "model-refleksyjny-czy-formatywny-mimic-dane.csv", row.names = FALSE)
Wynik w R
  h1   h2   h3   h4   p1   p2   p3
3.79 4.59 2.37 1.72 3.06 3.02 3.01
[1] -0.06  0.02  0.04  0.01  0.07  0.18
 chisq.scaled     df.scaled pvalue.scaled    cfi.robust  rmsea.robust
        4.397         8.000         0.820         1.000         0.000
         srmr
        0.015
  lhs op rhs est.std pvalue ci.lower ci.upper
1  PS =~  p1   0.726  0.000    0.653    0.799
2  PS =~  p2   0.673  0.000    0.597    0.750
3  PS =~  p3   0.729  0.000    0.651    0.806
4  PS  ~  h1  -0.309  0.000   -0.411   -0.207
5  PS  ~  h2   0.413  0.000    0.325    0.502
6  PS  ~  h3   0.197  0.000    0.096    0.298
7  PS  ~  h4   0.064  0.224   -0.039    0.167
   PS
0.338
    lhs op rhs   X2 p.value
5 p2~h1 ==   0 1.83   0.176
9 p3~h1 ==   0 1.37   0.242
7 p2~h3 ==   0 1.24   0.265
[1] -0.308  0.418  0.208
   PS
0.334
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lavaan; dane wielowymiarowe losowano funkcją mvrnorm() z pakietu MASS, a rysunki przygotowano w pakietach ggplot2 i ggforce. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggforce (wersja 0.5.0): Pedersen, T. L. (2025). ggforce: Accelerating ggplot2 (R package version 0.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.ggforce
Najczęstsze pytania
Jak sprawdzić, czy konstrukt jest refleksyjny, czy formatywny?
Odpowiedz na cztery pytania Jarvis i in. (2003): czy to konstrukt powoduje zmiany wskaźników, czy odwrotnie; czy wskaźniki są wymienne; czy powinny ze sobą korelować; i czy mają te same przyczyny i skutki. Odpowiedzi „konstrukt → wskaźniki”, „tak”, „tak”, „tak” wskazują na model refleksyjny, przeciwne – na formatywny. Rozstrzyga definicja konstruktu i treść pozycji, a nie wynik analizy danych.
Czy niska alfa Cronbacha oznacza, że skala jest formatywna?
Nie. Niska alfa może wynikać ze źle napisanych pozycji skali refleksyjnej, a wskaźniki formatywne mogą przypadkiem silnie korelować. W modelu formatywnym spójność wewnętrzna po prostu nie jest kryterium jakości, ale jej niska wartość nie dowodzi formatywności – decyzję podejmij na podstawie definicji konstruktu.
Co się stanie, gdy konstrukt formatywny potraktuję jako refleksyjny?
Zmieni się znaczenie konstruktu i oszacowania związków z innymi zmiennymi. W symulacjach MacKenzie i in. (2005) błędna specyfikacja zawyżała współczynniki strukturalne nawet o 400% albo zaniżała je nawet o 80%. W naszej symulacji ścieżka o prawdziwej wartości .50 miała w błędnym modelu medianę .55–.90, a dopasowanie zwykle wyglądało dobrze.
Jak oszacować model MIMIC w lavaan?
Zapisz czynnik z wskaźnikami refleksyjnymi operatorem =~ i regresję czynnika na przyczyny operatorem ~, np. PS =~ p1 + p2 + p3 i PS ~ h1 + h2 + h3 + h4, a następnie użyj funkcji sem(). Sprawdź dopasowanie i testami punktowymi (lavTestScore()) efekty bezpośrednie przyczyn na wskaźniki, bo MIMIC zakłada, że przyczyny działają tylko przez czynnik.
Czy wskaźniki formatywne można usuwać z modelu, gdy mają nieistotne wagi?
Ostrożnie. Każdy wskaźnik formatywny pokrywa inny aspekt konstruktu, więc jego usunięcie zawęża definicję tego, co mierzysz. Nieistotna waga może wynikać ze współliniowości z innymi wskaźnikami, a nie z braku znaczenia; oceń też bezwzględny wkład wskaźnika (jego związek z konstruktem) i uzasadnienie teoretyczne.
Powiązane hasła
Przeczytaj też
Modelowanie zmiennych i konstruktów wyższego rzędu
Jak odróżnić wspólny czynnik od kompozytu, wybrać typ modelu drugiego rzędu, zwalidować obie warstwy i poprawnie opisać wynik.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikPLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →Nie wiesz, jak zapisać konstrukt w swoim modelu?
Pomożemy rozstrzygnąć, czy wskaźniki są refleksyjne czy formatywne, oszacować model w R i opisać tę decyzję tak, by wytrzymała recenzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Diamantopoulos, A. (2017). In defense of causal-formative indicators: A minority report. Psychological Methods, 22(3), 581–596. https://doi.org/10.1037/met0000056 ● Otwarty dostęp: pełny tekst
- Bollen, K. A., & Ting, K. (2000). A tetrad test for causal indicators. Psychological Methods, 5(1), 3–22. https://doi.org/10.1037/1082-989x.5.1.3
- Bollen, K., & Lennox, R. (1991). Conventional wisdom on measurement: A structural equation perspective. Psychological Bulletin, 110(2), 305–314. https://doi.org/10.1037/0033-2909.110.2.305
- Cenfetelli, R. T., & Bassellier, G. (2009). Interpretation of formative measurement in information systems research. MIS Quarterly, 33(4), 689–708. https://doi.org/10.2307/20650323
- Diamantopoulos, A., & Winklhofer, H. M. (2001). Index construction with formative indicators: An alternative to scale development. Journal of Marketing Research, 38(2), 269–277. https://doi.org/10.1509/jmkr.38.2.269.18845
- Edwards, J. R. (2011). The fallacy of formative measurement. Organizational Research Methods, 14(2), 370–388. https://doi.org/10.1177/1094428110378369
- Edwards, J. R., & Bagozzi, R. P. (2000). On the nature and direction of relationships between constructs and measures. Psychological Methods, 5(2), 155–174. https://doi.org/10.1037/1082-989x.5.2.155
- Jarvis, C. B., MacKenzie, S. B., & Podsakoff, P. M. (2003). A critical review of construct indicators and measurement model misspecification in marketing and consumer research. Journal of Consumer Research, 30(2), 199–218. https://doi.org/10.1086/376806
- Jöreskog, K. G., & Goldberger, A. S. (1975). Estimation of a Model with Multiple Indicators and Multiple Causes of a Single Latent Variable. Journal of the American Statistical Association, 70(351a), 631–639. https://doi.org/10.1080/01621459.1975.10482485
- MacCallum, R. C., & Browne, M. W. (1993). The use of causal indicators in covariance structure models: Some practical issues. Psychological Bulletin, 114(3), 533–541. https://doi.org/10.1037/0033-2909.114.3.533
- MacKenzie, S. B., Podsakoff, P. M., & Jarvis, C. B. (2005). The problem of measurement model misspecification in behavioral and organizational research and some recommended solutions. Journal of Applied Psychology, 90(4), 710–730. https://doi.org/10.1037/0021-9010.90.4.710
- Rhemtulla, M., van Bork, R., & Borsboom, D. (2020). Worse than measurement error: Consequences of inappropriate latent variable measurement models. Psychological Methods, 25(1), 30–45. https://doi.org/10.1037/met0000220
Cytowania BibTeX
@article{bollen2017defense, author={Bollen, Kenneth A. and Diamantopoulos, Adamantios}, title={{In defense of causal-formative indicators: A minority report}}, journal={Psychological Methods}, year={2017}, volume={22}, number={3}, pages={581--596}, doi={10.1037/met0000056}}@article{bollen2000tetrad, author={Bollen, Kenneth A. and Ting, Kwok-fai}, title={{A tetrad test for causal indicators}}, journal={Psychological Methods}, year={2000}, volume={5}, number={1}, pages={3--22}, doi={10.1037/1082-989x.5.1.3}}@article{bollen1991conventional, author={Bollen, Kenneth and Lennox, Richard}, title={{Conventional wisdom on measurement: A structural equation perspective}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={305--314}, doi={10.1037/0033-2909.110.2.305}}@article{cenfetelli2009interpretation, author={Cenfetelli, Ronald T. and Bassellier, Geneviève}, title={{Interpretation of formative measurement in information systems research}}, journal={MIS Quarterly}, year={2009}, volume={33}, number={4}, pages={689--708}, doi={10.2307/20650323}}@article{diamantopoulos2001index, author={Diamantopoulos, Adamantios and Winklhofer, Heidi M.}, title={{Index construction with formative indicators: An alternative to scale development}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={269--277}, doi={10.1509/jmkr.38.2.269.18845}}@article{edwards2011fallacy, author={Edwards, Jeffrey R.}, title={{The fallacy of formative measurement}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={370--388}, doi={10.1177/1094428110378369}}@article{edwards2000nature, author={Edwards, Jeffrey R. and Bagozzi, Richard P.}, title={{On the nature and direction of relationships between constructs and measures}}, journal={Psychological Methods}, year={2000}, volume={5}, number={2}, pages={155--174}, doi={10.1037/1082-989x.5.2.155}}@article{jarvis2003critical, author={Jarvis, Cheryl Burke and MacKenzie, Scott B. and Podsakoff, Philip M.}, title={{A critical review of construct indicators and measurement model misspecification in marketing and consumer research}}, journal={Journal of Consumer Research}, year={2003}, volume={30}, number={2}, pages={199--218}, doi={10.1086/376806}}@article{joreskog1975estimation, author={Jöreskog, Karl G. and Goldberger, Arthur S.}, title={{Estimation of a Model with Multiple Indicators and Multiple Causes of a Single Latent Variable}}, journal={Journal of the American Statistical Association}, year={1975}, volume={70}, number={351a}, pages={631--639}, doi={10.1080/01621459.1975.10482485}}@article{maccallum1993use, author={MacCallum, Robert C. and Browne, Michael W.}, title={{The use of causal indicators in covariance structure models: Some practical issues}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={533--541}, doi={10.1037/0033-2909.114.3.533}}@article{mackenzie2005problem, author={MacKenzie, Scott B. and Podsakoff, Philip M. and Jarvis, Cheryl Burke}, title={{The problem of measurement model misspecification in behavioral and organizational research and some recommended solutions}}, journal={Journal of Applied Psychology}, year={2005}, volume={90}, number={4}, pages={710--730}, doi={10.1037/0021-9010.90.4.710}}@article{rhemtulla2020worse, author={Rhemtulla, Mijke and van Bork, Riet and Borsboom, Denny}, title={{Worse than measurement error: Consequences of inappropriate latent variable measurement models}}, journal={Psychological Methods}, year={2020}, volume={25}, number={1}, pages={30--45}, doi={10.1037/met0000220}}