PLS-SEM i CB-SEM szacują różne modele, nie tylko różnymi metodami
Pytanie „PLS-SEM czy CB-SEM?” zwykle pada jako pytanie o program albo o liczebność próby. To błąd perspektywy. Obie rodziny metod należą do modelowania równań strukturalnych, ale inaczej rozumieją, czym jest konstrukt:
- CB-SEM (SEM oparte na kowariancjach, np. lavaan, Mplus, AMOS) zakłada model czynnika wspólnego. Konstrukt to zmienna latentna, która powoduje odpowiedzi na wskaźniki, a każdy wskaźnik zawiera też błąd pomiaru. Metoda szuka parametrów, przy których macierz kowariancji odtworzona przez model jest jak najbliższa macierzy z danych. Szczegóły opisujemy w przewodniku CB-SEM krok po kroku.
- PLS-SEM (partial least squares path modeling, np. SmartPLS, seminr, cSEM) buduje konstrukty jako kompozyty – ważone sumy wskaźników – i szacuje wagi tak, by kompozyty dobrze wyjaśniały się nawzajem w modelu ścieżkowym. Logikę metody i ocenę modelu omawia przewodnik PLS-SEM.
Z tej różnicy wynika większość sporów. Rönkkö i Evermann (2013) pokazali na prostych przykładach, że wiele rozpowszechnionych przekonań o zaletach PLS jest nieprawdziwych. Henseler i in. (2014) odpowiedzieli, że krytyka ocenia PLS miarą modelu czynnika wspólnego, a PLS jest właściwym estymatorem modeli kompozytowych. Sarstedt i in. (2016) uporządkowali ten spór: obciążenia pojawiają się wtedy, gdy metoda nie pasuje do modelu, który wygenerował dane – PLS jest obciążony przy danych czynnikowych, a CB-SEM przy danych kompozytowych. Pierwsze pytanie brzmi więc nie „która metoda jest lepsza?”, tylko „jaki model pomiaru opisuje moje konstrukty?”
Najważniejsze różnice w jednej tabeli
| Kryterium | CB-SEM | PLS-SEM |
|---|---|---|
| Model konstruktu | czynnik wspólny (wskaźniki refleksyjne); wskaźniki przyczynowe tylko w modelach specjalnych, np. MIMIC | kompozyt; wagi Mode A albo Mode B; czynniki – przez korektę PLSc |
| Główny cel | test teorii: czy model odtwarza kowariancje | wyjaśnienie i predykcja zmiennych endogenicznych |
| Błąd pomiaru | modelowany wprost | zawarty w kompozytach (bez korekty) |
| Ocena modelu | test χ², CFI, RMSEA, SRMR | rzetelność, trafność, R², f², PLSpredict; testy dopasowania (dULS, dG, SRMR) w nowszym podejściu |
| Wymagania identyfikacji | model musi być zidentyfikowany; konstrukty formatywne wymagają dodatkowych ścieżek | łagodniejsze; formatywne kompozyty bez dodatkowych warunków |
| Typowy estymator | ML, MLR, WLSMV | iteracyjny algorytm PLS + OLS; wnioskowanie bootstrapem |
| Wyniki zmiennych latentnych | nieoznaczone (szacunki czynnikowe wtórne) | jawne wyniki kompozytów dla każdej osoby |
Trzy mity, które nie powinny decydować o wyborze
„PLS działa na małych próbach.” Algorytm PLS zbiega przy małej liczbie obserwacji, ale to nie znaczy, że daje wtedy trafne wyniki. Goodhue i in. (2012) porównali w symulacji PLS, regresję i CB-SEM: przy małych próbach wszystkie trzy metody traciły moc i dokładność, a PLS – podobnie jak regresja na sumach – był stale mniej dokładny niż CB-SEM, bo nie koryguje błędu pomiaru. Mała próba to argument za ostrożnością, nie za PLS. Liczebność planuj analizą mocy, jak w poradniku o doborze liczebności próby.
„PLS nie wymaga normalności.” To prawda w tym sensie, że wnioskowanie opiera się na bootstrapie, a nie na teorii normalnej. Ale Goodhue i in. (2012) stwierdzili, że wszystkie trzy metody były odporne na umiarkowane odstępstwa od normalności w podobnym stopniu. W CB-SEM masz zresztą estymatory odporne (MLR, WLSMV) i bootstrap. Brak normalności nie jest więc powodem do zmiany metody.
„PLS to metoda eksploracyjna, więc nie trzeba oceniać dopasowania.” Henseler i in. (2016) pokazują, że współczesny PLS ma narzędzia konfirmacyjne: PLSc, konfirmacyjną analizę kompozytów, HTMT i testy dokładnego dopasowania. Schuberth i in. (2018) opisali, jak testować model kompozytowy bootstrapem rozbieżności między macierzą z danych a macierzą odtworzoną przez model. Pomijanie oceny dopasowania nie jest cechą metody, tylko skrótem.
Symulacja: kiedy która metoda się myli
Żeby pokazać, gdzie leżą obciążenia, przeprowadziliśmy symulację Monte Carlo w R. Model jest najprostszy z możliwych: konstrukt X wpływa na konstrukt Y, prawdziwa standaryzowana ścieżka wynosi .40, a każdy konstrukt ma cztery wskaźniki. Zmienialiśmy dwie rzeczy:
- model, który wygenerował dane: (1) model czynnika wspólnego z ładunkami .55, .65, .75 i .85 albo (2) model kompozytowy – konstrukt jest ważoną sumą wskaźników, a wskaźniki w bloku korelują niejednorodnie (od .10 do .60) i nie mają wspólnego czynnika;
- liczebność: 100 albo 400 osób, po 500 prób w każdym warunku.
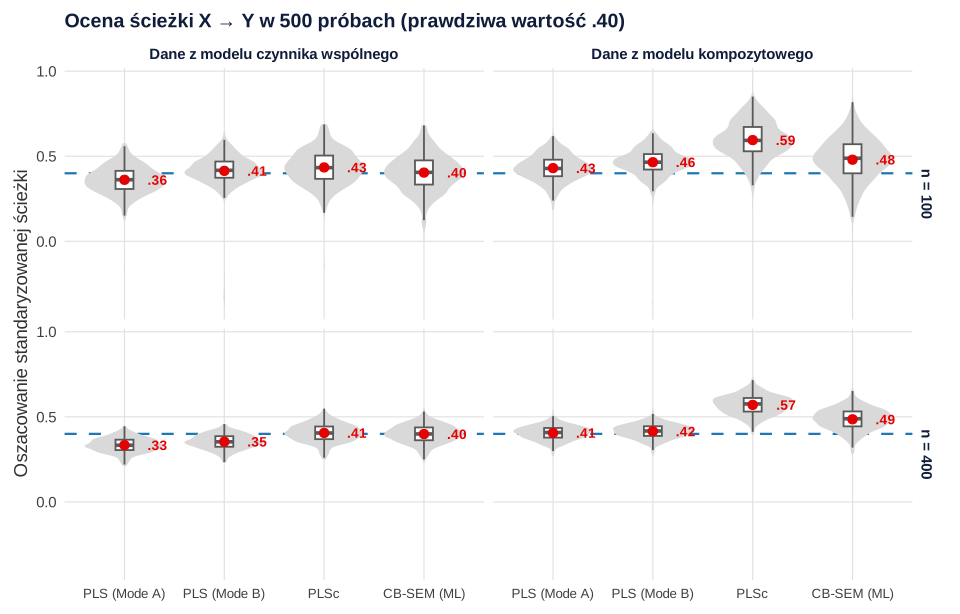
W każdej próbie ścieżkę oszacowały cztery metody: klasyczny PLS z wagami Mode A, PLS z wagami Mode B, consistent PLS (PLSc) i CB-SEM metodą ML. W haśle o PLSc pokazujemy korektę na jednej próbie danych czynnikowych; tutaj interesuje nas, co się dzieje, gdy założenia metody nie pasują do danych. Rysunek 1 pokazuje rozkłady oszacowań.
| Dane z modelu | n | PLS Mode A | PLS Mode B | PLSc | CB-SEM (ML) |
|---|---|---|---|---|---|
| czynnika wspólnego | 100 | −.039 (.091) | .014 (.112) | .034 (.107) | .004 (.109) |
| czynnika wspólnego | 400 | −.066 (.079) | −.046 (.063) | .005 (.054) | −.001 (.054) |
| kompozytowego | 100 | .030 (.083) | .065 (.105) | .195 (.223) | .080 (.159) |
| kompozytowego | 400 | .006 (.043) | .015 (.045) | .170 (.180) | .086 (.107) |
W komórkach: średnie obciążenie (średnia oszacowań minus .40), w nawiasie RMSE. W warunku „kompozytowy, n = 100” CB-SEM nie zbiegł w 2 z 500 prób.
Co z tego wynika?
- Dane czynnikowe: klasyczny PLS zaniża ścieżkę. Przy n = 400 PLS Mode A dawał średnio .334 zamiast .40. Kompozyt zawiera błąd pomiaru, więc korelacja między kompozytami jest osłabiona – to znany efekt atenuacji. Większa próba tego nie naprawia: obciążenie przy n = 400 (−.066) było nawet większe niż przy n = 100 (−.039), choć zmienność oszacowań spadła. PLSc i CB-SEM trafiały w wartość prawdziwą (.405 i .399), zgodnie z wynikami Dijkstry i Henselera (2015).
- Dane kompozytowe: metody czynnikowe zawyżają ścieżkę. PLS (oba tryby wag) był bliski .40, natomiast PLSc dawał średnio .570, a CB-SEM .486. PLSc „koryguje” błąd pomiaru, którego w tym modelu nie ma, więc korekta zawyża związek. To ilustracja tezy Sarstedta i in. (2016): obciążenie zależy od dopasowania metody do modelu danych.
- Mała próba zwiększa rozrzut wszystkich metod. Przy n = 100 RMSE wynosiło od .083 do .223. Na pojedynczej próbie takiej wielkości różnice między metodami łatwo zginą w szumie albo zostaną przez niego wyolbrzymione.
Pamiętaj o granicach tej symulacji. Model ma tylko dwa konstrukty i jedną ścieżkę, dane są ciągłe i mają rozkład normalny, a każdy konstrukt ma cztery wskaźniki. W złożonych modelach z wieloma ścieżkami obciążenia mogą się kumulować albo częściowo znosić, a przy danych porządkowych dochodzi problem doboru estymatora w CB-SEM. Wniosek ogólny pozostaje jednak taki sam: metoda zakładająca inny model pomiaru niż ten, który wygenerował dane, daje obciążone ścieżki, a większa próba tego nie naprawia.
Ten schemat zgadza się z pracą Rhemtulli i in. (2020): gdy dane nie pochodzą z modelu czynnika wspólnego, a modeluje się je jako czynnik wspólny, oszacowania ścieżek mogą być silnie obciążone. Autorzy zaznaczają, że w niektórych sytuacjach modele kompozytowe działają lepiej, a wybór modelu pomiaru trzeba uzasadniać merytorycznie.
Czy dopasowanie modelu ostrzeże przed błędnym wyborem?
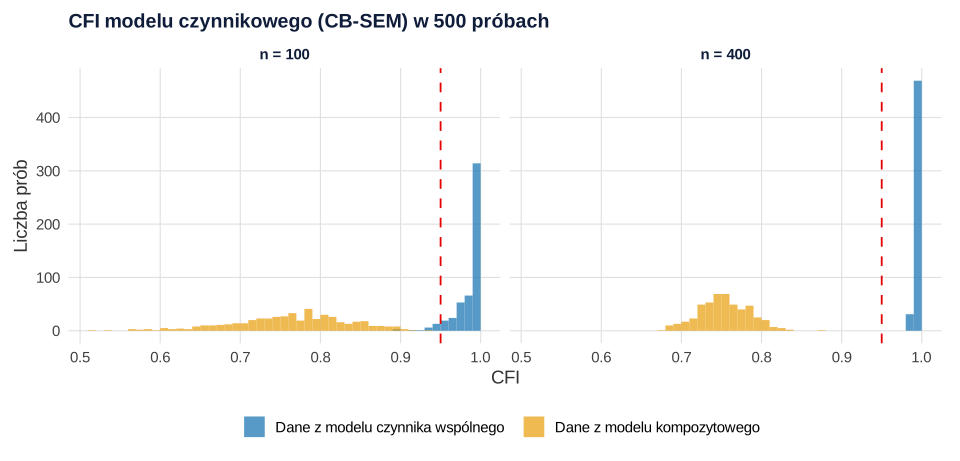
W naszej symulacji – tak, ale tylko w CB-SEM. Rysunek 2 pokazuje CFI modelu czynnikowego w obu „światach”. Przy danych czynnikowych średni CFI wynosił .988 (n = 100) i .998 (n = 400), a 97.6% wszystkich prób osiągało co najmniej .95 – orientacyjny próg Hu i Bentlera (1999). Test χ² odrzucał prawdziwy model w 6.6% i 4.4% prób, czyli blisko nominalnego poziomu 5%. Przy danych kompozytowych CFI wynosił średnio .763 i .753, w żadnej próbie nie przekroczył .935, a test χ² odrzucał model w 100% prób.
Wnioski praktyczne:
- Złe dopasowanie CB-SEM to sygnał, że model pomiaru może być błędny, a nie tylko „formalność do poprawienia” indeksami modyfikacji. Dopisywanie kowariancji błędów może ukryć problem, który leży w samej koncepcji konstruktu.
- PLSc sam w sobie nie ostrzega. Algorytm daje wynik także dla danych kompozytowych – w symulacji zawyżony o .17–.20. Dlatego przy PLSc trzeba ocenić dopasowanie modelu, np. testem opartym na dULS, dG i SRMR, który pokazujemy we wpisie PLS-SEM w R.
- Dobre dopasowanie nie dowodzi, że model pomiaru jest właściwy. Rhemtulla i in. (2020) pokazują, że obciążenie ścieżek może się pojawić nawet przy idealnym dopasowaniu. Dopasowanie wyklucza część błędów, ale nie zastępuje argumentu teoretycznego.
Jak podjąć decyzję: pięć pytań
- Czym są Twoje konstrukty? Jeśli konstrukt jest cechą, która powoduje odpowiedzi (lęk, ekstrawersja, zaangażowanie mierzone zamiennymi pozycjami), opisuje go model czynnikowy – refleksyjny. Jeśli konstrukt jest zbudowany z części, które razem go tworzą (indeks stresorów, status społeczno-ekonomiczny, indeks praktyk zarządczych), lepiej opisuje go kompozyt – zwykle formatywny. Szczegółowe kryteria omawia wpis model refleksyjny czy formatywny.
- Jaki jest cel? Test teorii i ocena, czy model odtwarza dane – to naturalne pole CB-SEM. Predykcja zmiennej wynikowej, np. zamiaru rezygnacji ze studiów, i ocena trafności prognoz poza próbą – to pole, dla którego Shmueli i in. (2019) opisali procedurę PLSpredict.
- Czy model zawiera kompozyty i czynniki jednocześnie? Henseler i in. (2016) wskazują, że PLS jest wtedy metodą z wyboru, bo pozwala modelować oba typy konstruktów: czynniki przez PLSc, kompozyty przez wagi Mode B.
- Jakie są konwencje Twojej dziedziny? W psychologii, gdzie dominują skale refleksyjne, naturalnym wyborem jest zwykle CB-SEM z pełną oceną dopasowania; większość przykładów PLS-SEM pochodzi z badań nad zarządzaniem, marketingiem i systemami informacyjnymi. Konwencja nie jest argumentem merytorycznym, ale wpływa na to, jak szczegółowo musisz uzasadnić wybór.
- Ile masz danych i jak złożony jest model? Przy małej próbie żadna metoda nie da precyzyjnych oszacowań (Goodhue i in., 2012). Złożony model z wieloma konstruktami i małą próbą może jednak sprawiać CB-SEM problemy ze zbieżnością – wtedy rozważ uproszczenie modelu, zanim zmienisz metodę.
| Sytuacja | Rekomendacja | Dlaczego |
|---|---|---|
| Skale psychologiczne (pozycje refleksyjne), test modelu mediacji | CB-SEM | model czynnikowy, potrzebna ocena dopasowania; PLS zaniżyłby ścieżki |
| Skale refleksyjne, ale cel predykcyjny i ocena prognoz | PLS-SEM + PLSpredict, ewentualnie PLSc do oszacowań ścieżek | kompozyty dają wyniki osób do prognozowania; korekta PLSc przybliża parametry czynnikowe |
| Indeks złożony z różnych składników (np. stresory, zasoby) | PLS-SEM (Mode B) albo CB-SEM z modelem MIMIC | konstrukt formatywny; w CB-SEM wymaga dodatkowych warunków identyfikacji |
| Model z konstruktami refleksyjnymi i formatywnymi | PLS-SEM z PLSc dla czynników | oba typy w jednym modelu (Henseler i in., 2016) |
| Bardzo mała próba (np. n < 100) i duży model | uprościć model; obie metody tylko z ostrożną interpretacją | mała próba obniża moc i dokładność każdej metody |
PLSc: most między dwoma światami
Consistent PLS (Dijkstra i Henseler, 2015) to klasyczny PLS z korektą: kompozyty szacuje się zwykłym algorytmem, a następnie ładunki i korelacje między konstruktami koryguje się na niepełną rzetelność, szacowaną współczynnikiem rhoA. Przy danych czynnikowych PLSc daje oszacowania zbliżone do CB-SEM, co potwierdza nasza symulacja (.405 wobec .399 przy n = 400). Przy danych kompozytowych korekta zawyża ścieżki. PLSc jest więc dobrym wyborem, gdy pracujesz w PLS (np. ze względu na kompozyty formatywne w tym samym modelu), a część konstruktów to skale refleksyjne. Nie jest uniwersalnym „ulepszonym PLS”, który zawsze stosuje się zamiast klasycznego.
Hair i in. (2019) zestawiają kryteria oceny i raportowania PLS-SEM, które obowiązują niezależnie od wariantu algorytmu: rzetelność, trafność zbieżną i różnicową, współliniowość, istotność ścieżek, R², f² i ocenę predykcji.
Mediacja, moderacja i konstrukty wyższego rzędu w obu podejściach
Rozszerzenia modelu rzadko przesądzają o wyborze metody, ale w każdej z nich wyglądają trochę inaczej.
- Mediacja. W obu podejściach efekt pośredni to iloczyn ścieżek, a jego przedział ufności wyznacza się bootstrapem. Różnica dotyczy skali: klasyczny PLS przy skalach refleksyjnych zaniża obie ścieżki składowe, więc efekt pośredni jest zaniżony podwójnie. Jeśli mediacja jest głównym pytaniem, a konstrukty są refleksyjne, wybierz CB-SEM albo PLSc.
- Moderacja. W CB-SEM interakcję zmiennych latentnych modeluje się m.in. przez iloczyny wskaźników albo metody oparte na rozkładzie warunkowym; wymaga to sporej próby i uwagi przy identyfikacji. W PLS-SEM najczęściej stosuje się podejście dwuetapowe: najpierw wyniki kompozytów, potem ich iloczyn jako predyktor. Jest prostsze obliczeniowo, ale dziedziczy błąd pomiaru kompozytów.
- Konstrukty wyższego rzędu. W CB-SEM to czynnik drugiego rzędu wyjaśniający korelacje czynników pierwszego rzędu. W PLS-SEM stosuje się m.in. podejście powtarzanych wskaźników albo dwuetapowe. Decyzja, czy konstrukt wyższego rzędu jest refleksyjny, czy formatywny, ma te same konsekwencje co na poziomie wskaźników – omawiamy ją we wpisie o modelowaniu konstruktów wyższego rzędu.
Lista kontrolna przed wyborem metody
- Dla każdego konstruktu zapisz, czy wskaźniki są wymiennymi przejawami jednej cechy, czy składnikami, które razem ją tworzą. Jeśli nie umiesz tego uzasadnić, wróć do teorii, a nie do programu.
- Zapisz cel analizy: test modelu teoretycznego, oszacowanie konkretnych efektów czy predykcja wyniku u nowych osób.
- Sprawdź, czy model jest zidentyfikowany w CB-SEM i ile parametrów szacujesz w stosunku do liczebności próby.
- Zaplanuj ocenę modelu: w CB-SEM – χ², CFI, RMSEA, SRMR i reszty; w PLS-SEM – rzetelność, HTMT, współliniowość, R², f², PLSpredict i testy dopasowania przy PLSc.
- Zaplanuj analizę wrażliwości: ten sam model w drugim podejściu albo w wariancie PLSc.
- Zapisz uzasadnienie w planie analizy (najlepiej w prerejestracji), zanim zobaczysz wyniki obu metod.
Jak uzasadnić wybór metody w artykule
Recenzenci rzadko kwestionują samą metodę. Częściej – argumenty, którymi ją uzasadniono. Słabe uzasadnienia to „mała próba”, „brak normalności” i „model eksploracyjny”. Mocne uzasadnienie odwołuje się do natury konstruktów i celu badania, a uzupełnia je analiza wrażliwości: ten sam model oszacowany drugą metodą. Jeśli wnioski są zgodne, napisz to; jeśli nie – wyjaśnij, z czego wynika różnica.
Przykład pełnej analizy CB-SEM z kodem pokazuje wpis CB-SEM w R z pakietem lavaan, a PLS-SEM – wpis PLS-SEM w R: seminr i cSEM. Przegląd całej rodziny metod SEM, w tym modeli wyższego rzędu i mediacji, znajdziesz we wpisie modelowanie równań strukturalnych (SEM).
Przykład w R
Kod odtwarza symulację, tabelę i oba rysunki (wykresy powstają w ggplot2 z zapisanego pliku p9-symulacja.rds). Pełna symulacja – 2000 prób i 8000 dopasowań modeli – trwa kilka minut. Aby sprawdzić kod szybciej, zmień R <- 500 na R <- 50; liczby będą wtedy mniej stabilne.
Symulacja Monte Carlo: dane czynnikowe i kompozytowe, PLS, PLSc i CB-SEM
R
# PLS-SEM czy CB-SEM – symulacja Monte Carlo: dwa „światy” danych i cztery estymatory
# Model: dwa konstrukty, X -> Y, prawdziwa ścieżka (korelacja konstruktów) = .40, po 4 wskaźniki na konstrukt.
#  Świat 1 – model czynnika wspólnego (refleksyjny): wskaźniki = ładunek × czynnik + błąd; ładunki .55, .65, .75, .85.
#  Świat 2 – model kompozytowy: konstrukt = ważona suma wskaźników (wagi .40, .30, .30, .20),
#            wskaźniki w bloku skorelowane niejednorodnie (.10–.60), bez wspólnego czynnika.
# Estymatory: PLS Mode A, PLS Mode B, PLSc (consistent PLS) – pakiet cSEM; CB-SEM (ML) – pakiet lavaan.
suppressPackageStartupMessages({library(cSEM); library(lavaan); library(MASS)})
beta <- .40

# --- Świat 1: macierz kowariancji modelu czynnikowego
lam <- c(.55, .65, .75, .85)
Lx <- cbind(c(lam, rep(0, 4)), c(rep(0, 4), lam))
S_czynnik <- Lx %*% matrix(c(1, beta, beta, 1), 2) %*% t(Lx); diag(S_czynnik) <- 1

# --- Świat 2: macierz kowariancji modelu kompozytowego
R_blok <- matrix(c(1, .60, .30, .10,
                   .60, 1, .40, .20,
                   .30, .40, 1, .50,
                   .10, .20, .50, 1), 4)
w <- c(.40, .30, .30, .20); w <- w / sqrt(drop(t(w) %*% R_blok %*% w))   # wariancja kompozytu = 1
S12 <- beta * (R_blok %*% w) %*% t(R_blok %*% w)                          # Cov(x1, x2) = Σ11 w ρ w' Σ22
S_kompozyt <- rbind(cbind(R_blok, S12), cbind(t(S12), R_blok))
cat("Wagi populacyjne kompozytu:", round(w, 3), "\n")
cat("Macierz kompozytowa dodatnio określona:", all(eigen(S_kompozyt)$values > 0), "\n")

nazwy <- c(paste0("x", 1:4), paste0("y", 1:4))
dimnames(S_czynnik) <- dimnames(S_kompozyt) <- list(nazwy, nazwy)

m_refl <- 'X =~ x1 + x2 + x3 + x4
           Y =~ y1 + y2 + y3 + y4
           Y ~ X'
m_komp <- 'X <~ x1 + x2 + x3 + x4
           Y <~ y1 + y2 + y3 + y4
           Y ~ X'

jedna <- function(S, n) {
  d <- as.data.frame(mvrnorm(n, rep(0, 8), S)); names(d) <- nazwy
  sc <- function(fit) fit$Estimates$Path_estimates["Y", "X"]
  pls_a <- sc(csem(d, m_refl, .disattenuate = FALSE))
  pls_b <- sc(csem(d, m_komp))
  plsc  <- sc(csem(d, m_refl, .disattenuate = TRUE))
  cb <- tryCatch({
    f <- sem(m_refl, data = d, std.lv = TRUE)
    ss <- standardizedSolution(f)
    c(est = ss$est.std[ss$op == "~"], cfi = unname(fitMeasures(f, "cfi")), p = unname(fitMeasures(f, "pvalue")))
  }, error = function(e) c(est = NA, cfi = NA, p = NA))
  c(PLS_A = pls_a, PLS_B = pls_b, PLSc = plsc, CB_SEM = unname(cb["est"]), CFI = unname(cb["cfi"]), p_chi2 = unname(cb["p"]))
}

R <- 500
set.seed(2009)
wyniki <- do.call(rbind, lapply(c("czynnik", "kompozyt"), function(sw) {
  do.call(rbind, lapply(c(100, 400), function(n) {
    S <- if (sw == "czynnik") S_czynnik else S_kompozyt
    m <- t(replicate(R, suppressWarnings(jedna(S, n))))
    data.frame(swiat = sw, n = n, m)
  }))
}))
saveRDS(wyniki, "p9-symulacja.rds")

# Podsumowanie: średnia ocena, obciążenie (średnia − .40), RMSE, odsetek ocen > 1 (niemożliwych)
est <- c("PLS_A", "PLS_B", "PLSc", "CB_SEM")
pods <- do.call(rbind, lapply(split(wyniki, list(wyniki$swiat, wyniki$n)), function(d)
  do.call(rbind, lapply(est, function(e) {
    x <- d[[e]]
    data.frame(swiat = d$swiat[1], n = d$n[1], estymator = e, srednia = mean(x, na.rm = TRUE),
               obciazenie = mean(x, na.rm = TRUE) - beta, RMSE = sqrt(mean((x - beta)^2, na.rm = TRUE)),
               SD = sd(x, na.rm = TRUE), braki = sum(is.na(x)), powyzej_1 = sum(abs(x) > 1, na.rm = TRUE))
  }))))
pods[, 4:7] <- round(pods[, 4:7], 3); rownames(pods) <- NULL; pods

# Dopasowanie CB-SEM w obu światach: średni CFI i odsetek prób z p testu chi-kwadrat < .05
round(do.call(rbind, lapply(split(wyniki, list(wyniki$swiat, wyniki$n)), function(d)
  c(n = d$n[1], CFI_sr = mean(d$CFI, na.rm = TRUE), odrzucenia_chi2 = mean(d$p_chi2 < .05, na.rm = TRUE)))), 3)
Wynik w R
Wagi populacyjne kompozytu: 0.456 0.342 0.342 0.228
Macierz kompozytowa dodatnio określona: TRUE
      swiat   n estymator srednia obciazenie  RMSE    SD braki powyzej_1
1   czynnik 100     PLS_A   0.361     -0.039 0.091 0.083     0         0
2   czynnik 100     PLS_B   0.414      0.014 0.112 0.111     0         0
3   czynnik 100      PLSc   0.434      0.034 0.107 0.101     0         0
4   czynnik 100    CB_SEM   0.404      0.004 0.109 0.109     0         0
5  kompozyt 100     PLS_A   0.430      0.030 0.083 0.077     0         0
6  kompozyt 100     PLS_B   0.465      0.065 0.105 0.082     0         0
7  kompozyt 100      PLSc   0.595      0.195 0.223 0.109     0         0
8  kompozyt 100    CB_SEM   0.480      0.080 0.159 0.138     2         0
9   czynnik 400     PLS_A   0.334     -0.066 0.079 0.043     0         0
10  czynnik 400     PLS_B   0.354     -0.046 0.063 0.043     0         0
11  czynnik 400      PLSc   0.405      0.005 0.054 0.054     0         0
12  czynnik 400    CB_SEM   0.399     -0.001 0.054 0.054     0         0
13 kompozyt 400     PLS_A   0.406      0.006 0.043 0.042     0         0
14 kompozyt 400     PLS_B   0.415      0.015 0.045 0.042     0         0
15 kompozyt 400      PLSc   0.570      0.170 0.180 0.057     0         0
16 kompozyt 400    CB_SEM   0.486      0.086 0.107 0.064     0         0
               n CFI_sr odrzucenia_chi2
czynnik.100  100  0.988           0.066
kompozyt.100 100  0.763           1.000
czynnik.400  400  0.998           0.044
kompozyt.400 400  0.753           1.000
Dodatkowe liczby do rysunku 2
R
# PLS-SEM czy CB-SEM – liczby do rysunku 2: CFI modelu czynnikowego w obu „światach” danych
w <- readRDS("p9-symulacja.rds")
cat("Zakres CFI – dane kompozytowe:", round(range(w$CFI[w$swiat == "kompozyt"], na.rm = TRUE), 3), "\n")
cat("Odsetek prób z CFI >= .95 – dane czynnikowe:", round(mean(w$CFI[w$swiat == "czynnik"] >= .95), 3), "\n")
cat("Odsetek prób z CFI >= .95 – dane kompozytowe:", round(mean(w$CFI[w$swiat == "kompozyt"] >= .95, na.rm = TRUE), 3), "\n")
Wynik w R
Zakres CFI – dane kompozytowe: 0.52 0.935
Odsetek prób z CFI >= .95 – dane czynnikowe: 0.976
Odsetek prób z CFI >= .95 – dane kompozytowe: 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cSEM (wersja 0.6.1): Rademaker, M. E., & Schuberth, F. (2020). cSEM: Composite-based structural equation modeling (Version 0.6.1) [R package]. https://floschuberth.github.io/cSEM/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy wyborze między PLS-SEM a CB-SEM
- Wybór PLS wyłącznie z powodu małej próby lub braku normalności. Żaden z tych argumentów nie wytrzymuje porównań symulacyjnych (Goodhue i in., 2012).
- Klasyczny PLS dla skal refleksyjnych i interpretacja ścieżek jak parametrów czynnikowych. W symulacji PLS Mode A zaniżał ścieżkę o .066 przy n = 400. Użyj CB-SEM albo PLSc.
- PLSc lub CB-SEM dla konstruktów kompozytowych. Korekta na błąd pomiaru, którego nie ma, zawyża związki.
- Brak oceny dopasowania w PLS-SEM. Raportuj SRMR i testy oparte na dULS i dG, zwłaszcza przy PLSc.
- Poprawianie złego dopasowania CB-SEM indeksami modyfikacji bez pytania o model pomiaru. Bardzo niski CFI może oznaczać, że konstrukt nie jest czynnikiem wspólnym.
- Porównanie wyników obu metod bez wyjaśnienia różnic. Różnice są przewidywalne: PLS daje zwykle niższe ścieżki i wyższe ładunki niż CB-SEM przy danych czynnikowych.
- Uzasadnienie „metoda X jest lepsza”. Obie metody są poprawne – dla różnych modeli. Uzasadniaj wybór naturą konstruktów i celem badania.
Jeśli recenzent kwestionuje wybór metody w Twoim artykule albo chcesz przeprowadzić analizę wrażliwości w obu podejściach, możemy pomóc w ramach analiz statystycznych dla badaczy – od uzasadnienia metody po obliczenia i odpowiedź na recenzję.
Najczęstsze pytania
Czy PLS-SEM jest lepszy przy małej próbie niż CB-SEM?
Nie. Algorytm PLS zbiega przy małej liczbie obserwacji, ale symulacje pokazują, że przy małych próbach wszystkie metody tracą moc i dokładność, a klasyczny PLS dodatkowo nie koryguje błędu pomiaru (Goodhue i in., 2012). Mała próba to powód do uproszczenia modelu i ostrożnej interpretacji, a nie do zmiany metody.
Dlaczego PLS-SEM daje niższe współczynniki ścieżek niż CB-SEM?
Klasyczny PLS buduje konstrukty jako ważone sumy wskaźników, które zawierają błąd pomiaru, więc korelacje między nimi są osłabione. Przy danych z modelu czynnikowego ścieżki są przez to zaniżone, a ładunki zawyżone. Korektę daje consistent PLS (PLSc), który dzieli korelacje przez pierwiastek z rzetelności kompozytów.
Kiedy wybrać PLS-SEM zamiast CB-SEM?
Gdy konstrukty mają charakter kompozytów (np. indeksy złożone z różnych składników), gdy model łączy konstrukty formatywne i refleksyjne albo gdy głównym celem jest predykcja i ocena prognoz poza próbą. Dla modeli zbudowanych wyłącznie ze skal refleksyjnych i nastawionych na test teorii naturalnym wyborem jest CB-SEM.
Czy w artykule można oszacować model obiema metodami?
Tak – to dobra analiza wrażliwości. Główną metodę wybierz i uzasadnij przed analizą, a drugą podaj jako sprawdzenie odporności wniosków. Opisz, czy kierunek i istotność ścieżek są zgodne, i wyjaśnij przewidywalne różnice, np. niższe ścieżki w klasycznym PLS.
Jak ocenić dopasowanie modelu w PLS-SEM?
Najczęściej raportuje się SRMR oraz testy dokładnego dopasowania oparte na odległościach dULS i dG, z wartościami krytycznymi z bootstrapu (np. funkcja testOMF w pakiecie cSEM). Dla modeli z PLSc ocena dopasowania jest szczególnie ważna, bo sam algorytm nie ostrzeże, że model czynnikowy nie pasuje do danych.
Powiązane hasła
Przeczytaj też
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikCB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikModel refleksyjny czy formatywny?
Kryteria decyzji Jarvis i in. (2003), symulacja skutków błędnej specyfikacji modelu pomiaru i model MIMIC w lavaan – z opisem do artykułu.
Czytaj →Recenzent pyta, dlaczego PLS-SEM, a nie CB-SEM?
Pomożemy uzasadnić wybór metody naturą konstruktów i celem badania, oszacujemy model w obu podejściach i przygotujemy analizę wrażliwości do odpowiedzi na recenzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Goodhue, D. L., Lewis, W., & Thompson, R. (2012). Does PLS have advantages for small sample size or non-normal data? MIS Quarterly, 36(3), 981–1001. https://doi.org/10.2307/41703490
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Dijkstra, T. K., Sarstedt, M., Ringle, C. M., Diamantopoulos, A., Straub, D. W., Ketchen, D. J., Hair, J. F., Hult, G. T. M., & Calantone, R. J. (2014). Common beliefs and reality about PLS: Comments on Rönkkö and Evermann (2013). Organizational Research Methods, 17(2), 182–209. https://doi.org/10.1177/1094428114526928 ● Otwarty dostęp
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Rhemtulla, M., van Bork, R., & Borsboom, D. (2020). Worse than measurement error: Consequences of inappropriate latent variable measurement models. Psychological Methods, 25(1), 30–45. https://doi.org/10.1037/met0000220
- Rönkkö, M., & Evermann, J. (2013). A critical examination of common beliefs about partial least squares path modeling. Organizational Research Methods, 16(3), 425–448. https://doi.org/10.1177/1094428112474693
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007 ● Otwarty dostęp
- Schuberth, F., Henseler, J., & Dijkstra, T. K. (2018). Confirmatory composite analysis. Frontiers in Psychology, 9, Article 2541. https://doi.org/10.3389/fpsyg.2018.02541 ● Otwarty dostęp
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@article{goodhue2012does, author={Goodhue, Dale L. and Lewis, William and Thompson, Ron}, title={{Does PLS have advantages for small sample size or non-normal data?}}, journal={MIS Quarterly}, year={2012}, volume={36}, number={3}, pages={981--1001}, doi={10.2307/41703490}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2014common, author={Henseler, Jörg and Dijkstra, Theo K. and Sarstedt, Marko and Ringle, Christian M. and Diamantopoulos, Adamantios and Straub, Detmar W. and Ketchen, David J. and Hair, Joseph F. and Hult, G. Tomas M. and Calantone, Roger J.}, title={{Common beliefs and reality about PLS: Comments on Rönkkö and Evermann (2013)}}, journal={Organizational Research Methods}, year={2014}, volume={17}, number={2}, pages={182--209}, doi={10.1177/1094428114526928}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{rhemtulla2020worse, author={Rhemtulla, Mijke and van Bork, Riet and Borsboom, Denny}, title={{Worse than measurement error: Consequences of inappropriate latent variable measurement models}}, journal={Psychological Methods}, year={2020}, volume={25}, number={1}, pages={30--45}, doi={10.1037/met0000220}}@article{ronkko2013critical, author={Rönkkö, Mikko and Evermann, Joerg}, title={{A critical examination of common beliefs about partial least squares path modeling}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={3}, pages={425--448}, doi={10.1177/1094428112474693}}@article{sarstedt2016estimation, author={Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M. and Thiele, Kai O. and Gudergan, Siegfried P.}, title={{Estimation issues with PLS and CBSEM: Where the bias lies!}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={3998--4010}, doi={10.1016/j.jbusres.2016.06.007}}@article{schuberth2018confirmatory, author={Schuberth, Florian and Henseler, Jörg and Dijkstra, Theo K.}, title={{Confirmatory composite analysis}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={2541}, doi={10.3389/fpsyg.2018.02541}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}