Co to są Model A i Model B w PLS-PM?
Model A i Model B (w literaturze angielskiej Mode A i Mode B) to dwa sposoby obliczania wag zewnętrznych w algorytmie PLS-PM (partial least squares path modeling). Każdy konstrukt w PLS jest kompozytem, czyli ważoną sumą swoich wskaźników. Tryb decyduje o tym, jak algorytm wyznacza te wagi:
- Mode A (wagi korelacyjne) – waga wskaźnika jest proporcjonalna do jego korelacji z „otoczeniem” konstruktu, czyli z wynikami sąsiednich konstruktów w modelu ścieżkowym. Każdy wskaźnik liczy się osobno, jak w serii regresji prostych.
- Mode B (wagi regresyjne) – wagi to współczynniki regresji wielokrotnej otoczenia konstruktu na wszystkie jego wskaźniki naraz. Uwzględniają więc korelacje między wskaźnikami.
Algorytm PLS działa iteracyjnie. Najpierw liczy wyniki konstruktów z bieżących wag (estymacja zewnętrzna). Potem dla każdego konstruktu tworzy przybliżenie z wyników jego sąsiadów w modelu ścieżkowym (estymacja wewnętrzna). Na tej podstawie wyznacza nowe wagi – i właśnie tu działa tryb A albo B. Kroki powtarza się, aż wagi przestaną się zmieniać.
Polska nazwa „Model A i Model B” utrwaliła się w części podręczników, ale chodzi o tryby estymacji wag, a nie o dwa różne modele teoretyczne. W oprogramowaniu tryb ustawia się osobno dla każdego konstruktu. W pakiecie seminr robi się to argumentem weights = mode_A albo weights = mode_B funkcji composite().
Tryb estymacji a model pomiaru
Tradycyjnie Mode A łączono z pomiarem refleksyjnym, a Mode B – z formatywnym. To skojarzenie jest wygodne, ale mylące. Sarstedt i in. (2016) przypominają, że trzeba odróżnić pojęcie pomiaru (konstrukt jest przyczyną wskaźników albo wskaźniki go tworzą) od modelu estymacji (czynnik wspólny albo kompozyt). PLS w obu trybach tworzy kompozyty. Mode A nie zamienia kompozytu we wspólny czynnik, a Mode B nie „dowodzi” formatywności.
Z tego rozróżnienia wynikają dzisiejsze zalecenia:
- Gdy konstrukt jest refleksyjną zmienną latentną (czynnikiem wspólnym), Mode A daje niezgodne oszacowania ładunków i ścieżek. Dijkstra i Henseler (2015) zaproponowali korektę – consistent PLS (PLSc). Po niej ładunki, korelacje konstruktów i ścieżki są zgodne, a obciążenie jest porównywalne z CB-SEM.
- Gdy konstrukt jest z definicji kompozytem, np. indeksem złożonym z różnych zachowań (formatywna zmienna latentna), naturalnym wyborem jest Mode B. Wagi pokazują wtedy wkład każdego składnika przy kontroli pozostałych.
- Henseler i in. (2016) opisują PLS-PM jako metodę z wyboru dla modeli zawierających zarówno czynniki, jak i kompozyty, z nowymi narzędziami oceny takimi jak CCA.
Decyzję o naturze konstruktu podejmuje się przed analizą, na podstawie teorii (zob. modele refleksyjne i formatywne). Tryb wag jest jej techniczną konsekwencją.
Przykład: ta sama „higiena snu”, dwa tryby
Dwustu pięćdziesięciu studentów (dane symulowane) oceniło na skali 1–7 cztery zachowania związane ze snem: stałe pory snu (N1), brak ekranów przed snem (N2), brak kofeiny wieczorem (N3) i ruch w ciągu dnia (N4). Z tych zachowań budujemy kompozyt „higiena snu”, który przewiduje zmęczenie w ciągu dnia (Z1–Z3, Mode A). Wskaźniki N2 i N3 korelują ze sobą silnie (r = .71), bo osoby unikające ekranów zwykle unikają też wieczornej kawy. N4 prawie nie koreluje z pozostałymi (.13–.22).
| Wskaźnik | Waga Mode A | Waga Mode B | Ładunek Mode A | Ładunek Mode B |
|---|---|---|---|---|
| N1 stałe pory snu | .442 | .685 | .841 | .933 |
| N2 bez ekranów | .387 | .443 | .876 | .816 |
| N3 bez kofeiny | .288 | −.058 | .801 | .607 |
| N4 ruch | .158 | .103 | .369 | .333 |
W Mode A wszystkie wagi są dodatnie i mają podobny porządek jak ładunki. W Mode B waga N3 jest ujemna (−.058), choć jego ładunek pozostaje wyraźnie dodatni (.607). To typowy skutek współliniowości: N3 nie wnosi prawie nic ponad to, co już niesie N2. VIF wskaźników wynosił od 1.06 do 2.34, więc nie przekraczał popularnych progów, a mimo to waga zmieniła znak. Cenfetelli i Bassellier (2009) zalecają w takiej sytuacji odróżniać względny wkład wskaźnika (waga) od bezwzględnego (ładunek) i nie usuwać go automatycznie.
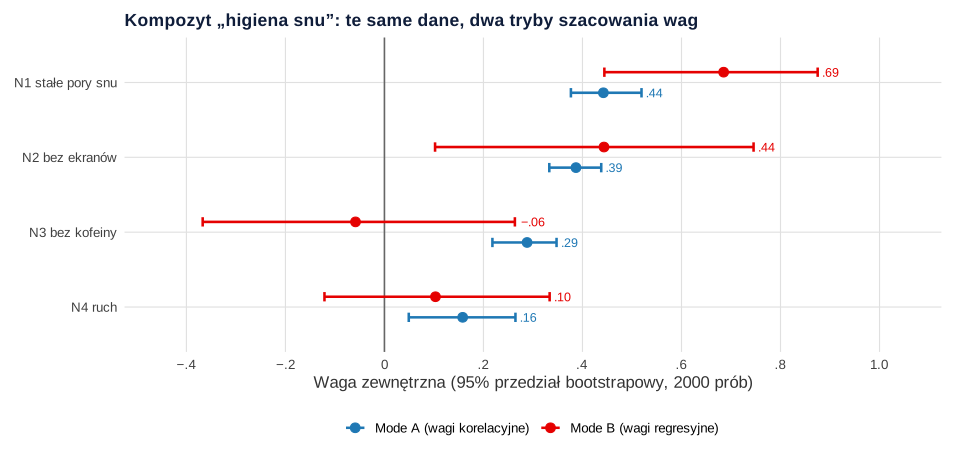
Rysunek 1 pokazuje drugą różnicę – precyzję. Bootstrapowe SD wag w Mode A wynosiło od 0.027 do 0.055, a w Mode B od 0.112 do 0.167. Przedziały dla N3 [−.367, .263] i N4 [−.121, .334] obejmują zero. Mode B maksymalizuje związek kompozytu z otoczeniem, więc R² zmęczenia jest nieco wyższe (.246 wobec .225), a ścieżka nieco silniejsza (−.496 wobec −.475). Wyniki kompozytu z obu trybów korelowały jednak na poziomie .956. W kategoriach przewidywania różnica jest niewielka, w interpretacji wag – zasadnicza.
Jak wybrać tryb
- Zacznij od teorii pomiaru. Czy wskaźniki są wymiennymi przejawami jednej cechy, czy różnymi składnikami, które razem ją tworzą?
- Konstrukt refleksyjny – Mode A, najlepiej z korektą PLSc, jeśli chcesz interpretować ładunki i ścieżki jak w modelu czynnikowym.
- Kompozyt formatywny – Mode B. Sprawdź współliniowość, oceń wagi z bootstrapowymi przedziałami ufności, a znaczenie wskaźnika oceniaj na podstawie wagi i ładunku łącznie.
- Mała próba i silnie skorelowane wskaźniki kompozytu – rozważ Mode A jako stabilniejszą alternatywę dla Mode B. Prostsze wagi bywają w praktyce równie użyteczne – w przykładzie wyniki kompozytu z obu trybów korelowały na poziomie .956. Opisz ten wybór jako decyzję estymacyjną, a nie zmianę teorii.
Jak opisać tryb w pracy
W opisie metody podaj tryb dla każdego konstruktu i krótkie uzasadnienie. W wynikach przy kompozytach Mode B podaj wagi z przedziałami ufności, ładunki i VIF.
Mode A i Mode B w R (seminr)
Kod generuje dane z przykładu, szacuje ten sam model PLS z kompozytem „higiena snu” w trybie Mode A i Mode B, porównuje wagi, ładunki, ścieżkę i R², sprawdza ręcznie, że wagi Mode B to współczynniki regresji wielokrotnej, a wagi Mode A – korelacje, oraz liczy VIF i bootstrapowe przedziały ufności wag. Liczby w tekście, w tabeli i na rysunku 1 pochodzą z tego kodu.
Ten sam kompozyt w dwóch trybach
R
# R122 – Mode A i Mode B w PLS-PM (pakiet seminr)
# Dane symulowane: 250 studentów. Kompozyt „higiena snu” z czterech wskaźników (1–7):
# N1 stałe pory snu, N2 brak ekranów przed snem, N3 brak kofeiny wieczorem, N4 ruch w ciągu dnia.
# Kompozyt przewiduje zmęczenie w ciągu dnia (Z1–Z3, wskaźniki refleksyjne).
suppressPackageStartupMessages({library(MASS); library(seminr)})
set.seed(122)
R_N <- matrix(c(1.00, 0.55, 0.45, 0.25,
                0.55, 1.00, 0.70, 0.20,
                0.45, 0.70, 1.00, 0.20,
                0.25, 0.20, 0.20, 1.00), 4)
n <- 250
X <- mvrnorm(n, rep(0, 4), R_N)
w_pop <- c(0.55, 0.30, 0.05, 0.30)                       # wagi w populacji
k <- as.numeric(scale(X %*% w_pop))
zm <- -0.50 * k + rnorm(n, sd = sqrt(1 - 0.25))            # zmęczenie (cecha ukryta)
Z <- sapply(c(0.85, 0.80, 0.75), function(l) l * zm + rnorm(n, sd = sqrt(1 - l^2)))
na17 <- function(x) pmin(pmax(round(4 + 1.4 * x), 1), 7)
dane <- data.frame(apply(X, 2, na17), apply(Z, 2, na17))
names(dane) <- c(paste0("N", 1:4), paste0("Z", 1:3))
round(cor(dane[, 1:4]), 2)

struktura <- relationships(paths(from = "SEN", to = "ZM"))
model_A <- constructs(composite("SEN", multi_items("N", 1:4), weights = mode_A),
                      composite("ZM", multi_items("Z", 1:3), weights = mode_A))
model_B <- constructs(composite("SEN", multi_items("N", 1:4), weights = mode_B),
                      composite("ZM", multi_items("Z", 1:3), weights = mode_A))
pls_A <- estimate_pls(dane, model_A, struktura)
pls_B <- estimate_pls(dane, model_B, struktura)
sA <- summary(pls_A); sB <- summary(pls_B)

# 1. Wagi zewnętrzne i ładunki zewnętrzne wskaźników N1–N4
round(cbind(waga_A = sA$weights[1:4, "SEN"], waga_B = sB$weights[1:4, "SEN"],
            ladunek_A = sA$loadings[1:4, "SEN"], ladunek_B = sB$loadings[1:4, "SEN"]), 3)

# 2. Ścieżka SEN -> ZM i R²
round(rbind(Mode_A = c(sciezka = sA$paths["SEN", "ZM"], R2 = sA$paths["R^2", "ZM"]),
            Mode_B = c(sciezka = sB$paths["SEN", "ZM"], R2 = sB$paths["R^2", "ZM"])), 3)

# 3. Korelacja wyników kompozytu z obu trybów
round(cor(pls_A$construct_scores[, "SEN"], pls_B$construct_scores[, "SEN"]), 3)

# 4. Mode B = wagi z regresji wielokrotnej kompozytu sąsiedniego na wskaźniki (sprawdzenie)
zs <- scale(dane[, 1:4])
y <- -pls_B$construct_scores[, "ZM"]   # minus: związek SEN–ZM jest ujemny, a znak kompozytu ustala się tak, by wagi były dodatnie
b <- coef(lm(y ~ zs))[-1]
round(b / sd(zs %*% b), 3)
# Mode A = korelacje wskaźników z kompozytem sąsiednim (po przeskalowaniu)
a <- cor(zs, -pls_A$construct_scores[, "ZM"])[, 1]
round(a / sd(zs %*% a), 3)

# 5. Współliniowość wskaźników (VIF) i przedziały bootstrapowe wag
round(sB$validity$vif_items$SEN, 2)
set.seed(1220)
bA <- summary(bootstrap_model(pls_A, nboot = 2000, cores = 1))
bB <- summary(bootstrap_model(pls_B, nboot = 2000, cores = 1))
round(bA$bootstrapped_weights[1:4, c("Original Est.", "Bootstrap SD", "2.5% CI", "97.5% CI")], 3)
round(bB$bootstrapped_weights[1:4, c("Original Est.", "Bootstrap SD", "2.5% CI", "97.5% CI")], 3)
Wynik w R
     N1   N2   N3   N4
N1 1.00 0.57 0.49 0.22
N2 0.57 1.00 0.71 0.20
N3 0.49 0.71 1.00 0.13
N4 0.22 0.20 0.13 1.00
Generating the seminr model
All 250 observations are valid.
Generating the seminr model
All 250 observations are valid.
   waga_A waga_B ladunek_A ladunek_B
N1  0.442  0.685     0.841     0.933
N2  0.387  0.443     0.876     0.816
N3  0.288 -0.058     0.801     0.607
N4  0.158  0.103     0.369     0.333
       sciezka    R2
Mode_A  -0.475 0.225
Mode_B  -0.496 0.246
[1] 0.956
  zsN1   zsN2   zsN3   zsN4
 0.685  0.443 -0.058  0.103
   N1    N2    N3    N4
0.442 0.387 0.288 0.158
  N1   N2   N3   N4
1.55 2.34 2.06 1.06
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
Bootstrapping model using seminr...
SEMinR Model successfully bootstrapped
            Original Est. Bootstrap SD 2.5% CI 97.5% CI
N1  ->  SEN         0.442        0.036   0.377    0.519
N2  ->  SEN         0.387        0.027   0.333    0.438
N3  ->  SEN         0.288        0.034   0.218    0.348
N4  ->  SEN         0.158        0.055   0.049    0.265
            Original Est. Bootstrap SD 2.5% CI 97.5% CI
N1  ->  SEN         0.685        0.112   0.444    0.875
N2  ->  SEN         0.443        0.166   0.102    0.746
N3  ->  SEN        -0.058        0.167  -0.367    0.263
N4  ->  SEN         0.103        0.116  -0.121    0.334
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N. P., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Mode A = model refleksyjny”. Mode A to sposób liczenia wag kompozytu. Bez korekty PLSc nie daje oszacowań modelu czynnikowego.
- Usuwanie wskaźnika formatywnego z powodu ujemnej lub nieistotnej wagi. Waga mówi o wkładzie ponad pozostałe wskaźniki. Usunięcie składnika zmienia definicję konstruktu.
- Interpretowanie wag Mode B bez przedziałów ufności. W przykładzie waga N2 mogła wynosić zarówno .10, jak i .75.
- Ocena kompozytu Mode B kryteriami refleksyjnymi (alfa Cronbacha, AVE). Wskaźniki formatywne nie muszą ze sobą korelować.
- Zmiana trybu po obejrzeniu wyników, bo „Mode B daje wyższe R²”. Tryb wynika z definicji konstruktu, a nie z wielkości efektu.
Praktyczny przegląd oceny modeli z kompozytami znajdziesz w przewodniku PLS-SEM, kod z trybami w seminr i cSEM – we wpisie PLS-SEM w R, a pytanie, jak określić naturę konstruktu, omawia wpis model refleksyjny czy formatywny.
Najczęstsze pytania
Czy Mode A oznacza model refleksyjny, a Mode B formatywny?
Tylko w przybliżeniu. To tryby liczenia wag kompozytu, a nie definicje konstruktu. Mode A jest zwykle używany dla konstruktów refleksyjnych, ale bez korekty PLSc nie daje zgodnych oszacowań modelu czynnikowego; Mode B jest naturalny dla kompozytów formatywnych.
Dlaczego waga w Mode B wyszła ujemna, skoro ładunek jest dodatni?
Waga w Mode B pokazuje wkład wskaźnika przy kontroli pozostałych wskaźników kompozytu. Gdy wskaźnik silnie koreluje z innym, jego unikalny wkład może być bliski zera albo ujemny, choć sam wskaźnik wiąże się z konstruktem dodatnio. Oceń wtedy wagę, ładunek i VIF łącznie i nie usuwaj wskaźnika automatycznie.
Jak ustawić Mode B w seminr?
W definicji konstruktu dodaj argument weights = mode_B, np. composite("SEN", multi_items("N", 1:4), weights = mode_B). Domyślnie seminr stosuje Mode A (mode_A).
Który tryb daje wyższe R² w PLS?
Zwykle Mode B, bo wagi regresyjne maksymalizują związek kompozytu z jego otoczeniem w danej próbie. W przykładzie z tego hasła różnica była mała (.246 wobec .225). Wyższe R² nie uzasadnia wyboru trybu – decyduje teoria pomiaru.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →PoradnikModel refleksyjny czy formatywny? Jak poprawnie określić konstrukt
Kierunek pomiaru zmienia znaczenie modelu, diagnostykę i interpretację. Zobacz kryteria wyboru modelu refleksyjnego, formatywnego i kompozytowego.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cenfetelli, R. T., & Bassellier, G. (2009). Interpretation of formative measurement in information systems research. MIS Quarterly, 33(4), 689–708. https://doi.org/10.2307/20650323
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007 ● Otwarty dostęp
Cytowania BibTeX
@article{cenfetelli2009interpretation, author={Cenfetelli, Ronald T. and Bassellier, Geneviève}, title={{Interpretation of formative measurement in information systems research}}, journal={MIS Quarterly}, year={2009}, volume={33}, number={4}, pages={689--708}, doi={10.2307/20650323}}@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{sarstedt2016estimation, author={Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M. and Thiele, Kai O. and Gudergan, Siegfried P.}, title={{Estimation issues with PLS and CBSEM: Where the bias lies!}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={3998--4010}, doi={10.1016/j.jbusres.2016.06.007}}