Co to jest PLSc?
PLSc (ang. consistent partial least squares, spójny PLS) to odmiana modelowania ścieżek metodą cząstkowych najmniejszych kwadratów, która koryguje oszacowania PLS o niepełną rzetelność kompozytów. Dzięki temu, gdy konstrukty są czynnikami wspólnymi (model refleksyjny), ładunki, korelacje konstruktów i współczynniki ścieżek są szacowane zgodnie – w dużych próbach zbliżają się do wartości populacyjnych.
Metodę wprowadzili Dijkstra i Henseler (2015). Punktem wyjścia był znany problem klasycznego PLS: przy pomiarze refleksyjnym jego oszacowania ścieżek są niezgodne, co – jak pokazali autorzy – może zniekształcać testowanie hipotez. W ich symulacji Monte Carlo obciążenie PLSc było porównywalne z obciążeniem CB-SEM, a przy danych o rozkładzie nienormalnym PLSc miał przewagę.
Ważne rozróżnienie: PLSc nie zmienia samych wyników kompozytów (ważonych sum pozycji), które program wylicza dla każdej osoby. Korygowane są parametry modelu – ładunki, korelacje konstruktów i ścieżki – tak, by odpowiadały zmiennym latentnym, a nie ich niedokładnym przybliżeniom.
Na czym polega problem klasycznego PLS
PLS nie szacuje zmiennych latentnych, tylko kompozyty – ważone sumy wskaźników. Kompozyt zawiera błąd pomiaru każdej pozycji, więc jest tylko przybliżeniem czynnika. Skutki są systematyczne:
- Korelacje i ścieżki między konstruktami są zaniżone – tak jak korelacja dwóch niedokładnych pomiarów jest niższa niż korelacja mierzonych cech (osłabienie korelacji przez błąd pomiaru).
- Ładunki są zawyżone – wskaźnik koreluje z kompozytem, którego sam jest częścią, więc korelacja zawiera fragment jego własnego błędu.
Rönkkö i Evermann (2013) pokazali na prostych przykładach, że wiele rozpowszechnionych przekonań o możliwościach PLS jest nieprawdziwych, i zakwestionowali przydatność metody do testowania teorii. PLSc jest częściową odpowiedzią na tę krytykę: nie zmienia algorytmu kompozytów, ale usuwa obciążenie wynikające z błędu pomiaru.
Jak działa korekta
Henseler i in. (2016) opisują ją prosto: korelacje kompozytów zwykle zaniżają korelacje czynników, a PLSc koryguje to, dzieląc korelację kompozytów przez pierwiastek z ich rzetelności. To klasyczna poprawka na osłabienie:
Rzetelność kompozytu mierzy się współczynnikiem ρA Dijkstry–Henselera. Według Henselera i in. (2016) to jedyna spójna miara rzetelności wyników konstruktów w PLS, w odróżnieniu od rzetelności kompozytowej ρC i alfy, które dotyczą sum pozycji. Ze skorygowanych korelacji konstruktów oblicza się następnie ścieżki (regresje) i ładunki.
Kiedy stosować PLSc, a kiedy nie. Ten sam tekst podkreśla, że korekta jest konieczna, gdy model zawiera czynniki, czyli konstrukty z losowym błędem pomiaru – a takimi są zwykle konstrukty psychologiczne. Gdy konstrukt jest z natury kompozytem (artefaktem, np. indeksem złożonym z odrębnych składników, zob. formatywna zmienna latentna i Model A i Model B), korekty się nie stosuje. W modelach mieszanych PLSc koryguje tylko konstrukty określone jako czynniki.
Przykład: wsparcie dyrekcji i zaangażowanie nauczycieli
W danych symulowanych 200 nauczycieli odpowiedziało na trzy pozycje o wsparciu dyrekcji (WS) i trzy o zaangażowaniu w pracę (ZA). W populacji model jest refleksyjny: każdy ładunek wynosi .70, a ścieżka WS → ZA β = .45. Porównujemy trzy estymatory na tych samych danych:
| Metoda | Ścieżka WS → ZA (prawda: .45) | Średni ładunek (prawda: .70) |
|---|---|---|
| PLS (bez korekty) | .344 | .810 |
| PLSc | .452 | .696 |
| CB-SEM (ML) | .412 | .705 |
Korekta krok po kroku. Korelacja kompozytów wynosi .344 – w modelu z jednym predyktorem to zarazem ścieżka PLS. Rzetelności ρA to .777 dla wsparcia i .747 dla zaangażowania. Skorygowana korelacja: .344 / √(.777 × .747) = .452 – dokładnie ścieżka PLSc.
Klasyczny PLS zaniżył ścieżkę o około jedną czwartą i zawyżył ładunki o około .11. Pojedyncze ładunki PLSc wahają się w tej próbie mocno (od .492 do .796) – przy trzech wskaźnikach i 200 osobach oszacowania są mało precyzyjne, co dotyczy także CB-SEM (od .554 do .843).
Jedna próba to jednak tylko jeden wynik. Rysunek 1 pokazuje 500 prób z tej samej populacji.
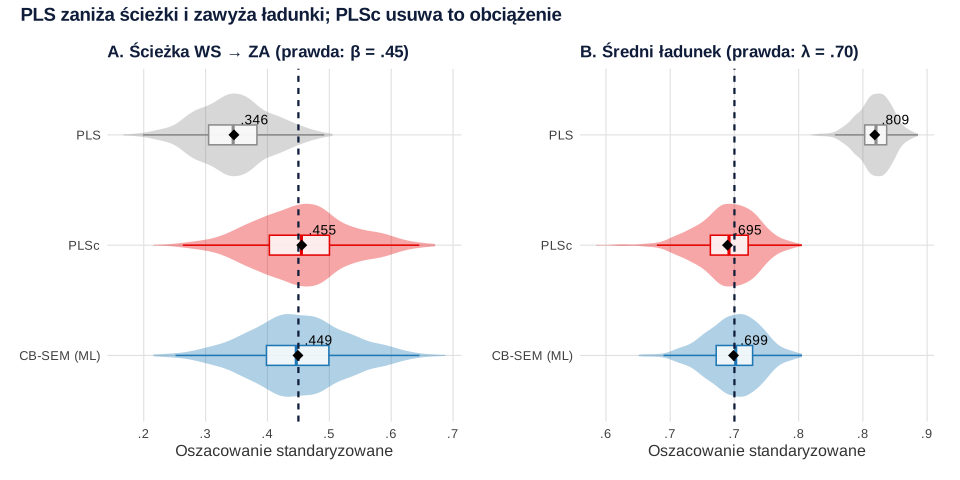
- Obciążenie. Średnia ścieżka PLS to .346 zamiast .45; PLSc daje .455, a CB-SEM .449. Średni ładunek PLS to .809, PLSc .695, CB-SEM .699.
- Cena korekty – zmienność. Odchylenie standardowe oszacowań ścieżki wynosi .059 w PLS, ale .078 w PLSc i .080 w CB-SEM. PLS jest „precyzyjny” wokół złej wartości; PLSc trafia średnio w prawdę, ale z większym rozrzutem, podobnie jak CB-SEM. Przy małych próbach przekłada się to na szersze przedziały ufności.
PLSc w programach i ocena modelu
W praktyce nie musisz liczyć korekty ręcznie. W pakiecie R cSEM (wersja 0.6.1) korekta jest włączona domyślnie: argument .disattenuate = TRUE działa, gdy przynajmniej jeden konstrukt zapiszesz jako czynnik wspólny (operator =~). W pakiecie seminr (wersja 2.5.0) model oszacowany funkcją estimate_pls() można przekształcić funkcją PLSc(). W programach okienkowych PLSc jest zwykle osobną procedurą obok klasycznego algorytmu PLS – sprawdź w dokumentacji, którą wersję uruchamiasz.
Po korekcie ocena modelu przebiega tak samo jak w PLS-SEM, z dwiema różnicami. Po pierwsze, ładunki PLSc są niższe niż w PLS, więc reguły dotyczące minimalnych ładunków czy AVE stosowane do wyników klasycznego PLS stają się bardziej wymagające. Po drugie, skoro model zakłada czynniki wspólne, warto sprawdzić jego dopasowanie: Henseler i in. (2016) opisują testy dokładnego dopasowania oparte na bootstrapie, mierzące rozbieżność macierzy jako dULS i dG, oraz SRMR. Jeżeli prognoza jest celem badania, oceń model także procedurą PLSpredict.
Jak opisać PLSc w pracy (APA)
Napisz, dlaczego konstrukty potraktowano jako czynniki, jaki program i jaką korektę zastosowano, oraz podaj ρA. Ścieżki testuj przedziałami bootstrapowymi (zob. bootstrap w SEM). Hair i in. (2019) zestawiają kryteria oceny i zasady raportowania wyników PLS-SEM. Wzór:
Szerzej o wyborze metody piszemy we wpisach PLS-SEM czy CB-SEM oraz PLS-SEM w R: seminr i cSEM.
PLSc w R (cSEM)
Kod tworzy dane z przykładu, szacuje model klasycznym PLS, PLSc i CB-SEM (lavaan), porównuje ścieżki i ładunki oraz odtwarza korektę ręcznie. Liczby w tabeli i tekście pochodzą z tego kodu; rysunek 1 – z 500 powtórzeń funkcji gen() (skrypt rysunki-r129.R).
PLS, PLSc i CB-SEM na tych samych danych
R
# Dane symulowane: 200 nauczycieli; wsparcie dyrekcji (ws1–ws3) -> zaangażowanie w pracę (za1–za3)
# Model populacyjny jest modelem czynnika wspólnego (refleksyjnym): ładunki .70, ścieżka β = .45
suppressPackageStartupMessages({library(cSEM); library(lavaan)})
set.seed(118)
n <- 200
gen <- function(n, beta = .45, l = .70) {
  WS <- rnorm(n); ZA <- beta * WS + rnorm(n, sd = sqrt(1 - beta^2))
  X <- cbind(sapply(1:3, function(j) l * WS + rnorm(n, sd = sqrt(1 - l^2))),
             sapply(1:3, function(j) l * ZA + rnorm(n, sd = sqrt(1 - l^2))))
  colnames(X) <- c(paste0("ws", 1:3), paste0("za", 1:3)); as.data.frame(X)
}
dane <- gen(n)
model <- '
  WS =~ ws1 + ws2 + ws3
  ZA =~ za1 + za2 + za3
  ZA ~ WS
'
# Klasyczny PLS (bez korekty) i PLSc (korekta na niepełną rzetelność kompozytów)
pls  <- csem(dane, model, .disattenuate = FALSE)
plsc <- csem(dane, model, .disattenuate = TRUE)
ml   <- sem(model, data = dane, std.lv = TRUE)
sciezka <- c(PLS = pls$Estimates$Path_estimates["ZA", "WS"], PLSc = plsc$Estimates$Path_estimates["ZA", "WS"],
             CB_SEM_ML = standardizedSolution(ml)$est.std[standardizedSolution(ml)$op == "~"])
round(sciezka, 3)
lad <- rbind(PLS = pls$Estimates$Loading_estimates[pls$Estimates$Loading_estimates != 0],
             PLSc = plsc$Estimates$Loading_estimates[plsc$Estimates$Loading_estimates != 0],
             CB_SEM_ML = standardizedSolution(ml)$est.std[standardizedSolution(ml)$op == "=~"])
colnames(lad) <- c(paste0("ws", 1:3), paste0("za", 1:3)); round(cbind(lad, srednia = rowMeans(lad)), 3)   # w populacji każdy ładunek = .70
# Rzetelność kompozytów, którą PLSc wykorzystuje do korekty (rho_A Dijkstry–Henselera)
round(plsc$Estimates$Reliabilities, 3)
# Korekta „na piechotę”: korelacja kompozytów / pierwiastek z iloczynu ich rzetelności
r_komp <- pls$Estimates$Construct_VCV["WS", "ZA"]
round(c(r_kompozytow = r_komp, skorygowana = r_komp / sqrt(prod(plsc$Estimates$Reliabilities))), 3)
Wynik w R
      PLS      PLSc CB_SEM_ML
    0.344     0.452     0.412
            ws1   ws2   ws3   za1   za2   za3 srednia
PLS       0.739 0.826 0.865 0.810 0.749 0.870   0.810
PLSc      0.492 0.796 0.792 0.660 0.667 0.770   0.696
CB_SEM_ML 0.653 0.638 0.828 0.715 0.554 0.843   0.705
   WS    ZA
0.777 0.747
r_kompozytow  skorygowana
       0.344        0.452
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cSEM (wersja 0.6.1): Rademaker, M. E., & Schuberth, F. (2020). cSEM: Composite-based structural equation modeling (R package version 0.6.1) [Computer software]. https://floschuberth.github.io/cSEM/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Klasyczny PLS dla konstruktów refleksyjnych i interpretacja ścieżek jak w CB-SEM. Oszacowania są systematycznie zaniżone; użyj PLSc.
- PLSc dla konstruktów kompozytowych (indeksów, artefaktów). Korekta na błąd pomiaru nie ma wtedy sensu.
- Brak ρA w raporcie. To od niego zależy korekta – czytelnik powinien widzieć, jak duża była.
- Bardzo niska rzetelność konstruktu. Dzielenie przez mały pierwiastek daje skrajne, niestabilne korelacje, czasem większe niż 1; popraw wtedy pomiar, a nie model.
- Pomijanie większej zmienności oszacowań PLSc przy planowaniu liczebności – moc testów ścieżek jest niższa niż sugerowałyby obciążone wyniki PLS.
- Przekonanie, że PLS „lepiej działa w małych próbach”. Wąski rozrzut klasycznego PLS to rozrzut wokół złej wartości – rysunek 1A.
Najczęstsze pytania
Kiedy użyć PLSc zamiast zwykłego PLS?
Gdy konstrukty w modelu traktujesz jako czynniki wspólne, czyli zakładasz, że cecha powoduje odpowiedzi na pozycje, a te zawierają losowy błąd pomiaru. Tak jest w większości skal psychologicznych. Dla konstruktów kompozytowych, takich jak indeksy złożone z odrębnych składników, pozostań przy zwykłym PLS.
Dlaczego zwykły PLS zaniża współczynniki ścieżek?
Bo szacuje zależności między kompozytami – ważonymi sumami wskaźników – które zawierają błąd pomiaru. Błąd osłabia korelacje między konstruktami, a więc i ścieżki. W przykładzie na tej stronie ścieżka o prawdziwej wartości .45 wyniosła w PLS średnio .346.
Czy PLSc daje takie same wyniki jak CB-SEM?
Przy konstruktach refleksyjnych oba podejścia szacują te same parametry i w dużych próbach dają zbliżone wyniki. W symulacji Dijkstry i Henselera (2015) obciążenie PLSc było porównywalne z CB-SEM. W pojedynczej próbie wartości mogą się jednak różnić, bo metody inaczej ważą informację.
Dlaczego w PLSc ścieżka może przekroczyć 1?
Korekta dzieli korelację kompozytów przez pierwiastek z rzetelności. Gdy rzetelność jest niska, a korelacja kompozytów wysoka, wynik może przekroczyć 1. To sygnał słabego pomiaru albo słabo odróżnialnych konstruktów – sprawdź ρA i trafność różnicową, zanim zinterpretujesz model.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM czy CB-SEM? Porównanie metod i praktyczna decyzja
Neutralne porównanie PLS-SEM i CB-SEM: cel, rodzaj konstruktu, estymacja, dopasowanie, predykcja, próba i raportowanie bez popularnych mitów.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →PoradnikPLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dijkstra, T. K., & Henseler, J. (2015). Consistent partial least squares path modeling. MIS Quarterly, 39(2), 297–316. https://doi.org/10.25300/misq/2015/39.2.02 ● Otwarty dostęp: pełny tekst
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Henseler, J., Hubona, G., & Ray, P. A. (2016). Using PLS path modeling in new technology research: Updated guidelines. Industrial Management & Data Systems, 116(1), 2–20. https://doi.org/10.1108/imds-09-2015-0382 ● Otwarty dostęp
- Rönkkö, M., & Evermann, J. (2013). A critical examination of common beliefs about partial least squares path modeling. Organizational Research Methods, 16(3), 425–448. https://doi.org/10.1177/1094428112474693
Cytowania BibTeX
@article{dijkstra2015consistent, author={Dijkstra, Theo K. and Henseler, Jörg}, title={{Consistent partial least squares path modeling}}, journal={MIS Quarterly}, year={2015}, volume={39}, number={2}, pages={297--316}, doi={10.25300/misq/2015/39.2.02}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{henseler2016using, author={Henseler, Jörg and Hubona, Geoffrey and Ray, Pauline Ash}, title={{Using PLS path modeling in new technology research: Updated guidelines}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={1}, pages={2--20}, doi={10.1108/imds-09-2015-0382}}@article{ronkko2013critical, author={Rönkkö, Mikko and Evermann, Joerg}, title={{A critical examination of common beliefs about partial least squares path modeling}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={3}, pages={425--448}, doi={10.1177/1094428112474693}}