Co to jest PLSpredict?
PLSpredict to procedura oceny mocy predykcyjnej poza próbą (ang. out-of-sample prediction) modelu PLS-SEM. Dane dzieli się na części (foldy), model szacuje się na części danych, a następnie prognozuje wartości wskaźników konstruktu endogenicznego u osób, których nie użyto do estymacji. Błędy tych prognoz porównuje się z dwoma punktami odniesienia: naiwną prognozą średnią (stąd Q²predict) i prostą regresją liniową (benchmark LM).
Problem, który Shmueli i in. (2016) nazwali w tytule pracy „słoniem w pokoju”, opisują Shmueli i in. (2019): badacze podkreślają predykcyjny charakter PLS-SEM, a model oceniają wyłącznie miarami mocy wyjaśniającej, takimi jak R². Autorzy przedstawili PLSpredict jako procedurę opartą na próbie wydzielonej (ang. holdout), która tworzy prognozy na poziomie pozycji lub konstruktu, objaśnili kluczowe decyzje badacza i zalecili rutynową ocenę mocy predykcyjnej. Hair i in. (2019) włączyli PLSpredict do zestawu kryteriów raportowania wyników PLS-SEM.
Jak działa procedura
- Podział na k foldów (zwykle 10). Każda osoba trafia do jednego foldu.
- Estymacja na k − 1 foldach i prognoza wskaźników konstruktów endogenicznych w pominiętym foldzie – na podstawie wskaźników konstruktów egzogenicznych. Powtarza się to k razy, aż każda osoba dostanie prognozę z modelu, który jej nie widział.
- Powtórzenia (np. 10 razy z innym losowym podziałem) i uśrednienie, by wynik nie zależał od jednego podziału.
- Miary błędu dla każdego wskaźnika: RMSE (pierwiastek średniego kwadratu błędu) i MAE (średni błąd bezwzględny), oraz Q²predict = 1 − SSEPLS/SSEśrednia.
- Porównanie z benchmarkiem LM: regresją każdego wskaźnika endogenicznego bezpośrednio na wszystkie wskaźniki egzogeniczne, szacowaną w tych samych foldach.
Benchmark LM ignoruje strukturę modelu, więc jest wymagającym rywalem: jeśli model PLS prognozuje gorzej niż zwykła regresja na tych samych pozycjach, jego struktura nie wnosi nic do prognozy. Q²predict > 0 oznacza tylko, że model jest lepszy od średniej – to próg minimalny, a nie dowód dobrej prognozy. Starsza miara tego typu, liczona procedurą blindfolding, nie prognozuje dla nowych osób. Więcej o logice tej miary w haśle Q² Stone’a-Geissera.
Decyzje, które trzeba podjąć
| Ustawienie | Typowy wybór | Uwagi |
|---|---|---|
| Liczba foldów k | 10 | Każdy fold musi mieć wystarczająco wielu osób; w bardzo małych próbach dokumentacja seminr zaleca walidację „zostaw jedną osobę” (LOOCV). |
| Liczba powtórzeń | 10 | Uśrednia wpływ losowego podziału na foldy. |
| Technika prognozy | DA lub EA | W seminr: predict_DA prognozuje z bezpośrednich poprzedników konstruktu, predict_EA – z najwcześniejszych poprzedników w modelu. Przy modelu z jednym konstruktem endogenicznym obie dają ten sam wynik. |
| Poziom oceny | Wskaźniki konstruktów kluczowych | Oceniaj przede wszystkim konstrukty endogeniczne, które są celem prognozy; wynik na poziomie konstruktu (np. OOS_MSE) traktuj pomocniczo. |
| Miara błędu | RMSE lub MAE | Zależnie od rozkładu błędów prognozy – jedna miara dla wszystkich wskaźników. |
Wszystkie te decyzje zapisz w planie analizy przed jej wykonaniem i podaj w raporcie. Zmiana liczby foldów czy techniki po zobaczeniu wyników, aż model „wygra” z LM, podważa sens procedury.
Przykład: czy wsparcie i autonomia przewidują satysfakcję?
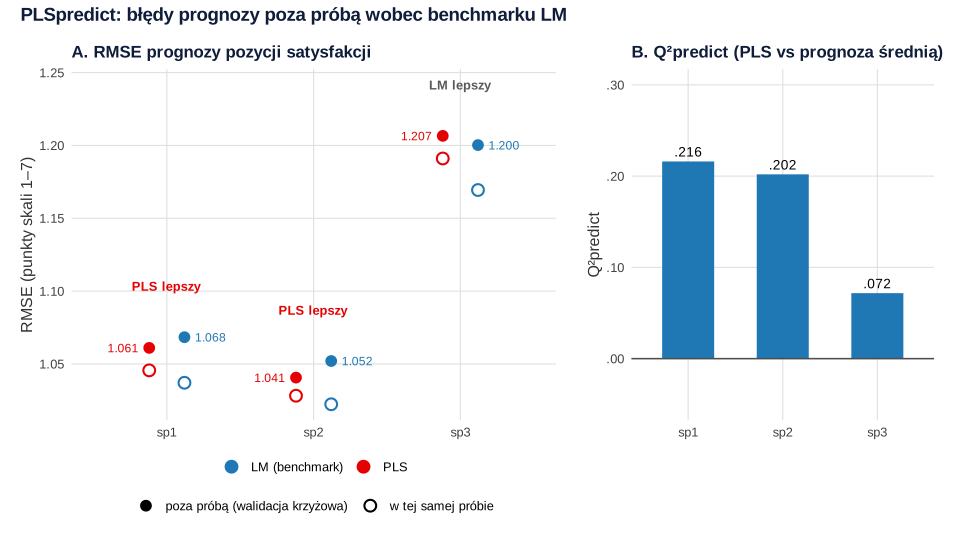
W danych symulowanych 240 pracowników oceniło wsparcie przełożonego (3 pozycje), autonomię (3 pozycje) i satysfakcję z pracy (3 pozycje; skala 1–7). W modelu PLS oba konstrukty przewidują satysfakcję: ścieżki 0.370 (wsparcie) i 0.261 (autonomia), R² = .270. To dopasowanie w tej samej próbie. Czy model przewiduje satysfakcję nowych osób? PLSpredict: 10 foldów, 10 powtórzeń.
| Pozycja | Q²predict | RMSE PLS | RMSE LM | Różnica PLS − LM | MAE PLS | MAE LM |
|---|---|---|---|---|---|---|
| sp1 | .216 | 1.061 | 1.068 | −0.007 | 0.847 | 0.859 |
| sp2 | .202 | 1.041 | 1.052 | −0.011 | 0.828 | 0.836 |
| sp3 | .072 | 1.207 | 1.200 | 0.006 | 0.970 | 0.956 |
Jak to czytać krok po kroku:
- Q²predict > 0 dla wszystkich pozycji – model przewiduje lepiej niż średnia. Dla sp3 przewaga jest jednak mała (.072): to najsłabszy wskaźnik satysfakcji.
- Wybór miary błędu. Błędy prognozy są niemal symetryczne (skośność od −0.063 do 0.040), więc można opierać się na RMSE. Przy wyraźnie skośnym rozkładzie błędów lepszy byłby MAE, mniej wrażliwy na pojedyncze duże pomyłki.
- Porównanie z LM. Dla sp1 i sp2 RMSE PLS jest niższe niż LM, dla sp3 – wyższe. Model wygrywa z benchmarkiem w większości wskaźników, ale nie we wszystkich: moc predykcyjną można opisać jako umiarkowaną. Różnice są przy tym bardzo małe (setne części punktu skali).
- Porównanie z próbą uczącą. RMSE w tej samej próbie jest niższe niż poza nią (np. sp1: 1.046 wobec 1.061) – to normalne; duża różnica sygnalizowałaby nadmierne dopasowanie (por. skorygowane R², które częściowo koryguje ten efekt w tej samej próbie).
Ograniczenia i CVPAT
PLSpredict porównuje liczby, ale nie mówi, czy różnica jest większa od przypadkowej. W przykładzie przewaga PLS nad LM w sp1 i sp2 wynosi około 0.01 punktu i może zniknąć w innej próbie. Liengaard i in. (2021) wskazali brak testu statystycznego dla mocy predykcyjnej jako ograniczenie PLS i zaproponowali test CVPAT (ang. cross-validated predictive ability test), który porównuje straty prognostyczne dwóch modeli, np. modelu teoretycznego i benchmarku albo dwóch modeli konkurencyjnych. W pakiecie R cSEM jest on dostępny jako funkcja testCVPAT(). Jeśli w pracy porównujesz kilka modeli teoretycznych pod kątem prognozy, CVPAT jest bardziej przekonujący niż zestawienie wartości RMSE, bo uwzględnia zmienność różnic w stratach prognostycznych obu modeli i pozwala podać wartość p różnicy.
Pamiętaj też, że PLSpredict ocenia prognozę, a nie poprawność modelu przyczynowego. Model o słabej mocy predykcyjnej może trafnie opisywać mechanizm, a model dobrze prognozujący – być błędny teoretycznie. Do oceny dopasowania i trafności służą inne narzędzia, a przy konstruktach refleksyjnych także korekta PLSc (zob. wpis PLS-SEM krok po kroku).
Jak opisać PLSpredict w pracy (APA)
Podaj liczbę foldów i powtórzeń, technikę prognozy, wybraną miarę błędu z uzasadnieniem, Q²predict i wynik porównania z LM dla każdego wskaźnika (najlepiej w tabeli). Wzór:
PLSpredict w R (seminr)
Kod tworzy dane z przykładu, szacuje model PLS, uruchamia PLSpredict (10 foldów, 10 powtórzeń), liczy ręcznie Q²predict i RMSE oraz sprawdza skośność błędów prognozy. Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu. W kodzie Q²predict liczono względem średniej całej próby – to wersja nieco ostrożniejsza niż ze średnią części uczącej.
predict_pls(): PLS wobec benchmarku LM
R
# Dane symulowane: 240 pracowników; wsparcie przełożonego (ws1–ws3) i autonomia (au1–au3)
# przewidują satysfakcję z pracy (sp1–sp3); wszystkie pozycje na skali 1–7
suppressPackageStartupMessages(library(seminr))
set.seed(130)
n <- 240
WS <- rnorm(n); AU <- 0.4 * WS + rnorm(n, sd = sqrt(1 - .16))
SP <- 0.35 * WS + 0.30 * AU + rnorm(n, sd = 0.78)
poz <- function(f, l) round(pmin(pmax(4.3 + 1.2 * (l * f / sd(f) + rnorm(n, sd = sqrt(1 - l^2))), 1), 7))
dane <- data.frame(ws1 = poz(WS, .85), ws2 = poz(WS, .80), ws3 = poz(WS, .70),
                   au1 = poz(AU, .80), au2 = poz(AU, .75), au3 = poz(AU, .70),
                   sp1 = poz(SP, .85), sp2 = poz(SP, .80), sp3 = poz(SP, .60))
mm <- constructs(composite("WS", multi_items("ws", 1:3)), composite("AU", multi_items("au", 1:3)),
                 composite("SP", multi_items("sp", 1:3)))
sm <- relationships(paths(from = c("WS", "AU"), to = "SP"))
pls <- estimate_pls(data = dane, measurement_model = mm, structural_model = sm)
round(summary(pls)$paths, 3)                    # ścieżki i R² (dopasowanie w tej samej próbie)

# PLSpredict: 10-krotna walidacja krzyżowa powtórzona 10 razy, technika bezpośrednich poprzedników (DA)
set.seed(2130)
pred <- predict_pls(model = pls, technique = predict_DA, noFolds = 10, reps = 10)
sp <- summary(pred)
sp                                              # RMSE i MAE dla PLS i benchmarku LM, w próbie i poza nią

# Q²predict „ręcznie”: błędy PLS poza próbą wobec naiwnej prognozy średnią (tu: średnia całej próby)
y <- as.matrix(pred$items$item_actuals[, c("sp1", "sp2", "sp3")])
e_pls <- as.matrix(pred$items$PLS_out_of_sample_residuals)
q2pred <- 1 - colSums(e_pls^2) / colSums(sweep(y, 2, colMeans(y))^2)
rmse_pls <- sqrt(colMeans(e_pls^2))
rmse_lm  <- sqrt(colMeans(as.matrix(pred$items$lm_out_of_sample_residuals)^2))
round(rbind(Q2predict = q2pred, RMSE_PLS = rmse_pls, RMSE_LM = rmse_lm, PLS_minus_LM = rmse_pls - rmse_lm), 3)
# Rozkład błędów prognozy: przy wyraźnej asymetrii lepiej raportować MAE niż RMSE
round(apply(e_pls, 2, function(e) mean((e - mean(e))^3) / sd(e)^3), 3)
Wynik w R
Generating the seminr model
All 240 observations are valid.
          SP
R^2    0.270
AdjR^2 0.264
WS     0.370
AU     0.261

PLS in-sample metrics:
       sp1   sp2   sp3
RMSE 1.046 1.028 1.191
MAE  0.834 0.816 0.957

PLS out-of-sample metrics:
       sp1   sp2   sp3
RMSE 1.061 1.041 1.207
MAE  0.847 0.828 0.970

LM in-sample metrics:
       sp1   sp2   sp3
RMSE 1.037 1.022 1.169
MAE  0.831 0.812 0.935

LM out-of-sample metrics:
       sp1   sp2   sp3
RMSE 1.068 1.052 1.200
MAE  0.859 0.836 0.956

Construct Level metrics:
            SP
IS_MSE  0.7250
IS_MAE  0.6785
OOS_MSE 0.7406
OOS_MAE 0.6878
overfit 0.0214
                sp1    sp2   sp3
Q2predict     0.216  0.202 0.072
RMSE_PLS      1.061  1.041 1.207
RMSE_LM       1.068  1.052 1.200
PLS_minus_LM -0.007 -0.011 0.006
   sp1    sp2    sp3
 0.040 -0.063 -0.001
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (R package version 2.5.0) [Computer software]. https://doi.org/10.32614/CRAN.package.seminr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Utożsamianie wysokiego R² z mocą predykcyjną. R² opisuje dopasowanie w tej samej próbie; prognozę poza próbą sprawdza dopiero PLSpredict.
- Raportowanie samego Q²predict > 0 bez porównania z LM – to bardzo niska poprzeczka.
- Mieszanie RMSE i MAE między wskaźnikami albo wybór miary po zobaczeniu wyników. Zdecyduj na podstawie rozkładu błędów.
- Jeden losowy podział na foldy. Wyniki zależą od podziału; stosuj powtórzenia i zapisz ziarno losowania.
- Za mała próba na 10 foldów. W bardzo małych próbach rozważ walidację „zostaw jedną osobę” (LOOCV), którą oferuje
predict_pls(). - Wybór PLS-SEM tylko „dla prognozy” bez sprawdzenia jej procedurą PLSpredict – o wyborze metody piszemy we wpisie PLS-SEM czy CB-SEM, a kod znajdziesz w poradniku PLS-SEM w R: seminr i cSEM.
- Interpretacja drobnych różnic RMSE jako przewagi modelu bez testu, np. CVPAT.
Najczęstsze pytania
Jak interpretować wyniki PLSpredict?
Najpierw sprawdź, czy Q²predict każdego wskaźnika jest większe od zera. Potem porównaj RMSE (albo MAE) modelu PLS z benchmarkiem LM: jeśli PLS ma mniejszy błąd we wszystkich wskaźnikach, moc predykcyjna jest wysoka; w większości – umiarkowana; w mniejszości lub w żadnym – niska lub brak.
Kiedy w PLSpredict wybrać MAE zamiast RMSE?
RMSE silniej karze duże pomyłki, więc nadaje się, gdy błędy prognozy mają rozkład zbliżony do symetrycznego. Gdy rozkład błędów jest wyraźnie skośny albo ma pojedyncze bardzo duże błędy, MAE lepiej opisuje typową pomyłkę. Decyzję podejmij na podstawie rozkładu błędów, zanim porównasz modele.
Czym jest benchmark LM w PLSpredict?
To regresja liniowa każdego wskaźnika konstruktu endogenicznego na wszystkie wskaźniki konstruktów egzogenicznych, oszacowana w tych samych foldach co model PLS. Nie uwzględnia struktury modelu, więc pokazuje, czy ta struktura poprawia prognozę ponad to, co daje zwykła regresja na pozycjach.
Czy niskie Q²predict oznacza, że model jest zły?
Nie musi. Q²predict mówi o prognozowaniu wyników nowych osób, a nie o trafności mechanizmu opisanego w modelu. Konstrukt z wieloma przyczynami spoza modelu będzie słabo prognozowany nawet przy poprawnej teorii. Jeśli jednak celem pracy jest prognoza, niska moc predykcyjna jest istotnym ograniczeniem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Liengaard, B. D., Sharma, P. N., Hult, G. T. M., Jensen, M. B., Sarstedt, M., Hair, J. F., & Ringle, C. M. (2021). Prediction: Coveted, yet forsaken? Introducing a cross-validated predictive ability test in partial least squares path modeling. Decision Sciences, 52(2), 362–392. https://doi.org/10.1111/deci.12445 ● Otwarty dostęp
- Shmueli, G., Ray, S., Velasquez Estrada, J. M., & Chatla, S. B. (2016). The elephant in the room: Predictive performance of PLS models. Journal of Business Research, 69(10), 4552–4564. https://doi.org/10.1016/j.jbusres.2016.03.049
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{liengaard2021prediction, author={Liengaard, Benjamin Dybro and Sharma, Pratyush Nidhi and Hult, G. Tomas M. and Jensen, Morten Berg and Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M.}, title={{Prediction: Coveted, yet forsaken? Introducing a cross-validated predictive ability test in partial least squares path modeling}}, journal={Decision Sciences}, year={2021}, volume={52}, number={2}, pages={362--392}, doi={10.1111/deci.12445}}@article{shmueli2016elephant, author={Shmueli, Galit and Ray, Soumya and Velasquez Estrada, Juan Manuel and Chatla, Suneel Babu}, title={{The elephant in the room: Predictive performance of PLS models}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={4552--4564}, doi={10.1016/j.jbusres.2016.03.049}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}