Co to jest blindfolding w PLS-SEM?
Blindfolding (ang. dosłownie „zawiązywanie oczu”) to procedura ponownego użycia próby, którą w PLS-SEM liczy się współczynnik Q² Stone’a–Geissera. Działa tak: część danych zostaje „zakryta”, model szacuje się bez nich, a potem sprawdza, jak dobrze przewiduje zakryte wartości. Q² nawiązuje do prac Stone’a (1974) o walidacji krzyżowej i Geissera (1974) o predykcyjnym ponownym użyciu próby.
Blindfolding należy do etapu oceny modelu strukturalnego w modelowaniu równań strukturalnych metodą PLS (ang. partial least squares). Wykonuje się go dopiero wtedy, gdy model pomiarowy jest zaakceptowany: wskaźniki mają odpowiednie ładunki zewnętrzne, a konstrukty – rzetelność i AVE.
Q² liczy się dla endogenicznych konstruktów refleksyjnych, czyli tych, które w modelu strukturalnym są wyjaśniane przez inne konstrukty. Q² większe od zera oznacza, że model przewiduje pominięte wartości wskaźników lepiej niż ich średnia. Q² równe zero lub ujemne oznacza, że predykcja nie jest lepsza od zgadywania średnią. W odróżnieniu od R², które opisuje dopasowanie do danych użytych w estymacji, Q² ocenia trafność predykcyjną modelu, choć – jak pokażemy niżej – tylko częściowo.
Jak działa blindfolding krok po kroku
- Wybierz odległość pominięcia D (ang. omission distance). Zwykle przyjmuje się wartość od 5 do 12, w programach domyślnie 7.
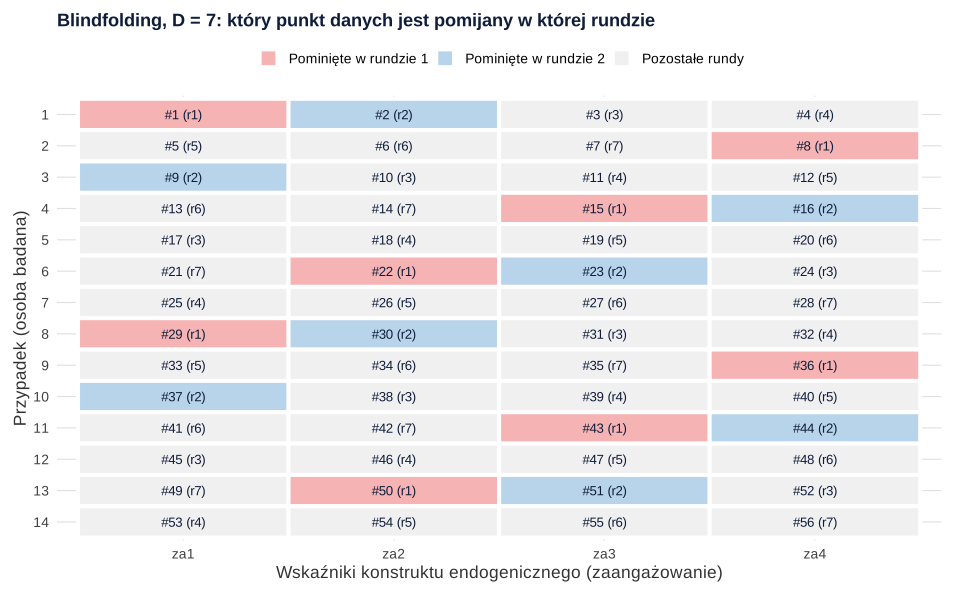
- Ponumeruj punkty danych wskaźników konstruktu endogenicznego: wiersz po wierszu, czyli (osoba 1, wskaźnik 1), (osoba 1, wskaźnik 2) itd.
- W rundzie 1 pomiń co D-ty punkt, zaczynając od pierwszego: 1, 1 + D, 1 + 2D… Pominięte wartości zastąp średnią i oszacuj model PLS na tak zmienionych danych.
- Przewidź pominięte wartości z modelu: wynik konstruktu endogenicznego przewidywany ze ścieżek i wyników konstruktów egzogenicznych, pomnożony przez ładunek danego wskaźnika.
- Powtórz dla rund 2, 3, …, D, aż każdy punkt danych zostanie pominięty dokładnie raz.
- Policz Q² z sumy kwadratów błędów predykcji (SSE) i sumy kwadratów odchyleń pominiętych wartości od średniej (SSO).
Rysunek 1 pokazuje schemat pomijania dla D = 7 i czterech wskaźników. Ponieważ numeracja biegnie wierszami, w każdej rundzie pomijane są wartości różnych wskaźników u różnych osób.
Istnieją dwa warianty przewidywania. Redundancja walidowana krzyżowo (ang. cross-validated redundancy) przewiduje pominięte wartości z konstruktów poprzedzających w modelu strukturalnym, więc ocenia model ścieżkowy. To ją zwykle raportuje się jako Q². Komunalność walidowana krzyżowo przewiduje je z samego konstruktu, czyli ocenia tylko model pomiarowy.
Przykład: Q² dla zaangażowania w naukę
Dwustu pięćdziesięciu studentów (dane symulowane) oceniło wsparcie społeczne (3 pozycje), poczucie własnej skuteczności (3 pozycje) i zaangażowanie w naukę (4 pozycje) na skali 1–7. W modelu PLS-SEM wsparcie i skuteczność wyjaśniają zaangażowanie. Współczynniki ścieżek wyniosły .226 i .338, a R² = .193.
Blindfolding z D = 7 dał SSO = 1189.19 i SSE = 998.55, czyli Q² = 1 − 998.55/1189.19 = .160. Model przewiduje pominięte odpowiedzi lepiej niż średnia, a Q² jest niższe niż R², co jest typowe. Wynik zależy nieco od wyboru D:
| D | 5 | 6 | 7 | 8 | 9 | 11 | 12 |
|---|---|---|---|---|---|---|---|
| Q² | .155 | .144 | .160 | .120 | .159 | .160 | .145 |
Najniższe wartości pojawiają się przy D = 8 i 12, czyli wielokrotnościach liczby wskaźników (4). Przy takim D numeracja wierszami sprawia, że w każdej rundzie pomijane są wartości jednego wskaźnika, a nie różnych. Dlatego wybieraj D, które nie jest wielokrotnością liczby wskaźników, i takie, by liczba przypadków nie dzieliła się przez D bez reszty. Przy 250 osobach D = 5 tego warunku nie spełnia.
Blindfolding pozwala też ocenić wkład pojedynczego predyktora w trafność predykcyjną. Po usunięciu ścieżki od skuteczności Q² spadło do .068. Wielkość efektu q² liczy się analogicznie do f² (zob. wielkość efektu):
Q² na tle innych miar modelu strukturalnego
| Miara | Co mierzy | Dane do predykcji |
|---|---|---|
| R² i R² skorygowane | część wariancji konstruktu endogenicznego wyjaśnioną w próbie | te same, co do estymacji |
| f² | spadek R² po usunięciu predyktora | te same, co do estymacji |
| Q² (blindfolding) | przewidywanie pominiętych wartości wskaźników | częściowo te same (pominięte pojedyncze wartości) |
| q² | spadek Q² po usunięciu predyktora | jak w Q² |
| PLSpredict (Q²predict, RMSE, MAE) | przewidywanie odpowiedzi nowych osób | osoby spoza estymacji (podział na części) |
Wszystkie te miary dotyczą modelu z kompozytami. W modelach estymowanych jako Model A lub Model B procedura jest taka sama, bo pomijane i przewidywane są wartości wskaźników, a nie wagi.
Ograniczenia: Q² to nie predykcja poza próbą
Pominięty punkt danych nie znika naprawdę. Pozostałe odpowiedzi tej samej osoby, w tym jej wyniki konstruktów egzogenicznych, nadal biorą udział w estymacji wag, a wartość pominięta jest zastąpiona średnią. Q² z blindfoldingu ocenia więc trafność predykcyjną tylko częściowo. Shmueli i in. (2019) zauważają, że ocena modeli PLS-SEM opierała się dotąd na miarach mocy wyjaśniającej. Jako uzupełnienie opisują PLSpredict – procedurę z próbą wstrzymaną (ang. holdout), w której przewiduje się odpowiedzi osób niebiorących udziału w estymacji. Hair i in. (2019) włączają PLSpredict do aktualnych zaleceń oceny modeli PLS-SEM. W praktyce raportuj Q² z blindfoldingu, jeśli wymaga tego czasopismo lub promotor, ale do wniosków o predykcji poza próbą użyj PLSpredict.
Q² ma sens tylko dla konstruktów endogenicznych mierzonych refleksyjnie (zob. refleksyjna zmienna latentna). Dla konstruktów formatywnych i jednowskaźnikowych przewidywanie poszczególnych wskaźników z ładunków nie odpowiada logice pomiaru.
Jak opisać blindfolding w pracy (APA)
Podaj wariant (redundancja walidowana krzyżowo), odległość pominięcia D, wartości Q² dla każdego konstruktu endogenicznego obok R² oraz – jeśli porównujesz predyktory – q². Wskaż program lub pakiet i jego wersję.
Blindfolding w R (seminr i własna funkcja)
Pakiet seminr szacuje model PLS-SEM, ale nie ma gotowej funkcji blindfolding. Dlatego kod zawiera krótką funkcję, która realizuje procedurę z tego hasła: numeruje punkty danych wierszami, pomija co D-ty punkt, zastępuje go średnią, szacuje model i przewiduje pominięte wartości (redundancja walidowana krzyżowo). Liczby w tekście pochodzą z tego kodu.
Q² Stone’a–Geissera i wielkość efektu q²
R
suppressPackageStartupMessages({library(lavaan); library(seminr)})

# Dane symulowane: 250 studentów; wsparcie społeczne (ws1–ws3) i poczucie własnej skuteczności (sk1–sk3)
# wyjaśniają zaangażowanie w naukę (za1–za4). Odpowiedzi na skali 1–7.
set.seed(100)
pop <- '
  wsparcie    =~ 0.80*ws1 + 0.75*ws2 + 0.70*ws3
  skutecznosc =~ 0.80*sk1 + 0.78*sk2 + 0.72*sk3
  zaangazowanie =~ 0.82*za1 + 0.78*za2 + 0.75*za3 + 0.70*za4
  zaangazowanie ~ 0.35*wsparcie + 0.50*skutecznosc
  wsparcie ~~ 0.30*skutecznosc
'
z <- simulateData(pop, sample.nobs = 250, standardized = TRUE)
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.4 * x), 1), 7)))

mm <- constructs(
  composite("Wsparcie",      multi_items("ws", 1:3)),
  composite("Skutecznosc",   multi_items("sk", 1:3)),
  composite("Zaangazowanie", multi_items("za", 1:4)))
sm <- relationships(paths(from = c("Wsparcie", "Skutecznosc"), to = "Zaangazowanie"))
pls <- function(d) suppressMessages(estimate_pls(d, mm, sm))
fit <- pls(dane)
round(fit$path_coef, 3)
round(fit$rSquared, 3)

# Blindfolding (redundancja walidowana krzyżowo, Q²) – implementacja krok po kroku
# 1. Punkty danych wskaźników konstruktu endogenicznego numerujemy wierszami: (przypadek 1, za1), (1, za2), ...
# 2. W rundzie d pomijamy co D-ty punkt, zaczynając od d; zastępujemy go średnią z pozostałych obserwacji.
# 3. Szacujemy model na zmienionych danych i przewidujemy pominięte wartości:
#    ẑ(ik) = ładunek_k × Σ β_j × wynik_j(i) (w jednostkach standaryzowanych).
# 4. Q² = 1 − SSE / SSO, gdzie SSO to suma kwadratów odchyleń pominiętych wartości od średniej.
blindfolding <- function(dane, D = 7, endo = "Zaangazowanie", wsk = paste0("za", 1:4), egzo = c("Wsparcie", "Skutecznosc")) {
  n <- nrow(dane); K <- length(wsk)
  nr <- matrix(seq_len(n * K), nrow = n, byrow = TRUE)          # numer punktu danych (wierszami)
  zstd <- scale(dane[, wsk])                                     # wartości standaryzowane do porównań
  SSE <- SSO <- 0
  for (d in 1:D) {
    pomin <- (nr - d) %% D == 0
    dd <- dane
    for (k in seq_len(K)) dd[pomin[, k], wsk[k]] <- mean(dane[!pomin[, k], wsk[k]])
    f <- pls(dd)
    pred_konstrukt <- as.matrix(f$construct_scores[, egzo]) %*% f$path_coef[egzo, endo]
    for (k in seq_len(K)) {
      lad <- f$outer_loadings[wsk[k], endo]
      sr  <- mean(dane[!pomin[, k], wsk[k]]); sdk <- sd(dd[, wsk[k]])
      obs <- (dane[pomin[, k], wsk[k]] - sr) / sdk               # pominięte wartości w jednostkach z
      prz <- lad * pred_konstrukt[pomin[, k]]
      SSE <- SSE + sum((obs - prz)^2); SSO <- SSO + sum(obs^2)
    }
  }
  c(D = D, SSO = SSO, SSE = SSE, Q2 = 1 - SSE / SSO)
}
round(blindfolding(dane, D = 7), 3)

# Wrażliwość na odległość pominięcia D (n/D nie powinno być liczbą całkowitą)
round(t(sapply(c(5, 6, 7, 8, 9, 11, 12), function(D) blindfolding(dane, D)[c("D", "Q2")])), 3)

# Model bez skuteczności jako predyktora: spadek Q² pokazuje jej wkład w trafność predykcyjną
sm0 <- relationships(paths(from = "Wsparcie", to = "Zaangazowanie"))
mm0 <- constructs(composite("Wsparcie", multi_items("ws", 1:3)), composite("Zaangazowanie", multi_items("za", 1:4)))
pls <- function(d) suppressMessages(estimate_pls(d, mm0, sm0))
q2_bez <- blindfolding(dane, D = 7, egzo = "Wsparcie")
round(q2_bez, 3)
# Wielkość efektu q² dla skuteczności: (Q² z predyktorem − Q² bez niego) / (1 − Q² z predyktorem)
pls <- function(d) suppressMessages(estimate_pls(d, mm, sm))
q2_pelny <- blindfolding(dane, D = 7)
round(unname((q2_pelny["Q2"] - q2_bez["Q2"]) / (1 - q2_pelny["Q2"])), 3)
Wynik w R
              Wsparcie Skutecznosc Zaangazowanie
Wsparcie             0           0         0.226
Skutecznosc          0           0         0.338
Zaangazowanie        0           0         0.000
       Zaangazowanie
Rsq            0.193
AdjRsq         0.186
       D      SSO      SSE       Q2
   7.000 1189.192  998.550    0.160
      D    Q2
[1,]  5 0.155
[2,]  6 0.144
[3,]  7 0.160
[4,]  8 0.120
[5,]  9 0.159
[6,] 11 0.160
[7,] 12 0.145
       D      SSO      SSE       Q2
   7.000 1189.192 1108.627    0.068
[1] 0.11
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models [R package]. https://doi.org/10.32614/CRAN.package.seminr
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Q² dla konstruktów egzogenicznych lub formatywnych. Q² ma interpretację tylko dla endogenicznych konstruktów refleksyjnych.
- Traktowanie Q² > 0 jako dowodu trafności predykcyjnej poza próbą. Blindfolding używa tych samych osób do estymacji i predykcji; do tego służy PLSpredict.
- Brak informacji o D i wariancie. Redundancja i komunalność walidowana krzyżowo dają różne wartości.
- Nieprzemyślane D. Wartość będąca wielokrotnością liczby wskaźników albo dzieląca liczbę przypadków bez reszty zaburza schemat pomijania.
- Porównywanie Q² z R² jak dwóch miar tego samego. R² opisuje wyjaśnianie w próbie, Q² – predykcję pominiętych wartości.
Miejsce blindfoldingu w całej ocenie modelu pokazują poradniki PLS-SEM krok po kroku i PLS-SEM w R: seminr i cSEM, a o wyborze między PLS-SEM a CB-SEM przeczytasz we wpisie PLS-SEM czy CB-SEM. Niepewność współczynników ścieżek ocenisz z kolei bootstrapem.
Najczęstsze pytania
Jaką wartość Q² uznaje się za dobrą w PLS-SEM?
Podstawowa interpretacja dotyczy znaku: Q² > 0 oznacza, że model przewiduje pominięte wartości wskaźników lepiej niż ich średnia, a Q² ≤ 0 – że nie ma trafności predykcyjnej. Wielkość Q² porównuj z R² i z modelami alternatywnymi, a o predykcji poza próbą wnioskuj na podstawie PLSpredict.
Jaką odległość pominięcia D wybrać w blindfoldingu?
Najczęściej wartość od 5 do 12, domyślnie 7. Ważne, by liczba przypadków nie dzieliła się przez D bez reszty, a D nie było wielokrotnością liczby wskaźników konstruktu – inaczej schemat pomijania obejmuje w rundzie tylko jeden wskaźnik.
Czym różni się Q² z blindfoldingu od PLSpredict?
Blindfolding pomija pojedyncze wartości, ale te same osoby nadal uczestniczą w estymacji, więc ocena predykcji jest częściowo „w próbie”. PLSpredict dzieli próbę na części i przewiduje odpowiedzi osób, których dane nie były użyte do estymacji, czyli ocenia predykcję poza próbą.
Jak policzyć wielkość efektu q² w PLS-SEM?
Policz Q² dla modelu pełnego i dla modelu bez danego predyktora, a następnie q² = (Q²pełny − Q²bez) / (1 − Q²pełny). W przykładzie z hasła usunięcie poczucia skuteczności obniżyło Q² z .160 do .068, co daje q² = .110.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku
Logika kompozytów, założenia, ocena modelu refleksyjnego i formatywnego, ścieżki, f² i PLSpredict – na przykładzie z R, z tabelą progów i źródeł.
Czytaj →PoradnikPLS-SEM w R: seminr i cSEM
Kompletny przykład z mediacją: model pomiarowy i strukturalny, bootstrap, PLSpredict, consistent PLS i test dopasowania – z danymi, kodem i opisem APA.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Geisser, S. (1974). A predictive approach to the random effect model. Biometrika, 61(1), 101–107. https://doi.org/10.1093/biomet/61.1.101 ● Otwarty dostęp: pełny tekst
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Shmueli, G., Sarstedt, M., Hair, J. F., Cheah, J.-H., Ting, H., Vaithilingam, S., & Ringle, C. M. (2019). Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. European Journal of Marketing, 53(11), 2322–2347. https://doi.org/10.1108/ejm-02-2019-0189 ● Otwarty dostęp: pełny tekst
- Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. https://doi.org/10.1111/j.2517-6161.1974.tb00994.x
Cytowania BibTeX
@article{geisser1974predictive, author={Geisser, Seymour}, title={{A predictive approach to the random effect model}}, journal={Biometrika}, year={1974}, volume={61}, number={1}, pages={101--107}, doi={10.1093/biomet/61.1.101}}@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{shmueli2019predictive, author={Shmueli, Galit and Sarstedt, Marko and Hair, Joseph F. and Cheah, Jun-Hwa and Ting, Hiram and Vaithilingam, Santha and Ringle, Christian M.}, title={{Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict}}, journal={European Journal of Marketing}, year={2019}, volume={53}, number={11}, pages={2322--2347}, doi={10.1108/ejm-02-2019-0189}}@article{stone1974cross, author={Stone, M.}, title={{Cross-validatory choice and assessment of statistical predictions}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1974}, volume={36}, number={2}, pages={111--133}, doi={10.1111/j.2517-6161.1974.tb00994.x}}