Co to jest SEM?
Modelowanie równań strukturalnych (ang. structural equation modeling, SEM) to rodzina metod, które w jednym modelu łączą dwa zadania: pomiar konstruktów, których nie obserwujemy wprost, i testowanie zależności między nimi. Konstrukt taki jak stres, wypalenie czy zadowolenie z życia jest zmienną latentną: znamy go tylko z odpowiedzi na kilka pozycji kwestionariusza, czyli ze zmiennych jawnych. SEM szacuje, jak mocno każda pozycja odzwierciedla konstrukt, i jednocześnie – jak konstrukty wpływają na siebie nawzajem.
W psychologii SEM obejmuje kilka dobrze znanych analiz jako przypadki szczególne. Konfirmacyjna analiza czynnikowa to SEM bez ścieżek między konstruktami. Analiza ścieżek to SEM bez zmiennych latentnych. Regresja i mediacja na wynikach sumarycznych to jeszcze prostsze modele. MacCallum i Austin (2000) w przeglądzie zastosowań pokazują, jak różne plany badawcze da się analizować w SEM, ale też, że w publikowanych analizach powtarzają się chroniczne problemy metodologiczne – najczęstsze błędy zebraliśmy na końcu tej strony.
Model pomiarowy i model strukturalny
Każdy model SEM składa się z dwóch części, które na wykresie ścieżkowym rysuje się według stałej konwencji: prostokąty to zmienne jawne, elipsy – latentne, strzałki jednokierunkowe – wpływy, łuki dwukierunkowe – kowariancje.
| Część modelu | Co opisuje | Główne parametry | Gdzie czytać więcej |
|---|---|---|---|
| Model pomiarowy | Jak pozycje odzwierciedlają konstrukty | Ładunki, wariancje błędu, korelacje czynników | ładunek czynnikowy, refleksyjna zmienna latentna |
| Model strukturalny | Jak konstrukty wpływają na siebie | Współczynniki ścieżek, efekty pośrednie, R² zmiennych endogenicznych | efekt pośredni, R² |
Zmienna egzogeniczna (w przykładzie stres) nie ma w modelu przyczyn – jest tylko ich źródłem. Zmienne endogeniczne (wypalenie, zadowolenie z życia) mają przynajmniej jedną strzałkę wchodzącą i własną wariancję niewyjaśnioną. Anderson i Gerbing (1988) zalecają podejście dwuetapowe: najpierw sprawdź model pomiarowy (CFA), dopiero potem interpretuj ścieżki strukturalne. Jeśli pozycje źle mierzą konstrukty, współczynniki ścieżek nie mają sensownej interpretacji.
Dwie rodziny: CB-SEM i PLS-SEM
Pod nazwą SEM kryją się dwa podejścia o innej logice estymacji. Wybór między nimi omawia szczegółowo wpis PLS-SEM czy CB-SEM; tu najkrótsze porównanie:
| Cecha | CB-SEM (kowariancyjne) | PLS-SEM (wariancyjne) |
|---|---|---|
| Co dopasowuje | Macierz kowariancji odtworzoną z modelu do obserwowanej | Kompozyty (ważone sumy wskaźników) i regresje między nimi |
| Typowa estymacja | największa wiarygodność (ML), MLR | Iteracyjny algorytm PLS, dla czynników wspólnych – PLSc |
| Ocena modelu | Test χ² i indeksy dopasowania | Rzetelność, trafność, R², PLSpredict, Q² |
| Rzetelność konstruktu | omega = rzetelność kompozytowa | ρC, ρA |
| Praktyczny przewodnik | CB-SEM krok po kroku, przykład w lavaan | PLS-SEM krok po kroku, seminr i cSEM |
W psychologii, gdzie konstrukty zwykle traktuje się jako czynniki wspólne, domyślnym wyborem jest CB-SEM. Dalsza część strony dotyczy właśnie tego podejścia.
Etapy analizy SEM
- Specyfikacja – narysuj model wynikający z teorii, zanim zobaczysz dane: które pozycje mierzą który konstrukt i które ścieżki są dopuszczone.
- Identyfikacja – sprawdź, czy parametrów nie jest więcej niż informacji w danych. Przy p zmiennych jawnych masz p(p + 1)/2 wariancji i kowariancji; różnica między tą liczbą a liczbą parametrów to stopnie swobody (szczegóły: identyfikacja modelu SEM).
- Estymacja – zwykle ML; przy skośnych odpowiedziach MLR, przy pozycjach porządkowych – estymatory dla danych kategorialnych.
- Ocena dopasowania – test χ² i kilka indeksów różnego typu (tabela niżej) oraz lokalne niedopasowania w resztach standaryzowanych.
- Interpretacja – ładunki, ścieżki, efekty pośrednie z przedziałami bootstrapowymi, wyjaśniona wariancja.
- Modyfikacja – tylko uzasadniona teoretycznie i jawnie opisana; indeksy modyfikacji to podpowiedź, nie decyzja.
Przykład: stres, wypalenie i zadowolenie z życia
W badaniu 320 studentów (dane symulowane) każdy z trzech konstruktów zmierzono trzema pozycjami na skali 1–5. Hipoteza: stres akademicki zwiększa wypalenie, a wypalenie obniża zadowolenie z życia; dopuszczono też bezpośrednią ścieżkę od stresu do zadowolenia. Dziewięć pozycji daje 9 × 10/2 = 45 wariancji i kowariancji, model ma 21 parametrów, więc df = 24.
Krok 1 – model pomiarowy. CFA z trzema skorelowanymi czynnikami: χ²(24) = 49.57, p = .002, CFI = .976, TLI = .965, RMSEA = .058, 90% CI [.035, .080], SRMR = .043. Test χ² odrzuca dokładne dopasowanie, ale indeksy przybliżonego dopasowania są dobre. Ładunki standaryzowane mieszczą się w przedziale .67–.84. Największy indeks modyfikacji (32.85) dotyczy ładunku krzyżowego pozycji zad3 na wypaleniu. Jeśli treść pozycji tego nie uzasadnia, nie dodawaj go – opisz jako ograniczenie.
Krok 2 – model strukturalny. Ponieważ model strukturalny ma wszystkie możliwe ścieżki między trzema konstruktami, jego dopasowanie jest identyczne jak w CFA – całe niedopasowanie pochodzi z części pomiarowej. Stres przewidywał wypalenie (β = .54), a wypalenie – niższe zadowolenie z życia (β = −.55). Ścieżka bezpośrednia od stresu do zadowolenia była nieistotna (β = −.08). Efekt pośredni stresu przez wypalenie wyniósł b = −0.29, 95% CI [−0.40, −0.19] (bootstrap percentylowy, 1000 prób). Model wyjaśnił 29.1% wariancji wypalenia i 35.5% wariancji zadowolenia.
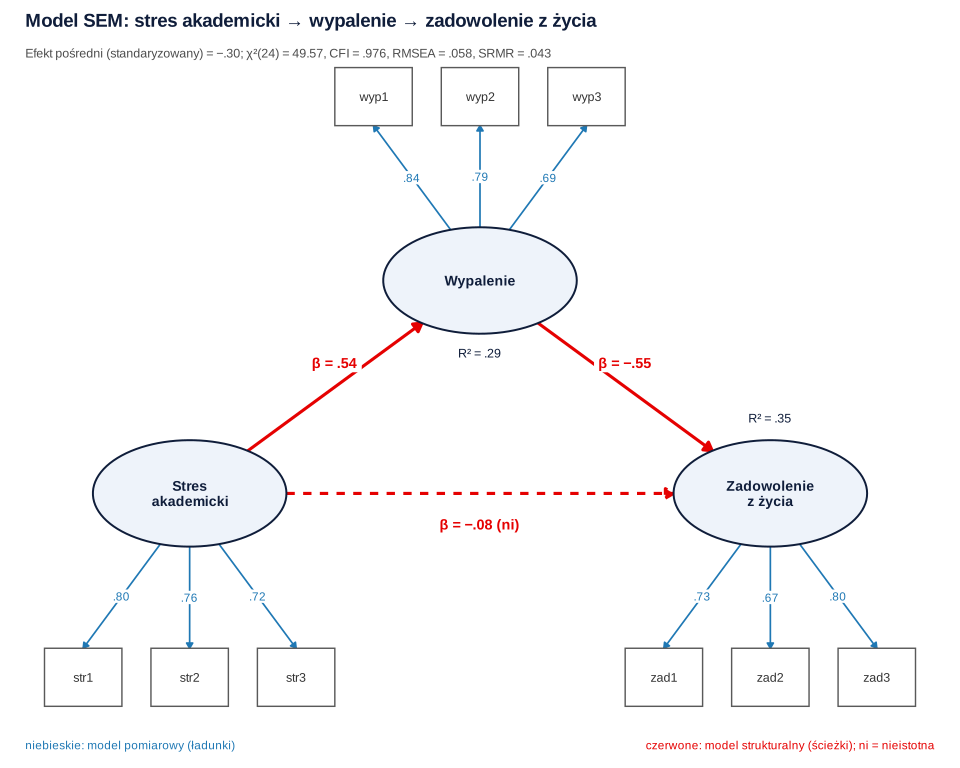
Czy ścieżkę bezpośrednią można usunąć? Model bez niej (mediacja całkowita) nie był istotnie gorszy: test różnicy χ² dał Δχ²(1) = 0.92, p = .339, a AIC i BIC były nieco niższe dla modelu prostszego (5683.7 vs 5684.8 i 5759.1 vs 5763.9). Pamiętaj, że to dane przekrojowe: model zgodny z danymi nie dowodzi kierunku przyczynowego.
Indeksy dopasowania – mapa haseł
Żaden pojedynczy wskaźnik nie rozstrzyga o dopasowaniu. Hu i Bentler (1999) na podstawie symulacji zaproponowali dla estymacji ML wartości orientacyjne: CFI i TLI bliskie .95 lub wyższe, RMSEA bliskie .06 lub niższe, SRMR bliskie .08 lub niższe, i zalecili raportowanie dwóch wskaźników razem. To punkty orientacyjne dla określonych warunków symulacji, nie progi „zaliczenia”.
| Rodzaj | Wskaźniki | Co mierzą |
|---|---|---|
| Test dokładnego dopasowania | χ² (CMIN), FMIN | Czy model odtwarza macierz kowariancji bez błędu |
| Bezwzględne | RMSEA, SRMR, GFI | Wielkość niedopasowania samego modelu |
| Przyrostowe | CFI, TLI, NFI | Poprawa względem modelu niezależności zmiennych |
| Z karą za złożoność | PGFI, PNFI, PCFI | Dopasowanie skorygowane o liczbę parametrów |
| Porównanie modeli | AIC, BIC, test różnicy χ² | Który z kilku modeli wybrać |
Jak opisać model SEM w pracy (APA)
Schreiber i in. (2006) wymieniają informacje, które powinien zawierać każdy artykuł z SEM lub CFA. W praktyce: rysunek modelu, program i estymator, liczebność i obsługa braków danych, test χ² z kilkoma indeksami, ładunki, ścieżki z przedziałami ufności i każda modyfikacja modelu. Wzór dla przykładu:
Model SEM w R (lavaan)
Kod tworzy dane z przykładu, szacuje model pomiarowy, model strukturalny z efektem pośrednim i bootstrapem oraz porównuje go z modelem bez ścieżki bezpośredniej. Wszystkie liczby na tej stronie i na rysunku 1 pochodzą z tego kodu. Składnię lavaan opisuje jego autor (Rosseel, 2012).
Dwuetapowa analiza SEM
R
# Dane symulowane: 320 studentów, trzy konstrukty mierzone po 3 pozycjami (skala 1–5, wyniki średnie z odpowiedzi)
# Stres akademicki (STR) -> Wypalenie (WYP) -> Zadowolenie z życia (ZAD) oraz ścieżka bezpośrednia STR -> ZAD
suppressPackageStartupMessages(library(lavaan))
set.seed(2137)
n <- 320
STR <- rnorm(n)
WYP <- 0.55 * STR + rnorm(n, sd = sqrt(1 - 0.55^2))
ZAD <- -0.45 * WYP - 0.15 * STR + rnorm(n, sd = 0.82)
poz <- function(f, l) round(pmin(pmax(3 + 0.8 * (l * f + rnorm(n, sd = sqrt(1 - l^2))), 1), 5), 1)
dane <- data.frame(str1 = poz(STR, .80), str2 = poz(STR, .75), str3 = poz(STR, .70),
                   wyp1 = poz(WYP, .85), wyp2 = poz(WYP, .80), wyp3 = poz(WYP, .70),
                   zad1 = poz(ZAD, .80), zad2 = poz(ZAD, .75), zad3 = round(pmin(pmax(3 + 0.8 * (0.60 * ZAD - 0.30 * WYP + rnorm(n, sd = 0.70)), 1), 5), 1))
# zad3 słabo zależy też od wypalenia (ładunek krzyżowy, którego model nie zakłada) – drobne niedopasowanie

# Krok 1: model pomiarowy (CFA) – czy pozycje mierzą swoje konstrukty
pomiar <- '
  STR =~ str1 + str2 + str3
  WYP =~ wyp1 + wyp2 + wyp3
  ZAD =~ zad1 + zad2 + zad3
'
cfa1 <- cfa(pomiar, data = dane)
round(fitMeasures(cfa1, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr")), 3)
# Największe indeksy modyfikacji – podpowiedź, nie automatyczna poprawka
mi <- modindices(cfa1, sort. = TRUE)[1:3, c("lhs", "op", "rhs", "mi", "sepc.all")]
mi[, 4:5] <- round(mi[, 4:5], 2); mi

# Krok 2: model strukturalny – hipotezy o zależnościach między konstruktami
model <- '
  STR =~ str1 + str2 + str3
  WYP =~ wyp1 + wyp2 + wyp3
  ZAD =~ zad1 + zad2 + zad3
  WYP ~ a * STR
  ZAD ~ b * WYP + c * STR
  posredni := a * b
  calkowity := c + a * b
'
sem1 <- sem(model, data = dane, se = "bootstrap", bootstrap = 1000)
round(fitMeasures(sem1, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "srmr")), 3)
# Ładunki i ścieżki standaryzowane
st <- standardizedSolution(sem1)
st_l <- st[st$op %in% c("=~", "~", ":="), c("lhs", "op", "rhs", "est.std", "se", "pvalue")]
st_l[, 4:6] <- round(st_l[, 4:6], 3); st_l
# Ścieżki niestandaryzowane z bootstrapowym 95% CI (percentylowym)
pe <- parameterEstimates(sem1, boot.ci.type = "perc")
pe_l <- pe[pe$op %in% c("~", ":="), c("lhs", "op", "rhs", "label", "est", "ci.lower", "ci.upper", "pvalue")]
pe_l[, 5:8] <- round(pe_l[, 5:8], 3); pe_l
# Wyjaśniona wariancja zmiennych endogenicznych
round(lavInspect(sem1, "r2")[c("WYP", "ZAD")], 3)
# Liczba danych i parametrów: p(p + 1)/2 = 45 momentów
c(momenty = 9 * 10 / 2, parametry = lavInspect(sem1, "npar"), df = fitMeasures(sem1, "df"))

# Model alternatywny: mediacja całkowita (bez ścieżki STR -> ZAD) – test różnicy chi-kwadrat
model2 <- sub("ZAD ~ b * WYP + c * STR", "ZAD ~ b * WYP", model, fixed = TRUE)
model2 <- sub("  calkowity := c + a * b\n", "", model2, fixed = TRUE)
sem2 <- sem(model2, data = dane)
lavTestLRT(sem(model, data = dane), sem2)
Wynik w R
         chisq             df         pvalue            cfi            tli
        49.565         24.000          0.002          0.976          0.965
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr
         0.058          0.035          0.080          0.043
    lhs op  rhs    mi sepc.all
36  WYP =~ zad3 32.85    -0.47
76 zad1 ~~ zad2 30.68     0.59
34  WYP =~ zad1 11.68     0.26
 chisq     df pvalue    cfi    tli  rmsea   srmr
49.565 24.000  0.002  0.976  0.965  0.058  0.043
         lhs op   rhs est.std    se pvalue
1        STR =~  str1   0.802 0.034  0.000
2        STR =~  str2   0.755 0.035  0.000
3        STR =~  str3   0.725 0.035  0.000
4        WYP =~  wyp1   0.840 0.028  0.000
5        WYP =~  wyp2   0.788 0.031  0.000
6        WYP =~  wyp3   0.691 0.036  0.000
7        ZAD =~  zad1   0.731 0.049  0.000
8        ZAD =~  zad2   0.671 0.048  0.000
9        ZAD =~  zad3   0.796 0.050  0.000
10       WYP  ~   STR   0.539 0.056  0.000
11       ZAD  ~   WYP  -0.551 0.075  0.000
12       ZAD  ~   STR  -0.076 0.076  0.318
25  posredni :=   a*b  -0.297 0.054  0.000
26 calkowity := c+a*b  -0.373 0.062  0.000
         lhs op   rhs     label    est ci.lower ci.upper pvalue
10       WYP  ~   STR         a  0.573    0.441    0.718  0.000
11       ZAD  ~   WYP         b -0.500   -0.648   -0.361  0.000
12       ZAD  ~   STR         c -0.073   -0.221    0.071  0.324
25  posredni :=   a*b  posredni -0.287   -0.401   -0.189  0.000
26 calkowity := c+a*b calkowity -0.360   -0.496   -0.242  0.000
  WYP   ZAD
0.291 0.355
  momenty parametry     df.df
       45        21        24

Chi-Squared Difference Test

                        Df    AIC    BIC  Chisq Chisq diff RMSEA Df diff
sem(model, data = dane) 24 5684.8 5763.9 49.565
sem2                    25 5683.7 5759.1 50.481     0.9162     0       1
                        Pr(>Chisq)
sem(model, data = dane)
sem2                        0.3385
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizach SEM
- Interpretowanie ścieżek bez sprawdzenia modelu pomiarowego. Złe ładunki lub brak trafności różnicowej (HTMT) podważają każdą ścieżkę.
- Raportowanie tylko wskaźników, które „wyszły”. Podaj χ², RMSEA z przedziałem, CFI/TLI i SRMR – zawsze ten sam zestaw.
- Dopisywanie kowariancji reszt i ładunków krzyżowych według indeksów modyfikacji bez uzasadnienia treścią pozycji. Model przestaje być konfirmacyjny.
- Wnioski przyczynowe z danych przekrojowych. Modele z odwróconymi strzałkami często pasują równie dobrze.
- Za mała próba dla złożonego modelu – niestabilne oszacowania i przypadki Heywooda. Liczebność planuj z wyprzedzeniem (wpis dobór liczebności próby).
- Pomijanie modeli alternatywnych. Dobre dopasowanie jednego modelu nie wyklucza innych wyjaśnień – porównaj przynajmniej jeden konkurencyjny model zgodny z teorią, tak jak w przykładzie z mediacją całkowitą.
Jeśli potrzebujesz pomocy przy specyfikacji modelu albo opisie wyników, zajrzyj do oferty analiz statystycznych dla studentów.
Najczęstsze pytania
Czym SEM różni się od zwykłej regresji?
Regresja traktuje wyniki skal jako pomiar bez błędu i ma jedną zmienną zależną. SEM modeluje konstrukty jako zmienne latentne mierzone kilkoma pozycjami, oddziela błąd pomiaru od wariancji wspólnej i pozwala szacować wiele równań naraz – na przykład łańcuch stres → wypalenie → zadowolenie z efektem pośrednim.
Co oznacza, że model strukturalny ma takie samo dopasowanie jak CFA?
Tak jest, gdy część strukturalna zawiera wszystkie możliwe ścieżki lub kowariancje między konstruktami, czyli jest nasycona. Całe niedopasowanie pochodzi wtedy z modelu pomiarowego, a indeksy dopasowania nic nie mówią o trafności hipotez strukturalnych – o nich świadczą oszacowania ścieżek i porównania z modelami alternatywnymi.
Ile osób potrzeba do analizy SEM?
Nie ma jednej reguły – potrzebna liczebność zależy od liczby parametrów, siły ładunków, liczby wskaźników na konstrukt i rozkładu danych. Małe próby zwiększają ryzyko braku zbieżności i ujemnych wariancji. Liczebność planuj analizą mocy, np. dla RMSEA albo przez symulację modelu, który zamierzasz testować.
Jakie indeksy dopasowania podać w pracy z SEM?
Standardowy zestaw to χ² z df i p, RMSEA z 90% przedziałem ufności, CFI, TLI i SRMR. Hu i Bentler (1999) zalecali raportowanie co najmniej dwóch wskaźników różnego typu. Przy porównywaniu modeli dodaj test różnicy χ² oraz AIC i BIC.
Czy w SEM można udowodnić związek przyczynowy?
Nie. Model zgodny z danymi jest tylko jednym z wielu modeli, które mogą do nich pasować, w tym modeli z odwróconymi strzałkami. O przyczynowości decyduje plan badania (eksperyment, pomiary podłużne), a nie sama analiza – w danych przekrojowych pisz o związkach zgodnych z hipotezą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modelowanie równań strukturalnych (SEM): od teorii do raportu
SEM bez skrótów myślowych: model pomiarowy i strukturalny, CB-SEM a PLS-SEM, dopasowanie, założenia oraz raportowanie wyników.
Czytaj →PoradnikCB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikPLS-SEM czy CB-SEM? Porównanie metod i praktyczna decyzja
Neutralne porównanie PLS-SEM i CB-SEM: cel, rodzaj konstruktu, estymacja, dopasowanie, predykcja, próba i raportowanie bez popularnych mitów.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- MacCallum, R. C., & Austin, J. T. (2000). Applications of structural equation modeling in psychological research. Annual Review of Psychology, 51(1), 201–226. https://doi.org/10.1146/annurev.psych.51.1.201
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Schreiber, J. B., Nora, A., Stage, F. K., Barlow, E. A., & King, J. (2006). Reporting structural equation modeling and confirmatory factor analysis results: A review. The Journal of Educational Research, 99(6), 323–338. https://doi.org/10.3200/joer.99.6.323-338
Cytowania BibTeX
@article{anderson1988structural, author={Anderson, James C. and Gerbing, David W.}, title={{Structural equation modeling in practice: A review and recommended two-step approach}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={411--423}, doi={10.1037/0033-2909.103.3.411}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{maccallum2000applications, author={MacCallum, Robert C. and Austin, James T.}, title={{Applications of structural equation modeling in psychological research}}, journal={Annual Review of Psychology}, year={2000}, volume={51}, number={1}, pages={201--226}, doi={10.1146/annurev.psych.51.1.201}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{schreiber2006reporting, author={Schreiber, James B. and Nora, Amaury and Stage, Frances K. and Barlow, Elizabeth A. and King, Jamie}, title={{Reporting structural equation modeling and confirmatory factor analysis results: A review}}, journal={The Journal of Educational Research}, year={2006}, volume={99}, number={6}, pages={323--338}, doi={10.3200/joer.99.6.323-338}}