Co to jest analiza pozycji testu?
Analiza pozycji testu (ang. item analysis) to ocena każdego pytania testu prostymi statystykami klasycznej teorii testów, jednego z modeli pomiaru w psychometrii: wskaźnikiem łatwości i mocą różnicującą. Wykonuje się ją po badaniu pilotażowym testu wiedzy, egzaminu albo skali, żeby poprawić lub usunąć słabe pytania, zanim policzysz rzetelność, np. KR-20.
Łatwość i moc różnicująca
- Wskaźnik łatwości p (od 0 do 1) to odsetek poprawnych odpowiedzi: im wyższy, tym łatwiejsze pytanie, choć po angielsku nazywa się go item difficulty.
- Wskaźnik mocy różnicującej D to różnica odsetków poprawnych odpowiedzi w grupie osób z najwyższym i z najniższym wynikiem testu. Kelley (1939) uzasadnił, by do każdej z tych grup brać po 27% badanych z krańców rozkładu.
- Korelacja pozycja–reszta to korelacja punktowo-dwuseryjna pozycji z sumą pozostałych pytań; wykorzystuje wyniki wszystkich osób.
Progi są umowne. Boateng i in. (2018) piszą, że wybór łatwości zależy od celu narzędzia: skale ogólnego przeznaczenia buduje się z pozycji o średniej łatwości (.40–.60), a skorygowana korelacja z resztą poniżej .30 jest sygnałem, by rozważyć usunięcie pozycji. W teście sprawdzającym opanowanie podstaw łatwe pytania bywają zamierzone.
Przykład
Dwustu pięćdziesięciu studentów rozwiązało 10-pytaniowy test z metodologii (dane symulowane). Łatwość wynosiła od .28 do .94, a korelacje z resztą testu – od −.37 do .45. Pytanie 2 (p = .94) prawie nie różnicowało: r = .19, D = .16. Pytanie 7 różnicowało ujemnie (r = −.37, D = −.24), bo w kluczu zaznaczono dystraktor, który częściej wybierały osoby słabsze.
Na rysunku
Oba rysunki powstały z tych samych 250 odpowiedzi co przykład (dane symulowane, set.seed(575)). Progi .40–.60 i .30 to umowne wartości z sekcji wyżej, a nie kryteria statystyczne.
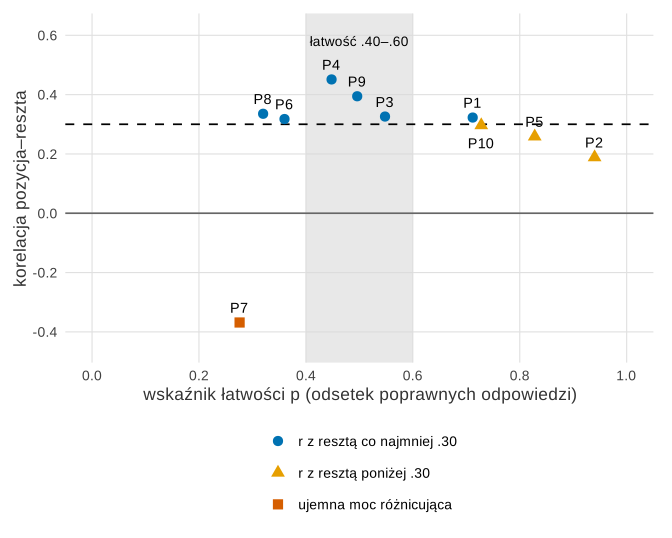
Co widać. Jeden punkt to jedno pytanie. Najmocniej różnicuje P4 (r = .45) – pytanie o średniej łatwości. Im pytanie łatwiejsze, tym niżej leży: P5 (.26) i P2 (.19) są pod linią .30, a P10 (.297) dotyka jej. P7 odstaje od reszty – ujemna korelacja to sygnał, by najpierw sprawdzić klucz.
Na co uważać. Wykres pokazuje dwie liczby na pytanie, ale nie mówi, dlaczego pytanie jest słabe; to wyjaśnia dopiero lektura treści i rozkładu odpowiedzi na dystraktory. Przy 250 osobach korelacje z resztą mają błąd losowy, a różnica między P10 (.297) i P1 (.32) mieści się w granicach tego błędu – nie oceniaj pytań po trzecim miejscu po przecinku.
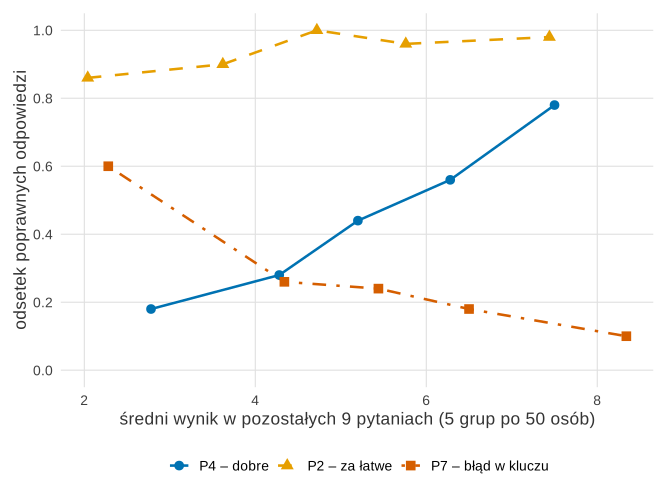
Co widać. Osoby podzielono na pięć grup po 50 według wyniku w pozostałych dziewięciu pytaniach. W pytaniu P4 odsetek poprawnych rośnie z grupy do grupy od .18 do .78 – tak wygląda moc różnicująca. P2 jest płaskie (.86–1.00), bo prawie wszyscy odpowiadają dobrze. P7 opada od .60 do .10: im lepszy student, tym rzadziej trafia w odpowiedź z klucza.
Na co uważać. Każdy punkt opiera się na 50 osobach, więc nierówności krzywej (np. spadek P2 z 1.00 do .96) mogą być przypadkowe. Taka krzywa jest empirycznym odpowiednikiem krzywej charakterystycznej pozycji z IRT, ale nie zastępuje dopasowania modelu.
Kod poniżej odtwarza dane z przykładu i oba wykresy; wymaga tylko pakietu ggplot2. Rysunki na stronie różnią się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunków 1 i 2
library(ggplot2)
kol <- c(dobre = "#0072B2", slabe = "#E69F00", ujemne = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
set.seed(575)                                                      # te same dane co w przykładzie
wiedza <- rnorm(250)
b <- setNames(c(-0.9, -3.0, -0.3, 0.2, -1.4, 0.6, -0.5, 1.0, 0.0, -1.0), paste0("P", 1:10))
odp <- sapply(b, function(bi) rbinom(250, 1, plogis(1.2 * (wiedza - bi))))
odp[, "P7"] <- rbinom(250, 1, plogis(-1.2 - 1.3 * wiedza))         # P7: błąd w kluczu
suma <- rowSums(odp)
poz <- data.frame(pytanie = colnames(odp), p = colMeans(odp),
                  r_reszta = sapply(1:10, function(j) cor(odp[, j], suma - odp[, j])))
poz$ocena <- ifelse(poz$r_reszta < 0, "ujemna moc różnicująca",
                    ifelse(poz$r_reszta < 0.30, "r z resztą poniżej .30", "r z resztą co najmniej .30"))
# Rysunek 1: łatwość a moc różnicująca, progi umowne (.40–.60 i .30)
p1 <- ggplot(poz, aes(p, r_reszta)) +
  annotate("rect", xmin = 0.40, xmax = 0.60, ymin = -Inf, ymax = Inf, fill = "grey85", alpha = 0.6) +
  geom_hline(yintercept = 0.30, linetype = "dashed") + geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(aes(colour = ocena, shape = ocena), size = 3.2) +
  geom_text(aes(y = r_reszta + ifelse(pytanie == "P10", -0.06, 0.05), label = pytanie), size = 3.8) +
  annotate("text", x = 0.50, y = 0.58, label = "łatwość .40–.60", size = 3.6) +
  scale_colour_manual(values = unname(kol[c("dobre", "slabe", "ujemne")]),
                      breaks = c("r z resztą co najmniej .30", "r z resztą poniżej .30", "ujemna moc różnicująca"), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15),
                     breaks = c("r z resztą co najmniej .30", "r z resztą poniżej .30", "ujemna moc różnicująca"), name = NULL) +
  scale_x_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  scale_y_continuous(limits = c(-0.45, 0.62), breaks = seq(-0.4, 0.6, 0.2)) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "wskaźnik łatwości p (odsetek poprawnych odpowiedzi)", y = "korelacja pozycja–reszta") + motyw
# Rysunek 2: krzywe empiryczne – odsetek poprawnych w pięciu grupach wyniku reszty testu
krzywa <- function(j) {
  reszta <- suma - odp[, j]
  grupa <- cut(rank(reszta, ties.method = "first"), 5, labels = FALSE)   # pięć grup po 50 osób
  data.frame(pytanie = colnames(odp)[j], grupa = 1:5,
             reszta_sr = tapply(reszta, grupa, mean), odsetek = tapply(odp[, j], grupa, mean))
}
emp <- do.call(rbind, lapply(c(4, 2, 7), krzywa))
emp$pytanie <- factor(emp$pytanie, levels = c("P4", "P2", "P7"),
                      labels = c("P4 – dobre", "P2 – za łatwe", "P7 – błąd w kluczu"))
round(setNames(poz$r_reszta, poz$pytanie), 3)
round(xtabs(odsetek ~ pytanie + grupa, emp), 2)
p2 <- ggplot(emp, aes(reszta_sr, odsetek, colour = pytanie, shape = pytanie, linetype = pytanie)) +
  geom_line(linewidth = 0.9) + geom_point(size = 3) +
  scale_colour_manual(values = unname(kol[c("dobre", "slabe", "ujemne")]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash"), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(x = "średni wynik w pozostałych 9 pytaniach (5 grup po 50 osób)",
       y = "odsetek poprawnych odpowiedzi") + motyw
# print(p1); print(p2)   # albo: ggsave("rysunek-1.svg", p1, width = 7, height = 5.6)
Wynik w R
    P1     P2     P3     P4     P5     P6     P7     P8     P9    P10
 0.323  0.189  0.326  0.451  0.259  0.318 -0.368  0.335  0.394  0.297
                    grupa
pytanie                 1    2    3    4    5
  P4 – dobre         0.18 0.28 0.44 0.56 0.78
  P2 – za łatwe      0.86 0.90 1.00 0.96 0.98
  P7 – błąd w kluczu 0.60 0.26 0.24 0.18 0.10
Jak zapisać w pracy
Na co uważać
- Korelacja z sumą, która zawiera pozycję, jest zawyżona. W przykładzie dla pytania 4 wyniosła .64, a z resztą testu – .45. Boateng i in. (2018) zalecają wersję skorygowaną; w SPSS to kolumna „Corrected Item-Total Correlation”.
- Pytania, na które prawie wszyscy odpowiadają tak samo, nie mogą mocno różnicować – zbyt łatwe zadania to też droga do efektu sufitu.
- Wskaźniki zależą od próby. W lepiej przygotowanej grupie to samo pytanie okaże się łatwiejsze. Modele teorii reagowania na pozycje testowe (IRT) opisują trudność i dyskryminację pozycji na jednej skali z poziomem cechy.
- Nie usuwaj pytań mechanicznie. Sprawdź treść i klucz, a po zmianach przelicz rzetelność – krótszy test ma ją niższą (zob. wzór Spearmana–Browna). Pełny przykład z testem wiedzy pacjentów znajdziesz w poradniku ankieta wiedzy – analiza krok po kroku.
Przykład w R
Kod tworzy odpowiedzi z przykładu i dla każdego pytania liczy wskaźnik łatwości, korelację z resztą testu, korelację z sumą zawierającą pozycję oraz wskaźnik D dla skrajnych grup po 27% (68 osób). Remisy wyników na granicy grup rozstrzyga kolejność wierszy.
Łatwość, korelacja pozycja–reszta i wskaźnik D
R
set.seed(575)
wiedza <- rnorm(250)                                               # poziom wiedzy 250 studentów
b <- setNames(c(-0.9, -3.0, -0.3, 0.2, -1.4, 0.6, -0.5, 1.0, 0.0, -1.0), paste0("P", 1:10))   # P2 bardzo łatwe
odp <- sapply(b, function(bi) rbinom(250, 1, plogis(1.2 * (wiedza - bi))))   # 1 = poprawna
odp[, "P7"] <- rbinom(250, 1, plogis(-1.2 - 1.3 * wiedza))         # P7: w kluczu zaznaczono dystraktor
suma <- rowSums(odp); kol <- order(suma); n27 <- round(0.27 * 250) # grupy skrajne po 27% (68 osób)
round(rbind(p = colMeans(odp),                                                     # wskaźnik łatwości
            r_reszta = sapply(1:10, function(j) cor(odp[, j], suma - odp[, j])),  # korelacja pozycja–reszta
            r_suma = sapply(1:10, function(j) cor(odp[, j], suma)),               # z sumą, która zawiera pozycję
            D = colMeans(odp[tail(kol, n27), ]) - colMeans(odp[head(kol, n27), ])), 2)   # moc różnicująca D
Wynik w R
           P1   P2   P3   P4   P5   P6    P7   P8   P9  P10
p        0.71 0.94 0.55 0.45 0.83 0.36  0.28 0.32 0.50 0.73
r_reszta 0.32 0.19 0.33 0.45 0.26 0.32 -0.37 0.34 0.39 0.30
r_suma   0.52 0.30 0.54 0.64 0.43 0.53 -0.17 0.53 0.60 0.49
D        0.57 0.16 0.69 0.85 0.38 0.60 -0.24 0.66 0.74 0.51
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); Rysunki 1 i 2 wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Jaki wskaźnik łatwości pytania jest najlepszy?
Zależy od celu testu. Do różnicowania osób najlepiej nadają się pytania o średniej łatwości (ok. .40–.60), bo mogą różnicować najsilniej; w teście sprawdzającym opanowanie podstaw łatwe pytania bywają celowe.
Co oznacza ujemna moc różnicująca pytania?
Że osoby z niższym wynikiem całego testu częściej odpowiadają na to pytanie poprawnie niż osoby z wyższym. Możliwe przyczyny to błąd w kluczu, dwie obronne odpowiedzi albo niejasne sformułowanie – takie pytanie popraw lub usuń.
Czym różni się wskaźnik D od korelacji pozycja–reszta?
Wskaźnik D porównuje tylko grupy skrajne (po 27% osób z najwyższym i najniższym wynikiem), a korelacja pozycja–reszta wykorzystuje wyniki wszystkich osób. Oba mierzą moc różnicującą i zwykle wskazują te same słabe pytania.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza wyników sprawdzianu i ewaluacja w szkole
Zadania do poprawy, porównanie klas bez rankingu nauczycieli, dwa sprawdziany, ankieta ewaluacyjna i raport dla rady: Excel, R i gotowe zdania.
Czytaj →PoradnikJak pisać pytania testowe i dystraktory
Zasady pisania pytań jednokrotnego wyboru, przykłady źle i lepiej z pielęgniarstwa, trzy czy cztery odpowiedzi i analiza dystraktorów po pilotażu w R.
Czytaj →PoradnikJak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikDobre pozycje testowe i liczebność próby w IRT
Kryteria dobrej pozycji, przykłady z badań, planowanie próby symulacją Monte Carlo w R i najważniejsze przeliczenia parametrów IRT.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Kelley, T. L. (1939). The selection of upper and lower groups for the validation of test items. Journal of Educational Psychology, 30(1), 17–24. https://doi.org/10.1037/h0057123
Cytowania BibTeX
@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{kelley1939selection, author={Kelley, Truman L.}, title={{The selection of upper and lower groups for the validation of test items}}, journal={Journal of Educational Psychology}, year={1939}, volume={30}, number={1}, pages={17--24}, doi={10.1037/h0057123}}