Co to jest test psychometryczny?
Test psychometryczny (ang. psychological test, psychometric test) to standaryzowane narzędzie, które na podstawie próbki zachowań – odpowiedzi na pytania, rozwiązań zadań, reakcji – pozwala oszacować poziom cechy psychologicznej i porównać go z wynikami innych osób. Słowo „standaryzowane” jest tu kluczowe: każda osoba dostaje te same polecenia, w tych samych warunkach, a jej odpowiedzi są punktowane według tego samego klucza i interpretowane według tych samych norm.
Test różni się od zbioru pytań ułożonych przez badacza tym, że ma udokumentowane właściwości pomiarowe. Dziedzina, która je bada, to psychometria, a punktem odniesienia dla autorów i użytkowników testów są Standards for Educational and Psychological Testing (American Educational Research Association i in., 2014). Wymagania wobec kolejnych etapów budowy narzędzia – od pisania pozycji po ocenę rzetelności i trafności – w przystępnej formie zebrali Boateng i in. (2018).
Pięć cech dobrego testu
O tym, czy narzędzie zasługuje na nazwę testu psychometrycznego, decyduje pięć właściwości. Każda ma w słowniku osobne hasło:
| Cecha | Pytanie, na które odpowiada | Gdzie szukać informacji |
|---|---|---|
| Standaryzacja | Czy wszyscy badani są w tej samej sytuacji (instrukcja, czas, materiały)? | Rozdział o procedurze badania w podręczniku |
| Obiektywność | Czy dwie osoby obliczą i zinterpretują wynik tak samo? | Klucz, zasady punktowania, zgodność sędziów |
| Rzetelność | Jak dokładny jest wynik, czyli ile w nim błędu losowego? | Współczynniki α, ω, test–retest, błąd standardowy pomiaru |
| Trafność | Czy wynik można interpretować tak, jak chce autor? | Badania struktury czynnikowej i związków z innymi zmiennymi |
| Normalizacja | Jak wypada wynik na tle właściwej grupy odniesienia? | Tabele norm, opis próby normalizacyjnej |
Te cechy są od siebie zależne. Bez standaryzacji i obiektywności wynik zawiera dodatkowy błąd, więc spada rzetelność. Niska rzetelność ogranicza z kolei trafność. Normy mają sens tylko wtedy, gdy wynik osoby badanej uzyskano w tych samych warunkach co wyniki próby normalizacyjnej.
Rodzaje testów psychometrycznych
- Testy zdolności i wiadomości – zadania mają poprawne odpowiedzi (np. testy inteligencji, uwagi, pamięci). Wynikiem jest zwykle liczba poprawnych rozwiązań, a jakość zadań ocenia analiza pozycji testu.
- Kwestionariusze osobowości, postaw i objawów – nie ma dobrych ani złych odpowiedzi. Osoba ocenia, w jakim stopniu twierdzenie ją opisuje, najczęściej na skali Likerta.
- Testy szybkości i testy mocy – w pierwszych liczy się, ile łatwych zadań ktoś zdąży rozwiązać w krótkim czasie, w drugich – jak trudne zadania rozwiąże bez presji czasu.
- Testy normatywne i kryterialne – pierwsze porównują osobę z grupą (centyle, steny), drugie z ustalonym standardem (np. „opanował 80% materiału”).
Test psychometryczny to nie to samo co ankieta. Ankieta zbiera informacje o faktach, opiniach i zachowaniach, a jej pytania analizuje się zwykle pojedynczo. Test łączy wiele pozycji w jeden wynik, który ma mierzyć cechę. Różnicę szerzej omawia hasło kwestionariusz a ankieta.
Przykład: co naprawdę znaczy wynik jednej osoby
Najlepiej widać, czym test różni się od zwykłego zestawu pytań, kiedy interpretuje się wynik jednej osoby. Weźmy fikcyjny Kwestionariusz Lęku Egzaminacyjnego: 15 pozycji z odpowiedziami 0–3, wynik od 0 do 45 punktów. Próba normalizacyjna liczy 500 osób studiujących (dane symulowane): M = 20.32, SD = 8.46, α = .89. Studentka uzyskała 31 punktów. Co można o niej powiedzieć?
- Pozycja w grupie. Wynik surowy 31 odpowiada randze centylowej 87.8, czyli niższy wynik ma około 88% osób z próby normalizacyjnej (zob. percentyl). Na skali stenowej to sten 8, a więc wynik wysoki.
- Dokładność wyniku. Każdy wynik zawiera błąd pomiaru. Jego wielkość opisuje błąd standardowy pomiaru (SEM), liczony z odchylenia standardowego i rzetelności:
SEM = SD × √(1 − rxx) = 8.46 × √(1 − .89) = 2.78 pkt95% przedział dla wyniku tej osoby wynosi 31 ± 1.96 × 2.78, czyli od 25.6 do 36.4 punktu. W stenach to zakres od 7 do 9.
- Porównanie dwóch osób. Błąd różnicy dwóch wyników wynosi SEM × √2 = 3.93 punktu. Żeby różnica między dwiema osobami była większa od błędu przy 95% pewności, musi przekroczyć 1.96 × 3.93 = 7.70 punktu. Różnica 4–5 punktów nic więc nie rozstrzyga.
Harvill (1991) definiuje SEM jako odchylenie standardowe błędów pomiaru i pokazuje, jak budować wokół wyniku pasma niepewności. Zaleca też korzystanie z wartości SEM wyznaczonych dla różnych poziomów wyniku, jeśli podręcznik je podaje. Ten sam wynik przy słabszym teście znaczy mniej: gdyby rzetelność wynosiła .70, SEM wzrósłby do 4.6 punktu, a przedział objąłby zakres od 21.9 do 40.1 – od wyniku przeciętnego po bardzo wysoki.
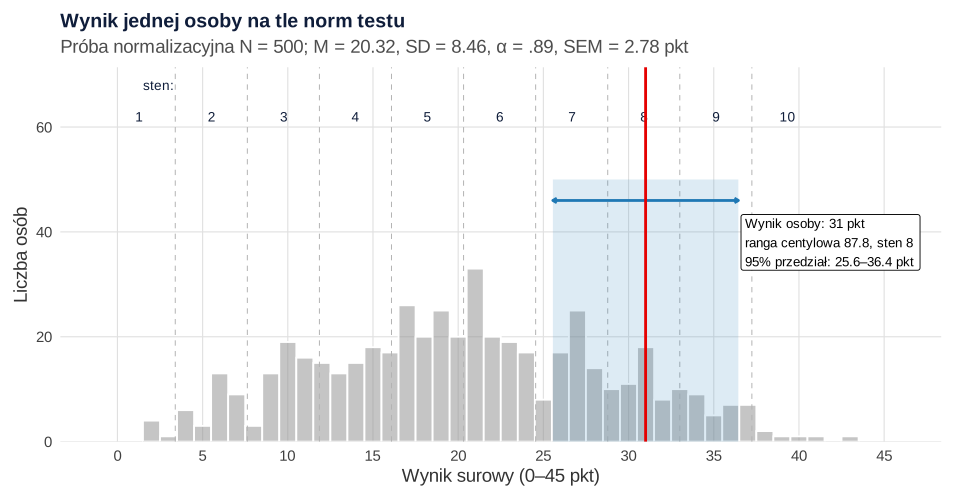
Rysunek pokazuje, dlaczego interpretacja „sten 8, więc wysoki lęk” jest tylko przybliżeniem. Prawdziwy wynik tej osoby może leżeć w stenie 7, 8 albo 9. W diagnozie decyduje się więc na podstawie przedziału, a nie pojedynczej liczby. Normy i przeliczanie wyników omawia szerzej hasło normy testowe.
Co powinien zawierać podręcznik testu
Zanim wybierzesz narzędzie do pracy, sprawdź w podręczniku (albo w artykule walidacyjnym), czy zawiera:
- opis mierzonej cechy i teorii, z której wyrasta test;
- pełną instrukcję badania, klucz i zasady punktowania;
- opis prób badawczych: liczebność, wiek, płeć, sposób doboru i rok badania;
- wskaźniki rzetelności, najlepiej kilka rodzajów, oraz błąd standardowy pomiaru;
- wyniki badań trafności: strukturę czynnikową i związki z innymi miarami;
- normy dla grup, do których odnosisz wyniki, z datą ich opracowania.
W badaniu do pracy dyplomowej liczy się jeszcze jedna sprawa – prawo do użycia testu. Stanowisko International Test Commission (2014) przypomina, że przed użyciem chronionego testu w badaniach trzeba uzyskać zgodę właściciela praw, także na przekład. Pozycji testu nie drukuje się w publikacjach ani w pracach dyplomowych, a zmiany w teście wymagają pisemnej zgody. Gdzie szukać narzędzi z jasnym statusem prawnym, podpowiada wpis Gdzie znaleźć kwestionariusze psychologiczne. Jeśli test pochodzi z innego kraju, sprawdź, czy ma właściwą adaptację.
Jak opisać test w pracy (APA)
W podrozdziale „Narzędzia” każdy test opisz w jednym akapicie: nazwa i autorzy (z adaptacją), co mierzy, liczba pozycji i format odpowiedzi, sposób liczenia wyniku i jego zakres, interpretacja wysokiego wyniku oraz rzetelność w Twojej próbie. Rzetelność z podręcznika nie zastępuje rzetelności policzonej na Twoich danych – podaj obie. Jak raportować współczynniki rzetelności, wyjaśnia wpis Wzór raportowania alfy Cronbacha.
Jeśli interpretujesz wyniki pojedynczych osób, np. w pracy z psychologii klinicznej, podawaj przedziały, a nie same steny: „wynik 31 punktów (95% przedział: 25.6–36.4), sten 8”.
Przykład w R
Kod symuluje próbę normalizacyjną, liczy rzetelność i błąd standardowy pomiaru, a potem interpretuje wynik jednej osoby: przedział, rangę centylową, sten i minimalną różnicę między dwiema osobami. Liczby w tekście pochodzą z tego kodu.
Wynik jednej osoby: SEM, przedział, centyl i sten
R
# R159 – test psychometryczny: od wyniku surowego do przedziału błędu i stenu
# Dane symulowane: próba normalizacyjna N = 500, kwestionariusz lęku egzaminacyjnego (15 pozycji 0–3, wynik 0–45)
suppressPackageStartupMessages(library(psych))
set.seed(159)
N <- 500; k <- 15
theta <- rnorm(N)
progi <- c(-0.9, 0.2, 1.3)
odp <- sapply(1:k, function(j) {
  lat <- 0.62 * theta + rnorm(N, 0, 0.80) + rnorm(1, 0, 0.15)
  findInterval(lat, progi)
})
wynik <- rowSums(odp)
M <- mean(wynik); SD <- sd(wynik)
alfa <- psych::alpha(as.data.frame(odp), warnings = FALSE)$total$raw_alpha
SEM <- SD * sqrt(1 - alfa)
round(c(M = M, SD = SD, alfa = alfa, SEM = SEM), 2)

# Wynik jednej osoby
x <- 31
przedzial <- x + c(-1, 1) * qnorm(0.975) * SEM
round(przedzial, 1)
# ranga centylowa (odsetek wyników niższych + połowa równych)
rc <- 100 * (mean(wynik < x) + 0.5 * mean(wynik == x))
round(rc, 1)
# sten: 5.5 + 2 * z, obcięty do 1–10
sten <- function(s) pmin(pmax(round(5.5 + 2 * (s - M) / SD), 1), 10)
c(sten_wyniku = sten(x), sten_dolna = sten(przedzial[1]), sten_gorna = sten(przedzial[2]))

# Czy dwie osoby różnią się naprawdę? Błąd standardowy różnicy i minimalna różnica (95%)
SE_roznicy <- SEM * sqrt(2)
round(c(SE_roznicy = SE_roznicy, minimalna_roznica = qnorm(0.975) * SE_roznicy), 2)
# Ten sam wynik przy słabszej rzetelności (alfa = .70)
SEM70 <- SD * sqrt(1 - 0.70)
round(c(SEM_przy_70 = SEM70, x + c(-1, 1) * qnorm(0.975) * SEM70), 1)
Wynik w R
    M    SD  alfa   SEM
20.32  8.46  0.89  2.78
[1] 25.6 36.4
[1] 87.8
sten_wyniku  sten_dolna  sten_gorna
          8           7           9
       SE_roznicy minimalna_roznica
             3.93              7.70
SEM_przy_70
        4.6        21.9        40.1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rzetelność policzono funkcją alpha() z pakietu psych, a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie testem dowolnego zestawu pytań. Kilka pytań napisanych do pracy magisterskiej to co najwyżej skala badawcza. Testem stanie się dopiero po zbadaniu rzetelności i trafności. Jak to zrobić, opisuje wpis Jak zbudować i zwalidować skalę psychometryczną?
- Traktowanie wyniku jako dokładnej wartości. Bez błędu standardowego pomiaru nie wiadomo, czy różnica 3 punktów coś znaczy. W przykładzie różnica między dwiema osobami musiała przekroczyć 7.70 punktu.
- Normy z innej populacji. Normy dla dorosłych nie nadają się do oceny nastolatków, a normy sprzed kilkudziesięciu lat mogą zawyżać lub zaniżać wyniki.
- Zmiany w teście bez zgody i bez nowych badań. Skrócenie skali, inna skala odpowiedzi czy przeformułowanie pozycji tworzą nowe narzędzie, do którego normy i dane o rzetelności z podręcznika już nie pasują.
- Publikowanie pozycji testu. Treść chronionych testów nie trafia do aneksu pracy – wystarczy nazwa, źródło i przykładowa pozycja, jeśli właściciel praw się na to zgodził.
- Utożsamianie rzetelności z trafnością. Wysoka α mówi, że pozycje mierzą coś wspólnego, ale nie mówi, czy jest to cecha, którą chcesz mierzyć (zob. spójność wewnętrzna).
Najczęstsze pytania
Czym test psychometryczny różni się od zwykłej ankiety?
Ankieta zbiera informacje o faktach, opiniach i zachowaniach, a jej pytania analizuje się zwykle osobno. Test psychometryczny łączy wiele pozycji w jeden wynik mierzący cechę, ma standaryzowaną procedurę oraz udokumentowaną rzetelność, trafność i normy. Dzięki temu wynik osoby można porównać z wynikami grupy odniesienia.
Jakie cechy musi mieć dobry test psychometryczny?
Pięć: standaryzację (te same warunki badania), obiektywność (ten sam wynik niezależnie od osoby, która go liczy), rzetelność (mały błąd pomiaru), trafność (wynik znaczy to, co ma znaczyć) i normalizację (normy dla właściwej grupy). Informacje o każdej z nich znajdziesz w podręczniku testu lub w artykule walidacyjnym.
Jak obliczyć przedział dla wyniku testu jednej osoby?
Policz błąd standardowy pomiaru: SEM = SD × √(1 − rzetelność). 95% przedział to wynik ± 1.96 × SEM. Na przykład przy SD = 8.46 i α = .89 SEM wynosi 2.78 punktu, więc dla wyniku 31 przedział obejmuje 25.6–36.4 punktu.
Czy mogę umieścić pozycje testu w aneksie pracy magisterskiej?
Zwykle nie. Według stanowiska International Test Commission pozycji chronionych testów nie drukuje się w publikacjach ani w pracach dyplomowych, a na przedruk nawet przykładowej pozycji potrzebna jest zgoda właściciela praw. W pracy podaj nazwę testu, autorów, wydanie i informację o zgodzie na użycie.
Kiedy różnica wyników dwóch osób w teście jest znacząca?
Gdy przekracza błąd różnicy pomnożony przez 1.96. Błąd różnicy to SEM × √2. W przykładzie z SEM = 2.78 punktu różnica między dwiema osobami musi wynosić co najmniej 7.70 punktu, żeby nie dało się jej wytłumaczyć samym błędem pomiaru.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Opis narzędzia badawczego – wzór
Dziesięć elementów opisu i cztery wzory: kwestionariusz z adaptacją, ankieta własna, test wiedzy i skala kliniczna – z rzetelnością z własnej próby.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikGdzie znaleźć kwestionariusze psychologiczne
Polskie adaptacje, wydawca testów, bazy i IPIP; jak ocenić skalę, kiedy potrzebna jest zgoda autora, wzór e-maila i zasady tłumaczenia narzędzi.
Czytaj →PoradnikWzór raportowania alfy Cronbacha
Gotowe zdania i tabela APA: podskale, niska alfa, pozycje odwrócone, skala adaptowana, porównanie z podręcznikiem – z plikiem .docx.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Harvill, L. M. (1991). Standard error of measurement. Educational Measurement: Issues and Practice, 10(2), 33–41. https://doi.org/10.1111/j.1745-3992.1991.tb00195.x
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{harvill1991standard, author={Harvill, Leo M.}, title={{Standard error of measurement}}, journal={Educational Measurement: Issues and Practice}, year={1991}, volume={10}, number={2}, pages={33--41}, doi={10.1111/j.1745-3992.1991.tb00195.x}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}