Co to jest pozycja odwrócona?
Pozycja odwrócona (ang. reverse-keyed item, reversed item) to pozycja kwestionariusza sformułowana tak, że zgoda z nią oznacza niższy poziom mierzonej cechy. W skali samooceny pozycja „Jestem zadowolony z siebie” jest prosta, a „Czasem czuję się zupełnie bezużyteczny” – odwrócona. Zanim zsumujesz lub uśrednisz odpowiedzi, odpowiedzi na pozycje odwrócone trzeba przekodować tak, by wszystkie pozycje miały ten sam kierunek. Weijters i in. (2013) definiują pozycje odwrócone właśnie przez tę konieczność rekodowania.
Wyróżnia się dwa rodzaje pozycji odwróconych:
- z przeczeniem – „Nie jestem zadowolony ze swojej pracy” (pozycja prosta z dodanym „nie”);
- z przeciwnym znaczeniem – „Moja praca mnie rozczarowuje” (opisuje biegun przeciwny bez przeczenia).
Pozycje z przeczeniem są szczególnie zdradliwe: podwójne przeczenie w połączeniu z odpowiedzią „nie zgadzam się” bywa źle rozumiane, zwłaszcza przy szybkim wypełnianiu ankiety.
Po co stosuje się pozycje odwrócone?
Pozycje odwrócone miały chronić przed potakiwaniem (ang. acquiescence), czyli skłonnością do zgadzania się z twierdzeniami niezależnie od treści. Krosnick (1991) opisuje potakiwanie jako jedną ze strategii „wystarczającej” odpowiedzi: gdy staranna odpowiedź wymaga wysiłku, część osób wybiera najłatwiejszą opcję. Jeśli w skali są pozycje w obu kierunkach, osoba, która zgadza się ze wszystkim, nie dostanie skrajnie wysokiego wyniku, a jej niespójne odpowiedzi łatwiej wychwycić.
Badania pokazują jednak, że korzyść jest mniejsza, niż się zakładało, a koszty – realne:
- van Sonderen i in. (2013) nie znaleźli w danych 700 osób dowodów, że dziesięć pozycji odwróconych w kwestionariuszu zmęczenia zapobiegło stylowi odpowiadania. Wyniki były za to zanieczyszczone nieuwagą i dezorientacją badanych.
- Suárez-Álvarez i in. (2018) porównali wersje testu samoskuteczności z pozycjami prostymi, odwróconymi i mieszanymi. Połączenie obu rodzajów obniżało rzetelność, wprowadzało dodatkowe źródła wariancji zagrażające jednowymiarowości i zmieniało średnie wyniki.
- Weijters i in. (2013) wskazują trzy źródła błędu związanego z pozycjami odwróconymi: potakiwanie, nieuważne odpowiadanie i skłonność do potwierdzania tego, co sugeruje treść pozycji.
Pozycje odwrócone to więc kompromis, nie automatyczna poprawa skali. Gdy budujesz nowe narzędzie, ogranicz je do takich, które da się zrozumieć bez wysiłku, unikaj przeczeń i przetestuj sformułowania w wywiadzie poznawczym albo badaniu pilotażowym. Gdy korzystasz z gotowego kwestionariusza, zachowaj pozycje w oryginalnej postaci – zmiana kierunku pozycji to zmiana narzędzia.
Jak przekodować pozycję odwróconą
Dla skali odpowiedzi od min do max nowa wartość to:
Na skali 1–5 jest to 6 − x, na skali 1–7 – 8 − x, a na skali 0–4 – 4 − x. Ogólne zasady przekształcania zmiennych (nowa kolumna zamiast nadpisywania, sprawdzenie tabelą krzyżową) opisuje hasło rekodowanie. Numery pozycji odwróconych bierz zawsze z klucza w podręczniku testu, a nie z intuicji – nie każda pozycja z przeczeniem jest odwrócona.
Kilka praktycznych zasad pozwala uniknąć pomyłek. Wpisz numery pozycji odwróconych do książki kodowej, zanim zaczniesz analizę, i nadaj przekodowanym zmiennym wyraźne nazwy, np. p3_r. Sprawdź, czy formularz internetowy zapisuje odpowiedzi jako liczby od 1 do 5, czy na przykład od 0 do 4 – od tego zależy wzór. Jeśli korzystasz z danych zebranych przez kogoś innego, upewnij się, że pozycje nie zostały już przekodowane wcześniej. Po rekodowaniu policz korelacje pozycja–całość: wszystkie powinny być dodatnie.
Przykład: co się dzieje, gdy zapomnisz o rekodowaniu
Trzysta osób (dane symulowane) wypełniło 10-pozycyjną skalę samooceny z odpowiedziami od 1 do 5. Pozycje 3, 5, 8 i 10 są odwrócone. Większość osób odpowiadała uważnie, ale około 8% potakiwało, a około 7% zaznaczało odpowiedzi losowo.
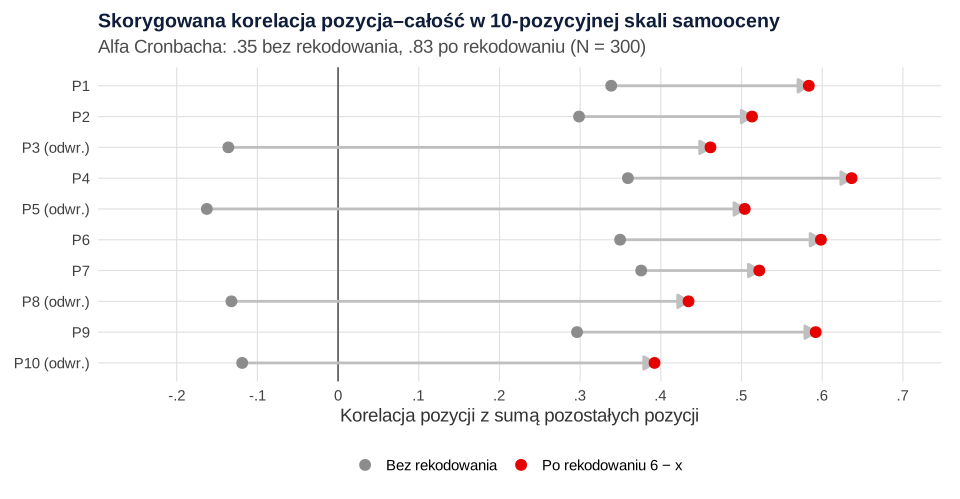
Krok 1. Skutek pominięcia rekodowania. Bez rekodowania alfa Cronbacha wyniosła .35, a po rekodowaniu – .83. Skorygowane korelacje pozycja–całość (korelacja pozycji z sumą pozostałych) dla czterech pozycji odwróconych były ujemne: od −.12 do −.16. Po rekodowaniu wyniosły od .39 do .50 (rysunek 1). Ujemna korelacja pozycji z resztą skali to najprostszy sygnał, że pozycja nie została przekodowana albo że klucz jest błędny. Tę samą informację podaje analiza pozycji testu.
Krok 2. Niespójne odpowiedzi. Jako niespójne oznaczono osoby, których średnia surowa była co najmniej 3.5 zarówno na pozycjach prostych, jak i na odwróconych – czyli zgadzały się z twierdzeniami o przeciwnej treści. Takich osób było 20, w tym 18 z 23 potakujących. Pozycje odwrócone pozwoliły więc wychwycić potakiwanie. Nie wykryły natomiast żadnej z 18 osób odpowiadających losowo – do tego potrzebne są inne wskaźniki (zob. nieuważne odpowiedzi i pytanie kontrolne).
Krok 3. Czynnik metody. Nawet po rekodowaniu jednoczynnikowy model CFA był dopasowany słabo: χ²(35) = 93.51, CFI = .920, RMSEA = .078. Dodanie drugiego, niezależnego czynnika dla czterech pozycji odwróconych poprawiło dopasowanie: χ²(31) = 36.97, CFI = .992, RMSEA = .026, a test różnicy dał Δχ²(4) = 56.59, p < .001. Pozycje odwrócone miały na tym czynniku standaryzowane ładunki od .35 do .50. Takie wyniki często się spotyka: pozycje odwrócone tworzą osobny „czynnik”, który odzwierciedla sposób odpowiadania, a nie odrębny aspekt cechy. Nie interpretuj go pochopnie jako drugiego wymiaru konstruktu.
Jak opisać pozycje odwrócone w pracy
W opisie narzędzia podaj, ile pozycji jest odwróconych i które, że przekodowano je przed obliczeniem wyniku, oraz – jeśli to sprawdzałeś – czy wszystkie korelacje pozycja–całość były dodatnie. Gdy ze względu na niespójne odpowiedzi wykluczasz osoby z analizy, opisz kryterium i liczbę wykluczonych.
Pełny opis rzetelności skali krok po kroku pokazuje wzór raportowania alfy Cronbacha.
Pozycje odwrócone w R
Kod tworzy odpowiedzi z przykładu, przekodowuje pozycje odwrócone, porównuje alfę i korelacje pozycja–całość przed rekodowaniem i po nim, wskazuje osoby z niespójnymi odpowiedziami oraz porównuje modele CFA bez czynnika metody i z nim. Liczby w tekście i na rysunku pochodzą z tego kodu.
Rekodowanie, korelacje pozycja–całość i czynnik metody
R
# Pozycje odwrócone: rekodowanie, korelacje pozycja–całość, alfa i czynnik metody (dane symulowane)
suppressPackageStartupMessages({
  library(psych)    # alpha()
  library(lavaan)   # cfa()
})
set.seed(151)
N <- 300
odwr <- c(3, 5, 8, 10)                        # numery pozycji sformułowanych przeciwnie
typ <- sample(c("uwazny", "potakujacy", "nieuwazny"), N, replace = TRUE, prob = c(0.85, 0.08, 0.07))
samoocena <- rnorm(N)
lad <- c(0.75, 0.70, 0.65, 0.70, 0.60, 0.70, 0.65, 0.60, 0.70, 0.55)
znak <- ifelse(1:10 %in% odwr, -1, 1)
ukryta <- sapply(1:10, function(j) znak[j] * lad[j] * samoocena + rnorm(N, 0, sqrt(1 - lad[j]^2)))
ukryta[typ == "potakujacy", ] <- ukryta[typ == "potakujacy", ] + 1.1   # potakiwanie: wyżej na wszystkich pozycjach
odp <- matrix(cut(ukryta, c(-Inf, -1.3, -0.45, 0.35, 1.2, Inf), labels = FALSE), N)
odp[typ == "nieuwazny", ] <- sample(1:5, sum(typ == "nieuwazny") * 10, replace = TRUE)   # odpowiedzi losowe
colnames(odp) <- paste0("p", 1:10)
dane <- as.data.frame(odp)

# 1. Rekodowanie pozycji odwróconych na skali 1–5: nowa wartość = (min + max) − stara = 6 − x
rek <- dane
rek[, odwr] <- 6 - dane[, odwr]
table(przed = dane$p3, po = rek$p3)

# 2. Alfa i skorygowane korelacje pozycja–całość: bez rekodowania i po nim
a_zle  <- alpha(dane, check.keys = FALSE, warnings = FALSE)
a_dobr <- alpha(rek,  check.keys = FALSE, warnings = FALSE)
round(c(alfa_bez_rekodowania = a_zle$total$raw_alpha, alfa_po_rekodowaniu = a_dobr$total$raw_alpha), 3)
round(cbind(r_drop_bez = a_zle$item.stats$r.drop, r_drop_po = a_dobr$item.stats$r.drop), 2)

# 3. Osoby zgadzające się jednocześnie z pozycjami prostymi i odwróconymi (średnie surowe ≥ 3.5)
sprzeczne <- rowMeans(dane[, -odwr]) >= 3.5 & rowMeans(dane[, odwr]) >= 3.5
table(sprzeczne, typ)

# 4. CFA: jeden czynnik vs jeden czynnik + czynnik metody dla pozycji odwróconych
m1 <- 'samoocena =~ p1 + p2 + p3 + p4 + p5 + p6 + p7 + p8 + p9 + p10'
m2 <- paste(m1, '\n metoda =~ p3 + p5 + p8 + p10 \n samoocena ~~ 0*metoda')
f1 <- cfa(m1, data = rek, estimator = "MLR"); f2 <- cfa(m2, data = rek, estimator = "MLR")
round(rbind(jeden_czynnik = fitMeasures(f1, c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr")),
            z_czynnikiem_metody = fitMeasures(f2, c("chisq.scaled", "df", "cfi.robust", "rmsea.robust", "srmr"))), 3)
lrt <- lavTestLRT(f1, f2)
c(roznica_chi2 = round(lrt[2, "Chisq diff"], 2), df = lrt[2, "Df diff"])
lrt[2, "Pr(>Chisq)"]
# Standaryzowane ładunki czynnika metody
st <- standardizedSolution(f2)
st[st$lhs == "metoda" & st$op == "=~", c("rhs", "est.std")]
Wynik w R
     po
przed  1  2  3  4  5
    1  0  0  0  0 34
    2  0  0  0 54  0
    3  0  0 89  0  0
    4  0 96  0  0  0
    5 27  0  0  0  0
alfa_bez_rekodowania  alfa_po_rekodowaniu
               0.350                0.833
      r_drop_bez r_drop_po
 [1,]       0.34      0.58
 [2,]       0.30      0.51
 [3,]      -0.14      0.46
 [4,]       0.36      0.64
 [5,]      -0.16      0.50
 [6,]       0.35      0.60
 [7,]       0.38      0.52
 [8,]      -0.13      0.43
 [9,]       0.30      0.59
[10,]      -0.12      0.39
         typ
sprzeczne nieuwazny potakujacy uwazny
    FALSE        18          5    257
    TRUE          0         18      2
                    chisq.scaled df cfi.robust rmsea.robust  srmr
jeden_czynnik             93.505 35      0.920        0.078 0.060
z_czynnikiem_metody       36.968 31      0.992        0.026 0.032
roznica_chi2           df
       56.59         4.00
[1] 1.510649e-11
   rhs est.std
11  p3   0.454
12  p5   0.504
13  p8   0.412
14 p10   0.353
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Brak rekodowania przed sumowaniem – wynik skali staje się mieszanką cechy i jej przeciwieństwa, a alfa gwałtownie spada.
- Podwójne rekodowanie – pozycja przekodowana w arkuszu, a potem jeszcze raz w programie, wraca do pierwotnego kierunku. Rekoduj do nowej kolumny i sprawdzaj tabelą krzyżową.
- Zły wzór dla skali od zera – na skali 0–4 nowa wartość to 4 − x, a nie 5 − x.
- Usuwanie pozycji odwróconych tylko dlatego, że obniżają alfę – najpierw sprawdź, czy zostały przekodowane; zmiana składu skali to zmiana narzędzia i wymaga uzasadnienia.
- Klucz z innej wersji testu – wersja oryginalna, skrócona i polska adaptacja mogą mieć inne numery pozycji odwróconych. Korzystaj z klucza do tej wersji, której używałeś.
- Interpretowanie czynnika pozycji odwróconych jako odrębnej cechy bez dowodów trafności – często jest to czynnik metody.
- Oczekiwanie, że pozycje odwrócone wykryją każdą nieuważną osobę – w przykładzie nie wykryły żadnej z osób odpowiadających losowo.
Najczęstsze pytania
Co to jest pozycja odwrócona w kwestionariuszu?
To twierdzenie sformułowane przeciwnie do mierzonej cechy, np. w skali samooceny „Czasem czuję się zupełnie bezużyteczny”. Wysoka zgoda z taką pozycją oznacza niski poziom cechy, dlatego przed obliczeniem wyniku jej punkty się odwraca.
Jak przekodować pozycje odwrócone na skali 1–7?
Odejmij odpowiedź od sumy najniższej i najwyższej wartości skali: 8 − x, czyli 1 → 7, 2 → 6, 3 → 5, 4 → 4. Na skali 1–5 to 6 − x, a na skali 0–4 – 4 − x. Zapisz wynik w nowej kolumnie i sprawdź go tabelą krzyżową.
Skąd wiadomo, że zapomniałem przekodować pozycję?
Najprostszy sygnał to ujemna skorygowana korelacja pozycja–całość i wyraźnie niższa alfa Cronbacha niż w podręczniku testu. W przykładzie z tego hasła alfa bez rekodowania wyniosła .35, a po rekodowaniu .83.
Czy warto używać pozycji odwróconych w nowej skali?
Tylko z rozwagą. Pomagają wychwycić osoby, które zgadzają się ze wszystkim, ale badania pokazują, że mieszanie pozycji prostych i odwróconych bywa źródłem nieporozumień, obniża rzetelność i tworzy dodatkowy czynnik metody. Unikaj przeczeń i sprawdź zrozumiałość pozycji w badaniu pilotażowym.
Dlaczego pozycje odwrócone tworzą osobny czynnik?
Bo oprócz cechy łączy je sposób sformułowania: potakiwanie, nieuwaga i trudność ze zrozumieniem przeczeń działają na nie podobnie. W analizie czynnikowej widać to jako dodatkowy czynnik metody, który zwykle nie oznacza odrębnego aspektu mierzonej cechy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Czynnik metody i pozycje odwrócone w CFA
Potakiwanie, nieuwaga czy sformułowanie? Pięć modeli CFA w lavaan, symulacja wyboru modelu i wpływ czynnika metody na omegę skali.
Czytaj →PoradnikJak policzyć wynik kwestionariusza
Klucz, pozycje odwrócone, podskale, reguła braków, suma czy średnia i kontrola wartości – w Excelu, SPSS, R i jamovi, z plikiem .xlsx z formułami.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikWzór raportowania alfy Cronbacha
Gotowe zdania i tabela APA: podskale, niska alfa, pozycje odwrócone, skala adaptowana, porównanie z podręcznikiem – z plikiem .docx.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Krosnick, J. A. (1991). Response strategies for coping with the cognitive demands of attitude measures in surveys. Applied Cognitive Psychology, 5(3), 213–236. https://doi.org/10.1002/acp.2350050305
- Suárez-Álvarez, J., Pedrosa, I., Lozano, L. M., García-Cueto, E., Cuesta, M., & Muñiz, J. (2018). Using reversed items in Likert scales: A questionable practice. Psicothema, 2(30), 149–158. https://doi.org/10.7334/psicothema2018.33 ● Otwarty dostęp
- van Sonderen, E., Sanderman, R., & Coyne, J. C. (2013). Ineffectiveness of reverse wording of questionnaire items: Let’s learn from cows in the rain. PLoS ONE, 8(7), Article e68967. https://doi.org/10.1371/journal.pone.0068967 ● Otwarty dostęp
- Weijters, B., Baumgartner, H., & Schillewaert, N. (2013). Reversed item bias: An integrative model. Psychological Methods, 18(3), 320–334. https://doi.org/10.1037/a0032121 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{krosnick1991response, author={Krosnick, Jon A.}, title={{Response strategies for coping with the cognitive demands of attitude measures in surveys}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={3}, pages={213--236}, doi={10.1002/acp.2350050305}}@article{suarezalvarez2018using, author={Suárez-Álvarez, Javier and Pedrosa, Ignacio and Lozano, Luis M. and García-Cueto, Eduardo and Cuesta, Marcelino and Muñiz, José}, title={{Using reversed items in Likert scales: A questionable practice}}, journal={Psicothema}, year={2018}, volume={2}, number={30}, pages={149--158}, doi={10.7334/psicothema2018.33}}@article{vansonderen2013ineffectiveness, author={van Sonderen, Eric and Sanderman, Robbert and Coyne, James C.}, title={{Ineffectiveness of reverse wording of questionnaire items: Let’s learn from cows in the rain}}, journal={PLoS ONE}, year={2013}, volume={8}, number={7}, eid={e68967}, doi={10.1371/journal.pone.0068967}}@article{weijters2013reversed, author={Weijters, Bert and Baumgartner, Hans and Schillewaert, Niels}, title={{Reversed item bias: An integrative model}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={320--334}, doi={10.1037/a0032121}}