Co to jest normalizacja testu?
Normalizacja (ang. norming, test norming) to etap budowy testu psychologicznego, w którym bada się dużą, starannie dobraną próbę z populacji odniesienia i na tej podstawie opracowuje normy – reguły przypisujące każdemu wynikowi surowemu jego pozycję wśród innych ludzi (rangę centylową, sten, wynik T albo IQ). Dzięki normalizacji zdanie „osoba uzyskała 48 punktów” można zamienić na „wynik wyższy niż u 91% dorosłych”.
W polskiej psychometrii słowo to bywa używane w dwóch znaczeniach. Warto je rozróżniać:
| Pojęcie | Co oznacza | Więcej |
|---|---|---|
| Normalizacja testu | Cały proces opracowania norm na próbie normalizacyjnej | to hasło |
| Wynik znormalizowany | Nieliniowe przeliczenie wyniku przez rangę centylową i rozkład normalny – jeden z formatów norm | wynik znormalizowany |
| Standaryzacja testu | Ujednolicenie instrukcji, warunków i punktowania – warunek sensownych norm | standaryzacja (psychometria) |
| Standaryzacja zmiennej | Liniowe przeliczenie na wynik z w dowolnych danych | standaryzacja zmiennej |
Normy są tak dobre jak próba, na której powstały. Dlatego w tym haśle skupiamy się na dwóch pytaniach, które decydują o jakości normalizacji: ile osób zbadać i jak je dobrać. Gotowe skale wyników i przykład tabeli norm stenowych znajdziesz w haśle o normach testowych.
Etapy normalizacji
- Zdefiniuj populację odniesienia – z kim użytkownik testu będzie porównywał badane osoby: dorośli w Polsce, uczniowie klas 4–6, pacjenci po udarze. Standardy testowe wymagają, by normy dotyczyły jasno opisanej populacji (American Educational Research Association i in., 2014).
- Zaplanuj dobór próby – zwykle warstwowy lub kwotowy według zmiennych, od których zależy wynik (wiek, wykształcenie, płeć, miejsce zamieszkania); zob. próba kwotowa i reprezentatywność próby.
- Ustal liczebność – osobno dla każdej grupy, dla której powstanie tabela norm.
- Zbierz dane w warunkach standardowych – tymi samymi instrukcjami, w tym samym czasie, z tym samym kluczem, z jakimi test będzie potem stosowany.
- Sprawdź, czy potrzebne są osobne normy – np. dla grup wieku albo płci – i wybierz format wyników: centyle, steny, staniny, wyniki T.
- Opisz normy – populację, sposób doboru i odsetek uczestnictwa, daty badania, ewentualne ważenie, statystyki opisowe i precyzję norm (American Educational Research Association i in., 2014).
Ile osób potrzeba? Przykład z precyzją normy
Norma jest oszacowaniem: ranga centylowa wyniku w próbie normalizacyjnej różni się od rangi w populacji tym bardziej, im mniejsza jest próba. Crawford i in. (2009) zwracają uwagę, że niepewność pozycji wyniku w normach centylowych rzadko się raportuje, i proponują przedziały dla rang centylowych. Oosterhuis i in. (2016) badali w symulacji 95% zakresy oszacowań centyli przy różnych liczebnościach i podają wymagane wielkości prób dla norm tradycyjnych i regresyjnych.
W naszym przykładzie (dane symulowane) populację stanowi 200 000 dorosłych rozwiązujących test uwagi z 60 zadaniami. Średnia w populacji wynosi 33.93 punktu (SD = 10.25), a wynik zależy od wykształcenia: 29.62 przy wykształceniu podstawowym lub zawodowym, 34.44 przy średnim i 40.15 przy wyższym. Interesuje nas wynik 48 punktów. W populacji ma on rangę centylową 91.4, co odpowiada stenowi 8. Z populacji wylosowaliśmy po 2000 prób o liczebności od 100 do 2000 osób i w każdej policzyliśmy rangę centylową wyniku 48.
| Liczebność próby | Środkowe 95% oszacowań rangi | SD oszacowań | Próby, w których wynik dostał inny sten niż 8 |
|---|---|---|---|
| 100 | 86.0–96.5 | 2.72 | 26.0% |
| 250 | 88.0–94.6 | 1.69 | 14.0% |
| 500 | 89.0–93.9 | 1.22 | 6.2% |
| 1000 | 89.8–93.0 | 0.84 | 0.9% |
| 2000 | 90.3–92.6 | 0.59 | 0.0% |
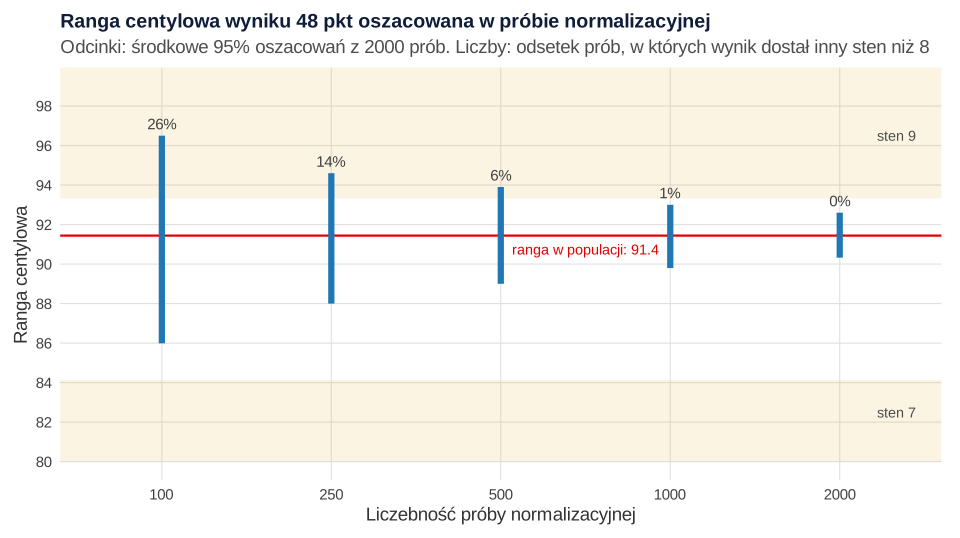
Przy 100 osobach co czwarta próba przypisałaby wynikowi 48 punktów inny sten niż populacja – najczęściej 9. Przy 1000 osobach takie pomyłki zdarzały się w 0.9% prób. Pamiętaj, że liczby z tabeli dotyczą jednej tabeli norm. Jeśli normy mają być osobne dla sześciu grup wieku i dwóch płci, każda z dwunastu komórek potrzebuje własnej, dużej próby. To główny argument za normalizacją ciągłą (regresyjną), w której model opisuje zmianę rozkładu wyników z wiekiem. Lenhard i Lenhard (2021) pokazali w symulacjach, że taka metoda daje dokładniejsze normy przy znacznie mniejszych próbach niż tablice tworzone dla przedziałów wieku, a Oosterhuis i in. (2016) – że przy spełnionych założeniach regresji liniowej wystarczają próby od 2.5 do 5.5 raza mniejsze.
Jak dobrać próbę? Przykład z próbą wygodną
Duża liczebność nie naprawi złego doboru. Załóżmy, że zamiast próby warstwowej zbadano 500 osób w sposób wygodny – głównie studentów i ich znajomych – i 60% z nich miało wykształcenie wyższe, choć w populacji takich osób jest 25%. Średni wynik w tej próbie wyniósł 36.74 punktu zamiast 33.93.
| Wynik surowy | Populacja | Próba wygodna | Próba wygodna z wagami |
|---|---|---|---|
| 25 | 20.7 (sten 4) | 13.3 (sten 3) | 23.4 (sten 4) |
| 34 | 48.9 (sten 5) | 36.9 (sten 5) | 49.6 (sten 5) |
| 42 | 76.2 (sten 7) | 66.0 (sten 6) | 77.0 (sten 7) |
| 48 | 91.4 (sten 8) | 87.5 (sten 8) | 92.4 (sten 8) |
Normy z próby wygodnej są „surowsze” niż populacyjne: osoba z przeciętnym wynikiem 34 punktów dostałaby rangę 36.9 zamiast 48.9, a osoby z wynikami 25 i 42 punktów – sten o jeden niższy. Taki błąd jest systematyczny i nie zmaleje po zbadaniu kolejnych osób tego samego rodzaju (rysunek 2).
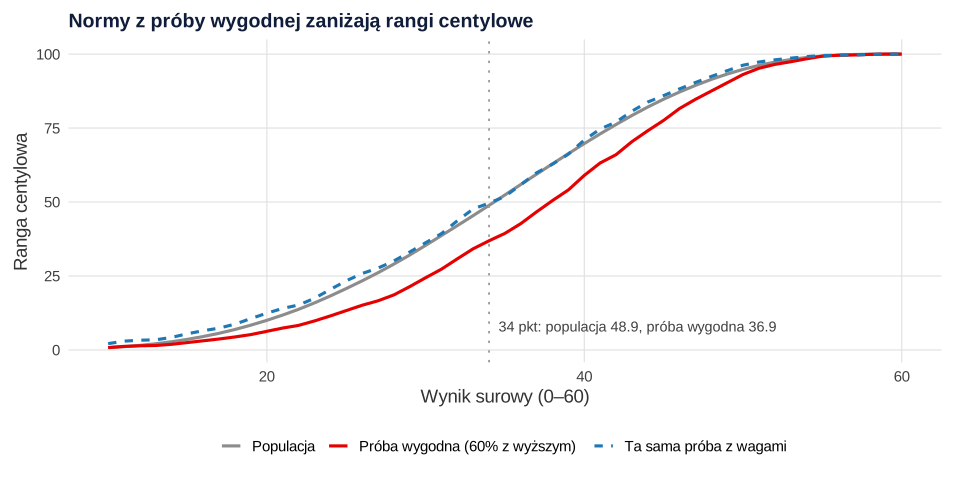
Ważenie poststratyfikacyjne – nadanie każdej osobie wagi równej udziałowi jej grupy w populacji podzielonemu przez udział w próbie – przybliżyło normy do populacyjnych (średnia ważona 33.31). Zadziałało jednak tylko dlatego, że w symulacji znamy jedyną zmienną odpowiedzialną za zniekształcenie. W prawdziwej próbie wygodnej osoby z wyższym wykształceniem, które się zgłosiły, mogą różnić się od tych, które się nie zgłosiły. Ważenie nie zastępuje planu doboru próby; jeśli je stosujesz, opisz je w raporcie z normalizacji.
Aktualność norm
Normalizacja nie jest jednorazowa. Wyniki populacji zmieniają się z czasem, a wraz z nimi znaczenie wyniku surowego. Najlepiej opisanym przykładem jest wzrost wyników testów inteligencji z dekady na dekadę, omawiany w haśle skala IQ. Standardy zalecają okresowy przegląd norm i podawanie roku badania normalizacyjnego (American Educational Research Association i in., 2014).
Jak opisać normy w pracy
Gdy korzystasz z gotowego testu, w opisie narzędzia podaj, na jakiej próbie i w którym roku opracowano normy i jakiego formatu wyników użyłeś. Gdy sam tworzysz normy (np. w pracy nad adaptacją narzędzia), opisz próbę normalizacyjną tak dokładnie, jak wymagają tego standardy. Wzór:
Jak przygotować i opisać całą adaptację narzędzia, pokazuje poradnik jak zbudować i zwalidować skalę psychometryczną.
Symulacja normalizacji w R
Kod tworzy populację z przykładu, szacuje rangę centylową wyniku 48 punktów w 2000 losowych próbach o różnej liczebności, a następnie porównuje normy z próby wygodnej – bez wag i z wagami poststratyfikacyjnymi – z normami populacyjnymi. Liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu.
Precyzja i dobór próby normalizacyjnej
R
# Normalizacja testu: jak liczebność i dobór próby normalizacyjnej wpływają na normy (dane symulowane)
set.seed(149)
# Populacja dorosłych: test uwagi (60 zadań, wynik 0–60), wynik zależy od wykształcenia
Npop <- 200000
wyk <- sample(c("podstawowe/zawodowe", "srednie", "wyzsze"), Npop, replace = TRUE, prob = c(0.40, 0.35, 0.25))
p_i <- plogis(qlogis(0.58) + c("podstawowe/zawodowe" = -0.35, "srednie" = 0, "wyzsze" = 0.45)[wyk] + rnorm(Npop, 0, 0.65))
pop <- data.frame(wyk, wynik = rbinom(Npop, 60, p_i))
round(c(M = mean(pop$wynik), SD = sd(pop$wynik)), 2)
round(tapply(pop$wynik, pop$wyk, mean), 2)

# Ranga centylowa metodą punktu środkowego i sten dla wyniku X (opcjonalnie z wagami)
pr <- function(x, X, w = rep(1, length(x))) 100 * (sum(w[x < X]) + 0.5 * sum(w[x == X])) / sum(w)
sten <- function(PR) pmin(pmax(round(5.5 + 2 * qnorm(PR / 100)), 1), 10)
X0 <- 48                                          # wynik, którego normy szukamy
c(PR_populacja = round(pr(pop$wynik, X0), 1), sten_populacja = sten(pr(pop$wynik, X0)))

# 1. Precyzja normy: 2000 prób losowych o różnej liczebności
n_proby <- c(100, 250, 500, 1000, 2000)
sym <- t(sapply(n_proby, function(n) {
  est <- replicate(2000, pr(sample(pop$wynik, n), X0))
  c(n = n, PR_2.5 = unname(quantile(est, 0.025)), PR_97.5 = unname(quantile(est, 0.975)),
    SD_PR = sd(est), inny_sten = mean(sten(est) != sten(pr(pop$wynik, X0))))
}))
round(sym, 3)

# 2. Próba wygodna: 500 osób, w tym 60% z wyższym wykształceniem
udzialy <- c("podstawowe/zawodowe" = 0.15, "srednie" = 0.25, "wyzsze" = 0.60)
wygodna <- do.call(rbind, lapply(names(udzialy), function(g)
  pop[sample(which(pop$wyk == g), 500 * udzialy[[g]]), ]))
# Wagi poststratyfikacyjne: udział w populacji / udział w próbie
w_pop <- c("podstawowe/zawodowe" = 0.40, "srednie" = 0.35, "wyzsze" = 0.25)
wygodna$waga <- (w_pop / udzialy)[wygodna$wyk]
round(c(M_wygodna = mean(wygodna$wynik), M_wazona = weighted.mean(wygodna$wynik, wygodna$waga)), 2)
Xs <- c(25, 34, 42, 48)
tab <- t(sapply(Xs, function(X) c(X = X, PR_populacja = pr(pop$wynik, X), PR_wygodna = pr(wygodna$wynik, X),
                                  PR_wazona = pr(wygodna$wynik, X, wygodna$waga))))
round(tab, 1)
# Znormalizowany wynik T i sten przypisany według każdej z trzech norm
round(50 + 10 * qnorm(tab[, -1] / 100), 1)
apply(tab[, -1], 2, sten)
Wynik w R
    M    SD
33.93 10.25
podstawowe/zawodowe             srednie              wyzsze
              29.62               34.44               40.15
  PR_populacja sten_populacja
          91.4            8.0
        n PR_2.5 PR_97.5 SD_PR inny_sten
[1,]  100 85.988  96.500 2.720     0.260
[2,]  250 88.000  94.600 1.689     0.140
[3,]  500 89.000  93.900 1.217     0.062
[4,] 1000 89.799  93.000 0.835     0.009
[5,] 2000 90.325  92.601 0.593     0.000
M_wygodna  M_wazona
    36.74     33.31
      X PR_populacja PR_wygodna PR_wazona
[1,] 25         20.7       13.3      23.4
[2,] 34         48.9       36.9      49.6
[3,] 42         76.2       66.0      77.0
[4,] 48         91.4       87.5      92.4
     PR_populacja PR_wygodna PR_wazona
[1,]         41.8       38.9      42.7
[2,]         49.7       46.7      49.9
[3,]         57.1       54.1      57.4
[4,]         63.7       61.5      64.3
     PR_populacja PR_wygodna PR_wazona
[1,]            4          3         4
[2,]            5          5         5
[3,]            7          6         7
[4,]            8          8         8
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Normy z próby wygodnej – kilkuset studentów to nie jest próba normalizacyjna dla dorosłych, nawet jeśli wyniki wyglądają „ładnie”.
- Jedna tabela norm dla grup o różnych wynikach – gdy wynik zależy od wieku lub wykształcenia, wspólna tabela myli wszystkie grupy naraz.
- Normy bez informacji o precyzji – przy małych komórkach różnica jednego stenu może wynikać z losowości próby.
- Normy sprzed dwóch dekad stosowane bez komentarza – sprawdź rok badania normalizacyjnego.
- Mylenie normalizacji z wynikiem znormalizowanym – przekształcenie rangowe to tylko jeden krok procesu normalizacji.
- Normalizacja testu, który nie jest wystandaryzowany – jeśli każdy badacz podaje inną instrukcję, normy nie mają stałego punktu odniesienia.
Najczęstsze pytania
Co to jest normalizacja testu psychologicznego?
To opracowanie norm, czyli zbadanie dużej próby z populacji odniesienia i ustalenie, jaką rangę centylową, sten lub wynik T ma każdy wynik surowy. Dzięki normalizacji wynik osoby można porównać z wynikami ludzi podobnych do niej, np. w tym samym wieku.
Czym różni się normalizacja od standaryzacji testu?
Standaryzacja ujednolica sposób badania – instrukcję, warunki, czas i punktowanie. Normalizacja dostarcza punktu odniesienia dla wyników uzyskanych w tych warunkach. Bez standaryzacji normalizacja traci sens, bo normy dotyczą tylko wyników zebranych tą samą procedurą.
Ile osób powinna liczyć próba normalizacyjna?
Tyle, by normy były precyzyjne w każdej grupie, dla której powstaje osobna tabela. W symulacji z tego hasła przy 100 osobach ranga wyniku z okolic 90. centyla wahała się od 86 do 97, a przy 1000 osobach – od 90 do 93. Normalizacja regresyjna pozwala zmniejszyć wymaganą liczebność, jeśli spełnione są jej założenia.
Czy normy można opracować na próbie studentów?
Tylko wtedy, gdy populacją odniesienia są studenci i próba dobrze ich reprezentuje. Normy dla dorosłych z próby studentów będą zniekształcone, bo studenci różnią się od populacji wiekiem i wykształceniem. Ważenie zmniejsza zniekształcenie tylko dla zmiennych, które da się zmierzyć i uwzględnić.
Co oznacza „normy nieaktualne”?
To normy opracowane na próbie zbadanej tak dawno, że rozkład wyników w populacji zdążył się zmienić. Wynik osoby porównuje się wtedy z ludźmi z innego pokolenia. Przed użyciem testu sprawdź w podręczniku rok badania normalizacyjnego i napisz go w opisie narzędzia.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikGdzie znaleźć kwestionariusze psychologiczne
Polskie adaptacje, wydawca testów, bazy i IPIP; jak ocenić skalę, kiedy potrzebna jest zgoda autora, wzór e-maila i zasady tłumaczenia narzędzi.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Crawford, J. R., Garthwaite, P. H., & Slick, D. J. (2009). On percentile norms in neuropsychology: Proposed reporting standards and methods for quantifying the uncertainty over the percentile ranks of test scores. The Clinical Neuropsychologist, 23(7), 1173–1195. https://doi.org/10.1080/13854040902795018
- Lenhard, W., & Lenhard, A. (2021). Improvement of norm score quality via regression-based continuous norming. Educational and Psychological Measurement, 81(2), 229–261. https://doi.org/10.1177/0013164420928457 ● Otwarty dostęp
- Oosterhuis, H. E. M., van der Ark, L. A., & Sijtsma, K. (2016). Sample size requirements for traditional and regression-based norms. Assessment, 23(2), 191–202. https://doi.org/10.1177/1073191115580638 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{crawford2009percentile, author={Crawford, John R. and Garthwaite, Paul H. and Slick, Daniel J.}, title={{On percentile norms in neuropsychology: Proposed reporting standards and methods for quantifying the uncertainty over the percentile ranks of test scores}}, journal={The Clinical Neuropsychologist}, year={2009}, volume={23}, number={7}, pages={1173--1195}, doi={10.1080/13854040902795018}}@article{lenhard2021improvement, author={Lenhard, Wolfgang and Lenhard, Alexandra}, title={{Improvement of norm score quality via regression-based continuous norming}}, journal={Educational and Psychological Measurement}, year={2021}, volume={81}, number={2}, pages={229--261}, doi={10.1177/0013164420928457}}@article{oosterhuis2016sample, author={Oosterhuis, Hannah E. M. and van der Ark, L. Andries and Sijtsma, Klaas}, title={{Sample size requirements for traditional and regression-based norms}}, journal={Assessment}, year={2016}, volume={23}, number={2}, pages={191--202}, doi={10.1177/1073191115580638}}