Co to jest właściwa adaptacja testu?
Adaptacja testu (ang. test adaptation, cross-cultural adaptation) to przygotowanie wersji narzędzia dla innego języka lub kultury tak, aby mierzyła ten sam konstrukt co oryginał i dawała wyniki porównywalne z oryginalnymi. Właściwa adaptacja to taka, w której tę równoważność udokumentowano: opisano proces przekładu i zebrano dowody empiryczne, że wersje są równoważne pod względem pomiarowym.
Adaptacja to coś więcej niż tłumaczenie. Dobry przekład słowo w słowo może zmienić trudność pozycji, jej konotacje albo sens w innej kulturze. Pozycja „czuję się jak piąte koło u wozu” nie ma dosłownego odpowiednika w wielu językach, a pytanie o „chodzenie do kościoła” mierzy w różnych krajach różne rzeczy. Dlatego wersja przetłumaczona, ale niezbadana, nie jest jeszcze testem psychometrycznym w nowym języku. Jest roboczym narzędziem, którego rzetelność, trafność i normy trzeba dopiero ustalić.
Etapy adaptacji
Punktem odniesienia są wytyczne International Test Commission (2018). Ich drugie wydanie zawiera 18 zaleceń w sześciu grupach: warunki wstępne, opracowanie adaptacji, potwierdzenie empiryczne, badanie, skale wyników z interpretacją oraz dokumentacja. W naukach o zdrowiu często cytuje się też wytyczne Beaton i in. (2000). Typowy przebieg wygląda tak:
| Etap | Co robisz | Po co |
|---|---|---|
| 1. Zgoda | Uzyskujesz zgodę właściciela praw do testu na przekład i adaptację | Wymóg prawny i etyczny (International Test Commission, 2014) |
| 2. Przekład w przód | Co najmniej dwie niezależne osoby znające oba języki, kulturę i treść testu tłumaczą pozycje | Różne wersje ujawniają niejednoznaczności |
| 3. Synteza i komisja | Zespół porównuje przekłady, ustala wersję wspólną, ocenia równoważność treści | Decyzje są udokumentowane, a nie przypadkowe |
| 4. Tłumaczenie zwrotne | Inna osoba tłumaczy wersję polską z powrotem na język oryginału | Kontrola zgodności – pomocnicza, bo ma słabe strony |
| 5. Pretest jakościowy | Wywiady poznawcze z osobami z populacji docelowej | Sprawdzenie, czy pozycje są rozumiane tak, jak w oryginale |
| 6. Pilotaż i badanie główne | Analiza pozycji, rzetelność, struktura czynnikowa, dowody trafności | Empiryczne potwierdzenie jakości wersji |
| 7. Równoważność pomiarowa | Inwariancja pomiaru względem danych z oryginału | Warunek porównywania wyników między krajami |
| 8. Normy i dokumentacja | Nowe normy, opis wszystkich zmian i decyzji | Normy oryginału nie przenoszą się na inną populację |
Według wytycznych przekład powinno przygotować więcej niż jeden ekspert, a zarówno przekład w przód, jak i tłumaczenie zwrotne mają swoje słabe strony. Samo tłumaczenie zwrotne może przepuścić przekład, który jest dosłowny, ale dziwny dla rodzimego użytkownika języka. Wytyczne wymagają też pilotażu z analizą pozycji, rzetelnością i wstępnymi badaniami trafności oraz udokumentowania wszystkich zmian (International Test Commission, 2018).
Trzy poziomy równoważności
- Językowa – pozycja jest poprawna, naturalna i zrozumiała w nowym języku.
- Pojęciowa – pozycja odnosi się do tego samego zachowania lub doświadczenia i ma podobne znaczenie w obu kulturach.
- Pomiarowa – te same ładunki i wyrazy wolne w modelu czynnikowym, czyli ten sam związek odpowiedzi z cechą. Bez niej różnica średnich między krajami może wynikać z przekładu, a nie z różnicy w cesze.
Putnick i Bornstein (2016) przypominają, że brak inwariancji oznacza, iż konstrukt ma w grupach inną strukturę lub znaczenie. Dlatego inwariancję trzeba sprawdzić przed porównywaniem średnich. Procedurę – serię coraz bardziej ograniczonych modeli – w formie listy kontrolnej opisali van de Schoot i in. (2012).
Przykład: pozycja, która zmieniła znaczenie w przekładzie
Sześciopozycyjną skalę samotności (odpowiedzi 1–7) wypełniło 300 osób w wersji oryginalnej i 300 osób w wersji polskiej (dane symulowane). W symulacji pozycja 4 w przekładzie stała się łatwiejsza do potwierdzenia: przy tym samym poziomie samotności osoby wybierają odpowiedź wyższą o 0.9 punktu. Prawdziwa samotność w polskiej próbie jest niższa o 0.30 odchylenia standardowego.
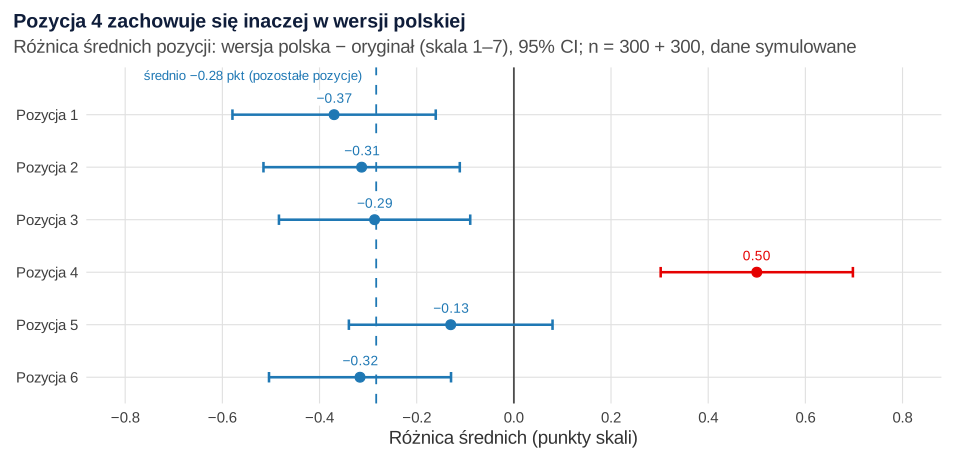
Wielogrupowa CFA pokazuje, gdzie leży problem:
| Model | CFI | RMSEA | SRMR | ΔCFI |
|---|---|---|---|---|
| Konfiguralny (ta sama struktura) | .988 | .048 | .024 | – |
| Metryczny (równe ładunki) | .987 | .044 | .036 | −.001 |
| Skalarny (równe ładunki i wyrazy wolne) | .914 | .103 | .069 | −.073 |
| Częściowo skalarny (wyraz wolny pozycji 4 swobodny) | .985 | .044 | .039 | −.002 |
Ładunki są równoważne, ale model skalarny wyraźnie pogarsza dopasowanie. Test punktowy wskazuje, że największy problem tworzy wyraz wolny pozycji 4: χ²(1) = 69.43, p < .001. Pozostałe ograniczenia dają wartości od 1.00 do 5.53 (dwie z nich mają p < .05, ale są o rząd wielkości mniejsze). Uwalniaj parametry pojedynczo, zaczynając od największego. Po uwolnieniu tego jednego parametru dopasowanie wraca do poziomu modelu metrycznego.
Konsekwencje dla wniosków są wyraźne. W modelu częściowo skalarnym polska próba ma niższą średnią samotności o 0.37 SD, 95% CI [−0.57, −0.17], p < .001. Model, który wymusza równość wszystkich wyrazów wolnych, zaniża tę różnicę do −0.25 SD, 95% CI [−0.44, −0.06]. Proste porównanie sum punktów daje tylko d = −0.17 (p = .040). Jedna źle przełożona pozycja maskuje część rzeczywistej różnicy między krajami. W praktyce warto wtedy wrócić do przekładu pozycji 4 i sprawdzić ją w wywiadach poznawczych, zamiast tylko uwolnić parametr.
Jak opisać adaptację w pracy
Jeśli korzystasz z gotowej polskiej adaptacji, podaj jej autorów, rok i najważniejsze dane o rzetelności i trafności w polskiej próbie. Jeśli samodzielnie tłumaczysz narzędzie do pracy dyplomowej, opisz kolejno: zgodę autorów, sposób przekładu, liczbę tłumaczy, tłumaczenie zwrotne, pretest, wyniki rzetelności i struktury czynnikowej. Nazwij taką wersję wprost „wersją eksperymentalną” lub „roboczym przekładem”, a nie „polską adaptacją”.
Kolejne kroki analizy inwariancji, z kodem, opisuje wpis Inwariancja pomiaru krok po kroku, a legalne źródła narzędzi i zasady ich użycia – Gdzie znaleźć kwestionariusze psychologiczne.
Przykład w R
Kod symuluje dane z wersji oryginalnej i polskiej, szacuje w pakiecie lavaan modele inwariancji (konfiguralny, metryczny, skalarny), szuka źródła braku inwariancji testem punktowym, dopasowuje model częściowo skalarny i porównuje różnicę średnich latentnych z różnicą sum punktów. Liczby w tekście pochodzą z tego kodu.
Inwariancja pomiaru wersji oryginalnej i polskiej
R
# R164 – właściwa adaptacja: czy polska wersja skali mierzy to samo co oryginał? (dane symulowane)
# Skala samotności, 6 pozycji 1–7; oryginał (n = 300) i polska adaptacja (n = 300).
# W przekładzie pozycja 4 stała się łatwiejsza do potwierdzenia (+0.9 pkt przy tym samym poziomie samotności).
suppressPackageStartupMessages(library(lavaan))
set.seed(164)
n <- 300
lad <- c(.80, .75, .70, .72, .78, .68); wyraz <- c(3.6, 3.2, 3.9, 3.4, 3.0, 3.7)
generuj <- function(n, przesuniecie, srednia) {
  eta <- rnorm(n, srednia)                                        # prawdziwy poziom samotności
  sapply(1:6, function(j) pmin(pmax(round(wyraz[j] + przesuniecie[j] + 1.2 * lad[j] * eta + rnorm(n, 0, 0.9)), 1), 7))
}
X <- rbind(generuj(n, rep(0, 6), 0), generuj(n, c(0, 0, 0, 0.9, 0, 0), -0.30))   # w polskiej próbie samotność niższa o 0.30 SD
colnames(X) <- paste0("s", 1:6)
dane <- data.frame(X, wersja = rep(c("oryginal", "polska"), each = n))
model <- "SAM =~ s1 + s2 + s3 + s4 + s5 + s6"
ind <- c("cfi", "rmsea", "srmr")
konf <- cfa(model, dane, group = "wersja", std.lv = TRUE)
metr <- cfa(model, dane, group = "wersja", std.lv = TRUE, group.equal = "loadings")
skal <- cfa(model, dane, group = "wersja", std.lv = TRUE, group.equal = c("loadings", "intercepts"))
round(rbind(konfiguralna = fitMeasures(konf, ind), metryczna = fitMeasures(metr, ind), skalarna = fitMeasures(skal, ind)), 3)
round(c(dCFI_metr = fitMeasures(metr, "cfi") - fitMeasures(konf, "cfi"), dCFI_skal = fitMeasures(skal, "cfi") - fitMeasures(metr, "cfi")), 3)

# Która pozycja łamie równość wyrazów wolnych? Test punktowy (score test) dla ograniczeń
st <- lavTestScore(skal)$uni
pt <- parTable(skal)
st$parametr <- pt$lhs[match(st$lhs, pt$plabel)]
st$typ <- pt$op[match(st$lhs, pt$plabel)]
st <- st[st$typ == "~1", c("parametr", "X2", "p.value")]
st$X2 <- round(st$X2, 2); st$p.value <- round(st$p.value, 3); st

# Częściowa inwariancja skalarna: uwalniamy wyraz wolny s4
czesc <- cfa(model, dane, group = "wersja", std.lv = TRUE, group.equal = c("loadings", "intercepts"), group.partial = "s4~1")
round(fitMeasures(czesc, ind), 3)
round(fitMeasures(czesc, "cfi") - fitMeasures(metr, "cfi"), 3)
# Różnica średnich latentnych (polska – oryginał; w grupie oryginalnej średnia = 0)
srednia <- function(m) { pe <- parameterEstimates(m); pe[pe$op == "~1" & pe$lhs == "SAM" & pe$group == 2, c("est", "ci.lower", "ci.upper", "pvalue")] }
round(rbind(skalarna = srednia(skal), czesciowa = srednia(czesc)), 3)
# Różnica w wyniku sumarycznym (d Cohena)
suma <- rowSums(X); g <- dane$wersja == "polska"
sp <- sqrt((var(suma[g]) + var(suma[!g])) / 2)
round(c(M_oryg = mean(suma[!g]), M_pol = mean(suma[g]), d = (mean(suma[g]) - mean(suma[!g])) / sp, p = t.test(suma[g], suma[!g])$p.value), 3)
# Różnice średnich pozycji (polska – oryginał) z 95% CI
roz <- t(sapply(1:6, function(j) { t <- t.test(X[g, j], X[!g, j]); c(roznica = unname(diff(rev(t$estimate))), dolna = t$conf.int[1], gorna = t$conf.int[2]) }))
rownames(roz) <- colnames(X); round(roz, 2)
round(mean(roz[-4, "roznica"]), 2)   # średnia różnica dla pozycji bez zastrzeżeń
Wynik w R
               cfi rmsea  srmr
konfiguralna 0.988 0.048 0.024
metryczna    0.987 0.044 0.036
skalarna     0.914 0.103 0.069
dCFI_metr.cfi dCFI_skal.cfi
       -0.001        -0.073
   parametr    X2 p.value
7        s1  5.53   0.019
8        s2  2.92   0.088
9        s3  2.04   0.153
10       s4 69.43   0.000
11       s5  1.00   0.318
12       s6  4.71   0.030
  cfi rmsea  srmr
0.985 0.044 0.039
   cfi
-0.002
             est ci.lower ci.upper pvalue
skalarna  -0.249   -0.443   -0.056  0.012
czesciowa -0.369   -0.567   -0.171  0.000
M_oryg  M_pol      d      p
20.970 20.053 -0.168  0.040
   roznica dolna gorna
s1   -0.37 -0.58 -0.16
s2   -0.31 -0.52 -0.11
s3   -0.29 -0.48 -0.09
s4    0.50  0.30  0.70
s5   -0.13 -0.34  0.08
s6   -0.32 -0.50 -0.13
[1] -0.28
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; modele wielogrupowe oszacowano w pakiecie lavaan (estymator ML, std.lv = TRUE), a rysunek przygotowano w ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Tłumaczenie bez zgody autora. Przekład chronionego testu wymaga zgody właściciela praw – także w pracy dyplomowej (International Test Commission, 2014).
- Jeden tłumacz i brak dokumentacji. Bez kilku niezależnych przekładów nie widać, które pozycje są niejednoznaczne.
- Tłumaczenie zwrotne jako jedyna kontrola. Zgodny przekład zwrotny nie gwarantuje, że wersja polska brzmi naturalnie i znaczy to samo.
- Przenoszenie norm i punktów odcięcia z oryginału. Normy i progi diagnostyczne trzeba ustalić na nowo dla polskiej populacji.
- Porównywanie średnich między krajami bez inwariancji skalarnej. W przykładzie suma punktów pokazała różnicę d = −0.17, a model z częściową inwariancją – różnicę 0.37 SD.
- Nazywanie własnego przekładu „polską adaptacją”. Adaptacja wymaga badań empirycznych. Roboczy przekład opisz jako roboczy.
Najczęstsze pytania
Czym różni się adaptacja testu od tłumaczenia?
Tłumaczenie przenosi słowa, a adaptacja – pomiar. Adaptacja obejmuje kilka niezależnych przekładów, uzgodnienie wersji w zespole, pretest z osobami z populacji docelowej, badania rzetelności, struktury czynnikowej i trafności, sprawdzenie równoważności pomiarowej oraz nowe normy. Samo tłumaczenie to dopiero jej pierwszy krok.
Czy mogę sam przetłumaczyć kwestionariusz do pracy magisterskiej?
Tylko za zgodą właściciela praw do testu. Przygotuj co najmniej dwa niezależne przekłady, uzgodnij wersję wspólną, sprawdź zrozumiałość pozycji w kilku wywiadach poznawczych i policz rzetelność na swoich danych. W pracy nazwij taką wersję roboczym przekładem, a nie polską adaptacją, i nie stosuj do niej norm z oryginału.
Czy tłumaczenie zwrotne wystarczy?
Nie. Tłumaczenie zwrotne pomaga wychwycić błędy znaczeniowe, ale może przepuścić przekład dosłowny, który brzmi nienaturalnie albo ma inne konotacje w nowej kulturze. Wytyczne International Test Commission traktują je jako jedną z metod kontroli, obok kilku niezależnych przekładów, oceny ekspertów i pretestu.
Po co sprawdzać inwariancję pomiaru adaptowanej skali?
Inwariancja pokazuje, czy pozycje wiążą się z mierzoną cechą tak samo w obu wersjach. Bez równych ładunków nie można porównywać związków między zmiennymi, a bez równych wyrazów wolnych – średnich. W przykładzie jedna przesunięta pozycja sprawiła, że różnica w sumach punktów (d = −0.17) była wyraźnie mniejsza niż w modelu z częściową inwariancją (0.37 SD).
Czy można używać norm z oryginalnej wersji testu?
Nie. Normy opisują rozkład wyników w konkretnej populacji, a po przekładzie zmieniają się i populacja, i właściwości pozycji. Adaptowana wersja potrzebuje własnej próby normalizacyjnej. Do czasu jej opracowania wyniki interpretuj tylko w porównaniach wewnątrz badanej grupy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Adaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikGdzie znaleźć kwestionariusze psychologiczne
Polskie adaptacje, wydawca testów, bazy i IPIP; jak ocenić skalę, kiedy potrzebna jest zgoda autora, wzór e-maila i zasady tłumaczenia narzędzi.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Beaton, D. E., Bombardier, C., Guillemin, F., & Ferraz, M. B. (2000). Guidelines for the process of cross-cultural adaptation of self-report measures. Spine, 25(24), 3186–3191. https://doi.org/10.1097/00007632-200012150-00014
- International Test Commission. (2014). ITC statement on the use of tests and other assessment instruments for research purposes (Version 1.2). https://www.intestcom.org/files/statement_using_tests_for_research.pdf ● Otwarty dostęp
- International Test Commission. (2018). ITC guidelines for translating and adapting tests (second edition). International Journal of Testing, 18(2), 101–134. https://doi.org/10.1080/15305058.2017.1398166 ● Otwarty dostęp: pełny tekst
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- van de Schoot, R., Lugtig, P., & Hox, J. (2012). A checklist for testing measurement invariance. European Journal of Developmental Psychology, 9(4), 486–492. https://doi.org/10.1080/17405629.2012.686740
Cytowania BibTeX
@article{beaton2000guidelines, author={Beaton, Dorcas E. and Bombardier, Claire and Guillemin, Francis and Ferraz, Marcos Bosi}, title={{Guidelines for the process of cross-cultural adaptation of self-report measures}}, journal={Spine}, year={2000}, volume={25}, number={24}, pages={3186--3191}, doi={10.1097/00007632-200012150-00014}}@techreport{itc2014statement, author={{International Test Commission}}, title={{ITC statement on the use of tests and other assessment instruments for research purposes}}, year={2014}, institution={International Test Commission}, url={https://www.intestcom.org/files/statement_using_tests_for_research.pdf}}@article{itc2018guidelines, author={{International Test Commission}}, title={{ITC guidelines for translating and adapting tests (second edition)}}, journal={International Journal of Testing}, year={2018}, volume={18}, number={2}, pages={101--134}, doi={10.1080/15305058.2017.1398166}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{vandeschoot2012checklist, author={van de Schoot, Rens and Lugtig, Peter and Hox, Joop}, title={{A checklist for testing measurement invariance}}, journal={European Journal of Developmental Psychology}, year={2012}, volume={9}, number={4}, pages={486--492}, doi={10.1080/17405629.2012.686740}}