Co to jest rzetelność?
Rzetelność (ang. reliability) to dokładność pomiaru: stopień, w jakim wyniki testu są wolne od błędu losowego i dałyby się powtórzyć w podobnych warunkach. Wynik rzetelnego kwestionariusza stresu niewiele się zmieni, jeśli ta sama osoba wypełni go jutro albo dostanie równoległą wersję z innymi, ale równoważnymi pozycjami. Rzetelność jest warunkiem trafności, ale jej nie gwarantuje: test może bardzo dokładnie mierzyć coś innego, niż zamierzono.
Revelle i Condon (2019) podkreślają, że rzetelność to problem każdego pomiaru, a nie tylko psychometrów. Dotyczy każdego, kto wyciąga wnioski z wyników pojedynczych osób albo grup. Ważna jest jeszcze jedna rzecz: rzetelność jest właściwością wyników w danej populacji, a nie samego testu. Dlatego standardy testowe wymagają podawania oszacowań rzetelności dla tej grupy, której dotyczą wnioski (American Educational Research Association i in., 2014).
Rzetelność w klasycznej teorii testów
Klasyczna teoria testów zakłada, że każdy wynik obserwowany X to suma wyniku prawdziwego T (ang. true score) i błędu losowego E, niezależnego od wyniku prawdziwego:
Rzetelność to udział wariancji wyników prawdziwych w wariancji wyników obserwowanych:
Z tej definicji wynikają trzy równoważne interpretacje. Rzetelność .80 oznacza, że 80% wariancji wyników to różnice prawdziwe, że dwa pomiary równoległe korelują na poziomie .80 i że kwadrat korelacji wyniku obserwowanego z prawdziwym wynosi .80. Wyniku prawdziwego nie obserwujemy, więc rzetelność się szacuje. Metoda zależy od tego, jakie źródło błędu nas interesuje.
Rodzaje rzetelności i sposoby jej oszacowania
| Rodzaj | Pytanie | Typowe miary |
|---|---|---|
| Stabilność | Czy wyniki są podobne po upływie czasu? | rzetelność test–retest (ICC) |
| Równoważność | Czy dwie wersje testu dają te same wyniki? | korelacja wersji równoległych |
| Spójność wewnętrzna | Czy pozycje jednej skali mierzą to samo? | spójność wewnętrzna: alfa, omega McDonalda, KR-20, rzetelność połówkowa |
| Zgodność oceniających | Czy wynik zależy od tego, kto ocenia? | ICC, kappa Cohena; zob. obiektywność |
Te miary nie są wymienne. Wysoka spójność wewnętrzna nie mówi nic o stabilności cechy w czasie, a wysoka korelacja test–retest nie mówi, czy pozycje mierzą jeden konstrukt. Revelle i Condon (2019) zalecają, by przy jednym pomiarze raportować oszacowania oparte na modelu (ω) zamiast samej alfy, a dla ocen sędziów – ICC lub κ.
Przykład: co oznacza rzetelność .80
Pięćset osób (dane symulowane) wypełniło dwie równoległe wersje skali stresu wyrażonej w wynikach T (M = 50, SD = 10). Wyniki prawdziwe i błędy pomiaru wylosowano tak, by rzetelność wynosiła .80.
Krok 1. Trzy definicje, jedna liczba. W próbie udział wariancji prawdziwej w wariancji obserwowanej wyniósł .81, korelacja wersji równoległych – .80, a kwadrat korelacji wyniku obserwowanego z prawdziwym – .80. W praktyce dostępna jest tylko druga z tych liczb, ale wszystkie trzy opisują tę samą właściwość.
Krok 2. Błąd pomiaru pojedynczej osoby. Standardowy błąd pomiaru (SEM, nie mylić z błędem standardowym średniej) to odchylenie standardowe błędów pomiaru (Harvill, 1991):
Osoba z wynikiem 65 punktów ma więc 95% przedział od 55.4 do 74.6 punktu. To szeroki przedział – obejmuje zarówno wynik ledwie powyżej przeciętnej, jak i bardzo wysoki. W symulacji taki przedział objął wynik prawdziwy u 93% osób. Harvill (1991) zaleca stosowanie takich przedziałów przy interpretacji wyników indywidualnych i ostrzega przed nadinterpretacją różnic mieszczących się w granicach błędu. Jak to wygląda w praktyce diagnostycznej, pokazują hasła skala IQ i skala stenowa.
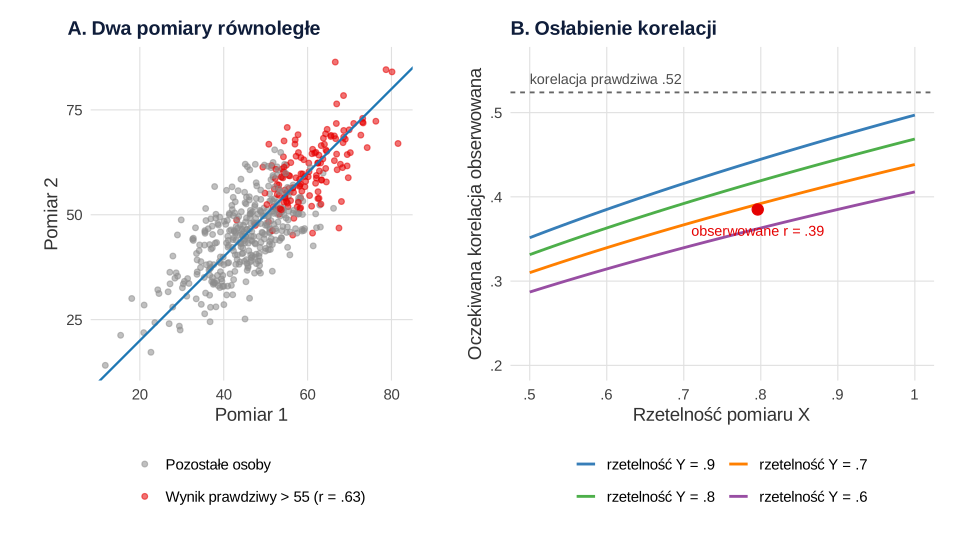
Krok 3. Osłabienie korelacji. Błąd pomiaru zaniża korelacje. Korelacja prawdziwych poziomów stresu i wypalenia wyniosła w próbie .52, ale stres mierzono z rzetelnością .80, a wypalenie – z rzetelnością .72. Obserwowana korelacja wyniosła tylko .39. Schmidt i Hunter (1996) pokazują na wielu scenariuszach badawczych, że obserwowana korelacja zależy od korelacji prawdziwej i rzetelności obu miar:
Po przekształceniu wzoru otrzymujemy korektę na osłabienie: .39 / √(.80 × .72) = .51, czyli niemal tyle, ile wynosi korelacja prawdziwa (rysunek 1B). Korekta ma sens tylko wtedy, gdy oszacowania rzetelności są dobre; przy zaniżonej rzetelności korelacja „skorygowana” jest zawyżona.
Krok 4. Ta sama skala, inna rzetelność. W podgrupie 140 osób z wysokim stresem (wynik prawdziwy powyżej 55) korelacja wersji równoległych spadła do .63. Skala i błąd pomiaru się nie zmieniły – zmalało zróżnicowanie osób (SD wyników z 10.85 do 6.95), więc błąd stanowi większą część wariancji. Hedge i in. (2018) opisują to samo zjawisko w zadaniach poznawczych: zadania, w których wszyscy reagują podobnie, dają silne efekty eksperymentalne, ale słabo różnicują ludzi i mają niską rzetelność.
Jaka rzetelność jest wystarczająca?
Nie ma jednej granicy. Wymagania zależą od zastosowania. W badaniach porównujących średnie grup błąd pomiaru częściowo się uśrednia i zwykle akceptuje się niższe wartości niż przy decyzjach o pojedynczej osobie, gdzie liczy się szerokość przedziału wokół jej wyniku. Zamiast szukać progu, odpowiedz na dwa pytania: jak szeroki jest przedział wokół wyniku indywidualnego (SEM) i o ile błąd pomiaru zaniży korelacje oraz moc twoich analiz.
Jak opisać rzetelność w pracy (APA)
Podaj rodzaj rzetelności i współczynnik obliczony w twojej próbie, najlepiej z 95% przedziałem ufności, osobno dla każdej skali i podskali. Gdy interpretujesz wyniki indywidualne, dodaj SEM. Wiele skal zbierz w tabeli według wzoru tabeli rzetelności w APA.
Praktyczne zasady oceny spójności wewnętrznej opisuje poradnik alfa Cronbacha – jak oceniać rzetelność skali bez uproszczeń.
Rzetelność w R
Kod symuluje wyniki prawdziwe, dwa pomiary równoległe i drugą zmienną mierzoną z błędem, a następnie liczy trzy definicje rzetelności, SEM i przedział dla jednej osoby, osłabienie korelacji z korektą oraz rzetelność w mniej zróżnicowanej podgrupie. Liczby w tekście i na rysunku pochodzą z tego kodu.
Klasyczna teoria testów: X = T + E
R
# Rzetelność w klasycznej teorii testów: X = T + E (dane symulowane)
set.seed(1523)
N <- 500
T_stres <- rnorm(N, 50, 10)                 # wynik prawdziwy: stres (skala T)
rho <- 0.80                                  # zakładana rzetelność
sd_E <- sqrt(100 * (1 - rho) / rho)          # SD błędu, przy której var(T)/var(X) = .80
X1 <- T_stres + rnorm(N, 0, sd_E)            # pomiar 1
X2 <- T_stres + rnorm(N, 0, sd_E)            # pomiar równoległy (np. druga wersja testu)

# 1. Trzy równoważne definicje rzetelności
round(c(sd_bledu = sd_E, var_T_do_var_X = var(T_stres) / var(X1), r_X1_X2 = cor(X1, X2),
        r_X_T_kwadrat = cor(X1, T_stres)^2), 3)

# 2. Standardowy błąd pomiaru i przedział dla wyniku jednej osoby
SEM <- sd(X1) * sqrt(1 - cor(X1, X2))
round(c(SD_X = sd(X1), rzetelnosc = cor(X1, X2), SEM = SEM), 2)
x_os <- 65
round(c(dolna = x_os - 1.96 * SEM, gorna = x_os + 1.96 * SEM), 1)
# Ile osób ma przedział 95% obejmujący swój wynik prawdziwy?
round(mean(abs(X1 - T_stres) <= 1.96 * SEM), 3)

# 3. Osłabienie korelacji: prawdziwa korelacja stresu z wypaleniem = .50
T_wyp <- 0.5 * scale(T_stres)[, 1] + rnorm(N, 0, sqrt(1 - 0.25))
Y <- T_wyp + rnorm(N, 0, sqrt((1 - 0.70) / 0.70))        # wypalenie mierzone z rzetelnością .70
Y2 <- T_wyp + rnorm(N, 0, sqrt((1 - 0.70) / 0.70))
r_prawdziwa <- cor(T_stres, T_wyp); r_obs <- cor(X1, Y); rzet_Y <- cor(Y, Y2)
round(c(r_prawdziwa = r_prawdziwa, r_obserwowana = r_obs, oczekiwana = r_prawdziwa * sqrt(0.80 * 0.70),
        rzet_X = cor(X1, X2), rzet_Y = rzet_Y, r_skorygowana = r_obs / sqrt(cor(X1, X2) * rzet_Y)), 3)

# 4. Rzetelność zależy od zróżnicowania próby: ten sam test u osób z wysokim stresem (T > 55)
wys <- T_stres > 55
round(c(n = sum(wys), SD_X_cala = sd(X1), SD_X_wysoki = sd(X1[wys]),
        rzet_cala = cor(X1, X2), rzet_wysoki = cor(X1[wys], X2[wys])), 3)
Wynik w R
      sd_bledu var_T_do_var_X        r_X1_X2  r_X_T_kwadrat
         5.000          0.812          0.796          0.795
      SD_X rzetelnosc        SEM
     10.85       0.80       4.90
dolna gorna
 55.4  74.6
[1] 0.93
  r_prawdziwa r_obserwowana    oczekiwana        rzet_X        rzet_Y
        0.524         0.385         0.392         0.796         0.723
r_skorygowana
        0.507
          n   SD_X_cala SD_X_wysoki   rzet_cala rzet_wysoki
    140.000      10.846       6.953       0.796       0.634
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://CRAN.R-project.org/package=patchwork
Najczęstsze błędy
- „Test ma rzetelność .85” – rzetelność dotyczy wyników w konkretnej grupie; w mniej zróżnicowanej próbie może być wyraźnie niższa. Podaj oszacowanie z własnych danych.
- Utożsamianie rzetelności z alfą Cronbacha – alfa to tylko jedno oszacowanie jednego rodzaju rzetelności, oparte na mocnych założeniach.
- Traktowanie rzetelności jak trafności – dokładny pomiar niewłaściwej cechy nadal jest niewłaściwy.
- Interpretowanie różnicy dwóch wyników bez SEM – różnica kilku punktów może mieścić się w granicach błędu.
- Wniosek „brak związku” przy słabo rzetelnych miarach – błąd pomiaru zaniża korelacje i obniża moc.
- Korekta na osłabienie bez zastrzeżeń – skorygowana korelacja jest oszacowaniem dla wyników prawdziwych, a nie wynikiem obserwowanym; podawaj obie wartości.
Najczęstsze pytania
Co to jest rzetelność testu psychologicznego?
To dokładność pomiaru: na ile wyniki są wolne od błędu losowego i dałyby się powtórzyć. Formalnie rzetelność to udział wariancji wyników prawdziwych w wariancji wyników obserwowanych; rzetelność .80 oznacza, że 80% zróżnicowania wyników to prawdziwe różnice między osobami.
Jakie są rodzaje rzetelności?
Najczęściej wyróżnia się stabilność w czasie (test–retest), równoważność wersji równoległych, spójność wewnętrzną (alfa, omega, KR-20, rzetelność połówkowa) i zgodność oceniających (ICC, kappa). Każdy rodzaj obejmuje inne źródło błędu, więc nie są one wymienne.
Co to jest standardowy błąd pomiaru (SEM)?
To odchylenie standardowe błędów pomiaru, obliczane jako SD × √(1 − rzetelność). Służy do budowania przedziału wokół wyniku jednej osoby: przy SD = 10.85 i rzetelności .80 SEM wynosi 4.90, więc 95% przedział dla wyniku 65 to od 55.4 do 74.6.
Czym różni się rzetelność od trafności?
Rzetelność mówi, jak dokładnie test mierzy, a trafność – czy mierzy to, co ma mierzyć, i czy interpretacje wyników są uzasadnione. Niska rzetelność ogranicza trafność, ale wysoka jej nie zapewnia.
Dlaczego niska rzetelność zaniża korelacje?
Błąd losowy dodaje do wyników zmienność niezwiązaną z żadną inną zmienną, więc obserwowana korelacja jest mniejsza od prawdziwej. W przybliżeniu równa się ona korelacji prawdziwej pomnożonej przez pierwiastek z iloczynu rzetelności obu miar.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →PoradnikPsychometria – zadania z rozwiązaniami
Dziesięć zadań: alfa Cronbacha, analiza pozycji, KR-20, omega, błąd standardowy pomiaru, RCI, normy, Spearman–Brown i korekta na atenuację.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikWzór raportowania alfy Cronbacha
Gotowe zdania i tabela APA: podskale, niska alfa, pozycje odwrócone, skala adaptowana, porównanie z podręcznikiem – z plikiem .docx.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. https://www.testingstandards.net/open-access-files.html ● Otwarty dostęp
- Harvill, L. M. (1991). Standard error of measurement. Educational Measurement: Issues and Practice, 10(2), 33–41. https://doi.org/10.1111/j.1745-3992.1991.tb00195.x
- Hedge, C., Powell, G., & Sumner, P. (2018). The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences. Behavior Research Methods, 50(3), 1166–1186. https://doi.org/10.3758/s13428-017-0935-1 ● Otwarty dostęp
- Revelle, W., & Condon, D. M. (2019). Reliability from α to ω: A tutorial. Psychological Assessment, 31(12), 1395–1411. https://doi.org/10.1037/pas0000754 ● Otwarty dostęp
- Schmidt, F. L., & Hunter, J. E. (1996). Measurement error in psychological research: Lessons from 26 research scenarios. Psychological Methods, 1(2), 199–223. https://doi.org/10.1037/1082-989x.1.2.199
Cytowania BibTeX
@book{aera2014standards, author={{American Educational Research Association} and {American Psychological Association} and {National Council on Measurement in Education}}, title={{Standards for educational and psychological testing}}, year={2014}, publisher={American Educational Research Association}, url={https://www.testingstandards.net/open-access-files.html}}@article{harvill1991standard, author={Harvill, Leo M.}, title={{Standard error of measurement}}, journal={Educational Measurement: Issues and Practice}, year={1991}, volume={10}, number={2}, pages={33--41}, doi={10.1111/j.1745-3992.1991.tb00195.x}}@article{hedge2018reliability, author={Hedge, Craig and Powell, Georgina and Sumner, Petroc}, title={{The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={1166--1186}, doi={10.3758/s13428-017-0935-1}}@article{revelle2019reliability, author={Revelle, William and Condon, David M.}, title={{Reliability from α to ω: A tutorial}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1395--1411}, doi={10.1037/pas0000754}}@article{schmidt1996measurement, author={Schmidt, Frank L. and Hunter, John E.}, title={{Measurement error in psychological research: Lessons from 26 research scenarios}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={199--223}, doi={10.1037/1082-989x.1.2.199}}